

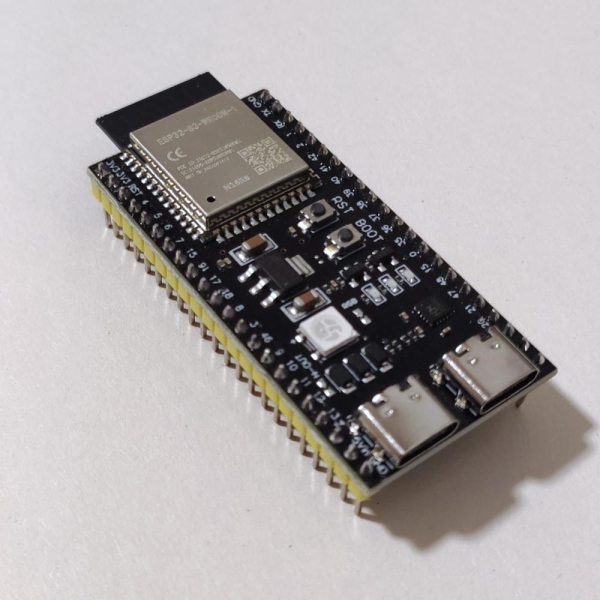
المطور فياتشيسلاف سيربوف، الذي يستخدم الاسم المستعار slvDev، مبرهن توليد نصوص محلية بالكامل باستخدام متحكم دقيق ESP32-S3. يحتوي نموذج اللغة الناتج على 28,9 مليون مُعامل، ويُنتج حوالي 9,9 رمزًا في الثانية دون الحاجة إلى خادم أو موارد حاسوبية خارجية أخرى. تُعرض القصص القصيرة المُولّدة على شاشة OLED متصلة.
مشروع esp32-ai تم اختبار النموذج على وحدة ESP32-S3 N16R8 مزودة بذاكرة SRAM مدمجة سعة 512 كيلوبايت، وذاكرة PSRAM سعة 8 ميجابايت، وذاكرة فلاش سعة 16 ميجابايت. يشغل النموذج الكمي ذو 4 بتات مساحة 14,9 ميجابايت. يحتوي المستودع على شفرة المصدر لوقت التشغيل بلغة C، وأدوات التدريب والتكميم، والبرامج الثابتة، والاختبارات، والنصوص البرمجية اللازمة لتحميلها على اللوحة.
لا ينبغي مقارنة عدد المعاملات المزعوم البالغ 28,9 مليون معامل مباشرةً بعدد معاملات نماذج التعلم الآلي التقليدية على أجهزة الكمبيوتر المكتبية. وفقًا لـ تقرير مفصل من المطوريتألف النموذج من نواة حسابية كثيفة تحتوي على ما يقارب 559 مُعامل، وطبقة إخراج تحتوي على 3,1 مليون مُعامل، وجدول تمثيلات متجهية متعددة الطبقات يحتوي على ما يقارب 25 مليون مُعامل. يُشكّل هذا الجدول الأخير الجزء الأكبر من الحجم الرسمي للنموذج، ولكنه لا يُعالَج بالكامل عند توليد كل رمز.
تُستخدم ثلاثة مستويات من الذاكرة لتخزين النموذج. توجد البيانات الأكثر استخدامًا في ذاكرة الوصول العشوائي الثابتة الداخلية (SRAM)، بينما توجد طبقة الإخراج وذاكرة التخزين المؤقت للقيم والمفاتيح والمخازن المؤقتة في ذاكرة الوصول العشوائي الثابتة (PSRAM)، أما الجدول الذي يحتوي على 25 مليون عنصر فيوجد في ذاكرة الفلاش ويمكن الوصول إليه عبر تعيين مساحة العناوين. لكل رمز مميز، تُقرأ منه ستة صفوف تقريبًا، بإجمالي 450 بايت تقريبًا.
يعتمد هذا الجهاز على تقنية تضمين الطبقات التي تستخدمها جوجل في جهاز Gemma 3n. وفقًا لـ وثائق جوجليمكن تخزين معلمات PLE خارج ذاكرة العمل الخاصة بالنموذج وإضافتها إلى عملية الاستدلال أثناء معالجة الطبقات الفردية. في esp32-ai، تم توسيع هذا النهج ليشمل التسلسل الهرمي لذاكرة المتحكم الدقيق، حيث تكون ذاكرة SRAM السريعة محدودة للغاية.
أنتجت النسخة الأولى الصحيحة من بيئة التشغيل المبنية على لغة C ما لا يزيد عن 0,57 رمزًا في الثانية. بعد وضع طبقة الإخراج في ذاكرة PSRAM، والتحول إلى تفعيلات ثمانية بت، وتوزيع الحساب بين نواتين من نوع Xtensa LX7، وإجراء تحسينات أخرى، انخفض زمن الاستجابة إلى 94,9 مللي ثانية لكل خطوة من خطوات النموذج. وبلغت الإنتاجية النهائية المقاسة 9,88 رمزًا في الثانية، مع الأخذ في الاعتبار عملية التوليد الكاملة. وأصبح القيد الرئيسي الآن هو عرض نطاق ذاكرة PSRAM عند قراءة طبقة الإخراج.
تم تدريب النموذج على مجموعة بيانات اصطناعية قصص صغيرةيتألف هذا البرنامج من قصص بسيطة باللغة الإنجليزية ذات مفردات محدودة. لذا، فهو قادر على إكمال الجمل وتأليف قصص قصيرة مترابطة، ولكنه غير مصمم للإجابة عن الأسئلة أو اتباع التعليمات أو البرمجة أو استحضار المعلومات الواقعية. ينظر المطور إلى هذا العمل في المقام الأول كعرض توضيحي لكفاءة وضع النموذج في ذاكرة المتحكم الدقيق، وليس كبرنامج دردشة آلي جاهز للاستخدام.
يؤكد المؤلف في الوثائق الحالية تحديدًا أن esp32-ai هو مشروع تطوير مستقل. llama2.c يُقدَّم عمل أندريه كارباثي وإطلاق النموذج رقم 260 على جهاز ESP32-S3 كإرشادات وأمثلة فقط على الأعمال السابقة: فالشفرة البرمجية ونقاط التحقق والمنهجية ليست مقتبسة منها مباشرةً. شفرة المصدر esp32-ai موزع بموجب ترخيص MIT.
المصدر: linux.org.ru
