

Публикувано е подробното ръководство за настройка на Linux среда за постигане на максимална производителност при обработка на HTTP заявки. Предложените методи доведоха до увеличение на производителността на JSON обработчика, базиран на библиотеката libreactor, в Amazon EC2 (4 vCPU) от 224 хиляди API заявки в секунда при стандартните настройки на Amazon Linux 2 с ядро 4.14 до 1.2 милиона заявки в секунда след оптимизация (прираст от 436%), както и до намаляване на закъсненията при обработката на заявки с 79%. Предложените методи не са специфични за libreactor и работят с други HTTP сървъри, включително nginx, Actix, Netty и Node.js (libreactor беше използван в тестовете, тъй като решението на неговата основа показа най-добра производителност).
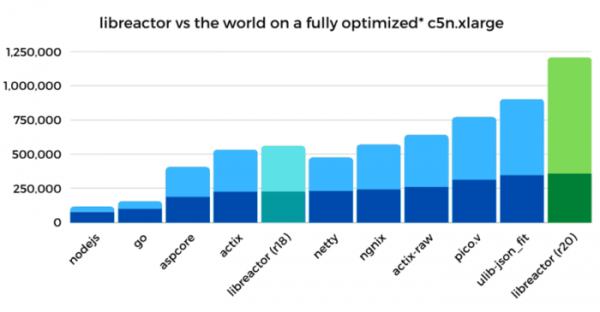
Основни оптимизации:
- Оптимизация на кода на libreactor. Основата беше вариант R18 от набора Techempower, който беше подобрен чрез премахване на кода за ограничаване на броя на използваните CPU ядра (оптимизацията ускори работата с 25-27%), компилация в GCC с опции «-O3» (прираст 5-10%) и «-march-native» (5-10%), замяна на извикванията read/write с recv/send (5-10%) и намаляване на накладните разходи при използване на pthreads (2-3%). Общият прираст на производителността след оптимизация на кода е 55%, а пропускната способност нарасна от 224k req/s до 347k req/s.
- Изключване на защитата от уязвимости, причинени от спекулативно изпълнение на инструкции. Използването на параметри при зареждане на ядрото «nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off» позволи да се увеличи производителността с 28%, а пропускната способност нарасна от 347k req/s до 446k req/s. Поотделно, прирастът от параметъра «nospectre_v1» (защита от Spectre v1 + SWAPGS) е 1-2%, «nospectre_v2» (защита от Spectre v2) — 15-20%, «pti=off» (Spectre v3/Meltdown) — 6%, «mds=off tsx_async_abort=off» (MDS/Zombieload и TSX Asynchronous Abort) — 6%. Настройките за защита от атаки L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass и SRBDS бяха оставени без промяна, тъй като не влияят на производителността, тъй като не се пресичат с тестваната конфигурация (например, специфични за KVM, вложена виртуализация и други модели CPU).
- Изключване на механизмите за одит и блокиране на системни повиквания с командата «auditctl -a never,task» и указването на опцията «—security-opt seccomp=unconfined» при стартиране на docker контейнер. Общият прираст на производителността е 11%, а пропускната способност нарасна от 446k req/s до 495k req/s.
- Изключване на iptables/netfilter чрез изваждане на свързаните с тях ядрови модули. Идеята за изключване на защитната стена, която не се е използвала в специфичното сървърно решение, бе подтикната от резултатите от профилирането, според които времето за изпълнение на функцията nf_hook_slow е било 18%. Отбелязва се, че nftables работи по-ефективно от iptables, но в Amazon Linux все още се използва iptables. След изключването на iptables производителността нарасна с 22%, а пропускната способност се увеличи от 495k req/s на 603k req/s.
- Намаляване на миграцията на обработчици между различни CPU ядра за повишаване на ефективността на използване на кеша на процесора. Оптимизацията беше извършена както на нивото на привързването на процесите libreactor към CPU ядрата (CPU Pinning), така и чрез закрепване на мрежовите обработчици на ядрото (Receive Side Scaling). Например, направено е изключване на irqbalance и явно задаване на привързаностите на опашките към CPU в /proc/irq/$IRQ/smp_affinity_list. За използването на едно и също CPU ядро за обработка на процеса libreactor и мрежовата опашка на входящите пакети е активиран собствен BPF обработчик, свързан чрез задаване на флага SO_ATTACH_REUSEPORT_CBPF при създаване на сокета. За привързване към CPU на опашките на изходящите пакети, настройките в /sys/class/net/eth0/queues/tx-<n>/xps_cpus бяха променени. Общият ръст в производителността бе 38%, а пропускната способност се увеличи от 603k req/s на 834k req/s.
- Оптимизация на обработката на прекъсвания и използване на поллинг (polling). Включването на режима adaptive-rx в драйвера ENA и манипулациите със sysctl net.core.busy_read позволиха повишаване на производителността с 28% (пропускната способност нарасна от 834k req/s на 1.06M req/s, а забавянията намаляха от 361μs на 292μs).
- Изключване на системни услуги, водещи до ненужни блокировки в мрежовия стек. Изключването на dhclient и настройката IP адреси ръчно доведе до повишаване на производителността с 6%, а пропускната способност се увеличи от 1.06M req/s на 1.12M req/s. Причината за влиянието на dhclient върху производителността е анализ на трафика с използване на raw сокет.
- Борба със Spin Lock. Превключването на мрежовия стек в режим „noqueue“ чрез sysctl „net.core.default_qdisc=noqueue“ и „tc qdisc replace dev eth0 root mq“ доведе до увеличаване на производителността с 2%, а пропускната способност се повиши от 1.12M req/s на 1.15M req/s.
- Финални оптимизации, като изключване на GRO (Generic Receive Offload) с командата «ethtool -K eth0 gro off» и смяна на алгоритъма за контрол на натоварването от cubic на reno с помощта на sysctl «net.ipv4.tcp_congestion_control=reno». Общото увеличение на производителността е 4%. Пропускливостта нараства от 1.15M req/s до 1.2M req/s.
Освен успешните оптимизации, в статията се разглеждат и методи, които не доведоха до очакван растеж на производителността. Например, неефективни се оказаха:
- Отделното стартиране на libreactor не се отличаваше по производителност от стартирането в контейнер. Сменянето на writev с send, увеличаването на maxevents в epoll_wait, експерименти с версии и флагове на GCC (ефектът беше забележим само за флаговете «-O3» и «-march-native») не оказаха влияние.
- Актуализацията на ядрото на Linux до версии 4.19 и 5.4, използването на планировчици SCHED_FIFO и SCHED_RR, манипулациите с sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 и clocksource=tsc не повлияха на производителността.
- В драйвера ENA включването на режимите Offload (segmentation, scatter-gather, rx/tx checksum), компилацията с флаг «-O3» и използването на параметрите ena.rx_queue_size и ena.force_large_llq_header не оказаха влияние.
- Промените в мрежовия стек не доведоха до увеличаване на производителността:
- Изключване на IPv6: ipv6.disable=1
- Изключване на VLAN: modprobe -rv 8021q
- Изключване на проверката на източника на пакета
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (негативен ефект)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Източник: opennet.ru
