

В рамките на професионалната дейност, разработчици, пентестери и специалисти по сигурност често се сблъскват с процеси като управление на уязвимости (VM) и (сигурен) SDLC.
Под тези термини се крият различни набори от практики и инструменти, които са взаимосвързани, въпреки че потребителите им за различни.
Техническият напредък все още не е достигнал до замяна на човека с един инструмент за извършване на анализ на сигурността на инфраструктурата и софтуера.
Интересно е да разберем защо е така и с какви проблеми се сблъскваме.
Процеси
Процесът на управление на уязвимости е създаден за непрекъснато наблюдение на сигурността на инфраструктурата и управление на пачове.
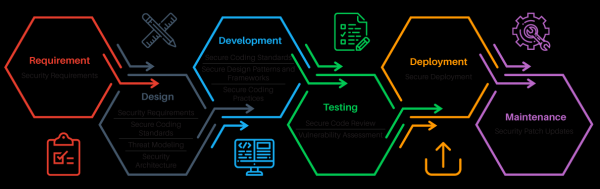
Процесът на сигурен SDLC е предназначен да подсигури безопасността на приложението по време на разработката и експлоатацията.
Сходна част от тези процеси е оценка на уязвимостите — сканиране на уязвимости.
Основното различие в сканирането в рамките на VM и SDLC е, че в първия случай целта е да се открият известни уязвимости в външния софтуер или конфигурацията. Например, остаряла версия на Windows или стандартен community-стринг за SNMP.
Във втория случай целта е да се открият уязвимости не само в външни компоненти (зависимости), но най-вече в кода на новия продукт.
Това поражда различия в инструментите и подходите. Според мен, задачата за търсене на нови уязвимости в приложението е значително по-интересна, тъй като не се свежда до фингерпринтиране на версии, събиране на банери, подбиране на пароли и т.н.
За качествено автоматизирано сканиране на уязвимости в приложенията са необходими алгоритми, които отчитат семантиката на приложението, неговото предназначение и специфични заплахи.
Инфраструктурният сканер често може да бъде заменен с таймер, както е изразил Същността е, че статистически можете да считате инфраструктурата си за уязвима, ако не сте я обновявали, да кажем, месец.
Инструменти
Сканирането, както и анализът на сигурността, могат да се извършват както с черна кутия, така и с бяла кутия.
Чёрна кутия
При blackbox сканиране, инструментът трябва да може да работи с услугата чрез същите интерфейси, чрез които работят потребителите.
Сканиращи инструменти за инфраструктура (Tenable Nessus, Qualys, MaxPatrol, Rapid7 Nexpose и т.н.) търсят отворени мрежови портове, събират „банери“, определят версиите на инсталирания софтуер и търсят в своята база данни информация за уязвимости в тези версии. Също така опитват да открият конфигурационни грешки, като пароли по подразбиране или отворен достъп до данни, слаби SSL шифри и т.н.
Сканиращи инструменти за уеб приложения (Acunetix WVS, Netsparker, Burp Suite, OWASP ZAP и т.н.) също могат да определят известни компоненти и техните версии (например, CMS, фреймуъркове, JS-библиотеки). Основните стъпки на сканирания инструмент са краулинг и фаззинг.
В хода на краулинга, сканиращият инструмент събира информация за съществуващите интерфейси на приложението, HTTP параметрите. По време на фаззинга, в всички открити параметри се въвеждат мутирани или генерирани данни с цел да се предизвика грешка и да се открие уязвимост.
Тези приложения се отнасят към класовете DAST и IAST — съответно Dynamic и Interactive Application Security Testing.
White Box
При whitebox сканиране разликите са повече.
В рамките на процеса VM, на сканиращите инструменти (Vulners, Incsecurity Couch, Vuls, Tenable Nessus и т.н.) често се предоставя достъп до системите, провеждайки аутентифицирано сканиране. По този начин, сканиращият инструмент може да извлече инсталираните версии на пакети и конфигурационни параметри направо от системата, без да ги гадае по банерите на мрежовите услуги.
Сканирането става по-точно и пълно.
Ако говорим за whitebox сканиране (CheckMarx, HP Fortify, Coverity, RIPS, FindSecBugs и т.н.) на приложения, обикновено става въпрос за статичен анализ на кода и използването на съответните инструменти от клас SAST — Static Application Security Testing.
Проблеми
Проблемите с сканирането са много! С повечето от тях ми се налага да се сблъсквам лично в рамките на предоставянето на услуги за изграждане на процеси на сканиране и безопасна разработка, а също и при провеждане на анализи на сигурността.
Ще посоча 3 основни групи проблеми, които се потвърдиха и в разговорите с инженери и ръководители на служби за информационна сигурност в много различни компании.
Проблеми при сканирането на уеб приложения
- Сложността на внедряването. Сканерите трябва да бъдат разгръщани, конфигурирани и персонализирани за всяко приложение, да се отделя тестова среда за сканиране и да бъдат внедрени в процеса на CI/CD, за да бъдат ефективни. В противен случай, това би било безполезна формална процедура, която единствено да генерира фалшиви срабатывания.
- Продължителност на сканирането. Сканерите дори през 2019 година не се справят добре с дедупликацията на интерфейсите и могат да сканират хиляда страници с 10 параметъра на всяка денонощно, считайки ги за различни, въпреки че отговаря за тях един и същ код. В същото време решението за деплой в продуктивна среда в рамките на цикъла на разработка трябва да бъде взето бързо.
- Оскъдни препоръки. Сканерите предоставят сравнително общи препоръки и не винаги разработчикът може бързо да разбере как да намали нивото на риск, а най-важното е, че не знае дали трябва да направи това веднага или все още е поносимо.
- Разрушително въздействие върху приложението. Сканерите могат да извършат DoS атака срещу приложението, както и да създадат голямо количество единици или да изменят съществуващи (например, да създадат десетки хиляди коментари в блога), така че не бива да стартирате сканиране в продуктивна среда безмислено.
- Ниско качество на откритие на уязвимости. Сканерите обикновено използват фиксиран набор от полезни натоварвания (payloads) и лесно могат да пропуснат уязвимост, която не попада в известния им сценарий на поведение на приложението.
- Недоразумение на функцията на приложението от скенера. Сканерите сами по себе си не знаят какво е "интернет-банк", "плащане", "коментар". За тях съществуват само линкове и параметри, така че огромен пласт от възможни уязвимости в бизнес логиката остава напълно непокрит; те няма да предположат как да направят двойно отчисление, да погледнат чужди данни по ID или да завишат баланса чрез закръгляне.
- Недоразумение на семантиката на страниците от скенера. Сканерите не могат да четат FAQ, не разпознават капчи, сами по себе си не могат да се досетят как трябва да се регистрират, че след това трябва да се логнат отново, че не трябва да се натиска "изход", и как трябва да подписват заявки при промяна на стойности на параметрите. В резултат на това голяма част от приложението може да остане напълно несканирана.
Проблеми с сканирането на изходния код.
- Фалшиви срабатывания. Статичният анализ е сложна задача, при решаването на която често се налага да се правят много компромиси. Често се жертва точността, а дори и скъпите enterprise скенери предоставят огромно количество фалшиви срабатывания.
- Сложността на внедряването. За увеличаване на точността и пълнотата на статичния анализ е необходимо да се доработят правилата за сканиране, а написването на тези правила може да се окаже прекалено трудоемко. Понякога е по-лесно да се намерят всички места в кода с определен бъг и да се коригират, отколкото да се напише правило за откриване на такива случаи.
- Липса на поддръжка на зависимости. Големи проекти зависят от множество библиотеки и фреймворкове, които разширяват възможностите на езика за програмиране. Ако в базата данни на скенера няма информация за опасни места („sinks“) в тези фреймворкове, това ще стане сляпо петно, и скенерът просто няма да разбере кода.
- Продължителност на сканирането. Намирането на уязвимости в кода е сложна задача и по отношение на алгоритмите. Следователно, процесът може да отнеме време и да изисква значителни изчислителни ресурси.
- Ниско покритие. Въпреки потреблението на ресурси и дългото време на сканиране, разработчиците на SAST инструменти все още трябва да правят компромиси и да анализират не всички състояния, в които може да се намира програмата.
- Възпроизводимост на находките. Указването на конкретна линия и стек от извиквания, които водят до уязвимост, е прекрасно, но действително често скенерът не предоставя достатъчно информация, за да провери наличието на уязвимост извън. Наистина недостатъкът може да бъде и в мъртвия код, който не може да бъде достигнат от атакуващия.
Проблеми с сканиране на инфраструктурата.
- Недостатъчна инвентаризация. В големи инфраструктури, особено географски разделени, често е труден да се разбере кои хостове трябва да бъдат сканирани. С други думи, задачата по сканиране е тясно свързана с задачата за управление на активи.
- Лоша приоритизация. Мрежовите скенери често предоставят много резултати с недостатъци, които на практика не могат да бъдат експлоатирани, но формално нивото на тяхния риск е високо. Потребителят получава отчет, който е труден за интерпретиране, и не се разбира какво трябва да се коригира на първо място.
- Оскъдни препоръки. В базата данни на скенера често има само много обща информация за уязвимостите и начините за тяхното отстраняване, така че администраторите ще трябва да се въоръжат с Google. Ситуацията е малко по-добра с whitebox скенерите, които могат да предоставят конкретна команда за поправка.
- Ръчна работа. В инфраструктурите може да има много възли, а следователно и потенциално много недостатъци, които трябва да се преглеждат и анализират ръчно при всяка итерация.
- Лошо покритие. Качеството на сканирането на инфраструктурата директно зависи от обема на базата данни за уязвимости и версиите на софтуера. При това, , дори при лидерите на пазара, базата данни не е изчерпателна, и в базите на безплатните решения има много информация, която липсва на лидерите.
- Проблеми с пачването. Най-често пачването на уязвимости в инфраструктурата е обновление на пакет или промяна на конфигурационния файл. Голям проблем тук е, че системата, особено legacy, може да се държи непредсказуемо в резултат на обновлението. По същество ще трябва да се проведат интеграционни тестове на живата инфраструктура в продукция.
Подходи
Какво да правим?
По-подробно за примери и за това как да се справим с много от изброените проблеми ще разкажа в следващите части, а засега ще посоча основните насоки, в които може да се работи:
- Агрегация на различни инструменти за сканиране. При правилна употреба на няколко скенера може да се постигне значително увеличаване на базата данни и качеството на детекцията. Може да се открият дори повече уязвимости, отколкото сумарно от всички скенери, стартирани поотделно, като същевременно може по-точно да се оценява нивото на риск и да се предоставят повече препоръки.
- Интеграция на SAST и DAST. Може да се увеличи покритието на DAST и точността на SAST чрез обмен на информация между тях. От изходния код може да се получи информация за съществуващите маршрути, а с помощта на DAST може да се провери дали уязвимостта е видима откъм външната страна.
- Machine Learning™. През 2015 година аз (и ) по приложението на статистиката, за да даде на скенерите интуицията на хакера и да ги ускори. Това определено е храна за развитие на автоматизирания анализ на защитата в бъдеще.
- Интеграция на IAST с автотестове и OpenAPI. В рамките на CI/CD-пайплайн е възможно създаването на процес на сканиране, основан на инструменти, които работят като HTTP-прокси, и функционални тестове, работещи по HTTP. Тестовете и контрактите OpenAPI/Swagger ще предоставят на скенера липсващата информация за потоците от данни и ще позволят сканирането на приложението в различни състояния.
- Правилната конфигурация. За всяко приложение и инфраструктура е необходимо да се създаде подходящ профил за сканиране, който да отчита количеството и характера на интерфейсите и използваните технологии.
- Персонализация на скенерите. Често приложението не може да бъде сканирано без доработка на скенера. Например - платежен шлюз, при който всяка заявка трябва да бъде подписана. Без написването на конектор към протокола на шлюза, скенерите ще преминават през заявки с неправилна подписка. Също така, е необходимо да се пишат специализирани скенери за конкретни видове недостатъци, като:
- Управление на риска. Използването на различни скенери и интеграция с външни системи, като управление на активи и управление на заплахи, ще позволи използването на множество параметри за оценка на нивото на риск, така че ръководството да има адекватна представа за текущото състояние на сигурността на разработката или инфраструктурата.
Следете актуализациите и нека разтърсиме сканирането за уязвимости!
Източник: habr.com
