

Какво може да накара толкова голяма компания като Lamoda с утвърден процес и десетки взаимосвързани услуги да промени значително подхода си? Мотивацията може да бъде напълно различна: от законодателни изисквания до вроденото желание на всички програмисти да експериментират.
Но това съвсем не означава, че не може да се разчита на допълнителна полза. Как точно може да се спечели, когато се внедри events-driven API на Kafka, ще разкаже Сергей Заика (). Ще има и за набитите шишки и интересните открития - не може да мине експеримент без тях.
Отказ: Тази статия е основана на материали от митапа, който Сергей проведе през ноември 2018 година на HighLoad++. Живият опит на Lamoda с Kafka привлече слушателите не по-малко от другите лекции в програмата. Смятаме, че това е отличен пример за това, че винаги може и трябва да се намерят съмишленици, а организаторите на HighLoad++ ще продължават да се стараят да създават атмосфера, благоприятстваща за това.
За процеса
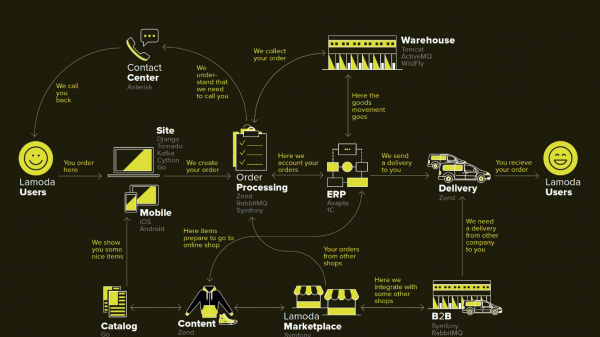
Lamoda е голяма електронна търговска платформа, която разполага със собствен контакт-център, служба за доставка (и множество партньори), фотостудия, огромен склад и всичко това работи на собствен софтуер. Има десетки начини на плащане, B2B партньори, които могат да ползват част или всички от тези услуги и желаят да знаят актуалната информация за своите стоки. Освен това, Lamoda оперира в три страни освен Русия и там всичко е малко по-различно. В крайна сметка съществуват вероятно над сто начина за конфигуриране на нова поръчка, която трябва да бъде обработена по уникален начин. Всичко това работи с помощта на десетки услуги, които комуникират понякога по неясен начин. Има и централна система, чиято основна отговорност е статутите на поръчките. Ние я наричаме BOB, и аз работя с нея.
Refund Tool with events-driven API
Думата events-driven е доста преекспонирана, малко по-надолу ще уточним какво точно имаме предвид. Ще започна с контекста, в който решихме да опитаме подхода events-driven API в Kafka.
Във всеки магазин, освен поръчките, за които клиентите плащат, има моменти, когато от магазина се изисква да върне пари, защото продуктът не е подходящ за клиента. Този сравнително кратък процес: уточняваме информацията, ако е необходимо, и прехвърляме парите.
Но връщането стана по-сложно заради измененията в законодателството, и ние трябваше да реализираме отделен микросервис за него.
Нашата мотивация:
- Закон FZ-54 — накратко, законът изисква да се уведомява данъчната служба за всяка парична операция, независимо дали е връщане или постъпление, в сравнително кратък SLA от няколко минути. Ние, като e-commerce, извършваме доста много операции. Технически това означава нова отговорност (значи нов сервис) и доработки във всички засегнати системи.
- BOB split — вътрешен проект на компанията за освобождаване на BOB от голям брой непрофесионални отговорности и намаляване на неговата обща сложност.
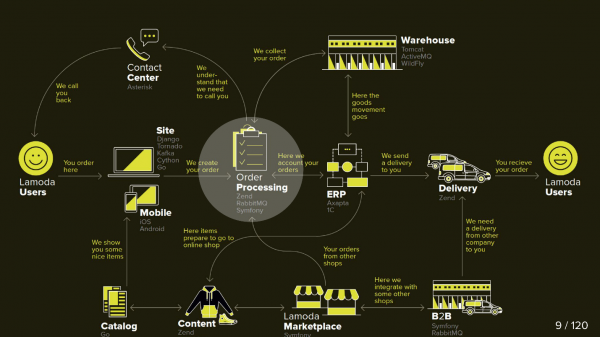
На тази схема са изобразени основните системи на Lamoda. В момента повечето от тях представляват по-скоро звездно съзвездие от 5-10 микросервиза около намаляващия монолит. Те бавно нарастват, но ние се стараем да ги направим по-малко, защото деплойването на отделен фрагмент в средата е страшно — не може да се допусне да се срине. Всички обменци (стрелки) сме принудени да резервираме и да се подготвим за факта, че всеки от тях може да стане недостъпен.
В BOB също така има доста много обменци: системи за плащане, доставка, известия и т.н.
Технически BOB е:
- ~150k реда код + ~100k реда тестове;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 изходящи интеграции;
- 4 държави със своя бизнес логика.
Деплонирането на BOB е скъпо и болезнено, количеството код и задачите, които решава, са такива, че никой не може да го вкара в главата си изцяло. Общо взето, има много причини да се опрости.
Процес на връщане
Първоначално в процеса са ангажирани две системи: BOB и Payment. Сега се появяват още две:
- Fiscalization Service, който ще поеме проблемите с фискализацията и общуването с външни услуги.
- Refund Tool, в който просто се прехвърлят нови обменци, за да не се разширява BOB.
Сега процесът изглежда така:
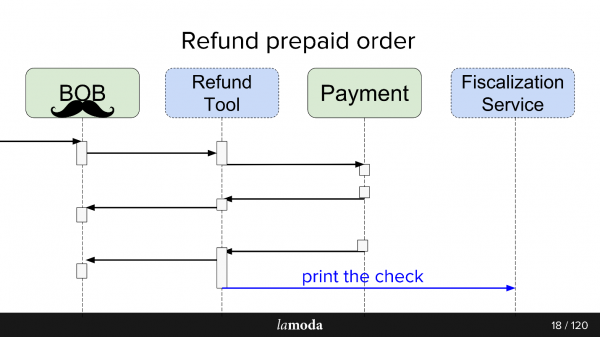
- Към BOB идва заявка за връщане на пари.
- BOB уведомява Refund Tool.
- Refund Tool казва на Payment: «Върни парите».
- Payment връща парите.
- Refund Tool и BOB синхронизират статусите помежду си, защото все още и двамата се нуждаят от това. Все още не сме готови да преминем изцяло в Refund Tool, тъй като в BOB има UI, отчети за счетоводството и по принцип много данни, които не могат да бъдат преместени просто така. Налага се да седим на два стола.
- Изпраща се заявка за фискализация.
В крайна сметка, създадохме нещо като шина на събитията на Kafka - event-bus, на която всичко е свързано. Ура, сега имаме единна точка на отказ (сарказъм).
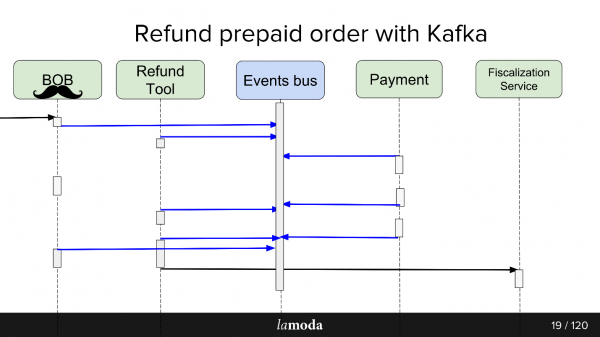
Плюсовете и минусите са доста очевидни. Създадохме шина, което означава, че сега всички услуги зависят от нея. Това опростява проектирането, но внася в системата единна точка на отказ. Ще падне Kafka, процесът ще спре.
Какво е events-driven API
Добър отговор на този въпрос има в доклада на Мартин Фаулър (GOTO 2017) .
Накратко, какво направихме:
- Обвихме всичките асинхронни обменни операции чрез events storage. Вместо да информираме по мрежата всеки заинтересован потребител за промяна на статуса, пишем в централизирано хранилище събитие за промяна на състоянието, а заинтересованите потребители четат всичко, което се появява оттам.
- Събитие (event) в случая е уведомление (notifications) за това, че нещо někъде се е променило. Например, променен е статусът на поръчката. Потребителят, на когото му е важна някаква свързана с промяната на статуса информация, но която не е в уведомлението, може сам да разбере състоянието им.
- Максималният вариант - пълно event sourcing, state transfer, при който събитие съдържа цялата информация, необходима за обработка: откъде и в какъв статус е преминало, как точно са променени данните и т.н. Въпросът е само в целесъобразността и обема на информацията, която можете да си позволите да съхранявате.
В рамките на старта на Refund Tool използвахме третия вариант. Това опрости обработката на събития, тъй като не беше нужно да извличаме подробна информация, плюс че елиминира сценарий, при който всяко ново събитие предизвиква изблик на уточняващи get-заявки от потребителите.
Сервисът Refund Tool не е натоварен, затова Kafka там е по-скоро проба на перо, отколкото необходимост. Не мисля, че, ако сервисът за връщане на средства стане highload-проект, бизнесът ще се зарадва.
Асинхронен обмен AS IS
За асинхронни обмени, PHP отделът обикновено използва RabbitMQ. Събираме данни за заявката, поставяме ги в опашката и консумиращият от същия сервис ги счете и изпрати (или не изпрати). За самия API Lamoda активно използва Swagger. Проектираме API, описваме го в Swagger, генерираме клиентски и сървърен код. Също така използваме малко разширен JSON RPC 2.0.
Къде-къде се използват esb-шини, някой живее на activeMQ, но като цяло, RabbitMQ - стандарт.
Асинхронен обмен TO BE
При проектиране на обмена чрез events-bus, се проследява аналогия. По подобен начин описваме бъдещия обмен на данни чрез описания на структурата на събитията. Форматът yaml, кодогенерацията трябваше да се направи от нас, генераторът по спецификация създава DTO и обучава клиентите и сървърите да работят с тях. Генерацията се извършва на два езика - golang и php. Това позволява поддържането на библиотеките в съгласие. Генераторът е написан на golang, за което получи името gogi.
Event-sourcing на Kafka - типичен пример. Има решение от основната enterprise версия на Kafka Confluent, има , решение от нашите "братя" по домейн област Zalando. Нашата мотивация да започнем с vanilla Kafka е да оставим решението безплатно, докато окончателно не решим ще го използваме ли широко и също така да оставим пространство за маневри и доработки: ние искаме поддръжка на нашия JSON RPC 2.0, генератори за два езика и ще видим какво още.
Иронично е, че дори в такъв щастлив случай, когато съществува приблизително аналогичен бизнес като Zalando, който е направил приблизително подобно решение, ние не можем да го използваме ефективно.
Архитектурно на старта паттернът е такъв: четем директно от Kafka, но пишем само чрез events-bus. За четене в Kafka има много готово: брокери, балансировачи и тя е по-скоро готова за хоризонтално мащабиране, това искахме да запазим. Записът обаче, искахме да обгърнем през един Gateway aka Events-bus, и ето защо.
Events-bus
Или автобус на събитията. Това е просто stateless http gateway, който поема няколко важни роли:
- Валидация на продуцирането — проверяваме, че събитията отговарят на нашата спецификация.
- Мастер-система по събитията, тоест това е главната и единствена система в компанията, която отговаря на въпроса, кои събития с какви структури се считат за валидни. В валидацията влизат просто типове данни и enums за строга спецификация на съдържанието.
- Hash-функция за шардирование - структурата на съобщението Kafka е key-value и по хеша от ключа се изчислява, къде да се постави.
Защо
Работим в голяма компания с установен процес. Защо да променяме нещо? Това е експеримент, и ние се надяваме да получим някои ползи.
1:n+1 обмени (един към много)
С Kafka е много лесно да свържеш нови потребители към API.
Да предположим, че имате справочник, който трябва да поддържате актуален в няколко системи едновременно (и в нови системи). По-рано измисляхме bundle, който реализираше set-API, а на основната система съобщавахме адресите на потребителите. Сега основната система изпраща актуализации в тема, а всички, на които им е интересно, четат. Появи се нова система — записахме я за темата. Да, също bundle, но по-просто.
В случая с refund-tool, който е част от BOB, удобно е да ги поддържаме синхронизирани през Kafka. Плащането заявява, че парите са върнати: BOB и RT научават за това, променят си статусите, Фискализационната служба научава и генерира чек.
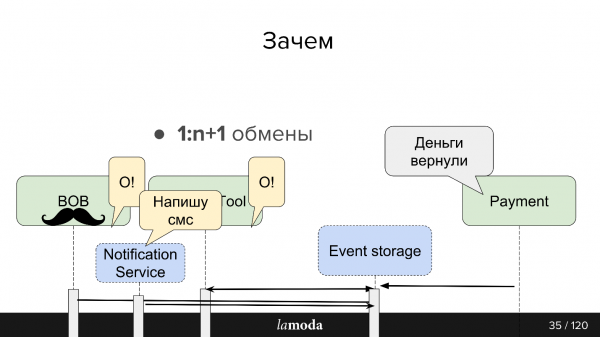
Имаме планове да направим единен Notifications Service, който да уведомява клиента за новините по неговата поръчка/върната стока. В момента тази отговорност е разпръсната между системите. Ще е достатъчно да научим Notifications Service да извлича от Kafka релевантна информация и да реагира на нея (и да изключим тези известия в останалите системи). Никаки нови преки обменни не са необходими.
Data-driven
Информацията между системите става прозрачна — каквато и да е „кървава компания“ пред вас и какъвто и да е вашият обемен backlog. В Lamoda има отдел Data Analytics, който събира данни от системите и ги поставя в рециклиран вид, както за бизнеса, така и за интелигентните системи. Kafka позволява бързо да им предоставим много данни и да поддържаме този информационен поток актуален.
Replication log
Съобщенията не изчезват след прочитане, както в RabbitMQ. Когато събитието съдържа достатъчно информация за обработка, имаме история на последните промени по обекта и, при желание, възможност да приложим тези промени.
Срокът за съхранение на replication log зависи от интензивността на записите в тази тема, Kafka позволява гъвкаво да настроим лимити по време на съхранение и по обем на данни. За интензивни теми е важно всички потребители да успяват да прочетат информацията преди да изчезне, дори в случай на краткосрочна неработоспособност. Обикновено се получава да се съхраняват данни за единици дни, което е напълно достатъчно за поддръжка.
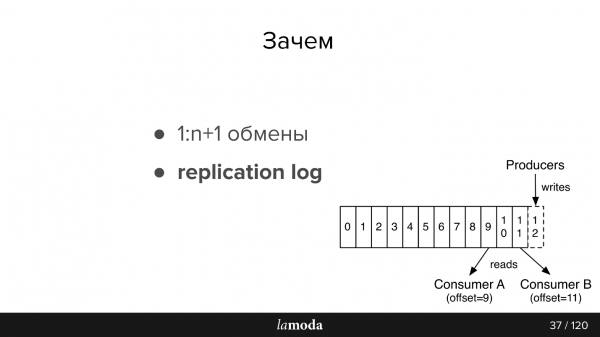
Следва малко резюме на документацията, за тези, които не са запознати с Kafka (картинката също е от документацията)
В AMQP има опашки: пишем съобщения в опашка за консумиращия. Обикновено, една опашка се обработва от една система с една и съща бизнес логика. Ако е необходимо да се уведоми няколко системи, може да се научи приложението да пише в няколко опашки или да се настрои exchange с механизъм fanout, който сам ги клонира.
В Kafka има подобна абстракция тема, в която пишете съобщения, но те не изчезват след прочитането. По подразбиране, когато се свържете с Kafka, получавате всички съобщения, а също така имате възможност да запазите мястото, на което сте спрели. Тоест, четете последователно, можете да не отбележите съобщението за прочетено, но да запазите id, от което после ще продължите четенето. Id, на което сте спрели, се нарича offset (изместване), а механизмът - commit offset.
Съответно, може да се реализира различна логика. Например, нашият BOB съществува в 4 инстанции за различни страни - Lamoda е в Русия, Казахстан, Украйна, Беларус. Тъй като те се разполагат отделно, имат малко свои конфигурации и своя бизнес логика. Указваме в съобщението, към коя страна принадлежи. Всеки консумиращ BOB в всяка страна чете с различни groupId, и, ако съобщението не го касае, го пропуска, т.е. веднага комитва offset +1. Ако същата тема чете нашият Payment Service, тогава той го прави с отделна група, и затова offset не се пресичат.
Изисквания към събитията:
- Пълнота на данните. Искаме събитията да имат достатъчно данни, за да могат да бъдат обработени.
- Цялостност. Делегираме Events-bus проверката на това, че събитието е последователно и той може да го обработи.
- Порядъкът е важен. В случай с връщането сме принудени да работим с историята. С нотификациите редът не е важен, ако това са хомогенни нотификации, имейлът ще бъде един и същ независимо от това, кой поръчка е пристигнала първа. В случай на връщане има ясен процес, ако променим реда, то ще възникнат изключения, refund няма да се създаде или обработи - ще попаднем в друг статус.
- Последователност. Имаме хранилище и сега вместо API създаваме събития. Трябва ни начин за бърз и евтин трансфер на информация за новите събития и за промените в съществуващите ни услуги. Това се постига с помощта на обща спецификация в отделен git-репозитори и кодогенератори. Затова клиентите и сървъри в различните услуги при нас са съгласувани.
Kafka в Lamoda
Имаме три инсталации на Kafka:
- Логове;
- изследвания и развитие;
- Events-bus.
Днес говорим само за последния елемент. В events-bus имаме не много големи инсталации - 3 брокера (сървъра) и общо 27 теми. Обикновено, една тема е един процес. Но това е деликатен момент, и сега ще го обсъдим.
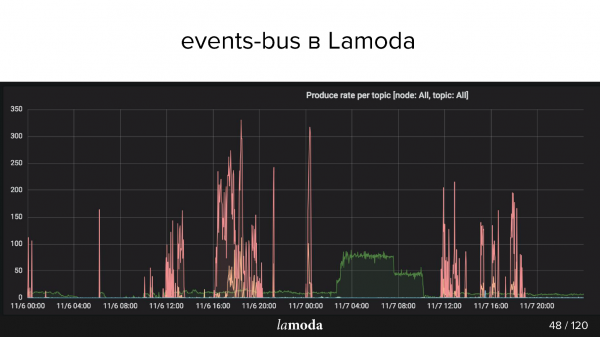
По-горе е графикът на rps. Процесът на връщане е маркиран с цианова линия (да, да, онзи, който лежи на ос X), а розовата линия - процесът на обновяване на съдържанието.
Каталогът на Lamoda съдържа милиони продукти и данните се обновяват непрекъснато. Някои колекции излизат от мода, на тяхно място се пускат нови, в каталога постоянно се появяват нови модели. Ние се опитваме да предвидим какво ще бъде интересно за нашите клиенти утре, затова постоянно закупуваме нови вещи, ги снимаме и обновяваме витрината.
Розовите пикове - това са продуктови обновления, тоест промени по стоките. Лично се вижда, че екипът е снимал, снимал, а после изведнъж! - качили са пакет събития.
Случаи на използване на Lamoda Events
Изградената архитектура използваме за такива операции:
- Проследяване на статусите на връщания: call-to-action и проследяване на статусите от всички ангажирани системи. Плащане, статуси, фискализация, уведомления. Тук опитахме един подход, създадохме инструменти, събрахме всички бъгове, написахме документация и обяснихме на колегите как да ги използват.
- Обновяване на картите на продукта: конфигурация, мета-данни, характеристики. Чете се от една система (която показва), а пишат няколко.
- Имейл, push и SMS: поръчката е събрана, поръчката е достигнала, връщането е прието и т.н., много от тях.
- Склад, обновление на наличностите — количествено обновление на имената, просто числа: постъпления на склада, връщане. Нужно е всички системи, свързани с резервирането на стоките, да работят с максимално актуални данни. В момента системата за обновление на стока е доста сложна, Kafka ще я опрости.
- Анализ на данни (R&D отдел), ML инструменти, аналитика, статистика. Искаме информацията да е прозрачна - за това Kafka е подходящ.
Сега идва интересната част за опитите и интересните открития, които се случиха през последните шест месеца.
Проблеми с проектиране
Да предположим, че искаме да направим нещо ново - например, да преместим целия процес на доставка на Kafka. В момента част от този процес се реализира в Order Processing в BOB. Зад предаването на поръчката на куриерската служба, движението към междинния склад и други стъпки стои статусна модел. Има цял монолит, дори два, плюс много API, посветени на доставката. Те знаят много повече за доставките.
Изглежда, че тези области са сходни, но статусите за Order Processing в BOB и за системата за доставка се различават. Например, някои куриерски услуги не изпращат междинни статуси, а само финални: 'доставено' или 'изгубено'. Други, обратното, предоставят много подробни отчети за движението на стоката. Всеки има свои правила за валидация: за някои валиден имейл означава, че ще го обработят; за други - невалиден, но поръчката все пак ще бъде обработена, защото има телефон за връзка, а трети казват, че таква поръчка изобщо няма да бъде обработена.
Данни поток
При Kafka възниква въпросът за организацията на данните поток. Тази задача е свързана с избор на стратегия по няколко точки, ще ги обсъдим всички.
В един топик или в различни?
Имаме спецификация за събитие. В BOB пишем, че определена поръчка трябва да бъде доставена, и посочваме: номер на поръчката, състав, някои SKU и баркодове и т.н. Когато стоката пристигне на склада, доставката ще може да получи статуси, времеви марки и всичко необходимо. Но след това искаме в BOB да получаваме обновления по тези данни. Възниква обратен процес на получаване на данни от доставката. Това ли е същото събитие? Или е отделна размяна, която заслужава отделен топик?
Скорее е, че те ще бъдат много сходни, и изкушението да направим един топик не е неоправдано, защото отделен топик означава отделни консуматори, отделни конфигурации, отделно генериране на всичко това. Но не е факт.
Ново поле или ново събитие?
Но ако използваме същите събития, възниква друг проблем. Например, не всички системи за доставка могат да генерират такова DTO, което да може да генерира BOB. Ние им изпращаме id, а те не ги запазват, защото не им трябват, а от гледна точка на стартирането на процеса event-bus това поле е задължително.
Ако въвеждаме правило за event-bus, че това поле е задължително, принудени сме в BOB или в обработчика на стартовото събитие да поставим допълнителни правила за валидация. Валидацията започва да се разпространява из услугата — това не е много удобно.
Още един проблем е изкушението на инкременталната разработка. Казват ни, че трябва да добавим нещо в събитието, и, може би, ако помислим хубаво, това трябваше да бъде отделно събитие. Но в нашата схема отделно събитие — това е отделна тема. Отделна тема — това е целият процес, който описах по-горе. У разработчика възниква изкушението просто да добави още едно поле в JSON схемата и да я регенерира.
В случая с refunds така за половин година достигнахме до събитие на събития. Имахме едно мета-събитие, което се нарича refund update, в което имаше поле type, описващо в какво всъщност се състои този ъпдейт. От това имахме „прекрасни“ превключватели с валидатори, които казваха как трябва да се валидира това събитие с този type.
Версиониране на събития
За валидиране на съобщения в Kafka може да се използва , но трябваше да предвидим това веднага и да използваме Confluent. В нашия случай с версионирането трябва да сме внимателни. Не винаги ще е възможно да прочетем съобщенията от replication log, защото моделът „вече е изчезнал“. Основно, се стараем да изградим версиите така, че моделът да е обратно съвместим: например, да направим полето временно незадължително. Ако разликите са твърде големи, започваме да пишем в нова тема, а клиентите мигрират, когато прочетат стария.
Гаранция за реда на четене на partitions
Темите в Kafka са разделени на partitions. Това не е особено важно, докато проектираме сущности и обмен, но е важно, когато решаваме как да ги консумираме и мащабираме.
В обикновен случай вие пишете в Kafka една тема. По подразбиране се използва една партиция и всички съобщения от тази тема попада в нея. А консумиращият съответно последователно чете тези съобщения. Да кажем, сега трябва да разширим системата, така че съобщенията да се четат от двама различни консумиращи. Ако например изпращате SMS, можете да кажете на Kafka да направи допълнителна партиция и Kafka ще започне да разпределя съобщенията на две части – половината там, половината тук.
Как Kafka ги разделя? Всяко съобщение има съдържание (в което съхраняваме JSON) и имаме ключ. Към този ключ можете да приложите хеш-функция, която ще определя в коя партиция ще попадне съобщението.
В нашия случай с възстановявания това е важно; ако вземем две партиции, има шанс, че паралелният консумиращ ще обработи второто събитие преди първото и ще възникне проблем. Хеш-функцията гарантира, че съобщенията с един и същ ключ ще попаднат в една и съща партиция.
Събития срещу команди
Това е още един проблем, с който се сблъскахме. Събитие – това е нещо, което се е случило: ние казваме, че нещо е станало (something_happened), например, артикулът е отменен или е настъпило възстановяване. Ако тези събития някой ги слуша, по "артикулът е отменен" ще бъде създадена сущност възстановяване, а "настъпило е възстановяване" ще бъде записано някъде в настройките.
Но обикновено, когато проектирате събития, вие не искате да ги пишете напразно – вие разчитате, че някой ще ги прочете. Силно е изкушението да не пишете something_happened (item_canceled, refund_refunded), а something_should_be_done. Например, артикулът е готов за връщане.
От една страна, това подказва как събитието ще бъде използвано. От друга страна, това изглежда много по-малко като нормално название на събитие. Освен това, оттук вече е близо до команда do_something. Но вие нямате гаранция, че това събитие някой го е прочел; а ако го е прочел, то го е прочел успешно; а ако го е прочел успешно, то направил е нещо и това нещо е преминало успешно. В момента, когато събитието стане do_something, става необходима обратна връзка и това е проблем.
В асинхронен обмен в RabbitMQ, когато прочетете съобщение, отидете на http, вие имате отговор – поне, че съобщението е било прието. Когато запишете в Kafka, имате съобщение, че сте записали в Kafka, но какво се е случило след това не знаете.
Затова в нашия случай трябваше да въведем отговорно събитие и да настроим мониторинг, за да следим, че ако излязат толкова събития, след такова време трябва да постъпят и толкова отговорни събития. Ако това не се случи, изглежда, че нещо е тръгнало наопаки. Например, ако изпратим събитието „item_ready_to_refund“, очакваме, че refund ще бъде създаден, клиентът ще получи парите обратно, а на нас ще излезе събитието „money_refunded“. Но това не е точно, затова е нужен мониторинг.
Нюанси
Има доста очевиден проблем: ако четете от топика последователно и имате лошо съобщение, консуматорът спира, и не можете да продължите. Нужно е да спрете всички консуматори, да комитирате offset по-нататък, за да продължите да четете.
Знаехме за това, планирахме го, и въпреки всичко се случи. А стана, защото събитието беше валидно от гледна точка на events-bus, събитието беше валидно от гледна точка на валидатора на приложението, но не беше валидно от гледна точка на PostgreSQL, защото в една система MySQL с UNSIGNED INT, а в новосъздадената система имаше PostgreSQL просто с INT. Той има малко по-малък размер, и Id не се побра. Symfony умря с изключение. Разбира се, хванахме изключението, защото бяхме предвидили това, и искахме да комитираме този offset, но преди това искахме да инкрементираме брояча на проблемите, понеже съобщението се обработи неуспешно. Броячите в този проект също са в базата, а Symfony вече закри комуникацията с базата, и второто изключение уби целия процес без шанс за комитване на offset.
Някакво време сървисът почиваше — за щастие, с Kafka това не е толкова страшно, защото съобщенията остават. Когато работата се възстанови, може да се дочетат. Това е удобно.
Kafka има възможност чрез инструментите да настрои произволен offset. Но за да го направите, трябва да спрете всички консуматори — в нашия случай да приготвите отделен релиз, в който няма да има консуматори, redeployments. Тогава в Kafka чрез инструментите може да се смести offset и съобщението ще премине.
Друг нюанс — replication log срещу rdkafka.so — свързан е със спецификата на нашия проект. Ние ползваме PHP, а в PHP обикновено всички библиотеки комуникират с Kafka чрез репозиторий rdkafka.so, след което има някаква обвивка. Може би това са нашите лични трудности, но се оказа, че просто да преразгледаш част от вече прочетеното не е толкова лесно. В общи линии, имахме софтуерни проблеми.
Връщайки се към особеностите на работата с partitions, направо в документацията е написано consumers >= topic partitions. Но научих за това много по-късно, отколкото бих искал. Ако искате да мащабирате и имате двама консьюмера, ви трябват поне два partitions. Тоест, ако сте имали един partition, в който са се натрупали 20 хиляди съобщения, и сте направили нов, броят на съобщенията ще се изравни поравно не скоро. Ето защо, за да имате два паралелни консьюмера, трябва да разбирате от partitions.
Мониторинг
Мисля, че по начина, по който наблюдаваме, ще бъде още по-ясно какви проблеми има в съществуващия подход.
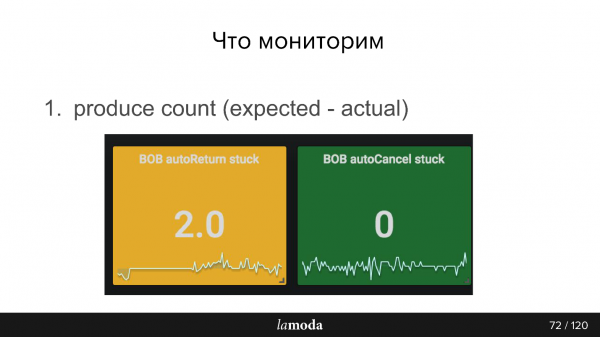
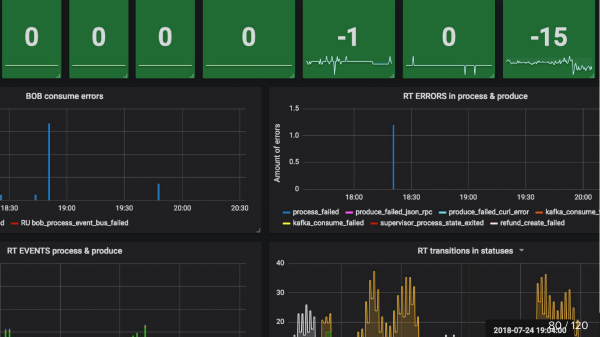
Например, смятаме колко стоки в базата наскоро са променили статус, и съответно, по тези промени са се случили събития, и изпращаме това число в нашата система за мониторинг. След това от Kafka получаваме второ число, колко наистина са били записани събития. Очевидно разликата между тези две числа винаги трябва да е нулева.
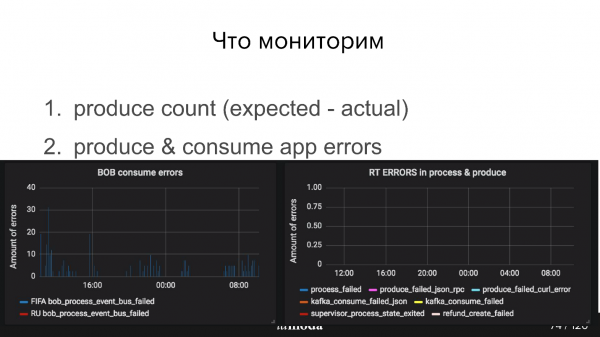
Освен това, трябва да наблюдаваме как се справя продюсерът, дали events-bus е приел съобщенията, и как е положението при консьюмера. Например, на графиките по-долу при Refund Tool всичко е наред, а при BOB очевидно има проблеми (сините върхове).
Вече споменах consumer-group lag. Грубо казано, това е броят на непрочетените съобщения. По принцип консьюмерите работят бързо, затова лагът обикновено е равен на 0, но понякога може да има кратковременен пик. Kafka умее да справя с това направо от кутията, но трябва да зададете определен интервал.
Има проект , който ще ви предостави повече информация за Kafka. Той просто по API по consumer-group дава статус, как стоят нещата с тази група. Освен OK и Failed там има warning, и ще можете да разберете, че вашите консьюмери не справят с темпото на продюсинга - не успяват да прочитат това, което се записва. Системата е доста умна, удобно е да се ползва.
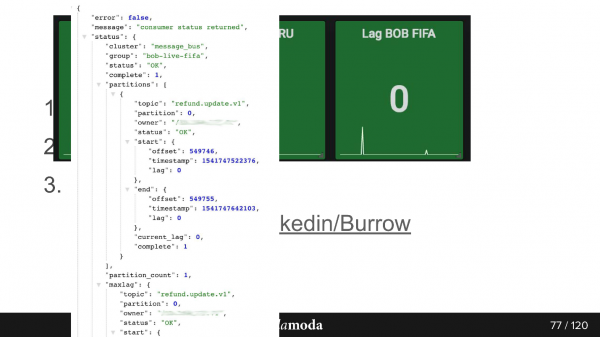
Така изглежда отговорът по API. Тук групата е bob-live-fifa, partition refund.update.v1, статус OK, lag 0 - последният конечен offset е такъв.
Мониторинг updated_at SLA (stuck) Аз вече споменах. Например, продуктът е преминал в статус, че е готов за връщане. Настройваме Cron, който казва, че ако за 5 минути този обект не е преминал в refund (възстановяваме парите чрез платежни системи много бързо), то нещо определено е излязло извън ред и това е определено случай за поддръжката. Затова просто взимаме Cron, който чете такива неща, и ако те са повече от 0, изпраща аларма.
За да обобщим, използването на събития е удобно, когато:
- информацията е нужна на няколко системи;
- резултатът от обработката не е важен;
- събитията са малко или събитията са малки.
Изглежда, че статията има съвсем конкретна тема - асинхронен API на Kafka, но поради нея искам веднага да препоръчам много неща.
На първо място, следващият на трябва да чакаме до ноември, вече през април ще има неговата питерска версия, а през юни ще говорим за високи натоварвания в Новосибирск.
На второ място, авторът на доклада Сергей Заика е член на Програмния комитет на нашата нова конференция за управление на знанията . Конференцията е еднодневна, ще се проведе на 26 април, но програмата ѝ е много наситена.
А също така през май ще бъде и (с DevOpsConf в състава) - там все още можете да предложите своята тема, да разкажете за своя опит и да се оплачетe от набитите си шишенца.
Източник: habr.com
