

В нашите проекти използваме микросервисна архитектура. При възникване на тесни места в производителността, голяма част от времето се отделя за мониторинг и анализ на логовете. При логването на тайминги на отделни операции в лог-файл, обикновено е трудно да се разбере какво е довело до извикването на тези операции, да се проследи последователността на действията или времевото изместване на една операция спрямо друга в различни услуги.
За да минимизираме ръчния труд, решихме да се възползваме от един от инструментите за трасировка. За това как и за какво може да се използва трасировката и как го направихме, ще стане дума в тази статия.
Кои проблеми могат да бъдат решени с помощта на трасировка
- Да се открият тесни места в производителността както вътре в една услуга, така и във всичките участващи услуги в изпълнителното дърво. Например:
- Много кратки последователни извиквания между услугите, например при геокодиране или при заявка към базата данни.
- Дълги изчаквания за вход и изход, например, предаване на данни по мрежата или четене от диск.
- Дълго парсване на данни.
- Дълги операции, изискващи CPU.
- Части от кода, които не са необходими за получаване на крайния резултат и могат да бъдат премахнати или стартирани отложено.
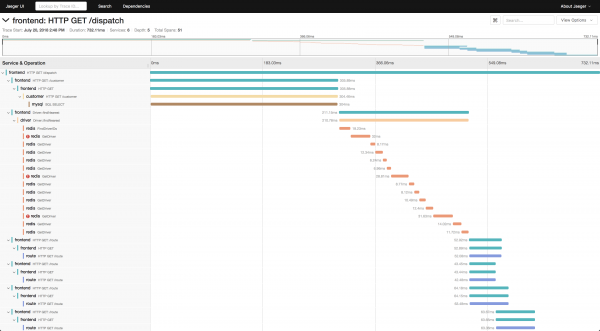
- Да се разбере на каква последователност какво се извиква и какво се случва, когато се извършва операция.

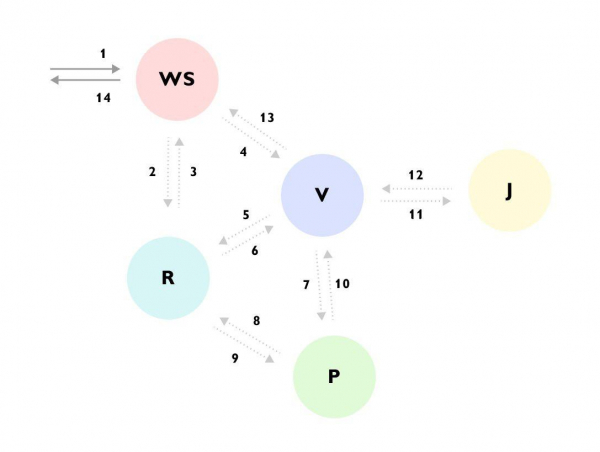
Вижда се, че например, Заявка е пристигнала в услуга WS -> услуга WS е допълнила данните чрез услуга R -> след това е изпратила заявка в услуга V -> услуга V е заредила много данни от услуга R -> след това е отишла в услуга P -> услуга P е посетила отново услуга R -> услуга V е игнорирала резултата и е отишла в услуга J -> и едва след това е върнала отговор на услуга WS, като в същото време продължава да изчислява нещо друго на заден план.
Без такава трасировка или подробна документация за целия процес, е много трудно да се разбере какво се случва, при първия поглед на кода, и самият код е разпръснат в различни услуги и е скрит зад куп бинове и интерфейси. - Събиране на информация за дереца за изпълнение за последващ отложен анализ. На всеки етап от изпълнението може да се добави информация в трасировката, която е налична на този етап и след това да се разбере какви входни данни са довели до подобен сценарий. Например:
- ID на потребителя
- Права
- Тип на избрания метод
- Лог или грешка при изпълнението
- Превръщането на трасетата в подмножество метрики и последващият анализ вече под формата на метрики.
Какво може да логира трасировката. Span
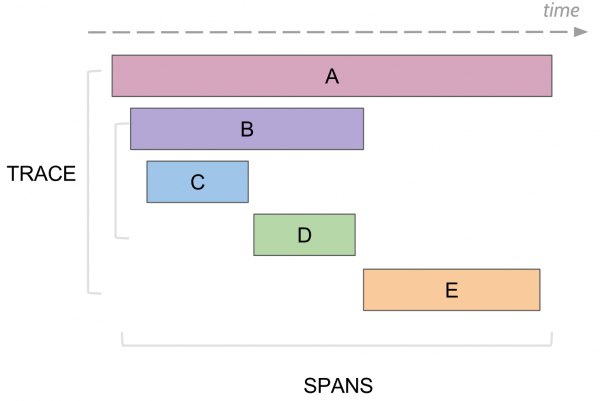
В трасировката съществува понятието span, което е аналог на един лог, в консолата. Span има:
- Име, обикновено това е името на метода, който е бил изпълнен
- Име на услугата, в която е бил генериран span
- Собствен уникален ID
- Някаква мета информация под формата key/value, която е била залогирана в него. Например, параметри на метода или дали методът е завършил с грешка или не
- Време на начало и край на изпълнението на този span
- ID на родителския span
Всеки span се изпраща в колектор на spans за запазване в база за последващ преглед, веднага след като е завършил изпълнението си. Впоследствие може да се изгради дърво на всички spans, свързвайки ги по ID на родителя. При анализа може да се намерят, например, всички spans в дадена услуга, които са отнели повече от определено време. След това, преминавайки към конкретен span, може да видите цялото дърво над и под този span.
Opentrace, Jaeger и как ние реализирахме това за нашите проекти
Съществува общ стандарт , който описва как и какво трябва да се събира, без да свързва трасировката с конкретна реализация в даден език. Например, в Java цялата работа с трасетата се извършва чрез общ API Opentrace, а под него може да се крие, например, Jaeger или празна дефолтна реализация, която не прави нищо.
Ние използваме като имплементация на Opentrace. Той се състои от няколко компонента:
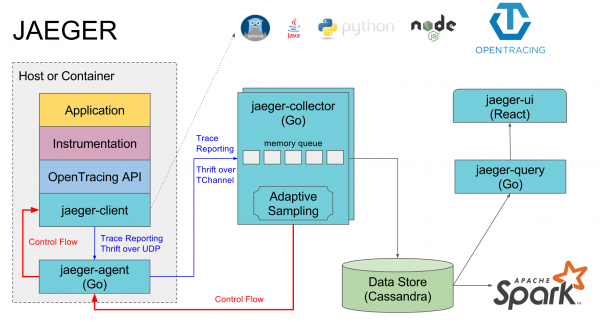
- Jaeger-agent — локален агент, който обикновено е на всяка машина и в него логира услугите на локалния дефолтен порт. Ако агента няма, то трасетата на всички услуги на тази машина обикновено са изключени.
- Jaeger-collector — в него всички агенти изпращат събраните трасета, а той ги поставя в избраната база данни
- Базата данни — предпочитана от тях е Cassandra, но ние използваме Elasticsearch, има реализации още за няколко други бази данни и in-memory реализация, която не запазва нищо на диск
- Jaeger-query — това е услуга, която извършва запитвания към базата данни и предоставя вече събраните трасета за анализ
- Jaeger-ui — това е уеб интерфейс за търсене и преглед на трасета, той извършва запитвания към jaeger-query
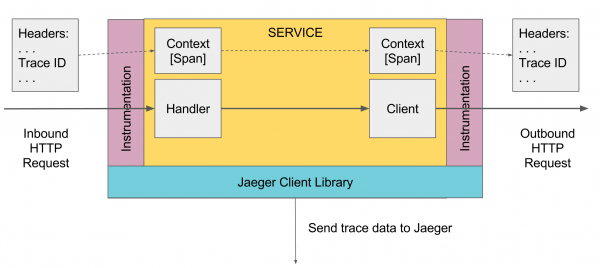
Отделен компонент може да се нарече реализация на opentrace jaeger за конкретни езици, чрез която spans се изпращат в jaeger-agent.
се свежда до имплементиране на интерфейса io.opentracing.Tracer, след което всички трасета ще се изпращат към реален агент чрез него.
Също така, за Spring компонентите може да се включи и имплементацията от Jaeger която автоматично ще конфигурира трасировката за всичко, което преминава през тези компоненти, включително HTTP заявки към контролерите, заявки към БД чрез jdbc и т.н.
Логване на трасета в Java
Някъде на най-високото ниво трябва да се създаде първият Span, което може да стане автоматично, например от Spring контролера при получаване на заявка, или ръчно, ако такъв не съществува. След това той се предава надолу по Scope. Ако някой метод по-долу иска да добави Span, той взима текущия activeSpan от Scope, създава нов Span и задава активния Span като родителски, след което прави новия Span активен. При извикване на външни услуги им се предава текущият активен Span, а тези услуги създават нови спанове, свързани с този Span.
Цялата работа става чрез инстанса Tracer, който може да бъде получен чрез механизма DI или GlobalTracer.get() като глобална променлива, ако механизмът DI не работи. По подразбиране, ако tracer не е инициализиран, ще се върне NoopTracer, който не прави нищо.
След това от tracer чрез ScopeManager се извлича текущият scope, създава се нов scope от текущия с привязка на новия span, а по-късно създаденият Scope се затваря, което затваря създадения Span и възстановява предишния активен Scope. Scope е свързан с нишката, затова при многопоточна програма не забравяйте да предавате активния span в друга нишка за последваща активация на Scope на друга нишка, свързана с този span.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Неща.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // СТЪПКА 2 ОТГОРЕ: реактивиране на Span в callback, предавайки true на
            // startActive() при/когато Span трябва да бъде завършен.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
За многопоточно програмиране съществува и TracedExecutorService, и подобни обвивки, които автоматично предават текущия спан в потока при стартиране на асинхронни задачи:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
За външни http заявки има
HttpClient httpClient = new TracingHttpClientBuilder().build();Проблеми, с които се сблъскваме
- Биновете и DI не винаги работят, ако трасерът не се използва в услуга или компонент, тогава Трасерът може да не работи и ще се налага да използвате GlobalTracer.get().
- Анотациите не работят, ако не са компонент или услуга, или ако извикването на метода се извършва от съседен метод на същия клас. Трябва да бъдете внимателни, да проверявате какво работи и да използвате ръчно създаване на трасета, ако @Traced не работи. Можете също така да добавите допълнителен компилатор за java анотации, тогава трябва да работят навсякъде.
- В старите spring и spring boot не работи автоматичната конфигурация на opentracing spring cloud поради бъгове в DI, затова, ако искате автоматично да работят трасетата в spring компонентите, можете да направите по аналогия с
- В groovy не работи try with resources, трябва задължително да се използва try finally.
- Всеки услуга трябва да зададе своето spring.application.name, под което ще се логват трасетата. Освен това, отделно име за прод и тест, за да не се смесват.
- Ако използвате GlobalTracer и tomcat, тогава всички услуги, стартирани в този tomcat, имат един GlobalTracer, следователно те ще имат едно и също име на услугата.
- При добавяне на трасета в метод, трябва да се уверите, че той не се извиква много пъти в цикъл. Трябва да добавите едно общо трасетo за всички извиквания, което да логира общото време на работа. В противен случай ще се създаде излишно натоварване.
- Веднъж в jaeger-ui правихме твърде големи заявки на голямо количество трасета и, тъй като не чакахме отговор, направихме отново. В резултат jaeger-query започна да яде много памет и забавяше еластика. Помогна рестартиране на jaeger-query.
Семплиране, съхранение и преглед на трасета
Има три типа :
- Const, който изпраща и съхранява всички трасета.
- Probabilistic, който филтрира трасета с определена зададена вероятност.
- Рейт лимитинг, който ограничава броя на трасетата в секунда. Можете да настроите тези параметри на клиента, на jaeger-agent или в колектора. В момента в нашия стек валидатори се използва const 1, тъй като заявките не са много, но отнемат доста време. В бъдеще, ако това доведе до излишно натоварване на системата, можем да поставим ограничения.
Ако използвате Cassandra, по подразбиране тя съхранява трасета само за два дни. Ние използваме и трасетата се съхраняват за всичкото време и не се изтриват. За всеки ден се създава отделен индекс, например jaeger-service-2019-03-04. В бъдеще е необходимо да се настрои автоматично почистване на стари трасета.
За да видите трасета, трябва:
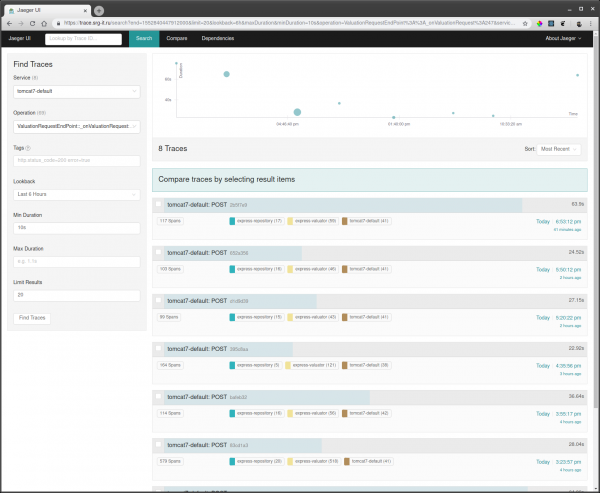
- Да изберете услугата, по която искате да филтрирате трасета, например tomcat7-default за услугата, която е стартирана в Tomcat и не може да има свое име.
- След това изберете операция, времеви интервал и минимално време на операцията, например от 10 секунди, за да вземете само дългите изпълнения.

- Преминете към едно от трасетата и вижте какво е забавило.

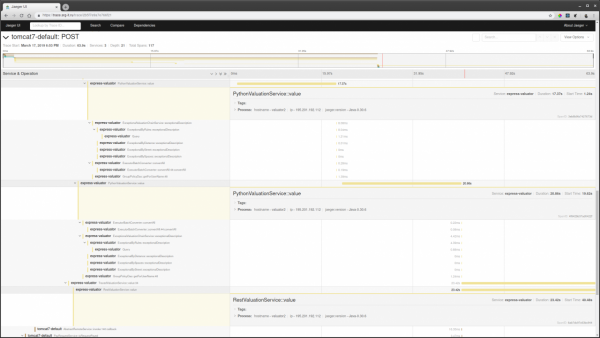
Също така, ако знаете някакво id на заявката, можете да намерите трасето по това id чрез търсене по тагове, ако това id се логва в спана на трасето.
Документация
- Документация OpenTracing
- Документация Jaeger
- Свързване на Jaeger Java
- Свързване Spring OpenTracing
Статии
- Jaeger OpenTracing и микроуслуги в реален проект на PHP и Golang
- Evolving Distributed Tracing at Uber Engineering
- Стартиране на Jaeger Agent на bare metal
Видео
- Как използвахме Jaeger и Prometheus, за да предоставим светкавично бързи заявки от потребители — Брайън Борехам
- Въведение: Jaeger — Юрий Шкуро, Uber и Павол Лофай, Red Hat
- Сергей Яковлев, “Малка история на голямата победа: OpenTracing, AWS и Jaeger”
Източник: habr.com
