

Днес повечето софтуерни продукти се разработват в екипи. Условията за успех на екипната разработка могат да бъдат представени като проста схема.
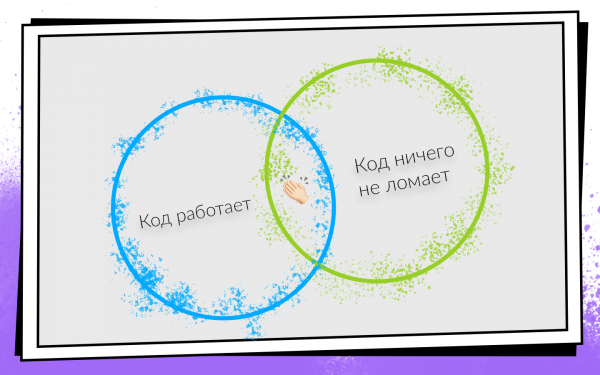
След като напишете кода, трябва да се уверите, че той:
- Работи.
- Не счупва нищо, включително кода, написан от вашите колеги.
Ако и двете условия са изпълнени, вие сте на пътя към успеха. За да проверявате лесно тези условия и да не се отклонявате от изгодния път, е измислен Continuous Integration.
CI е работен процес, при който колкото е възможно по-често интегрирате своя код в общия код на продукта. И не просто интегрирате, а също така постоянно проверявате, че всичко работи. Тъй като трябва да проверявате много и често, си струва да обмислите автоматизация. Можете да проверявате всичко ръчно, но не е удачно, и ето защо.
- Хората са скъпи. Часът работа на всеки програмист струва повече от час работа на всеки сървър.
- Хората грешат. Затова могат да възникнат ситуации, когато пуснете тестовете не на онази клонка или съберете не този комит за тестери.
- Хората мързелуват. Периодично, когато завършвам някаква задача, ми минава през ума: "Какво тук да проверявам? Написах две реда — вероятно всичко работи!" Сигурно и на вас понякога ви идват наум подобни мисли. Но проверяването е задължително.
Как внедриха и развиха Continuous Integration в екипа за мобилна разработка на Авито, как достигнаха от 0 до 450 сборки на ден и как билд-машините събират 200 часа на ден, разказва Николай Нестеров () — участник във всички еволюционни промени на CI/CD в Android приложението.
Разказът е построен на примера на Android екипа, но повечето подходи са приложими и за iOS също.
Някога в Android екипа на Авито работеше един човек. По определение на него не му беше нужна Continuous Integration: нямаше с кого да се интегрира.
Но приложението растеше, появяваха се все повече нови задачи, съответно, израстваше и екипът. В един момент дойде времето за по-формално установяване на процеса на интеграция на кода. Решението беше да се използва Git flow.
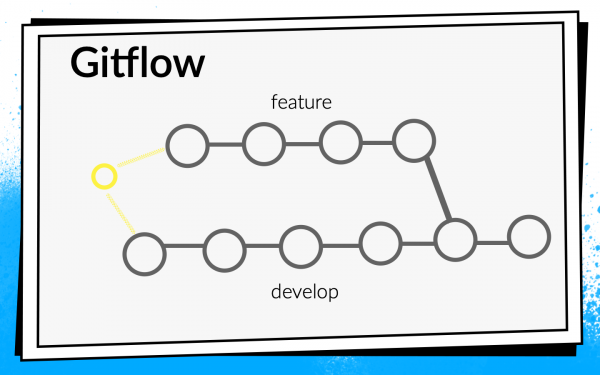
Концепцията Git flow е известна: в проекта има една обща клон develop, а за всяка нова функция разработчиците създават отделен клон, комитват в него, пушват, и когато искат да влеят своя код в клона develop, откриват pull request. За обмен на знания и обсъждане на подходи въведохме code review, т.е. колегите трябва да проверят и потвърдят кода един на друг.
Проверки
Гледането на кода с очите е страхотно, но недостатъчно. Затова се въвеждат автоматични проверки.
- Първо проверяваме сборката на АРК.
- Много Junit тестове.
- Изчисляваме code coverage, тъй като стартираме тестовете.
За да разберем как трябва да стартираме тези проверки, ще погледнем процеса на разработка в Авито.
Схематично можем да го представим така:
- Разработчикът пише код на своя лаптоп. Можем да стартираме интеграционни проверки точно тук — или с commit hook, или просто да пускаме проверки на фона.
- След като разработчикът е пушнал кода, той открива pull request. За да попада кодът му в клона develop, е необходимо да премине code review и да събере нужното количество потвърждения. Можем да включим проверки и билдове тук: докато не са успешни всички билдове, pull request не може да бъде слит.
- След като pull request бъде слит и кодът попада в develop, можем да изберем удобно време: например, през нощта, когато всички сървъри са свободни, и да стартираме проверки колкото можем.
Стартирането на проверки на собствения си лаптоп не беше на никого интересно. Когато разработчикът завърши функцията, той иска да я пушне възможно най-бързо и да открие pull request. Ако в този момент се стартират някакви дълги проверки, това не само че не е много приятно, но и забавя разработката: докато лаптопът проверява нещо, не може да се работи нормално.
Стартирането на проверки през нощта много ни хареса, защото има много време и сървъри, можем да се разпуснем. Но, за съжаление, когато кодът на функцията попадне в develop, разработчикът вече има много по-малко мотивация да поправя грешките, които е намерил CI. Периодично се хващах да мисля, когато гледах в сутрешния отчет за всички намерени грешки, че ще ги поправя някога по-късно, защото в Jira има страхотна нова задача, която толкова искам да започна.
Ако проверки блокират pull request, мотивацията е достатъчна, защото докато билдовете не станат зелени, кодът не попада в develop и, следователно, задачата не е завършена.
В крайна сметка избрахме следната стратегия: през нощта провеждаме максимален набор проверки, а най-критичните и, най-важното, бързи, ги стартираме при pull request. Но не спираме до тук — паралелно оптимизираме скоростта на преминаване на проверките, така че да ги преместим от нощен режим в проверки на pull request.
В този момент всичките ни сборки преминаваха доста бързо, затова просто включихме блокера към pull request събиране AРК, Junit тестове и изчисление на code coverage. Включихме, помислихме — и се отказахме от code coverage, защото решихме, че не ни е нужен.
За цялата настройка на базовия CI ни отне два дни (тук и по-долу времевите оценки са примерни, необходими са за мащаб).
След това започнахме да мислим напред — проверяваме ли правилно? Правилно ли стартираме билдовете на pull request?
Стартирахме сборката на последния комит на клона, от който е отворен pull request. Но проверките на този комит могат да покажат само, че кодът, написан от разработчика, работи. Но не доказват, че не е счупил нищо. Всъщност трябва да се проверява състоянието на клона develop след като функционалността бъде влита в него.
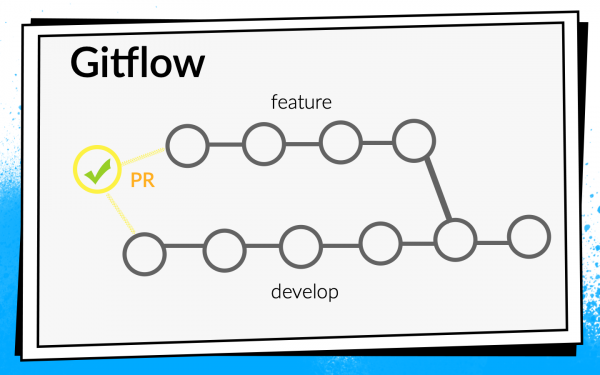
За целта написахме прост bash скрипт premerge.sh:
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Тук просто се изтеглят всичките най-нови изменения от develop и се влитат в текущия клон. Добавихме скрипта premerge.sh като първа стъпка на всички билдове и започнахме да проверяваме точно това, което искаме, тоест интеграцията.
За локализация на проблемите, търсене на решения и написване на този скрипт ни отне три дни.
Приложението се развиваше, задачите се увеличаваха, екипът нарастваше и premerge.sh понякога започна да ни подведе. В develop пробиваха конфликтиране изменения, които чупеха сборката.
Пример за това как се случва:
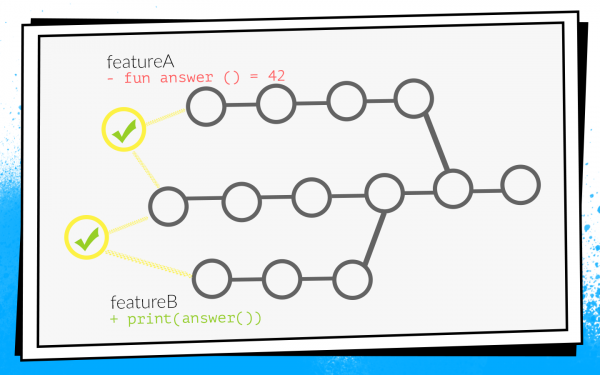
Двама разработчици едновременно започват да разработват функционалности A и B. Разработчикът на функционалност A открива в проекта неизползвана функция answer() и, като добър скаут, я изтрива. В същото време разработчикът на функционалност B в своя клон добавя ново извикване на тази функция.
Разработчиците завършват работата си и в същото време отварят pull request. Започват билдовете, premerge.sh проверява и двата pull request относно свежото състояние на develop — всичките проверки са зелени. След това merge-ва pull request на функционалност A, merge-ва pull request на функционалност B… Бум! Develop се чупи, защото в кода на develop има извикване на несъществуваща функция.
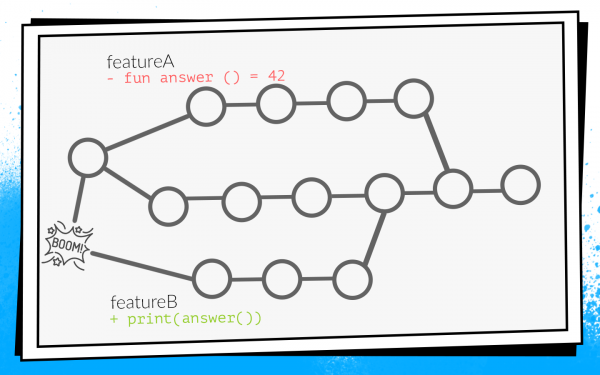
Когато develop не може да се събере, това е локална катастрофа. Целият екип не може да събере нищо и да го предостави за тестване.
Получава се така, че най-често се занимавах с инфраструктурни задачи: аналитика, мрежа, бази данни. Тоест, точно аз написах тези функции и класове, които използват другите разработчици. Поради това много често се оказвах в подобни ситуации. Имам един период, в който имах подобна картинка.
Тъй като това не ни устройваше, започнахме да разработваме варианти как да предотвратим това.
Как да не счупим develop
Първи вариант: да презаредим всичките pull request при обновление на develop. Ако в нашия пример pull request с функция A първи попадне в develop, pull request с функция B ще трябва да се презареди и, съответно, проверките няма да преминат поради грешка при компилацията.
За да разберем колко време ще отнеме, да разгледаме пример с два PR. Отваряме два PR: два билдa, два старта на проверки. След като първият PR бъде включен в develop, вторият трябва да се презареди. Сумарно, за два PR отиват три старта на проверки: 2 + 1 = 3.
В принципе, нормално. Но погледнахме статистиката и типична ситуация в нашия екип беше 10 отворени PR, а тогава броят на проверките е сумата от прогресията: 10 + 9 +… + 1 = 55. Тоест, за да приемем 10 PR, трябва да презаредим 55 пъти. И това в идеална ситуация, когато всички проверки минават от първия път, когато никой не отваря допълнителен pull request, докато обработваме това десеторно.
Представете си, че сте разработчик, на когото му трябва да натисне бутона „merge“ първи, защото ако съседят го направи, ще трябва да чакаме, докато всички сборки преминат отново… Не, така не става, това сериозно ще забави разработката.
Втори възможен начин: да съберем pull request след прегледа на кода. Тоест, отваряте pull request, събирате нужното количество одобрения от колеги, поправяте каквото трябва, след което стартирате билдове. Ако те са успешни, pull request-ът се слива с develop. В този случай няма допълнителни презареждания, но обратната връзка се забавя значително. Аз, като разработчик, отваряйки pull request, веднага искам да видя дали той се събира. Например, ако някой тест е пропаднал, трябва бързо да го поправя. В случай на отложено събиране, обратната връзка се забавя, а значи и цялата разработка. Това също не ни устройваше.
В крайна сметка остана само третият вариант — да въртим.. Целият ни код, всичките ни изходни файлове се съхраняват в репозитория на Bitbucket-сървър. Съответно, ни се наложи да разработим плъгин за Bitbucket.
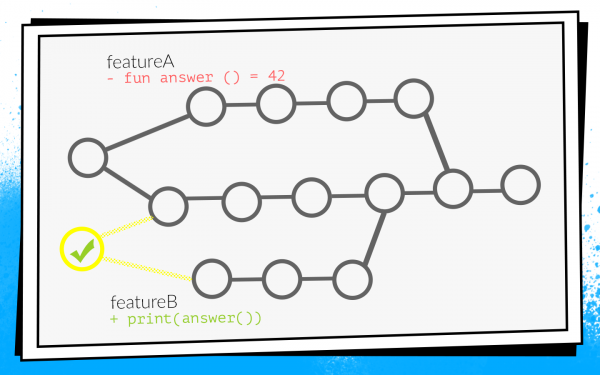
Този плъгин пренаписва механизма за сливане на pull request. Първоначалният процес е стандартен: отваря се PR, стартират се всички билдове, минава се през code review. Но след като code review е преминат и разработчикът реши да натисне „merge“, плъгинът проверява спрямо какво състояние на develop са били стартирани проверките. Ако след билдовете develop се е обновил, плъгинът няма да позволи такъв pull request да бъде влят в основната клон. Той просто ще рестартира билдовете спрямо актуалния develop.
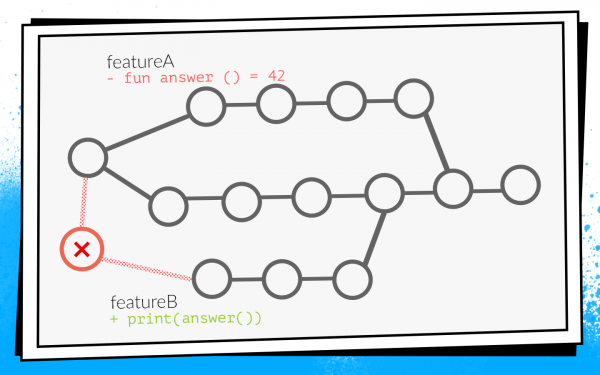
В нашия пример с конфликтни промени такива билдове няма да преминат заради компилационна грешка. Съответно, разработчикът на функция B ще трябва да поправи кода и да рестартира проверките, след което плъгинът автоматично ще приложи pull request.
Преди внедряването на този плъгин имахме средно 2,7 стартирания на проверка за един pull request. С плъгина стана 3,6 стартирания. Трудно ни се съгласихме.
Важно е да се отбележи, че този плъгин има недостатък: той рестартира билда само веднъж. Това означава, че остава малко прозорче, през което конфликтни промени могат да попаднат в develop. Но вероятността за това е ниска, и ние се съгласихме на този компромис между броя на стартиранията и вероятността за счупване. През последните две години се е случило само веднъж, така че вероятно не е било напразно.
За написването на първата версия на плъгина за Bitbucket ни бяха необходими две седмици.
Нови проверки
Междувременно нашият екип продължаваше да расте. Добавяха се нови проверки.
Помислихме: защо да поправяме грешки, ако можем да ги предотвратим? И затова внедрихме статичен анализ на кода. Започнахме с lint, който е част от Android SDK. Но тогава той изобщо не можеше да работи с Kotlin код, а при нас вече 75% от приложението беше написано на Kotlin. Затова към lint добавихме вградени проверки на Android Studio.
За това трябваше да извършим голямо усилие: да вземем Android Studio, да я опаковаме в Docker и да я стартираме на CI с виртуален монитор, за да мести, че е стартирана на истински лаптоп. Но това работеше.
Също така по това време започнахме да пишем много инструментални тестове и внедрихме тестове със скрийншоти. Това е, когато се генерира еталонен екранен снимка за отделен малък изглед, а тестът се състои в това, че от изгледа се взима екранен снимка и се сравнява с еталона пиксел по пиксел. Ако има разминаване, значи, някъде нещо е сбъркано в верстката или нещо не е наред със стиловете.
Но instrumentation тестовете и екранните тестове трябва да се изпълняват на устройства: на емулатори или на реални устройства. Като се има предвид, че тестовете са много и те се изпълняват често, е необходима цяла ферма. Създаването на собствена ферма е твърде трудоемко, затова намерихме готов вариант — Firebase Test Lab.
Firebase Test Lab
Беше избран, защото Firebase е продукт на Google, т.е. би трябвало да е надежден и малко вероятно да изчезне. Цените са разумни: 5$ на час работа на реално устройство, 1$ на час работа на емулатор.
За внедряването на Firebase Test Lab в нашия CI отне около три седмици.
Но екипът продължи да расте и Firebase, за съжаление, започна да ни създава проблеми. В този момент нямаше никакъв SLA. Понякога Firebase ни караше да чакаме, докато се освободи нужното количество устройства за тестове, а не започваше тестовете веднага, както искахме. Чакането в опашка отнемаше до половин час, а това е много дълго. Instrumentation тестовете се изпълняваха на всеки PR, закъсненията много забавяха разработката, а после получихме сметка за месеца с кръгла сума. В общи линии, решихме да се откажем от Firebase и да разработим ин-хаус, след като екипът беше достатъчно пораснал.
Docker + Python + bash
Взехме docker, сложихме в него емулатори, написахме проста програма на Python, която в нужния момент стартира подходящото количество емулатори в необходимата версия, а когато трябва, ги спира. И, разбира се, няколко bash-скрипта — как иначе?
За създаването на собствена тестова среда отне пет седмици.
В резултат на всеки pull request се падаше обширен, блокиращ сливането, списък проверки:
- Сборка АРК;
- Junit-тестове;
- Lint;
- Проверки на Android Studio;
- Instrumentation тестове;
- Тестове за екранни снимки.
Това предотврати много възможни проблеми. Технически всичко работеше, но разработчиците се оплакваха, че чакането на резултати отнема твърде много време.
Твърде дълго — колко? Изтеглихме данните от Bitbucket и TeamCity в система за анализ и разбрахме, че средното време за чакане е 45 минути. Тоест разработчикът, отваряйки pull request, средно чака резултатите от билдовете 45 минути. Според мен, това е много и така не може да се работи.
Разбира се, решихме да ускорим всичките си билдове.
Ускоряваме
Видя, че често билдовете чакат на опашка, първото нещо, което направихме, допълнихме хардуера — екстензивното развитие е най-простото. Билдовете спряха да чакат на опашка, но времето за изчакване намаля само малко, защото някои проверки сами по себе си отнемаха много време.
Премахваме прекалено дългите проверки
Нашият Continuous Integration можеше да улови такива видове грешки и проблеми.
- Не се компилира. CI може да улови грешка в компилацията, когато поради конфликтни промени нещо не се компилира. Както вече споменах, никой не може да компилира нищо, разработката спира и всички са притеснени.
- Баг в поведението. Например, когато приложението се компилира, но при натискане на бутона пада, или бутонът изобщо не се натиска. Това е лошо, защото такъв бъг може да достигне до потребителя.
- Баг в верстката. Например, бутонът се натиска, но е изместен с 10 пиксела наляво.
- Увеличаване на техническия дълг.
След като погледнахме този списък, осъзнахме, че критични са само първите две точки. Такива проблеми искаме да улавяме на първо място. Бъговете в верстката се откриват на етапа на design-review и тогава лесно се поправят. Работата с техническия дълг изисква отделен процес и планиране, затова решихме да не го проверяваме в pull request.
Въз основа на тази класификация прегледахме целия списък с проверки. Изключихме Lint и преместихме стартирането му за през нощта: просто за да издава отчет за броя на проблемите в проекта. С техническия дълг се уговорихме да работим отделно, а от Android Studio checks се отказахме напълно. Android Studio в Docker за стартиране на инспекции звучи интересно, но носи много неприятности в поддръжката. Всяко обновление на версиите на Android Studio е борба с неразбираеми бъгове. Също така беше трудно да се поддържат скрийншотни тестове, защото библиотеката не работеше много стабилно, имаше фалшиви сработвания. Скриншотните тестове премахнахме от списъка с проверки.
В крайна сметка ни останаха:
- Сборка АРК;
- Junit-тестове;
- Instrumentation tests.
Gradle remote cache
Без тежки проверки всичко стана по-добре. Но няма край на съвършенството!
Нашето приложение вече беше разделено на около 150 gradle модула. Обикновено в такъв случай добре работи Gradle remote cache, и решихме да го изпробваме.
Gradle remote cache е услуга, която може да кешира артефакти от изграждането за отделни задачи в отделни модули. Gradle вместо да компилира кода, по HTTP се свързва с remote cache и пита дали някой вече е изпълнявал тази задача. Ако да, просто изтегля резултата.
Стартирането на Gradle remote cache е лесно, защото Gradle предоставя Docker образ. Успяхме да направим това за три часа.
Всичко, което трябваше да направим, беше да стартираме Docker и да добавим една линия в проекта. Но макар да може да се стартира бързо, за да работи всичко добре, ще е нужно доста време.
По-долу е графикът на кеш пропуските.
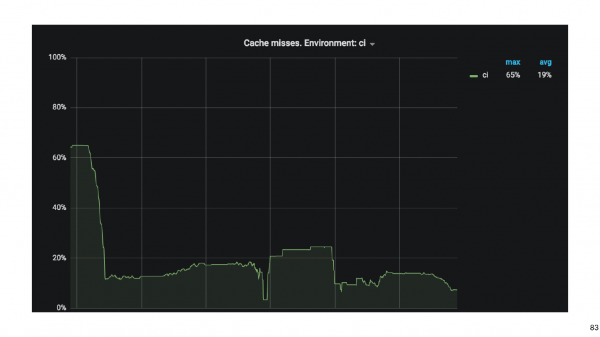
В началото процентът на пропуските мимо кеша беше около 65. След три седмици успяхме да намалим стойността до 20%. Оказа се, че задачите, които изграждат Android приложението, имат странни транзитивни зависимости, поради които Gradle пропуска кеша.
След като активирахме кеша, значително ускорихме изграждането. Но освен изграждането, все още се изпълняват тестове за инструментализиране, а те отнемат дълго време. Вероятно не е нужно да се изпълняват всички тестове за всяко пулно искане. За да го установим, използваме анализ на влиянието.
Анализ на влиянието
На пулното искане събираме git diff и намираме променените Gradle модули.
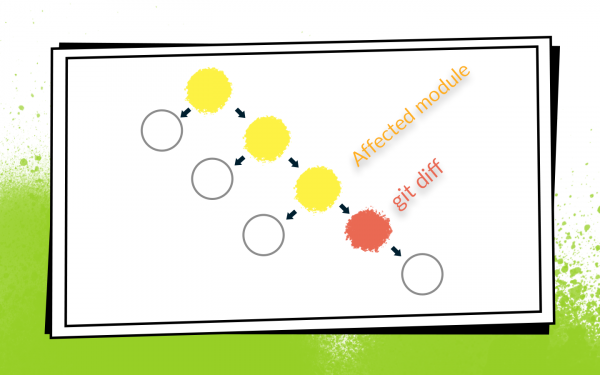
Има смисъл да стартираме само тези тестове за инструментализиране, които проверяват променените модули и всички модули, които зависят от тях. Тестовете за съседни модули нямат смисъл да се стартират: там кодът не е бил променен и нищо не може да се разбие.
С тестовете за инструментализиране не всичко е толкова просто, защото те трябва да бъдат в най-високото ниво на модула Application. Приложихме хевристика с байт-код анализ, за да разберем към кой модул принадлежи всеки тест.
Модернизацията на работата на тестовете за инструментализиране, за да проверяват само активираните модули, отне около осем седмици.
Мерките за ускоряване на проверките успешно сработиха. От 45 минути стигнахме до около 15. Четвърт час чакане за билд вече е нормално.
Но сега разработчиците започнаха да се оплакват, че не разбират какви билдове се стартират, къде да погледнат логовете, защо билдът е червен, кой тест е провален и т.н.
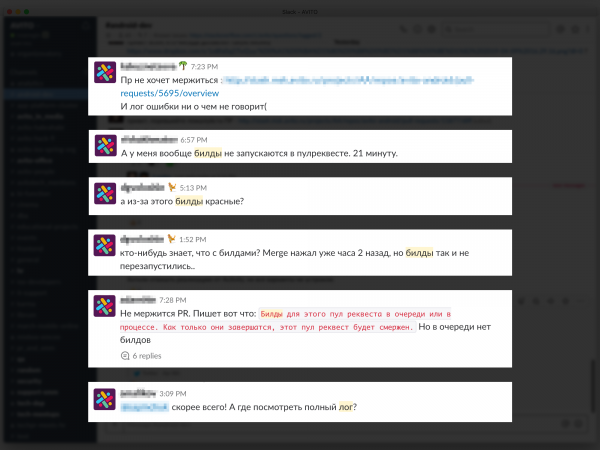
Проблемите с обратната връзка забавят разработката, затова ние се постарахме да осигурим максимално ясна и подробна информация за всеки PR и билд. Започнахме с коментари в Bitbucket към PR, посочвайки кой билд е паднал и защо, също така изпращахме насочени съобщения в Slack. В крайна сметка създадохме страница за PR dashboard със списък на всички текущи билдове и тяхното състояние: в опашка, стартиране, паднал или завършен. Можете да кликнете на билда и да получите достъп до дневника му.
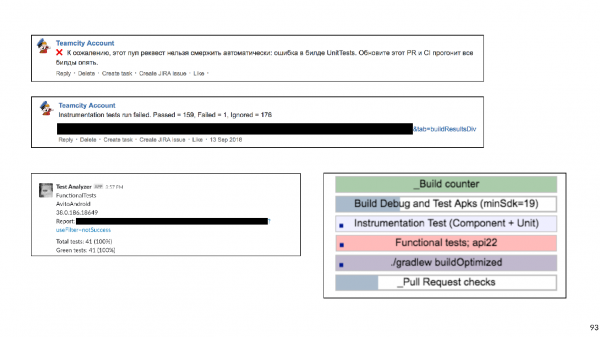
За подробната обратна връзка бяха изразходвани шест седмици.
Планове
Преминаваме към най-новата история. Решавайки проблема с обратната връзка, ние достигнахме ново ниво — решихме да изградим собствена ферма от емуатори. Когато има много тестове и емуатори, е трудно да се управляват. В крайна сметка всички наши емуатори бяха преместени в k8s клъстер с гъвкаво управление на ресурсите.
Освен това, има и други планове.
- Възстановяване на Lint (и друг статичен анализ). Вече работим в тази посока.
- Стартиране на PR блокера на всички end-to-end тестове на всички версии на SDK.
Така проследихме историята на развитието на Continuous Integration в Авито. Сега искам да дам няколко съвета от гледна точка на опитен.
Съвети
Ако мога да дам само един съвет, то това би бил той:
Моля, бъдете по-внимателни с shell скриптовете!
Bash е много гъвкав и мощен инструмент, с него е много удобно и бързо да се пишат скриптове. Но можете да попаднете в капан, и за съжаление, ние попаднахме.
Всичко започна с прости скриптове, които се стартираха на нашите билд машини:
#!/usr/bin/env bash
./gradlew assembleDebug
Но, както е известно, всичко с времето се развива и усложнява — да стартираме един скрипт от друг, да предадем там някакви параметри — в крайна сметка се наложи да напишем функция, която определя на какво ниво на вложеност сме в bash в момента, за да зададем нужните кавички, за да се стартира всичко.
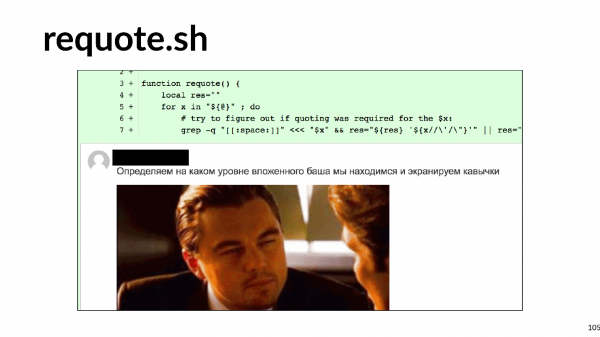
Можете ли да си представите трудозатратата за развитието на такива скриптове. Препоръчвам да не попадаме в този капан.
С какво може да се замени?
- С всякакъв скриптов език. Писането на Python или Kotlin Script е по-удобно, защото е програмиране, а не скриптове.
- Или да опишете цялата логика на билдовете под формата на Custom gradle tasks за вашия проект.
Решихме да изберем втория вариант и в момента постепенно премахваме всички bash скриптове и пишем много кастомни gradle задачи.
Съвет №2: да се съхранява инфраструктурата в код.
Удобно е, когато настройката на Continuous Integration не се съхранява в UI интерфейса на Jenkins или TeamCity и т.н., а под формата на текстови файлове директно в репозитория на проекта. Това осигурява версия на кода. Няма да бъде трудно да се върнете или да съберете код на друга клонка.
Скриптовете могат да се съхраняват в проекта. А какво да правим с околната среда?
Съвет №3: Docker може да помогне с околната среда.
Той определено ще помогне на разработчиците на Android, но за iOS все още не, за съжаление.
Това е пример за прост docker файл, който съдържа jdk и android-sdk:
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Изтегляне на Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Инсталиране на Android Build Tool и библиотеки
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Написвайки този docker файл (по съвет, всъщност можете да не го пишете и просто да го изтеглите готов от GitHub) и събирайки образ, получавате виртуална машина, на която можете да изграждате приложението и да стартирате Junit тестове.
Два основни аргумента, защо това има смисъл: мащабируемост и повторяемост. С използването на docker можете бързо да стартирате десетина билд агента, които ще имат точно същата околна среда, както предишните. Това значително улеснява живота на CI инженерите. Поставянето на android-sdk в docker е изключително лесно, с емулаторите е малко по-сложно: ще трябва да се поизпотите малко (или пак да свалите готово от GitHub).
Съвет №4: не забравяйте, че проверките се правят не заради самите проверки, а за хората.
Разработчиците се нуждаят от бърза и, най-важното, разбираема обратна връзка: какво се е счупило, кой тест е паднал, къде да видят логовете на билда.
Съвет №5: бъдете прагматични при развитието на Continuous Integration.
Ясно разберете какви типове грешки искате да предотвратите, колко ресурси, време и машинно време сте готови да инвестирате. Прекалено дългите проверки могат, например, да се преместят за през нощта. А от тези, които улавят не много важни грешки, можете напълно да се откажете.
Съвет №6: ползвайте готови инструменти.
В момента има много компании, които предлагат облачен CI.
За малки екипи това е добро решение. Няма нужда да поддържате нищо, просто плащате малко пари, събирате приложението си и дори изпълнявате тестове за инструментариум.
Съвет №7: в голям екип е по-изгодно да се изберат in-house решения.
Но рано или късно, с растежа на екипа in-house решенията стават по-изгодни. С тези решения има един момент. В икономиката съществува закон на намаляваща възвръщаемост: в който и да е проект всяко следващо подобрение става все по-трудно и изисква все повече инвестиции.
Икономиката описва целия наш живот, включително Continuous Integration. Изградих график на трудозатратата за всяка стъпка в развитието на нашето Continuous Integration.
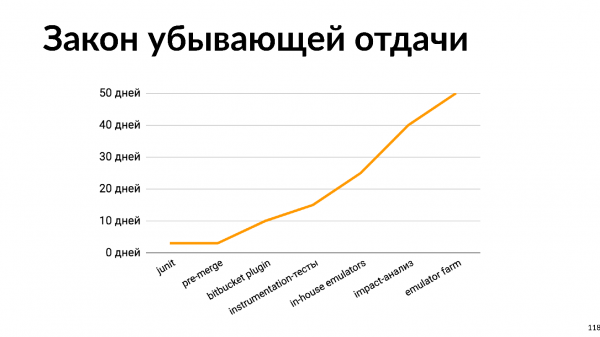
Ясно е, че всяко подобрение става все по-трудно и трудно. Гледайки този график, можем да разберем, че развитието на Continuous Integration трябва да бъде съгласувано с растежа на размера на екипа. За екип от двама души да отделят 50 дни за разработка на вътрешна ферма на емулятори — не е добра идея. Но също така, за голям екип да не се занимава с Continuous Integration — също е лоша идея, тъй като проблемите с интеграцията, ремонти на комуникацията и т.н. ще отнемат още повече време.
Започнахме с това, че автоматизацията е необходима, защото хората са скъпи, те грешат и са мързеливи. Но автоматизацията също се прави от хора. Да, следователно всички тези проблеми важат и за автоматизацията.
- Автоматизирането е скъпо. Помнете графика на трудозатратата.
- При автоматизацията хората грешат.
- Понякога е много мързеливo да се автоматизира, защото и без това всичко работи. Защо да подобряваме нещо, защо да имаме Continuous Integration?
Но имам статистика: в 20% от билдовете се намират грешки. И това не е, защото нашите разработчици пишат лош код. Това е, защото разработчиците са убедени, че, ако допуснат грешка, тя няма да попадне в develop, а автоматизираните проверки ще я засекат. Следователно разработчиците могат да отделят повече време за написване на код и интересни неща, а не да проверяват локално.
Занимавайте се с Continuous Integration. Но в умерени количества.
Между другото, Николай Нестеров не само прави страхотни доклади, но също така е част от програмния комитет и помага на другите да подготвят за вас съдържателни изложения. Пълнотата и полезността на програмата на предстоящата конференция могат да бъдат оценени по темите в . А за подробности идвайте на 22-23 април в Инфопространство.
Източник: habr.com
