

Предговор
Често потребители, разработчици и администратори на СУБД MS SQL Server се сблъскват с проблеми с производителността на базите данни или на самата СУБД, затова мониторингът на MS SQL Server е изключително актуален.
Тази статия е допълнение към статията и в нея ще бъдат разгледани някои аспекти на мониторинга на MS SQL Server, по-специално: как бързо да определим какви ресурси липсват, а също така и препоръки за конфигуриране на флагове за трасировка.
За да работят следните предоставени скриптове, е необходимо да се създаде схема inf в нужната база данни по следния начин:
Създаване на схема inf
use ;
go
create schema inf;
Метод за откриване на недостиг на оперативна памет
Първият признак за недостиг на оперативна памет е случай, в който инстанцията на MS SQL Server използва цялата налична ОЗУ.
За това ще създадем следното представление inf.vRAM:
Създаване на представление inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb] 					--колко свободна ОЗУ на сървъра в МБ
		 , a.[RAM_Avail_Percent] 					--процент на свободна ОЗУ на сървъра
		 , a.[Server_physical_memory_Mb] 				--колко общо ОЗУ има на сървъра в МБ
		 , a.[SQL_server_committed_target_Mb] 			--колко общо ОЗУ е заделено за MS SQL Server в МБ
		 , a.[SQL_server_physical_memory_in_use_Mb] 		--колко общо ОЗУ извършва MS SQL Server в момента в МБ
		 , a.[SQL_RAM_Avail_Percent] 				--процент на свободна ОЗУ за MS SQL Server относно цялото заделено ОЗУ за MS SQL Server
		 , a.[StateMemorySQL] 						--достатъчна ли е ОЗУ за MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent] 				--процент на заделената ОЗУ за MS SQL Server относно цялото ОЗУ на сървъра
		 --достатъчна ли е ОЗУ за сървъра
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Warning' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Danger' else 'Normal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/casT(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/casT(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Warning' else 'Normal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
		) as a;
Тогава, за да определим колко памет използва инстанцията на MS SQL Server, можем да използваме следната заявка:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Ако показателят SQL_server_physical_memory_in_use_Mb постоянно не е по-малък от SQL_server_committed_target_Mb, е необходимо да проверим статистиката на изчакванията.
За да определим недостатъчността на оперативната памет чрез статистиката на изчакванията, ще създадем представление inf.vWaits:
Създаване на представление inf.vWaits
СОЗДАТЬ представление [inf].[vWaits] как
С В [Waits] КАК
    (ВЫБРАТЬ
        [wait_type], --име на типа очакване
        [wait_time_ms] / 1000.0 КАТО [WaitS],--Общо време на очакване за този тип в милисекунди. Това време включва signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 КАТО [ResourceS],--Общо време на очакване за този тип в милисекунди без signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 КАТО [SignalS],--Разлика между времето за сигнализиране на изчакващия поток и времето на началото на неговото изпълнение
        [waiting_tasks_count] КАТО [WaitCount],--Брой на очакванията за този тип. Тази променлива нараства всеки път, когато започне очакване
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() КАТО [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) КАТО [RowNum]
    ОТ sys.dm_os_wait_stats
    КЪДЕ [waiting_tasks_count]>0
		и [wait_type] НЕ Е В (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPХОР',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress КАТО (
	ВЫБРАТИ
	    [W1].[wait_type] КАТО [WaitType],
	    CAST ([W1].[WaitS] КАТО DECIMAL (16, 2)) КАТО [Wait_S],--Общо време на очакване за този тип в милисекунди. Това време включва signal_wait_time_ms
	    CAST ([W1].[ResourceS] КАТО DECIMAL (16, 2)) КАТО [Resource_S],--Общо време на очакване за този тип в милисекунди без signal_wait_time_ms
	    CAST ([W1].[SignalS] КАТО DECIMAL (16, 2)) КАТО [Signal_S],--Разлика между времето за сигнализиране на изчакващия поток и времето на началото на неговото изпълнение
	    [W1].[WaitCount] КАТО [WaitCount],--Брой на очакванията за този тип. Тази променлива нараства всеки път, когато започне очакване
	    CAST ([W1].[Percentage] КАТО DECIMAL (5, 2)) КАТО [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) КАТО DECIMAL (16, 4)) КАТО [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) КАТО DECIMAL (16, 4)) КАТО [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) КАТО DECIMAL (16, 4)) КАТО [AvgSig_S]
	ОТ [Waits] КАТО [W1]
	INNER JOIN [Waits] КАТО [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	ГРУПИРАЙ ПО [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- процентен праг
)
ВЪРНИ [WaitType]
      ,MAX([Wait_S]) КАТО [Wait_S]
      ,MAX([Resource_S]) КАТО [Resource_S]
      ,MAX([Signal_S]) КАТО [Signal_S]
      ,MAX([WaitCount]) КАТО [WaitCount]
      ,MAX([Percentage]) КАТО [Percentage]
      ,MAX([AvgWait_S]) КАТО [AvgWait_S]
      ,MAX([AvgRes_S]) КАТО [AvgRes_S]
      ,MAX([AvgSig_S]) КАТО [AvgSig_S]
  ОТ ress
  групирай по [WaitType];
В този случай недостигът на оперативна памет може да бъде определен с помощта на следната заявка:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Тук трябва да се обърне внимание на показателите Percentage и AvgWait_S. Ако те са значителни по своята съвкупност, има много голяма вероятност, че экземплярът на MS SQL Server недостигва оперативна памет. Значителните стойности се определят индивидуално за всяка система. Въпреки това, може да започнете от следния показател: Percentage >= 1 и AvgWait_S >= 0.005.
За извеждане на показателите в системата за мониторинг (например, Zabbix) можете да създадете следните две заявки:
- колко процента заемат типовете изчаквания по ОЗУ (сумата по всичките такива типове изчаквания):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - колко в милисекунди занимават типовете изчаквания по ОЗУ (максималната стойност от всички средни забавяния по всичките такива типове изчаквания):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
            'PAGEIOLATCH_XX',
            'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Въз основа на динамиката на получените стойности по тези два показателя може да се направи извода дали ОЗУ е достатъчно за экземпляра на MS SQL Server.
Метод за откриване на прекомерно натоварване на ЦПУ
За да се открие недостигът на процесорно време, е достатъчно да се използва системното представяне sys.dm_os_schedulers. Тук, ако показателят runnable_tasks_count постоянно е по-голям от 1, съществува голяма вероятност, че броят на ядрото не е достатъчен за экземпляра на MS SQL Server.
За извеждане на показателя в системата за мониторинг (например, Zabbix) можете да създадете следната заявка:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id < 255;
Въз основа на динамиката на получените стойности по този показател може да се направи извода дали има достатъчно процесорно време (брой ядра на ЦПУ) за экземпляра на MS SQL Server.
Въпреки това, важно е да се помни, че самите заявки могат да искат веднага няколко потока. Понякога оптимизаторът не може правилно да оцени сложността на самата заявка. В тези случаи на заявката могат да бъдат назначени прекалено много потока, които в момента не могат да бъдат обработени едновременно. Това също причинява тип на изчакване, свързан с недостиг на процесорно време, и увеличаване на опашката за планировчиците, които използват конкретни ядра на ЦПУ, т.е. показателят runnable_tasks_count при тези условия ще нараства.
В такъв случай, преди да увеличите броя на ядрата на ЦПУ, е необходимо правилно да настроите свойствата на паралелизъм на самия екземпляр на MS SQL Server, а с версия 2016 - да настроите правилно свойствата на паралелизъм на нужните бази данни:
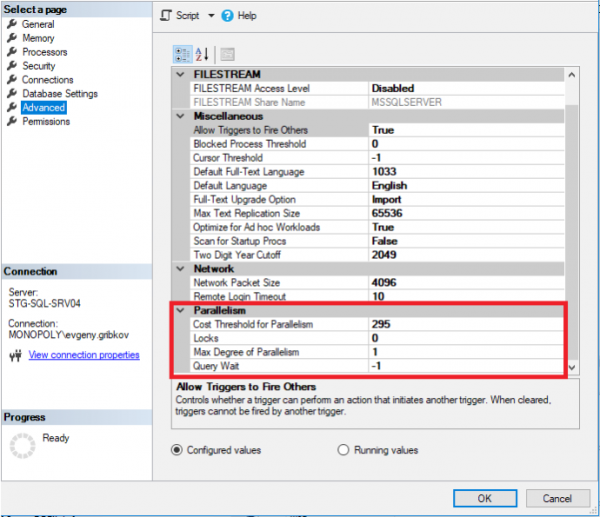
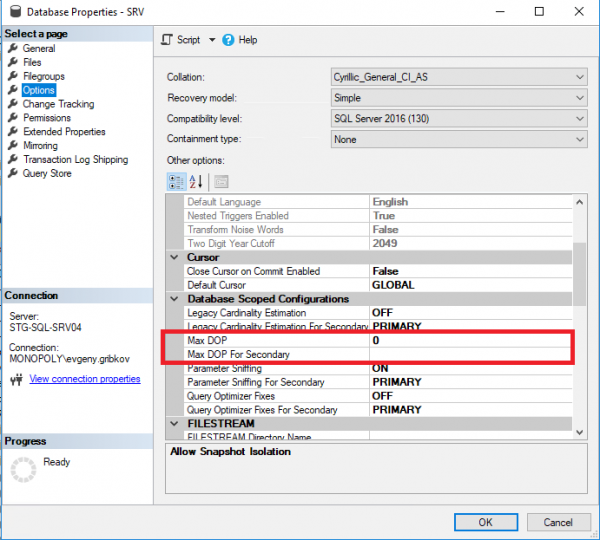
Тук е полезно да се обърне внимание на следните параметри:
- Max Degree of Parallelism - задава максималния брой потока, които могат да бъдат назначени на всяка заявка (по подразбиране е 0 - ограничение единствено на самата операционна система и редакцията на MS SQL Server)
- Cost Threshold for Parallelism - оценъчната стойност на паралелизма (по подразбиране е 5)
- Max DOP - задава максималния брой потока, които могат да бъдат назначени на всяка заявка на ниво база данни (но не повече от стойността на свойството „Max Degree of Parallelism“) (по подразбиране е 0 - ограничение единствено на самата операционна система и редакцията на MS SQL Server, както и ограничение по свойството „Max Degree of Parallelism“ на целия екземпляр на MS SQL Server)
Тук не е възможно да се даде еднакво добър рецепт за всички случаи, т.е. необходимо е да се анализират тежките заявки.
От личен опит препоръчвам следния алгоритъм на действия за OLTP системи за настройка на свойствата за паралелизъм:
- първо да се забрани паралелизмът, задавайки на ниво целия екземпляр Max Degree of Parallelism на 1
- да се анализират най-тежките заявки и да се подбере оптималният брой потока за тях
- да се зададе Max Degree of Parallelism на подбрания оптимален брой потока, получен от т. 2, а също така за конкретни бази данни да се зададе Max DOP стойност, получена от т. 2 за всяка база данни
- да се анализират най-тежките заявки и да се установи негативният ефект от многопоточността. Ако има такъв, да се повиши Cost Threshold for Parallelism.
За такива системи като 1С, Microsoft CRM и Microsoft NAV в повечето случаи е подходящо забраняването на многопоточността.
Ако е избрана версия Standard, в повечето случаи е достатъчно да се забрани многопоточността, тъй като тази версия е ограничена в броя ядра на ЦПУ.
За OLAP системи описаният по-горе алгоритъм не е подходящ.
От личния си опит препоръчвам следния алгоритъм за конфигуриране на свойствата на паралелизма за OLAP системи:
- да се анализират най-тежките заявки и да се подбере оптималният брой потока за тях
- да зададете Max Degree of Parallelism на оптимално подбрано количество потоци, получено от т.1, а също така за конкретни бази данни да зададете Max DOP стойността, получена от т.1 за всяка база данни.
- да анализирате най-тежките заявки и да установите негативния ефект от ограничаването на паралелизма. Ако такъв съществува, можете да намалите стойността на Cost Threshold for Parallelism или да повторите стъпки 1-2 от този алгоритъм.
Т.е. за OLTP системи преминаваме от еднопоточност към многопоточност, а за OLAP системи обратно – от многопоточност към еднопоточност. По този начин можете да подберете оптималните настройки на паралелизма както за конкретна база данни, така и за целия екземпляр на MS SQL Server.
Също така е важно да се разбере, че настройките на свойствата на паралелизма трябва да се променят с времето, в зависимост от резултатите от мониторинга на производителността на MS SQL Server.
Препоръки за конфигуриране на флаговете за трасировка
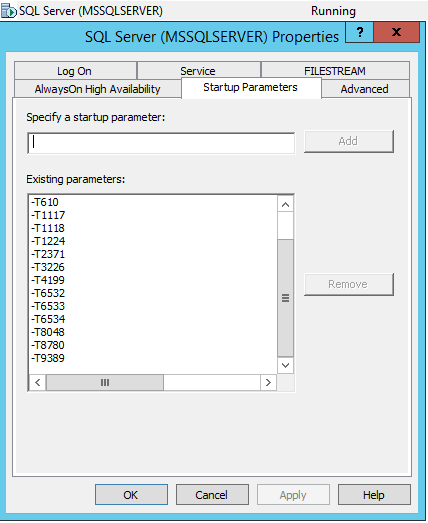
От личния си опит и опита на моите колеги, за оптимална работа препоръчвам да зададете следните флагове за трасировка на ниво стартиране на услугата MS SQL Server за версии 2008-2016:
- 610 — Намаляване на протоколизирането на вложенията в индексни таблици. Може да помогне при вложения в таблици с голямо количество записи и множество транзакции при чести дълги изчаквания WRITELOG поради промени в индексите.
- 1117 — Ако файлът във файловата група отговаря на условията за автоматично увеличаване, всички файлове в файловата група се увеличават.
- 1118 — Задължава всички обекти да се разположат в различни екстенти (забрана за смесени екстенти), което минимизира необходимостта от сканиране на страницата SGAM, която се използва за проследяване на смесените екстенти.
- 1224 — Деактивира увеличаването на блокировките на базата на броя на блокировките. Въпреки това, прекомерното използване на памет може да включи увеличаването на блокировките.
- 2371 — Променя прага на фиксирано автоматично обновяване на статистиката на прага на динамично автоматично обновяване на статистиката. Важно е за обновяването на плановете на запитвания относно големи таблици, където неправилното определяне на броя на записите води до грешни планове за изпълнение.
- 3226 — Потиска съобщенията за успешно выполнение на резервно копие в журнала на грешките.
- 4199 — Включва промени в оптимизатора на запитвания, публикувани в кумулативни пакети за актуализации и пакети за актуализации на SQL Server.
- 6532-6534 — Включва подобрение в производителността на операциите с пространствени типове данни.
- 8048 — Преобразува обектите в паметта, секционирани по NUMA, в такива, секционирани по CPU.
- 8780 — Включва допълнително времево разпределение за планиране на запитвания. Някои запитвания без този флаг могат да бъдат отхвърлени, тъй като нямат план за запитване (много рядка грешка).
- 8780 — 9389 — Включва допълнителна динамично предоставена буферна памет за операторите на пакетен режим, позволяваща на оператора на пакетен режим да поиска допълнителна памет и да избегне прехвърляне на данни в tempdb, ако допълнителната памет е налична.
Също така, до версия 2016 е полезно да се включи флагът за трасировка 2301, който включва оптимизация на разширената поддръжка на решения и по този начин помага при избора на по-точни планове за запитвания. Въпреки това, от версия 2016, той често оказва негативен ефект върху общото време на изпълнение на запитванията.
Също така, за системи с много индекси (например за бази данни на 1С) препоръчвам да се включи флагът за трасировка 2330, който деактивира събирането на информация за използването на индекси, което в общи линии има положителен ефект върху системата.
За повече информация относно флаговете за трасировка можете да се запознаете.
По предоставената по-горе връзка е важно също да се вземат предвид версиите и сборките на MS SQL Server, тъй като за новите версии някои флагове за трасировка са включени по подразбиране или не осигуряват никакъв ефект.
Флаговете за трасировка могат да бъдат включени и изключени с командите DBCC TRACEON и DBCC TRACEOFF съответно. По-подробно вижте.
Състоянието на флаговете за трасировка може да се получи с командата DBCC TRACESTATUS:
За да бъдат флаговете за трасировка включени в автоматичния старт на услугата MS SQL Server, е необходимо да влезете в SQL Server Configuration Manager и в свойствата на услугата да добавите данните за флаговете за трасировка чрез -T:
Итог
В тази статия бяха разгледани някои аспекти на мониторинга на MS SQL Server, с помощта на които можете бързо да идентифицирате липсата на RAM и свободно време на CPU, както и редица други по-малко очевидни проблеми. Обсъдени бяха най-често използваните флагове за трасировка.
Източници:
»
»
»
»
»
»
»
Източник: habr.com
