

Много корпоративни приложения и системи за виртуализация разполагат със собствени механизми за изграждане на отказоустойчиви решения. По-специално, Oracle RAC (Oracle Real Application Cluster) представлява клъстер от два или повече сървъра на Oracle бази данни, работещи съвместно с цел балансиране на натоварването и осигуряване на отказоустойчивост на ниво сървър/приложение. За работа в този режим е необходимо общо хранилище, обикновено реализирано чрез СХД.
Както вече обсъждахме в една от нашите , самата СХД, въпреки наличието на дублирани компоненти (включително контролери), все пак има точки на отказ – главно под формата на единен набор от данни. Следователно, за изграждане на Oracle решение с повишени изисквания за надеждност, схемата „N сървъра – едно СХД“ трябва да бъде усложнена.
Първо, разбира се, трябва да определим, от какви рискове се опитваме да се застраховаме. В рамките на тази статия няма да разглеждаме защита от заплахи от типа „паднал метеорит“. Следователно изграждането на териториално разпределено решение за disaster recovery остава тема за една от следващите статии. Тук ще разгледаме така нареченото Cross-Rack disaster recovery решение, при което защитата се изгражда на ниво сървърни шкафове. Самите шкафове могат да се намират както в едно помещение, така и в различни, но обикновено в рамките на една сграда.
Тези шкафове трябва да съдържат всичките необходими компоненти и софтуер, които ще позволят работата на Oracle бази данни независимо от състоянието на „съседа“. С други думи, използвайки Cross-Rack disaster recovery решение, ние изключваме рисковете при отказ:
- Сървъри на приложения Oracle
- Системи за съхранение
- Системи за комутиране
- Пълен отказ на всичкото оборудване в шкафа:
- Отказ на захранване
- Отказ на охладителната система
- Външни фактори (човек, природа и др.)
Дублирането на Oracle сървъри предполага самия принцип на работа на Oracle RAC и се реализира чрез приложението. Дублирането на средства за комутация също не представлява проблем. Но с дублирането на системата за съхранение не е толкова просто.
Най-простият вариант е репликацията на данни от основната СХД към резервната. Синхронна или асинхронна, в зависимост от възможностите на СХД. При асинхронна репликация веднага възниква въпросът за осигуряване на консистентността на данните по отношение на Oracle. Но дори ако има софтуерна интеграция с приложението, при повреда на основната СХД ще е необходимо намесата на администраторите в ръчен режим, за да прехвърлят клъстера на резервното хранилище.
По-сложен вариант е софтуерните и/или хардуерните „виртуализатори“ на СХД, които ще избавят от проблемите с консистентността и ръчната намеса. Но сложността на разгръщането и последващото администриране, както и доста високата цена на такива решения, отблъскват много.
Точно за подобни сценарии, като Cross-Rack disaster recovery, отлично подхожда решението All Flash масив AccelStor NeoSapphire™ с използването на архитектура Shared-Nothing. Тази модел представлява двунодова система за съхранение, използваща собствената си технология FlexiRemap® за работа с флаш памети. Благодарение на NeoSapphire™ H710 е способна да осигури производителност до 600K IOPS@4K произволно запис и 1M+ IOPS@4K произволно четене, което не е постижимо при използване на класически RAID-based СХД.
Но основната особеност на NeoSapphire™ H710 е изпълнението на двете ноди в отделни корпуси, всеки от които има собствена копия на данните. Синхронизацията на нодите става чрез външен интерфейс InfiniBand. Благодарение на такава архитектура, нодите могат да бъдат разнесени на различни места на разстояние до 100м, осигурявайки по този начин решение за Cross-Rack disaster recovery. И двете ноди работят напълно в синхронен режим. От страна на хостовете H710 изглежда като обикновена двуконтролерна СХД. Следователно, няма нужда от допълнителни софтуерни и хардуерни опции и особено сложни настройки.
Ако сравним всички описани решения за Cross-Rack disaster recovery, вариантът на AccelStor значително се откроява на фона на останалите:
AccelStor NeoSapphire™ Shared Nothing Architecture
Софтуерен или хардуерен „виртуализатор“ на СХД
Решение на база репликация
Достъпност
Отказ на сървъра
Без престой
Без престой
Без престой
Отказ на комутатора
Без престой
Без престой
Без престой
Отказ на системата за съхранение
Без престой
Без престой
Преустановяване
Отказ на целия шкаф
Без престой
Без престой
Преустановяване
Цена и сложност
Цена на решението
Ниска*
Висока
Висока
Сложност на разгръщането
Ниска
Висока
Висока
*AccelStor NeoSapphire™ е все пак All Flash масив, който по определение не струва "3 стотинки", особено с двукратен капацитет. Въпреки това, ако сравняваме крайната цена на решението на неговата база с подобни от други доставчици, цената може да се счита за ниска.
Топологията на свързване на сървъри на приложения и нодове на All Flash масива ще изглежда следния начин:
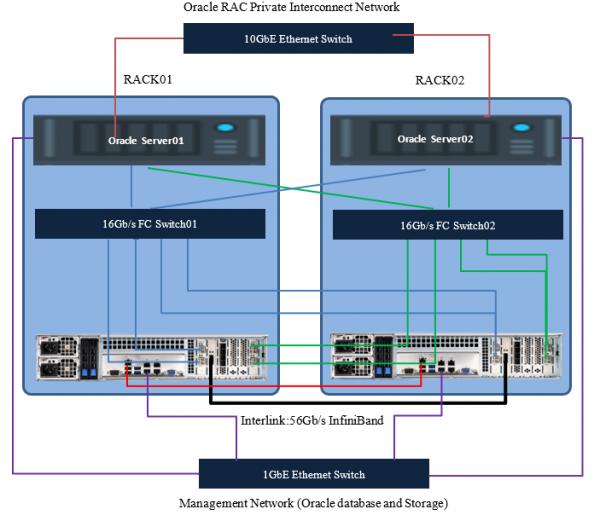
При планирането на топологията е силно препоръчително да се осигури дублиране на комутаторите за управление и интерконект на сървърите.
Тук и по-нататък ще става дума за свързване през Fibre Channel. В случай на използване на iSCSI, ще бъде същото, с уточнение на използваните типове комутатори и малко по-различни настройки на масива.
Подготвителна работа на масива
Използвано оборудване и софтуер
Спецификации на сървъри и комутатори
FAudio
Описание
Oracle Database 11g сървъри
Два
Операционна система на сървъра
Oracle Linux
Версия на Oracle database
11g (RAC)
Процесори на сървър
Два 16-ядрени Intel® Xeon® CPU E5-2667 v2 @ 3.30GHz
Физическа памет на сървър
128GB
FC мрежа
16Gb/s FC с мултипатенинг
FC HBA
Emulex Lpe-16002B
Посветени публични 1GbE портове за управление на клъстери
Intel ethernet адаптер RJ45
16Gb/s FC суич
Brocade 6505
Посветени частни 10GbE портове за синхронизация на данни
Intel X520
Спецификация на AccelStor NeoSapphhire™ All Flash масива
FAudio
Описание
Система за съхранение
NeoSapphire™ модел с висока наличност: H710
Версия на изображението
4.0.1
Общ брой дискове
48
Размер на диска
1.92TB
Тип на диска
SSD
FC целеви портове
16х 16Gb порта (8 на нода)
Портове за управление
Кабелът 1GbE ethernet, свързващ се с хостове чрез ethernet суич
Порт за сигнализация
Кабел 1GbE ethernet, свързващ два съхранителни нода
Порт за синхронизация на данни
56Gb/s InfiniBand кабел
Преди използването на масива, той трябва да бъде инициализиран. По подразбиране адресът за управление на двата нода е един и същ (192.168.1.1). Трябва последователно да се свържете с тях и да зададете нови (различни) адреси за управление и да настроите синхронизация на времето, след което портовете за управление могат да бъдат свързани в една мрежа. След това нодовете се обединяват в HA двойка, като се задават подсистеми за свързването на Interlink.
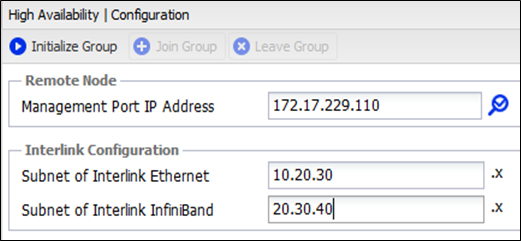
След завършване на инициализацията, управлението на масива може да се извършва от всеки нод.
След това създаваме необходимите томове и ги публикуваме за сървъри на приложения.
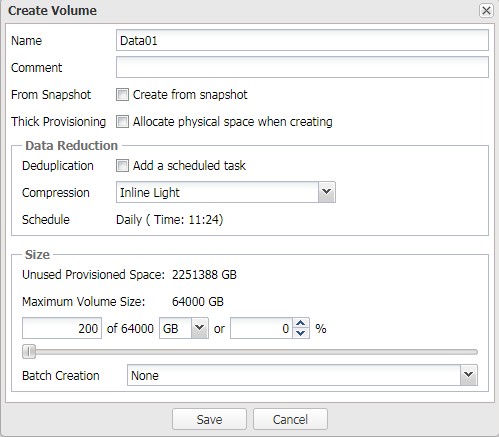
Силно се препоръчва да се създадат няколко тома за Oracle ASM, тъй като това ще увеличи броя на целите за сървърите, което в крайна сметка ще подобри общата производителност (повече за опашките в друга част) ).
Тестова конфигурация
Име на тома за съхранение
Размер на тома
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Някои пояснения относно режимите на работа на масива и протичащите процеси при извънредни ситуации
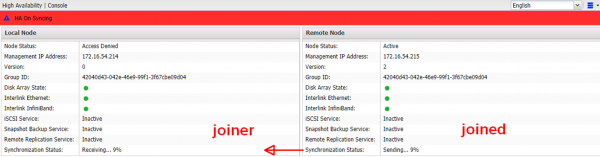
Всеки набор данни на всяка възел има параметър "номер на версия". След първоначалната инициализация той е същият и равен на 1. Ако поради някаква причина номерът на версиите е различен, данните винаги се синхронизират от по-високата версия към по-ниската, след което номерът на по-ниската версия се изравнява, т.е. това означава, че копията са идентични. Причини, поради които версиите могат да бъдат различни:
- Планирано рестартиране на една от възлите
- Авария на една от възлите поради внезапно прекъсване (електрическо захранване, прегряване и др.).
- Прекъсване на InfiniBand връзката с неможливост за синхронизация
- Авария на една от възлите поради повреда на данните. Тук вече ще е необходимо създаване на нова HA група и пълна синхронизация на набора от данни.
Във всеки случай, възелът, който остава онлайн, увеличава номера си на версия с единица, за да може след възстановяване на връзката да синхронизира своя набор от данни.
Ако се прекъсне връзката по Ethernet линията, Heartbeat временно преминава на InfiniBand и се връща обратно в рамките на 10 секунди при неговото възстановяване.
Настройка на хостовете
За да се осигури отказоустойчивост и да се увеличи производителността, е необходимо да се включи поддръжката на MPIO за масива. За целта трябва да се добавят редове в файла /etc/multipath.conf, след което да се рестартира услугата multipath.
Скрит текстdevices {
device {
vendor "AStor"
path_grouping_policy "group_by_prio"
path_selector "queue-length 0"
path_checker "tur"
features "0"
hardware_handler "0"
prio "const"
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
След това, за да работи ASM с MPIO през ASMLib, е необходимо да се промени файла /etc/sysconfig/oracleasm и след това да се изпълни /etc/init.d/oracleasm scandisks.
Скрит текст
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER="dm"
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE="sd"
Забележка
Ако нямате желание да използвате ASMLib, можете да използвате правила UDEV, които са основата за ASMLib.
Започвайки от версия 12.1.0.2, опцията на Oracle Database е налична за инсталиране като част от ПО ASMFD.
Задължително е да се уверите, че създадените дискове за Oracle ASM са подравнени по отношение на размера на блока, с който физически работи масивът (4K). В противен случай могат да възникнат проблеми с производителността. Следователно е необходимо да се създадат томове с подходящи параметри:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Разпределение на бази данни по създадените томове за нашата тестова конфигурация
Име на тома за съхранение
Размер на тома
Съответствие на томовете LUNs
Детайли на устройството ASM Volume
Размер на алокационната единица
Data01
200GB
Карта на всички хранилищни томове към системата за данни на всички портове.
Редундантност: Нормална
Име: DGDATA
Цел: Данни файлове
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Редундантност: Нормална
Име: DGGRID1
Цел: Мрежа: CRS и гласуване
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Редундантност: Нормална
Име: DGGRID2
Цел: Мрежа: CRS и гласуване
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Редундантност: Нормална
Име: DGREDO1
Цел: Журнал на възстановяване на нишка 1
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Редундантност: Нормална
Име: DGREDO2
Цел: Журнал на възстановяване на нишка 2
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Настройки на базата данни
- Размер на блока = 8K
- Сwap пространство = 16GB
- Деактивиране на AMM (Автоматично управление на паметта)
- Деактивиране на Transparent Huge Pages
Други настройки
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # не задавайте, ако използвате Linux x86
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus "/as sysdba"
alter system set processes=2000 scope=spfile;
alter system set open_cursors=2000 scope=spfile;
alter system set session_cached_cursors=300 scope=spfile;
alter system set db_files=8192 scope=spfile;
Тест за отказоустойчивост
С цел демонстрация беше използван HammerDB за симулиране на OLTP натоварване. Конфигурация на HammerDB:
Брой складове
256
Общо транзакции на потребител
1000000000000
Виртуални потребители
256
В резултат беше постигнат показател 2.1M TPM, което е далеч от максимума на производителността на масива , но представлява "поток" за текущата апаратура на сървърите (преди всичко заради процесорите) и тяхното количество. Целта на този тест все пак е демонстрацията на отказоустойчивостта на решението като цяло, а не достигането на максималните производствени показатели. Затова ще се основаваме просто на тази цифра.
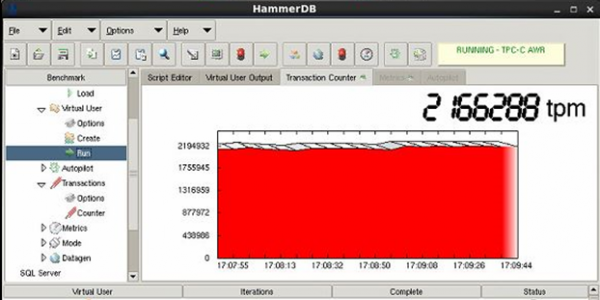
Тест за отказ на един от възлите
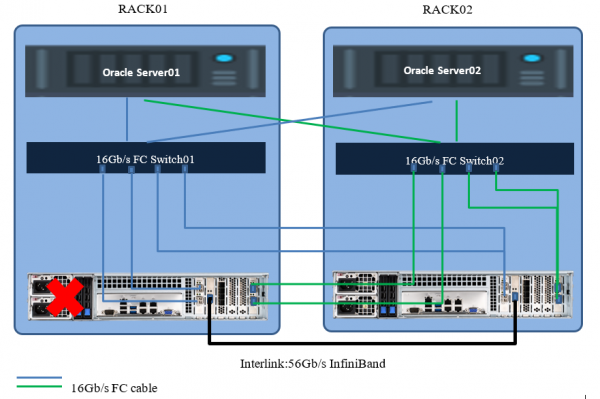
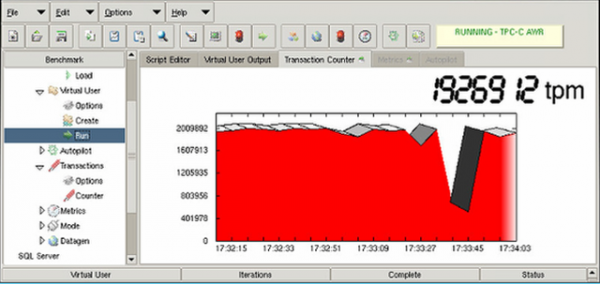
Хостовете загубиха част от пътищата до хранилището, продължавайки да работят чрез останалите с втория възел. Производителността падна за няколко секунди заради преустрояване на пътищата, а след това се върна към нормални показатели. Прекъсване на обслужването не настъпи.
Тест за отказ на шкафа със все оборудване
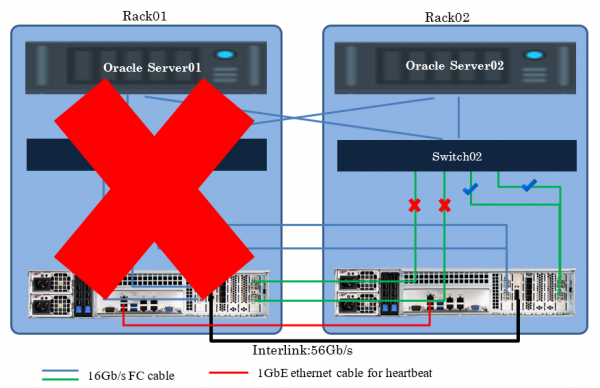
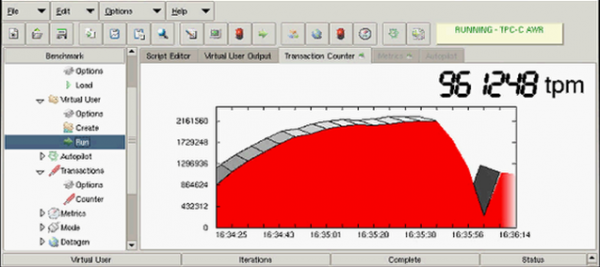
В този случай производителността също падна за няколко секунди заради преустрояване на пътищата, а след това се върна на половин стойност от оригиналния показател. Резултатът намаля наполовина от първоначалния заради изключването на един сървър за приложения. Прекъсване на обслужването също не настъпи.
Ако имате нужда от реализиране на отказоустойчиво решение Cross-Rack disaster recovery за Oracle на разумна цена и с минимални усилия за разгръщане/администриране, то съвместната работа на Oracle RAC и архитектурата ще бъде един от най-добрите варианти. Вместо Oracle RAC може да бъде всяко друго софтуерно решение, което предвижда кластеризация, същите СУБД или системи за виртуализация, например. Принципът на изграждане на решението остава същият. И крайният показател – нулеви стойности за RTO и RPO.
Източник: habr.com
