

Въведение в операционните системи
Здравейте, Хабр! Искам да ви представя серия от статии-преводи на интересна, според мен, литература — OSTEP. В този материал се разглежда дълбоко работата на Unix-подобни операционни системи, а именно — работа с процеси, различни планиратели, памет и други подобни компоненти, които съставят съвременната ОС. Оригиналът на всички материали можете да видите тук . Моля, имайте предвид, че преводът е направен непрофесионално (достатъчно свободно), но се надявам, че общият смисъл е запазен.
Лабораторните работи по този предмет можете да намерите тук:
Други части:
И можете да посещавате канала ми в =)
Въведение в планировчика
Същността на проблема: Как да разработим политика на планировчика
Как трябва да се разработват основни рамки на политиката на планировчика? Какви трябва да бъдат основните предположения? Какви метрики са важни? Какви основни техники бяха използвани в ранни компютърни системи?
Предположения за натоварването
Преди да обсъдим възможните политики, първо да направим няколко опростяващи отклонения относно процесите, стартирани в системата, които заедно се наричат натоварване. Определяйки натоварването като критична част от изграждането на политиките и колкото повече знаете за натоварването, толкова по-качествена политика можете да напишете.
Нека направим следните предположения за процесите, стартирани в системата, понякога наричани още jobs (задачи). Практически всички тези предположения са нереалистични, но са необходими за развитието на мисълта.
- Всяка задача работи равно количество време,
- Всички задачи се поставят едновременно,
- Поставената задача работи до своето завършване,
- Всички задачи използват само CPU,
- Времето за работа на всяка задача е известно.
Метрики на планировчика
Освен някои предположения за натоварването, е необходим и инструмент за сравнение на различни планировъчни политики: метрики на планировчика. Метриката е просто мярка за нещо. Съществува известно количество метрики, които могат да се използват за сравнение на планировчиците.
Например, ще използваме метриката, наречена време за завършване (turnaround time). Времето за завършване на задачата се определя като разлика между времето на завършване на задачата и времето на постъпване на задачата в системата.
Tturnaround=Tcompletion−Tarrival
Тъй като предположихме, че всички задачи са постъпили едновременно, Ta=0 и следователно Tt=Tc. Тази стойност естествено ще се промени, когато променим горепосочените предположения.
Друга метрика е справедливост (fairness). Производителността и справедливостта често са противоположни характеристики в планирането. Например, планировчик може да оптимизира производителността, но на цената на изчакване на стартиране от други задачи, по този начин намалявайки справедливостта.
ПЪРВИ ДА ВЛЕЗЕ, ПЪРВИ ДА ИЗЛЕЗЕ (FIFO)
Най-простият алгоритъм, който можем да реализираме, се нарича FIFO или первият, който дойде (влиза), първият, който е обслужен (излиза). Този алгоритъм има няколко предимства: той е много прост за реализиране и отговаря на всички наши предположения, изпълнявайки задачата доста добре.
Нека разгледаме прост пример. Да кажем, че 3 задачи са поставени едновременно. Но да предположим, че задача A е дошла малко по-рано от всички останали, затова ще бъде в списъка за изпълнение по-рано от останалите, точно както и B по отношение на C. Да предположим, че всяка от тях ще се изпълнява 10 секунди. Какво ще бъде средното време за изпълнение на тези задачи?
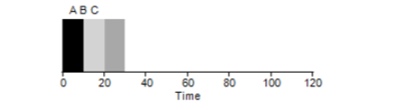
След като изчислим стойностите — 10+20+30 и разделим на 3, получаваме средно време за изпълнение на програмата, равно на 20 секунди.
Сега нека опитаме да променим нашите предположения. В частност, предположение 1, и по този начин няма да предполагаме, че всяка задача се изпълнява за еднакво количество време. Как ще се справи FIFO този път?
Както се оказва, различните времена за изпълнение на задачите оказват изключително негативно влияние върху производителността на алгоритъма FIFO. Да предположим, че задача A ще се изпълнява 100 секунди, докато B и C ще останат по 10 всяка.
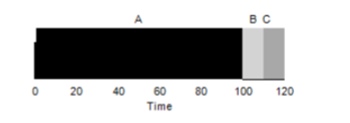
Както е видно от изображението, средното време за системата ще бъде (100+110+120)/3=110. Този ефект се нарича ефект на конвоя, когато някои краткосрочни потребители на ресурс се оказват зад тежък потребител. Това е подобно на опашка в магазин за хранителни стоки, когато пред вас има клиент с пълна количка. Най-доброто решение на проблема е да опитате да смените касата или просто да се отпуснете и да дишате дълбоко.
Shortest Job First
Може ли по някакъв начин да се реши подобна ситуация с тежки процеси? Разбира се. Друг тип планиране се наричаShortest Job First (SJF). Неговият алгоритъм също е достатъчно примитивен — както подсказва името, първо ще бъдат изпълнени най-кратките задачи една след друга.
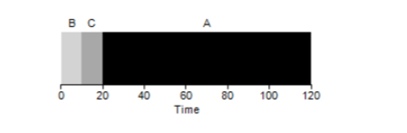
В този пример резултатът от стартирането на същите процеси ще бъде подобряване на средното време за оборот на програмите и ще бъде равно на 50 вместо 110, което е практически 2 пъти по-добре.
Следователно, при зададеното предположение, че всички задачи пристигат в едно и също време, алгоритъмът SJF изглежда най-оптимален. Въпреки това, нашите предположения все още не изглеждат реалистични. Този път ще променим предположение 2 и ще предположим, че задачите могат да пристигат по всяко време, а не всичките едновременно. До какви проблеми може да доведе това?
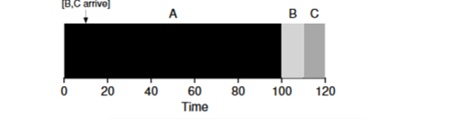
Нека си представим, че задача А (100с) пристига най-първа и започва изпълнението си. В момент t=10 пристигат задачи Б и В, всяка от които ще заема 10 секунди. Така средното време за изпълнение е (100+(110-10)+(120-10))/3 = 103. Какво може да направи планировчикът за подобряване на ситуацията?
Най-кратко време за завършване прво (STCF)
За да подобрите ситуацията, ще опуснем предположение 3, че програмата е стартирана и работи до завършването си. Освен това, ще ни е необходима помощ от хардуера и, както можете да предположите, ще използваме таймер за прекъсване на работещата задача и свалиране на контекст. Така планировчикът може да предприеме нещо, когато задачите Б и В пристигнат — да прекрати изпълнението на задача А и да обработи задачите Б и В, а след като те завършат, да продължи изпълнението на процес А. Такъв планировчик се нарича STCFили Преемптивен планировчик на задачи.
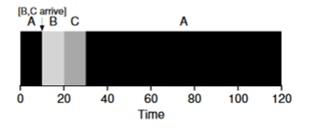
Резултатът от работата на този планировчик ще бъде следният: ((120-0)+(20-10)+(30-10))/3=50. Така този планировчик става още по-оптимален за нашите задачи.
Метрика Време за отговор (Response Time)
Следователно, ако знаем времето за работа на задачите и че тези задачи използват само CPU, STCF ще бъде най-доброто решение. И някога, в ранните времена, тези алгоритми работеха и доста добре. Въпреки това, сега потребителят прекарва по-голямата част от времето си на терминала и очаква производително интерактивно взаимодействие. Така се роди новата метрика — време за отговор (отговор).
Времето за отговор се счита по следния начин:
Tresponse=Tfirstrun−Tarrival
Следователно, за предишния пример времето за отговор ще бъде: А=0, Б=0, В=10 (abg=3.33).
И така, алгоритъмът STCF не е толкова добър в ситуация, когато три задачи пристигнат едновременно — той ще трябва да изчака, докато по-малките задачи завършат напълно. Така че, алгоритъмът е добър за измерване на време за обработка, но лош за измерване на интерактивност. Представете си, че седите пред терминал и се опитвате да напишете символи в редактора, но трябва да чакате повече от 10 секунди, защото някаква друга задача заема процесора. Това не е особено приятно.
Така се сблъскваме с друг проблем — как можем да изградим планировчик, който да е чувствителен към времето за отговор?
Кръгово разпределение
За решаване на този проблем е разработен алгоритъм Кръгово разпределение (RR). Основната идея е доста проста: вместо да стартираме задачите до пълното им завършване, ще стартираме задача за определен период от време (наречен времеви квант) и след това ще преминем към друга задача от опашката. Алгоритъмът повтаря работата си, докато всички задачи не бъдат завършени. Времето за работа на програмата трябва да бъде кратно на времето, след което таймерът ще прекъсне процеса. Например, ако таймерът прекъсва процеса на всеки x=10мс, тогава размерът на прозореца за изпълнение на процеса трябва да е кратен на 10 и да бъде 10, 20 или x*10.
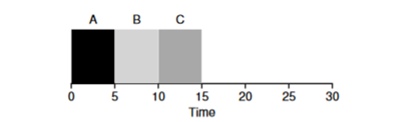
Нека разгледаме пример: Задачите A, B и C пристигат едновременно в системата и всяка от тях иска да работи 5 секунди. Алгоритъмът SJF ще изпълнява всяка задача до края, преди да пусне друга. В контекста на алгоритъма RR с времеви прозорец=1с, задачите ще преминат по следния начин (виж. Рис. 4.3):
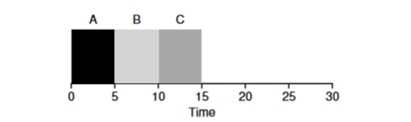
(SJF отново (лошо за времето за отговор)
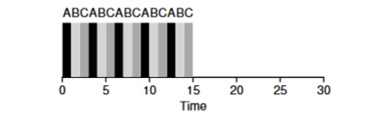
(Кръгово разпределение (добро за времето за отговор)
Средното време за отговор за алгоритъма RR (0+1+2)/3=1, докато за SJF (0+5+10)/3=5.
Логично е да предположим, че времевият прозорец е много важен параметър за RR; колкото по-малък е той, толкова по-високо е времето за отговор. Въпреки това, не бива да го правим прекалено малък, тъй като времето за превключване на контекста също играе роля в общата производителност. По този начин, изборът на времевия прозорец за изпълнение се определя от архитектa на ОС и зависи от задачите, които се планират да се изпълняват в нея. Превключването на контекста не е единствената системна операция, която отнема време - активната програма оперира с множество кешове, и при всяко превключване е необходимо да се запази и възстанови тази среда, което също може да отнеме време.
RR е отличен планировчик, ако говорим само за метриката време за отговор. Но как ще се държи метриката време за завършване на задачата при този алгоритъм? Нека разгледаме горния пример, когато времето за работа на A, B, C е 5 сек и те идват в един и същи момент. Задача A ще завърши в 13, B в 14, C в 15 сек и средното време за завършване ще бъде 14 сек. Следователно, RR е най-лошият алгоритъм за метриката на завършване.
По-подробно казано, всеки алгоритъм от типа RR е честен, тъй като разпределя времето за работа на CPU равномерно между всички процеси. И по този начин, тези метрики постоянно конфликтуват помежду си.
Така имаме няколко противопоставени алгоритми и все пак остават няколко предположения - че времето за задачата е известно и че задачата използва единствено CPU.
Смесване с I/O
На първо място, нека премахнем предположението 4, че процесът използва единствено CPU, естествено, това не е така и процесите могат да се обръщат и към друго оборудване.
В момента, в който某о процес поиска операция за вход/изход, процесът преминава в състояние blocked, очаквайки завършването на I/O. Ако I/O се изпраща към твърдия диск, такава операция може да отнеме до няколко милисекунди или повече, и по това време процесорът ще бъде в режим на изчакване. Временно, планировчикът може да заеме процесора с друг процес. Следващото решение, което планировчикът ще трябва да вземе, е кога процесът ще завърши своя I/O. Когато това се случи, ще се случи прекъсване и ОС ще преведе процеса, който е иницирал I/O, в състояние ready.
Нека да разгледаме пример с няколко задачи. Всяка от тях се нуждае от 50ms процесорно време. Въпреки това, първата задача ще извършва I/O на всеки 10ms (който също ще се изпълнява на всеки 10ms). А процес А просто използва 50ms процесорно време без I/O.
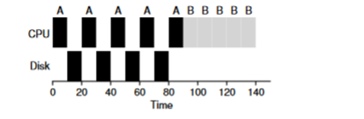
В този пример ще използваме планирания алгоритъм STCF. Как ще се държи планиращият алгоритъм, ако стартираме такъв процес като А? Той ще постъпи по следния начин — първо напълно ще завърши процес А, а след това процес Б.
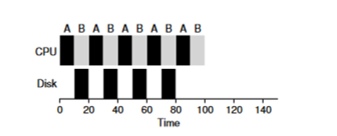
Традиционният подход за решаване на този проблем е да интерпретираме всяка 10ms подзадача на процес А като отделна задача. По този начин, при стартиране с алгоритъм STJF, изборът между 50ms задача и 10ms задача става очевиден. След като подзадача А приключи, ще се стартира процес Б и I/O. След приключване на I/O ще бъде решено отново да се стартира 10ms процес А вместо процес Б. По този начин е възможно да се реализира припокриване, при което CPU се използва от друг процес, докато първият изчаква I/O. И в крайна сметка системата се използва по-добре — в момента, когато интерактивните процеси изчакват I/O, на процесора могат да се изпълняват и други процеси.
Оракулът свърши.
Сега ще се опитаме да се освободим от предположението, че времето за работа на задачата е известно. Това е изобщо най-лошото и нереалистично предположение от целия списък. Всъщност, в обикновените операционни системи, самата ОС обикновено знае много малко за времето за изпълнение на задачите, как тогава да изградим планираща система без знание за това колко време ще отнеме изпълнението на задачата? Може би можем да използваме някои принципи на RR, за да решим този проблем?
Резюме
Разгледахме основните идеи за планиране на задачи и разгледахме две семейства планиращи алгоритми. Първият стартира най-кратката задача на първо място, увеличавайки времето за обръщение, докато вторият разпределя времето равномерно между всички задачи, увеличавайки времето за отговор. И двата алгоритма са лоши там, където добрите алгоритми от другото семейство са добри. Също така разгледахме как паралелната работа на CPU и I/O може да подобри производителността, но не решихме проблема с предвиждането от страна на ОС. На следващото занятие ще разгледаме планиращия алгоритъм, който гледа в близкото минало и се опитва да предвиди бъдещето, наречен multi-level feedback queue.
Източник: habr.com
