

Ако се използва база данни за времеви редове (timeseries db, ) като основно хранилище за сайт със статистика, то вместо решение на задачата, може да получите много главоболия. Работя по проект, в който се използва такава база, и понякога InfluxDB, за която ще говорим, ми е предоставяла напълно неочаквани изненади.
Отказ от отговорност: посочените проблеми се отнасят за версия InfluxDB 1.7.4.
Защо времеви редове?
Проектът е свързан с проследяване на транзакции в различни блокчейни и показване на статистика. Конкретно — наблюдаваме емисия и изгаряне на стейбълкойни (). На базата на тези транзакции трябва да изградим графики и да показваме обобщени таблици.
При анализа на транзакциите дойде идеята: да използваме базата данни за времеви редове InfluxDB като основно хранилище. Транзакциите са точки във времето и добре се вписват в модела на времеви ред.
Още функции за агрегация изглеждаха доста удобни — идеални за обработка на графики с дълъг период. На потребителя му трябва графика за година, а в базата има набор от данни с таймфрейм от пет минути. Да му изпращате всичките сто хиляди точки е безсмислено — освен дългата обработка, те просто няма да се поберат на екрана. Можете да напишете собствена реализация за увеличаване на таймфрейма или да се възползвате от вградените функции за агрегация в Influx. С тяхна помощ можете да групирате данните по дни и да изпратите нужните 365 точки.
Малко ме смущаваше, че обикновено такива бази се използват с цел събиране на метрики. Мониторинг на сървъри, IoT устройства, всичко, от което „потопяват“ милиони точки от вида: [<време> — <стойност на метрика>]. Но ако базата работи добре с голям обем данни, защо малкият обем трябва да предизвиква проблеми? С тази мисъл взехме InfluxDB на работа.
Какво още е удобно в InfluxDB
Освен споменатите функции за агрегация, има още едно чудесно нещо — постоянни запитвания (). Това е вграден в БД планиращ, който може да обработва данни по график. Например, можете на всеки 24 часа да групирате всички записи за деня, да изчислите средно и да запишете една нова точка в друга таблица без да пишете собствени велосипеди.
Съществува и политики за запазване () — настройка за премахване на данни след определен период. Полезно е, когато например, трябва да се съхранява натоварването на CPU за седмица с измервания на всяка секунда, а за период от няколко месеца такава точност не е нужна. В такава ситуация може да се направи следното:
- да се създаде непрекъснато запитване за агрегация на данни в друга таблица;
- за първата таблица да се определи политика за изтриване на метрики, които са по-стари от въпросната седмица.
И Influx ще намалява размера на данните самостоятелно и ще изтрива ненужното.
За съхраняваните данни
Данните не са много: около 70 хиляди транзакции и един милион точки с пазарна информация. Добавянето на нови записи — не повече от 3000 точки на ден. Също така има метрики за сайта, но там данните са малко и според политиката на задържане се съхраняват не повече от месец.
Проблеми
В процеса на разработване и последващо тестване на услугата възникнаха все по-критични проблеми при експлоатацията на InfluxDB.
1. Изтриване на данни
Има серия данни с транзакции:
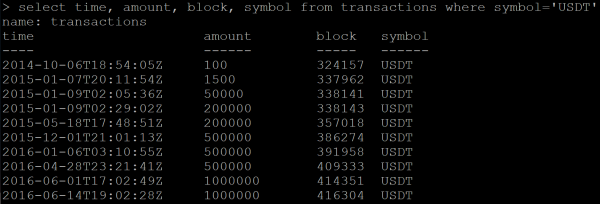
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Резултат:
Изпращам команда за изтриване на данни:
DELETE FROM transactions WHERE symbol=’USDT’След това правя заявка за получаване на вече изтритите данни. И Influx вместо празен отговор връща част от данните, които трябва да бъдат изтрити.
Опитвам се да изтрия таблицата изцяло:
DROP MEASUREMENT transactionsПроверявам изтриването на таблицата:
SHOW MEASUREMENTSНе виждам таблицата в списъка, но новата заявка за данни все още връща същия набор от транзакции.
Проблемът се появи само веднъж при мен, тъй като случаят с изтриването е единичен. Но такова поведение на базата очевидно не попада в рамките на 'коректна' работа. По-късно на github намерих отворен въпрос почти преди година по тази тема.
В резултат, помогна изтриването и последващото възстановяване на цялата база.
2. Числа с плаваща точка
Математическите изчисления при използване на вградените функции на InfluxDB дават грешки в точността. Не е така, че това е нещо необичайно, но е неприятно.
В моя случай данните имат финансова съставка и бих искал да ги обработвам с висока точност. Поради това имам намерение да се откажа от непрекъснатите запитвания.
3. Непрекъснатите запитвания не могат да бъдат адаптирани към различни времеви зони
На услугата има таблица с дневна статистика за транзакции. За всеки ден трябва да групираме всички транзакции за тези сутки. Но денят за всеки потребител ще започва в различно време, следователно и наборът от транзакции е различен. По UTC има на изместване, за които е необходимо да се агрегира информацията.
В InfluxDB при групиране по време можете допълнително да зададете изместване, например за московско време (UTC+3):
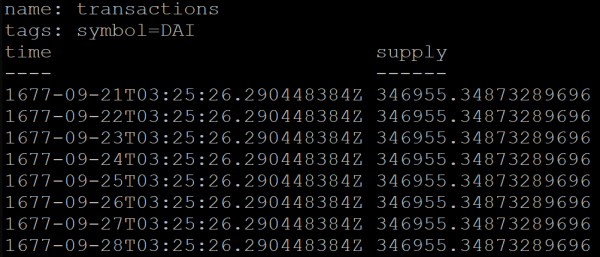
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Но резултатът от заявката ще бъде некоректен. По някаква причина сгрупираните по дни данни ще започват чак през 1677 година (InfluxDB официално поддържа времеви диапазон от тази година):
За да заобиколим този проблем, временно преместихме услугата на UTC+0.
4. Производителност
В интернет има много бенчмаркове с сравнения на InfluxDB и други БД. При първоначалното запознаване изглеждаха като маркетингови материали, но сега смятам, че има частична истина в тях.
Ще разкажа моя случай.
Услугата предоставя API метод, който връща статистиката за последните 24 часа. При изчисленията методът прави три запитвания към базата данни с такива заявки:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCОбяснение:
- В първото запитване получаваме последните точки за всяка монета с пазарни данни. Осем точки за осем монети в моя случай.
- Второто запитване получава най-новата точка.
- Третото запитва списък с транзакции за последните 24 часа, може да има няколко стотин.
Уточнявам, че в InfluxDB по тагове и време автоматично се изгражда индекс, който ускорява заявките. В първото запитване symbol — това е таг.
Направих стрес тест за този метод на API. За 25 RPS сървърът демонстрираше пълно натоварване на шест CPU:
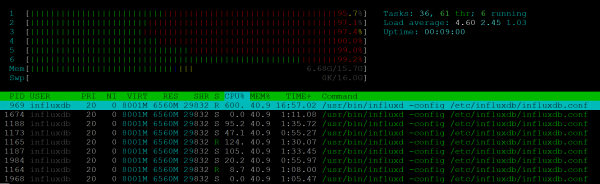
При това процесът NodeJs изобщо не натоварваше.
Скоростта на изпълнение деградираше вече на 7-10 RPS: ако един клиент можеше да получи отговор за 200 ms, то 10 клиенти трябваше да чакат по секунда. 25 RPS — граница, при която пострада стабилността, на клиентите им връщаха 500 грешки.
С такава производителност използването на Influx в нашия проект е невъзможно. Повече от това: в проект, където мониторингът трябва да бъде демонстриран на множество клиенти — могат да се появят подобни проблеми и сървърът за метрики ще бъде претоварен.
Извод
Основното заключение от получения опит е, че не трябва да се използва непозната технология в проекта без достатъчен анализ. Просто сканиране на отворените тикети в GitHub можеше да предостави информация, която да предотврати избора на InfluxDB като основно хранилище за данни.
InfluxDB изглеждаше идеално за нуждите на проекта ми, но както показа практиката, тази база данни не отговаря на изискванията и много често създава проблеми.
В репозитория на проекта вече може да се намери версия 2.0.0-beta, остава да се надяваме, че във втората версия ще има значителни подобрения. Докато това стане, ще се запозная с документацията на TimescaleDB.
Източник: habr.com
