

В тази статия ще разкажем как и защо разработихме – механизъм, който предава информация между клиентски приложения и сървъри на 1С: Предприятие – от формулиране на задача до планиране на архитектурата и детайлите на реализацията.
Системата за Взаимодействие (по-нататък – СВ) – е разпределена система за обмен на съобщения с гарантирано доставяне, устойчива на откази. Системата е проектирана като високо натоварен сервис с висока мащабируемост, и е налична както като онлайн сервис (предоставен от фирмата 1С), така и като тиражен продукт, който може да бъде инсталиран на собствени сървъри.
СВ използва разпределено хранилище и търсачна система . Ще говорим и за Java и как хоризонтално мащабираме PostgreSQL.
Формулиране на задачата
За да стане ясно защо разработихме Системата за Взаимодействие, ще разкажа малко за начина, по който се организира разработката на бизнес приложения в 1С.
Първо – малко за нас за тези, които все още не знаят с какво се занимаваме:) Ние създаваме технологичната платформа „1С: Предприятие“. Платформата включва средство за разработка на бизнес приложения, а също и runtime, позволяващ на бизнес приложенията да работят в кросплатформена среда.
Клиент-сървърната парадигма на разработка
Бизнес приложенията, създадени в „1С: Предприятие“, работят в трирежимна архитектура „БД – сървър на приложения – клиент“. Прикладният код, написан на , може да се изпълнява на сървъра на приложенията или на клиента. Цялата работа с практическите обекти (справочници, документи и т.н.), както и четене и запис на база данни, се извършва само на сървъра. Функционалността на формите и интерфейса на командите също е реализирана на сървъра. На клиента се извършва получаване, отваряне и показване на формите, „комуникация“ с потребителя (предупреждения, въпроси…), малки изчисления в формите, изискващи бърза реакция (например, умножаване на цена по количество), работа с локални файлове, работа с оборудване.
В приложния код заглавията на процедурите и функциите трябва ясно да посочват къде ще се изпълнява кодът – с директиви &НаКлиенте / &НаСервере (&AtClient / &AtServer в английската версия на езика). Разработчиците на 1С сега ще ме коригират, като кажат, че директивите всъщност , но за нас това не е съществено в момента.
Клиентският код може да извиква сървърен код, но обратното не е възможно. Това е фундаментално ограничение, което сме въвели по редица причини. По-специално, защото сървърният код трябва да е написан така, че да се изпълнява еднакво, независимо откъде бъде извикан - от клиент или сървър. При извикване на сървърния код от друг сървърен код клиента не съществува в този контекст. И тъй като в процеса на изпълнение на сървърния код, клиентът, който го е извикал, може да се е затворил или излязъл от приложението, и сървърът вече няма на кого да извиква.

Кодът, обработващ натискането на бутона: извикването на сървърна процедура от клиента работи, но извикването на клиентска процедура от сървъра - не.
Това означава, че ако искаме от сървъра да предадем съобщение на клиентското приложение, например, че форматирането на "дългосрочен" отчет е завършено и отчетът може да бъде прегледан - нямаме такъв начин. Трябва да прибегнем до хитрости, например, клиентският код периодично да опитва да опрашва сървъра. Но такъв подход натоварва системата с ненужни извиквания и изглежда не много елегантно.
А още има нужда, например, при входящ телефонен -повик да уведомим клиентското приложение, за да може то по номера наcaller-a да намери информация в базата данни за контрагентите и да покаже на потребителя информация за позвъняващия контрагент. Или, например, при постъпил на склад поръчка да уведомим клиентското приложение на поръчителя. В общи линии, случаите, в които такъв механизъм би бил полезен, са многобройни.
Същинската задача
Да се създаде механизъм за обмяна на съобщения. Бърз, надежден, с гарантирана доставка, с възможност за гъвкаво търсене на съобщения. На базата на механизма да се реализира мессенджър (съобщения, видеозвънци), работещ в приложенията на 1С.
Да се проектира система с хоризонтална скалируемост. Нарастващото натоварване трябва да се справя с увеличаването на броя на нодовете.
Реализация
Сървърната част на СВ решихме да не вграждаме директно в платформата 1С:Предприятие, а да я реализираме като отделен продукт, чието API може да се извиква от кода на приложните решения 1С. Това беше направено по редица причини, основната от които е желанието да се осъществи обмен на съобщения между различните приложения 1С (например между Управление на търговията и счетоводството). Различните приложения на 1С могат да работят на различни версии на платформата 1С:Предприятие, да са на различни сървъри и т.н. В тези условия реализацията на СВ като отделен продукт, който е "страничен" на инсталациите на 1С, е оптимално решение.
И така, решихме да разработим СВ като отделен продукт. На малките компании препоръчваме да използват сървера на СВ, който инсталирахме в облака си (wss://1cdialog.com), за да избегнат разходите, свързани с локалната инсталация и настройка на сървера. По-големите клиенти обаче може да решат, че е целесъобразно да инсталират собствен сървър на СВ на своите мощност. – той се предлага като тиражен продукт за инсталация при клиенти и също е разположен в нашия облак .
Приложение
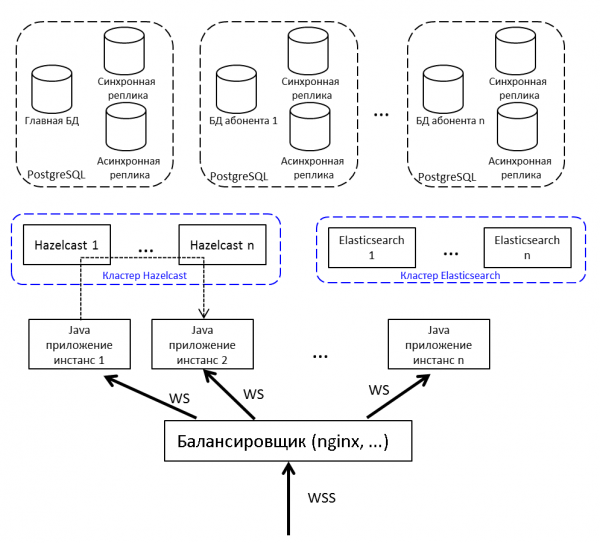
За разпределение на натоварването и откаженост ще разположим не едно Java приложение, а няколко, пред тях ще поставим балансировач на натоварването. Ако е необходимо да предадем съобщение от нода на нода – ще използваме publish/subscribe в Hazelcast.
Комуникацията между клиента и сървъра – по websocket. Той е подходящ за системи в реално време.
Разпределена кеш памет
Избирахме между Redis, Hazelcast и Ehcache. Годината е 2015. Redis току-що е пуснал нов клъстер (прекалено нов, страшно), има Sentinel с много ограничения. Ehcache не може да се събира в клъстер (тази функционалност се появи по-късно). Решихме да пробваме Hazelcast 3.4.
Hazelcast се събира в клъстер "от кутията". В режим на един нод той не е много полезен и може да служи само като кеш – не може да записва данни на диск, загубим ли единственния нод – загубихме данните. Ние разположим няколко Hazelcast-а, между които правим бекъп на критичните данни. Кеша не бекъпираме – не е жалко.
За нас Hazelcast е:
- Склад за потребителски сесии. Всяко ходене за сесия в базата е бавно, затова всички сесии поставяме в Hazelcast.
- Кеш. Търсите профила на потребителя – проверете в кеша. Написахте ново съобщение – поставете го в кеша.
- Топици за комуникация на инстансите на приложението. Нодът генерира събитие и го поставя в топика на Hazelcast. Други ноди на приложението, подписани на този топик, получават и обработват събитието.
- Клъстерни заключвания. Например, създаваме обсъждане по уникален ключ (обсъждане-сингълтон в рамките на базата 1С):
conversationKeyChecker.check("БЕНЗОКОЛОНКА");

      doInClusterLock("БЕНЗОКОЛОНКА", () -> {

          conversationKeyChecker.check("БЕНЗОКОЛОНКА");

          createChannel("БЕНЗОКОЛОНКА");
      });
Проверихме, че каналът не съществува. Взехме заключване, отново проверихме, създадохме. Ако след взимането на заключването не проверим, има шанс, че друг поток в този момент също е проверил и сега ще се опита да създаде същото обсъждане – а то вече съществува. Да се прави заключването чрез synchronized или обикновен java Lock не е възможно. Чрез базата е бавно, а и е жалко за базата, чрез Hazelcast – това, което трябва.
Избираме СУБД
Имаме голям и успешен опит с PostgreSQL и сътрудничество с разработчиците на тази СУБД.
С клъстера при PostgreSQL не е лесно – има , , , но, в общи линии, това не е noSQL, които се мащабират от самото начало. NoSQL като основно хранилище не направихме, достатъчно бе, че използваме Hazelcast, с който преди не сме работили.
Тъй като е необходимо да се мащабира релационната БД – значи, . Както знаете, при шардинга разделяме базата данни на отделни части, така че всяка от тях да може да бъде преместена на отделен сървър.
Първият вариант на нашия шардинг предвиждаше възможността да разпределим всяка от таблиците на нашето приложение на различни сървъри в различни пропорции. Много съобщения на сървър А – моля, нека преместим част от тази таблица на сървър Б. Такова решение просто викат за преждевременна оптимизация, така че решихме да се ограничим до multi-tenant подхода.
Можете да прочетете за multi-tenant, например, на сайта .
В СВ има понятия приложение и абонат. Приложението е конкретна инсталация на бизнес приложение, например, ERP или Счетоводство, със свои потребители и бизнес данни. Абонат е организация или физическо лице, от името на което се извършва регистрацията на приложението на сървъра на СВ. Един абонат може да има регистрирани няколко приложения, които могат да обменят съобщения помежду си. Абонатът стана наемател (tenant) в нашата система. Съобщения на няколко абоната могат да се намират в една физическа база; ако видим, че някой абонат генерира много трафик - изнасяме го в отделна физическа база (или дори отделен сървър на БД).
Имаме основна БД, където се съхранява таблицата за маршрутизиране с информация за местоположението на всички абонатски бази данни.
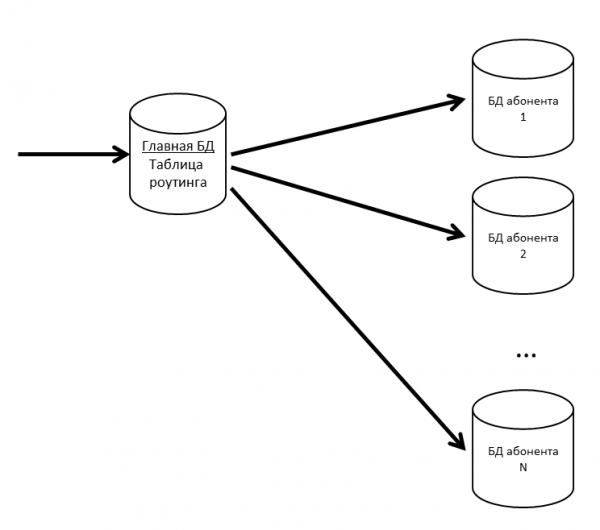
За да не бъде основната БД узко място, таблицата за маршрутизиране (и други често търсени данни) я държим в кеш.
Ако започне да забавя БД на абоната, ще я разбиваме на партиции. В други проекти за партициониране на големи таблици използваме .
Тъй като е лошо да се губят съобщения от потребители, поддържаме нашите БД с реплики. Комбинацията от синхронни и асинхронни реплики позволява да се застраховаме в случай на загуба на основната БД. Загубата на съобщение ще се случи само в случай на едновременно отказ на основната БД и нейното синхронно реплика.
Ако се изгуби синхронната реплика – асинхронната реплика става синхронна.
Ако се изгуби основната БД – синхронната реплика става основна БД, асинхронната реплика – синхронна реплика.
Elasticsearch за търсене
Тъй като, освен всичко друго, СВ е и мессенджър, тук е необходим бърз, удобен и гъвкав търсене, с оглед на морфологията, по неточни съвпадения. Решихме да не изобретяваме колелото и да използваме свободната търсеща система Elasticsearch, създадена на основата на библиотеката . Elasticsearch също разгръщаме в клъстер (master – data – data), за да избегнем проблеми в случай на отказ на възли на приложението.
На github намерихме за Elasticsearch и го използваме. В индекса Elasticsearch съхраняваме корените на думите (които определя плъгинът) и N-грамите. Когато потребителят въвежда текст за търсене, търсим въведеното текстово съдържание между N-грамите. Когато запазваме в индекса, думата „текстове“ ще бъде разделена на следните N-грами:
[те, тек, текс, текст, текстове, ек, екс, екст, екстове, кс, кст, кстове, ст, стове, ти],
Също така ще бъде запазен коренът на думата „текст“. Този подход позволява търсене както по начало, така и по средата, и по края на думите.
Общата картина
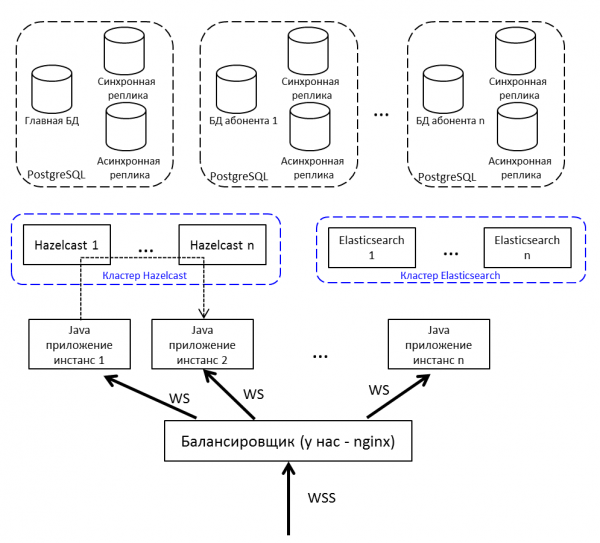
Повтор на картината от началото на статията, но вече с обяснения:
- Балансировчик, поставен в интернет; при нас – nginx, може да бъде всякакъв.
- Инстанциите на Java-приложението комуникират помежду си чрез Hazelcast.
- За работа с уеб сокет използваме .
- Java-приложението е написано на Java 8, състои се от бандли . В плановете ни е миграция на Java 10 и преминаване на модули.
Разработка и тестване
В процеса на разработка и тестване на СВ се сблъскахме със серия от интересни особености на продуктите, които използвахме.
Нагрузочно тестване и течове на паметта
Издаването на всяка версия на СВ – етово натоварващо тестване. То е преминато успешно, когато:
- Тестът е работил няколко дни и не е имало откази в обслужването
- Времето за реакция по ключовите операции не е надвишило комфортния праг
- Влошаването на производителността в сравнение с предишната версия не е повече от 10%
Попълваме тестовата база с данни – за това вземаме от продукционния сървър информация за най-активния абонат, умножаваме цифрите му по 5 (брой съобщения, обсъждания, потребители) и така тестваме.
Нагрузочното тестване на системата на взаимодействие провеждаме в три конфигурации:
- Стрес-тест
- Само свързвания
- Регистрация на абонати
При стрес теста стартираме няколко стотин потока, и те без спиране натоварват системата: пишат съобщения, създават обсъждания, получават списък с съобщения. Имитиране на действия на обикновени потребители (да получат списък на моите непрочетени съобщения, да напишат на някого) и софтуерни решения (да предадат пакет на друга конфигурация, да обработят уведомление).
Например, така изглежда част от стрес теста:
- В системата влиза потребител
- Запитва своите непрочетени обсъждания
- С 50% вероятност чете съобщения
- С 50% вероятност пише съобщения
- По-нататък потребителят:
- С 20% вероятност създава нова дискусия
- Случайно избира което и да е от своите дискусии
- Влиза вътре
- Запитва съобщения, профили на потребители
- Създава пет съобщения, адресирани до случайни потребители от тази дискусия
- Излиза от дискусията
- Повтаря 20 пъти
- Излиза от системата, връща се обратно в началото на сценария
- В системата влиза чат-бот (емулира обмен на съобщения от кода на приложните решения)
- С 50% вероятност създава нов канал за обмен на данни (специална дискусия)
- С 50% вероятност пише съобщение в който и да е от съществуващите канали
Сценарият "Само свързвания" не се е появил просто така. Случва се ситуация: потребителите свързват системата, но все още не са се включили. Всеки потребител сутрин в 09:00 включва компютъра, установява връзка със сървера и мълчи. Тези хора са опасни, те са много – от пакетите получават само PING/PONG, но продължават да поддържат връзка със сървера (не могат да я загубят – ами ако дойде ново съобщение). Тестът възпроизвежда ситуация, при която за половин час в системата се опитват да се авторизират голям брой такива потребители. Прилича на стрес-тест, но акцентът му е именно на това първо влизане – за да няма откази (човекът не използва системата, а тя вече се отказва – трудно е да се измисли нещо по-лошо).
Сценарият за регистрация на абонати започва с първото стартиране. Проведохме стрес-тест и бяхме сигурни, че при кореспонденцията системата не забавя. Но потребителите дойдоха и регистрацията започна да пада по таймаут. При регистрацията използвахме , който е свързан с ентропията на системата. Сървърът не успяваше да събере достатъчно ентропия и при заявка за нов SecureRandom замръзваше за десетки секунди. Има много изходи от такава ситуация, например: да се премине на по-малко сигурен /dev/urandom, да се постави специално устройство, което формира ентропия, да се генерират случайни числа предварително и да се съхраняват в пул. Временно решихме проблема с пула, но оттогава провеждаме отделен тест за регистрация на нови абонати.
Като генератор на натоварване използваме . Не може да работи с уебсокети, нужен е плъгин. Първите резултати в търсенето по заявка "jmeter websocket" са , в които препоръчват .
С него и решихме да започнем.
Почти веднага след началото на сериозно тестване открихме, че в JMeter започнаха да се появяват пробиви в паметта.
Плъгинът е отделна голяма история, с 176 звезди и 132 форка в github. Авторът не е комитвал в него от 2015 година (взехме го през 2015, тогава това не предизвика съмнения), има няколко проблема в github относно пробиви в паметта и 7 незатворени pull request-а.
Ако решите да провеждате натоварващо тестване с този плъгин, обърнете внимание на следните обсъждания:
- В многопоточна среда се използваше обикновен LinkedList, в резултат получавахме в рантайма. Това се решава или чрез преминаване на ConcurrentLinkedDeque, или чрез синхронизирани блокове. За себе си избрахме първия вариант ().
- Пробив в паметта, информацията за свързването не се изтрива при дисконект ().
- В режим на стрийминг (когато уебсокетът не се затваря в края на сэмпла, а се използва по-нататък в плана) не работят шаблоните за отговори ().
Това е едно от тези, които са в github. Какво направихме:
- Взехме (@elyrank) – той решава проблемите 1 и 3
- Решихме проблема 2
- Актуализирахме jetty от 9.2.14 на 9.3.12
- Овивахме SimpleDateFormat в ThreadLocal; SimpleDateFormat не е потокобезопасен, което водеше до NPE в рантайма
- Отстранихме още един пробив в паметта (връзката не се затваряше правилно при дисконект)
И все пак тече!
Паметта започна да свършва не за ден, а за два. Времето беше малко, решихме да стартираме по-малко потоци, но на четирима агенти. Това трябваше да е достатъчно поне за седмица.
Изминаха два дни...
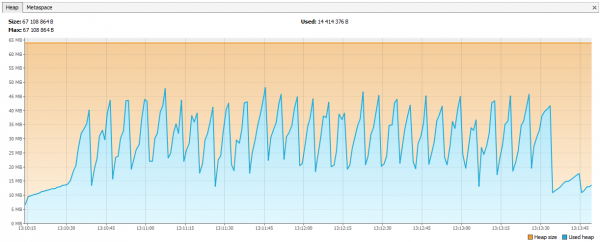
Сега паметта започна да свършва при Hazelcast. В логовете се виждаше, че след няколко дни тестване Hazelcast започва да се оплаква от недостиг на памет, а след известно време клъстърът се разпада и възлите започват да умират поединично. Свързахме JVisualVM към hazelcast и видяхме "възходящата пила" – той редовно призоваваше GC, но не можеше да освободи памет.
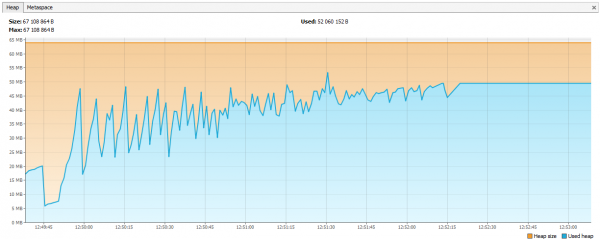
Оказа се, че в hazelcast 3.4 при изтриване на map / multiMap (map.destroy()) паметта не се освобождава напълно:
Сега грешката е поправена в 3.5, но тогава това беше проблем. Създавахме нови multiMap с динамични имена и ги изтривахме по нашата логика. Кодът изглеждаше горе-долу така:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Виклик:
service.join(auth1, "НОВИ_СЪОБЩЕНИЯ_В_ДИСКУСИЯ_UUID1");
service.join(auth2, "НОВИ_СЪОБЩЕНИЯ_В_ДИСКУСИЯ_UUID1");
multiMap беше създаден за всяка абонаментна услуга и беше премахнат, когато вече не е нужен. Решихме, че ще създадем Map, където ключът ще бъде името на абонамента, а стойностите ще бъдат идентификаторите на сесиите (по които след това можем да получим идентификаторите на потребителите, ако е нужно).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Графиките се стабилизираха.
Какво друго научихме за натоварващото тестване
- JSR223 трябва да се пише на groovy и да се включва compilation cache – това е значително по-бързо. .
- Графиките на Jmeter-Plugins са по-лесни за разбиране, отколкото стандартните. .
За нашия опит с Hazelcast
Hazelcast за нас беше нов продукт, започнахме да работим с него от версия 3.4.1, в момента на нашия продукционен сървър е инсталирана версия 3.9.2 (в момента на написването на статията последната версия на Hazelcast е 3.10).
Генериране на ID
Започнахме с целочислени идентификатори. Нека си представим, че ни е нужен нов Long за нова сущност. Последователността в БД не е подходяща, таблиците участват в шардването – ще се окаже, че има съобщение ID=1 в БД1 и съобщение ID=1 в БД2, в Elasticsearch не можеш да сложиш такъв ID, в Hazelcast също, но най-страшното е, ако искате да обедините данните от две БД в една (например, решавайки, че една база е достатъчна за тези абонати). Може да се заведат няколко AtomicLong в Hazelcast и да се поддържа брояч там, тогава производителността за получаване на нов ID – incrementAndGet плюс времето за заявка към Hazelcast. Но в Hazelcast има нещо по-оптимално – FlakeIdGenerator. На всеки клиент при запитване му се предоставя диапазон ID, например, на първия – от 1 до 10 000, на втория – от 10 001 до 20 000 и така нататък. Сега клиентът може сам да генерира нови идентификатори, докато не изчерпи предоставения му диапазон. Работи бързо, но при рестартиране на приложението (и клиента Hazelcast) започва нова последователност – откъдето идват пропуските и т.н. Освен това на разработчиците не е много ясно защо ID-тата са целочислени, но идват толкова разпокъсано. Ние всичко обмислихме и преминахме на UUID.
Между прочим, для тех, кто хочет быть как Твиттер, существует библиотека Snowcast — это реализация Snowflake поверх Hazelcast. Можно посмотреть здесь:
Но у нас до неё ещё не дошли руки.
TransactionalMap.replace
Ещё один сюрприз: TransactionalMap.replace не работает. Вот такой тест:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Ожидалось: newValue
Фактически: oldValue
Пришлось написать свой метод replace, используя getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Замена значения в транзакционной карте");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Замена значения в не транзакционной карте");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Тестируйте не только обычные структуры данных, но и их транзакционные версии. Иногда IMap работает, а TransactionalMap — нет.
Подложить новый JAR без даунтайма
Сначала мы решили записывать в Hazelcast объекты своих классов. Например, у нас есть класс Application, мы хотим его сохранить и прочитать. Сохраняем:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Читаем:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Все работает. Потом мы решили построить индекс в Hazelcast, чтобы искать по нему:
map.addIndex("subscriberId", false);И при записи новой сущности начали получать ClassNotFoundException. Hazelcast хотел обновить индекс, но ничего не знал о нашем классе и требовал, чтобы мы подложили JAR с этим классом. Мы так и сделали, всё заработало, но возникла новая проблема: как обновить JAR без полной остановки кластера? Hazelcast не подхватывает новый JAR при понодовом обновлении. В этот момент мы решили, что вполне можем обойтись без поиска по индексу. Если использовать Hazelcast как хранилище типа ключ-значение, то должно всё работать, не так ли? Не совсем. Здесь снова наблюдается разное поведение IMap и TransactionalMap. Там, где IMap-у всё равно, TransactionalMap выбрасывает ошибку.
IMap. Записваме 5000 обекта, прочитаме. Всичко е очаквано.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
А в транзакцията не работи, получаваме ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
В 3.8 се появи механизмът User Class Deployment. Можете да назначите една главна нода и да обновите JAR файла на нея.
Сега напълно сменихме подхода: сами сериализираме в JSON и го запазваме в Hazelcast. На Hazelcast не му трябва да знае структурата на нашите класове, а ние можем да се обновяваме без престой. Управлението на версионирането на домейн обектите е в приложението. В същото време може да бъдат стартирани различни версии на приложението, и може да се случи новото приложение да записва обекти с нови полета, а старото все още да не знае за тези полета. И в същото време новото приложение да чете обекти, записани от старото приложение, в които няма нови полета. Такива ситуации обработваме вътре в приложението, но за простота не променяме и не изтриваме полета, само разширяваме класовете, като добавяме нови полета.
Как осигуряваме висока производителност
Четири повиквания към Hazelcast – добре, две към БД – зле
По-добре е да се взимат данни от кеша, отколкото от база данни, но не искаме да съхраняваме ненужни записи. Решението за това какво да кешираме отлагаме за последния етап на разработката. Когато новата функционалност е кодирана, включваме в PostgreSQL логиране на всички заявки (log_min_duration_statement на 0) и стартираме натоварващо тестване за около 20 минути. Според събраните логове инструменти като pgFouine и pgBadger могат да генерират аналитични отчети. В отчетите на първо място търсим бавни и чести заявки. За бавните заявки изграждаме план за изпълнение (EXPLAIN) и оценяваме дали можем да ускорим заявката. Честите заявки с едни и същи входни данни се кешират добре. Опитваме се да поддържаме заявките „плоски“, с една таблица в заявката.
Експлоатация
Системата Взаимодействие като онлайн услуга беше стартирана през пролетта на 2017 година, а като отделен продукт излезе през ноември 2017 (в статус на бета версия).
През повече от година експлоатация не се е случвало сериозни проблеми с работата на онлайн услугата. Онлайн услугата наблюдаваме през , събираме и деплоим от .
Дистрибуцията на сървъра Системата Взаимодействие се предоставя в вид на нативни пакети: RPM, DEB, MSI. Освен това за Windows предлагаме единен инсталатор във вид на един EXE, който инсталира сървъра, Hazelcast и Elasticsearch на една машина. Първоначално нарекохме тази версия на инсталацията „демонстрационна“, но сега стана ясно, че това е най-популярният вариант за разгръщане.
Източник: habr.com
