

Здравей, Хабр!
Напомняме, че след книгата за пуснахме не по-малко интересен труд за библиотеката .
Докато общността все още опознава границите на възможностите на този мощен инструмент. Наскоро излезе статия, с която искаме да ви запознаем. Авторът разказва от личен опит как да направите от Kafka Streams разпределено хранилище за данни. Приятно четене!
Библиотеката Apache се използва по целия свят в предприятието за разпределена потокова обработка върху Apache Kafka. Един от недооценените аспекти на този фреймворк е, че той позволява съхранение на локално състояние, произвеждано на базата на потокова обработка.
В тази статия ще разкажа как в нашата компания успяхме ефективно да използваме тази възможност при разработването на продукт за безопасност на облачни приложения. С помощта на Kafka Streams създадохме микросервизи с споделено състояние, всеки от които служи за отказоустойчив и високо достъпен източник на достоверна информация за състоянието на обектите в системата. За нас това е напредък както по отношение на надеждността, така и на удобството при поддръжката.
Ако ви интересува алтернативен подход, който позволява да използвате единна централизирана база данни за поддържане на формалното състояние на вашите обекти - прочетете, ще бъде интересно…
Защо сметнахме, че е време да променим подходите си за работа с споделено състояние
Трябваше да поддържаме състоянието на различни обекти, разчитайки на докладите на агентите (например: подлаган ли е сайтът на атака)? Преди преминаването към Kafka Streams често разчитахме за управлението на състоянието на единна централизирана база данни (+ сервисен API). Такъв подход има свои недостатъци: в поддръжката на последователността и синхронизацията се превръща в истинско предизвикателство. Базата данни може да стане тясно място, или да се окаже в и да страда от непредсказуемост.
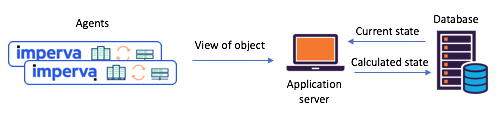
Илюстрация 1: типичен сценарий с разделение на състоянието, срещал се преди преминаването към
Kafka и Kafka Streams: агентите съобщават своите представи чрез API, обновеното състояние се изчислява чрез централна база данни
Запознайте се с Kafka Streams – сега е лесно да създавате микросервизи с споделено състояние
Около година назад решихме да преразгледаме нашите сценарии за работа с споделено състояние, за да се справим с някои проблеми. Веднага решихме да опитаме Kafka Streams – известно е колко е мащабируема, високо достъпна и устойчива на повреди, както и богатството на нейната потокова функционалност (трансформации, включително и със запазване на състоянието). Точно това, от което се нуждаехме, да не говорим колко зряла и надеждна система за обмен на съобщения еKafka.
Всеки от нашите създадени микросервизи със запазване на състояние беше изграждан на базата на инстанция на Kafka Streams с доста проста топология. Тя се състоеше от 1) източник 2) процесор с постоянно хранилище на ключове и стойности 3) поток:
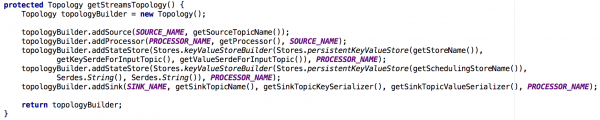
Илюстрация 2: зададената по подразбиране топология на нашите потокови инстанции за микросервизи със запазване на състояние. Обърнете внимание: тук също има хранилище, в което се намират метаданни за планирането.
При този нов подход агентите създават съобщения, подавани в изходния топик, а потребителите – да речем, услугата за имейл уведомления – приемат изчисленото споделено състояние чрез потока (изходния топик).
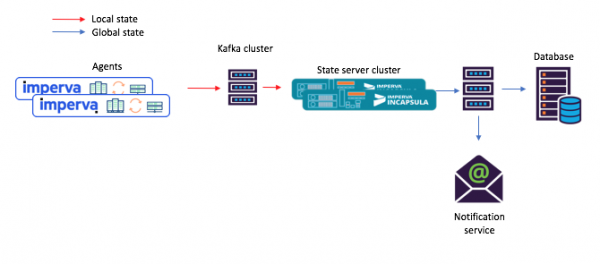
Илюстрация 3: нов пример за поток от задачи за сценарий със споделени микросервизи: 1) агент генерира съобщение, постъпващо в изходния топик на Kafka; 2) микросервиз със споделено състояние (използващ Kafka Streams) обработва съобщението и записва изчисленото състояние в краен топик на Kafka; след което 3) потребителите приемат новото състояние.
Хей, а това вградено хранилище на ключове и стойности наистина е много полезно!
Както споменахме по-горе, нашата топология със споделено състояние съдържа хранилище на ключове и стойности. Ние открихме няколко варианта за неговото използване, като два от тях са описани по-долу.
Вариант #1: употреба на хранилището на ключове и стойности при изчисления.
Нашето първо хранилище на ключове и стойности съдържаше помощни данни, които ни бяха необходими за изчисленията. Например, в някои случаи споделеното състояние се определяше по принципа на "повечето гласове". В хранилището можеха да се съхраняват всички последни отчети на агентите за състоянието на определен обект. След това, получавайки нов отчет от даден агент, можехме да го запазим, да изтеглим от хранилището отчетите на всички останали агенти за същия обект и да повторим изчислението.
На изображение 4 е показано как отворихме достъпа до хранилището на ключове и стойности за метода на обработка на процесора, така че после да можем да обработим ново съобщение.
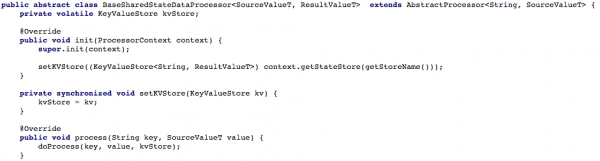
Изображение 4: отваряме достъпа до хранилището на ключове и стойности за метода на обработка на процесора (след това във всеки сценарий, работещ с споделено състояние, е необходимо да се реализира методът doProcess)
Вариант #2: създаване на CRUD API върху Kafka Streams
След като настроихме основния поток от задачи, започнахме да опитваме да напишем RESTful CRUD API за нашите микросервизи със споделено състояние. Искахме да можем да извличаме състоянието на някои или всички обекти, както и да задаваме или премахваме състоянието на обект (това е полезно за поддръжка на сървърната част).
За поддръжка на всички API Get State, всеки път, когато ни беше необходимо да изчислим отново състоянието по време на обработка, ние дълго време го съхранявахме в вградена хранилище на ключове и стойности. В такъв случай е достатъчно просто да се реализира такова API с помощта на единствен екземпляр на Kafka Streams, както е показано в долния листинг:
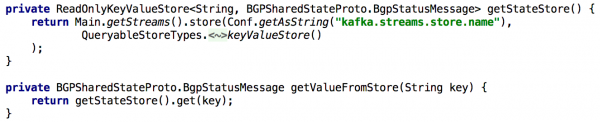
Изображение 5: използване на вграденото хранилище на ключове и стойности за получаване на предизчислено състояние на обекта
Обновяването на състоянието на обекта чрез API също не е сложно за реализиране. В принципе, за това е необходимо само да се създаде Kafka продюсер, а с него да се направи запис, в който е заключено новото състояние. Така се гарантира, че всички съобщения, генерирани чрез API, ще се обработват точно така, както и постъпващите от други продюсери (например, агенти).
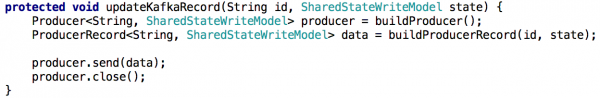
Изображение 6: задаване на състояние на обекта може да стане чрез Kafka продюсер
Някакво усложнение: Kafka има множество партиции
Следващата ни стъпка беше да разпределим натоварването, свързано с обработката, и да подобрим достъпността, като предоставим на всеки сценарий клъстер от микросервизи с общо състояние. Настройването мина много лесно: след като конфигурирахме всички инстанции да работят с един и същи ID на приложението (и с онези сървъри за начално зареждане), практически всичко останало се извършваше автоматично. Също така зададохме, че всяка входяща тема ще се състои от няколко партиции, за да може на всяка инстанция да бъде присвоено подмножество от тези партиции.
Също така искам да спомена, че тук е често срещано да се прави резервно копие на хранилището на състояния, за да може, например, при възстановяване от отказ, да се прехвърли това копие на друга инстанция. За всяко хранилище на състояния в Kafka Streams се създава репликирана тема с журнал на промените (в която се проследяват локалните актуализации). По този начин Kafka постоянно осигурява хранилището на състояния. Следователно, в случай на отказ на определена инстанция, състоянието на хранилището на Kafka Streams може да бъде бързо възстановено на друга инстанция, където ще преминат съответните партиции. Нашите тестове показаха, че това се извършва за секунди, дори когато в хранилището има милиони записи.
Преминаването от един микросервис с общо състояние към клъстер от микросервизи не е толкова тривиално, когато става въпрос за реализиране на Get State API. В новата ситуация хранилището на състояния на всеки микросервис съдържа само част от общата картина (тези обекти, чиито ключове се отнасят за конкретна партиция). Трябваше да определим на коя инстанция е състоянието на нужния ни обект, и ние направихме това на базата на метаданните на потоковете, както е показано по-долу:
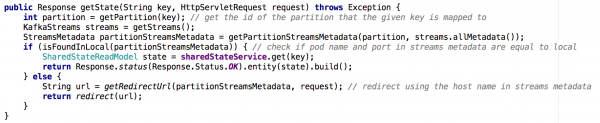
Илюстрация 7: с помощта на метаданните на потоковете определяме от коя инстанция да се запитаме за състоянието на необходимия обект; подобен подход беше приложен и за GET ALL API.
Основни изводи
Хранилища на състояния в Kafka Streams де факто могат да служат като разпределена база данни,
- постоянно репликирана в Kafka.
- Над такава система лесно може да се изградие CRUD API.
- Обработката на множество партиции става малко по-сложна.
- Също така е възможно да добавите едно или повече хранилища на състояния в поточната топология за съхранение на спомагателни данни. Тази опция може да се използва за:
- Дълготрайно съхранение на данни, необходими за изчисления при потокова обработка
- Дълготрайно съхранение на данни, които могат да бъдат полезни при следващата инициализация на потоковия инстанс
- много друго…
Благодарение на тези и други предимства, Kafka Streams е отличен избор за поддържане на глобално състояние в разпределени системи като нашата. Kafka Streams се е показала като изключително надеждна в продукция (от момента на внедряването практически не сме загубили съобщения) и сме уверени, че възможностите ѝ не се ограничават с това!
Източник: habr.com
