

Здравейте, приятели. Преди да се отправим към втората част на майските празници, споделяме с вас материал, който преведохме в подготовка за старта на нов поток по курса. .
Разработчиците на приложения прекарват много време в сравнение на няколко операционни бази данни, за да избират тази, която най-добре отговаря на предвиденото натоварване. Потребностите могат да включват опростено моделиране на данни, транзакционни гаранции, производителност на четене/запис, хоризонтално мащабиране и отказоустойчивост. По традиция изборът започва с категорията база данни, SQL или NoSQL, тъй като всяка категория предоставя ясен набор от компромиси. Високата производителност, от гледна точка на ниска латентност и висока пропускна способност, обикновено се разглежда като изискване, което не допуска компромиси, и следователно е необходимо за всяка база данни от избора.
Целта на тази статия е да помогне на разработчиците на приложения да направят правилния избор между SQL и NoSQL в контекста на моделирането на данните на приложението. Ще разгледаме една SQL база данни, а именно PostgreSQL, и две NoSQL бази данни – Cassandra и MongoDB, за да разкажем за основите на проектирането на бази данни, като създаване на таблици, тяхното запълване, четене на данни от таблицата и тяхното изтриване. В следващата статия задължително ще разгледаме индекси, транзакции, JOIN команди, директиви TTL и проектиране на бази данни на базата на JSON.
Каква е разликата между SQL и NoSQL?
SQL базите данни повишават гъвкавостта на приложението благодарение на транзакционните гаранции ACID, а също така и поради своята способност да заявяват данни чрез JOIN по неочаквани начини над съществуващите нормализирани модели на релационните бази данни.
Имайки предвид монолитната/едноузловата архитектура и използването на master-slave модел за репликация, традиционните SQL бази данни нямат две важни особености – линейна мащабируемост на записите (т.е. автоматично разпределение на множество възли) и автоматична/нула загуба на данни. Това означава, че обемът на получените данни не може да надвишава максималния капацитет за запис на един възел. Освен това, известна времева загуба на данни трябва да бъде взета предвид при отказоустойчивостта (в архитектура без разпределение на ресурси). Тук е важно да се има предвид, че скорошни ангажименти все още не са отразени в подчинената (slave) копия. Актуализациите без престой също са труднодостижими в SQL бази данни.
NoSQL базите данни по своята природа обикновено са разпределени, т.е. данните се разделят на секции и се разпределят по няколко възли. Те изискват денормализация. Това означава, че въведените данни трябва да бъдат копирани многократно за отговор на конкретни запитвания, които отправяте. Общата цел е да се постигне висока производителност, като се намали броят на шардовете, достъпни по време на четене. Оттук следва тезата, че NoSQL изисква от вас да моделирате вашите запитвания, докато SQL изисква да моделирате вашите данни.
NoSQL се акцентира на постигането на висока производителност в разпределен клъстер, и това е основното оправдание за множество компромиси при проектирането на бази данни, които включват загуба на транзакционните гаранции ACID, JOIN-и и съгласувани глобални вторични индекси.
Съществува мнение, че, въпреки че NoSQL базите данни осигуряват линейна мащабируемост на записите и висока отказоустойчивост, загубата на транзакционни гаранции ги прави неподходящи за критично важни данни.
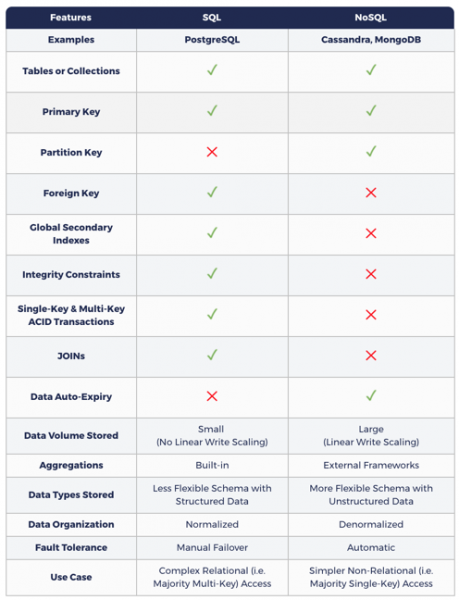
Следващата таблица показва как моделирането на данни в NoSQL се различава от SQL.
SQL и NoSQL: Защо и двете са необходими?
На реални приложения с голямо количество потребители, как Amazon.com, Netflix, Uber и Airbnb, лежи изпълнението на сложни разноцветни задачи. Например, приложение за електронна търговия, подобно на Amazon.com, трябва да съхранява леки, високо-критични данни, като информация за потребители, продукти, поръчки, фактури, наред с тежки, но по-малко чувствителни данни, като отзиви за продукти, съобщения от обслужване на клиенти, активност на потребителите, мнения и препоръки от потребители. Естествено, тези приложения разчитат на поне една SQL база данни, наред с поне една NoSQL база данни. В междурегионални и глобални системи, NoSQL базата данни служи като геораспределен кеш за данни, съхранявани в надежден източник, SQL база данни, работеща в определен регион.
Как YugaByte DB обединява SQL и NoSQL?
Изграден на лог-ориентиран смесен двигател за съхранение, авто-шардинг, шардингова дистрибуционна консенсусна репликация и разпределени транзакции ACID (вдъхновени от Google Spanner), YugaByte DB е първата в света база данни с отворен код, която едновременно е съвместима с NoSQL (Cassandra & Redis) и SQL (PostgreSQL). Както е показано в таблицата по-долу, YCQL, API-то на YugaByte DB, съвместимо с Cassandra, добавя понятията за едно- и многоключови ACID транзакции и глобални вторични индекси в NoSQL API-то, откривайки по този начин ерата на транзакционните NoSQL бази данни. Освен това, YCQL, API-то на YugaByte DB, съвместимо с PostgreSQL, добавя понятията за линейно мащабиране на записи и автоматична отказоустойчивост към SQL API-то, представяйки на света разпределени SQL бази данни. Тъй като базата данни YugaByte DB по същество е транзакционна, API-то на NoSQL може да бъде използвано в контекста на критично важни данни.
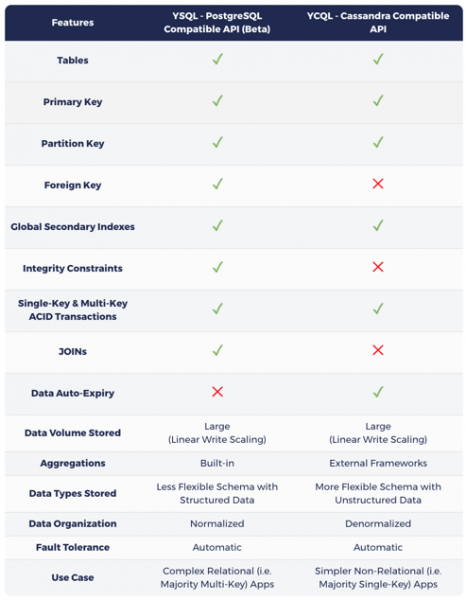
Както бе споменато по-рано в статията , изборът между SQL и NoSQL в YugaByte DB изцяло зависи от характеристиките на основната работна натовареност:
- Ако основната работна натовареност е многоключови операции с JOIN, то при избора на YSQL, имайте предвид, че вашите ключове може да бъдат разпределени на няколко възела, което ще доведе до по-висока латентност и/или намалена пропускателна способност в сравнение с NoSQL.
- В противном случае, изберете любой из двух NoSQL API, помня о том, что вы получите более высокую производительность в результате запросов, обслуживаемых с одного узла за раз. YugaByte DB может служить единой операционной базой данных для реальных сложных приложений, где необходимо управлять несколькими рабочими нагрузками одновременно.
В основе лаборатории моделирования данных (Data modeling lab) в следующем разделе лежат совместимые с PostgreSQL и Cassandra API базы данных YugaByte DB, в отличие от исходных баз данных. Этот подход подчеркивает простоту взаимодействия с двумя различными API (на двух разных портах) одного и того же кластера баз данных по сравнению с использованием полностью независимых кластеров двух разных баз данных.
В следующих разделах мы познакомимся с лабораторией моделирования данных, чтобы проиллюстрировать различия и некоторые общие черты рассматриваемых баз данных.
Лаборатория моделирования данных
Установка баз данных
Учитывая акцент на проектировании модели данных (а не на сложных архитектурах развертывания), мы установим базы данных в Docker контейнеры на локальном компьютере, а затем будем взаимодействовать с ними, используя соответствующие им оболочки командной строки.
Совместимая с PostgreSQL & Cassandra, база данных YugaByte DB
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestДоступ через командную строку
Давайте подключимся к базам данных, с помощью оболочки командной строки для соответствующих API.
PostgreSQL
— это оболочка командной строки для взаимодействия с PostgreSQL. Для простоты использования YugaByte DB поставляется с psql прямо в папке bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— это оболочка командной строки для взаимодействия с Cassandra и ее совместимыми базами данных через CQL (язык запросов Cassandra). Для удобства использования YugaByte DB поставляется с cqlsh в директорията bin.
Обратите внимание, что CQL был вдохновлен SQL и имеет аналогичные понятия таблиц, строк, столбцов и индексов. Однако как язык NoSQL, он добавляет определенный набор ограничений, большинство из которых мы также рассмотрим в других статьях.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– е команден интерфейс за връзка с MongoDB. Може да бъде намерен в директорията bin на инсталацията на MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Създаване на таблица
Сега можем да взаимодействаме с базата данни, за да извършваме различни операции чрез командния ред. Нека започнем със създаване на таблица, която съхранява информация за песни, написани от различни изпълнители. Тези песни могат да бъдат част от албум. Също така, опционални атрибути за песента са годината на издаване, цена, жанр и рейтинг. Трябва да имаме предвид допълнителни атрибути, които могат да са необходими в бъдеще, чрез полето „етикети“. То може да съхранява полуструктурирани данни под формата на двойки ключ-стойност.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Създаването на таблица в Cassandra е много подобно на PostgreSQL. Едно от основните различия е отсъствието на ограничения за целостта (например, NOT NULL), но това попада в отговорността на приложението, а не на NoSQL базата данни. Първичният ключ се състои от ключа на раздела (колоната Artist в примера по-долу) и набор от колони за класификация (колоната SongTitle в предоставения по-долу пример). Ключът на раздела определя в кой раздел/шард да бъде поставен редът, а колоните за класификация указват как трябва да бъдат организирани данните в текущия шард.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB организира данни в бази данни (Database) (аналогично на Keyspace в Cassandra), където има колекции (Collections) (аналогично на таблиците), в които се съдържат документи (Documents) (аналогично на редовете в таблица). В MongoDB по принцип не е необходимо определяне на първоначална схема. Командата «use database», показана по-долу, създава екземпляр на базата данни при първото извикване и променя контекста за новосъздадената база данни. Дори колекциите не трябва да се създават явно, те се създават автоматично, просто при добавяне на първия документ в нова колекция. Обърнете внимание, че по подразбиране MongoDB използва тестова база данни, така че всяка операция на ниво колекции без посочване на конкретна база ще бъде извършвана в нея по подразбиране.
use myNewDatabase;Получаване на информация за таблицата
PostgreSQL
d Music
Таблица "public.music"
    Колонка    |         Тип         | Сравнение | Nullable | По умолчанию
--------------+-----------------------+-----------+----------+--------
 артист       | character varying(20) |           | not null |
 название_песни | character varying(30) |           | not null |
 название_альбома | character varying(25) |           |          |
 год         | integer               |           |          |
 цена        | double precision      |           |          |
 жанр        | character varying(10) |           |          |
 рейтинг_критиков | double precision      |           |          |
 теги         | text                  |           |          |
Индексы:
    "music_pkey" PRIMARY KEY, btree (артист, название_песни)
Cassandra
ОПИСАТЬ ТАБЛИЦУ MUSIC;
СОЗДАТЬ ТАБЛИЦУ myapp.music (
    артист text,
    название_песни text,
    название_альбома text,
    год int,
    цена float,
    жанр text,
    теги text,
    PRIMARY KEY (артист, название_песни)
) С ПОРЯДКОМ КЛАСТЕРИЗАЦИИ ПО (название_песни ASC)
    И default_time_to_live = 0
    И transactions = {'enabled': 'false'};
MongoDB
использовать myNewDatabase;
показать коллекции;
Внесение данных в таблицу
PostgreSQL
ВСТАВИТЬ В Music
    (Артист, НазваниеПесни, НазваниеАльбома,
    Год, Цена, Жанр, РейтингКритиков,
    Теги)
Значения(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
ВСТАВИТЬ В Music
    (Артист, НазваниеПесни, НазваниеАльбома,
    Цена, Жанр, РейтингКритиков)
Значения(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
ВСТАВИТЬ В Music
    (Артист, НазваниеПесни, НазваниеАльбома,
    Цена, Жанр)
Значения(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
ВСТАВИТЬ В Music
    (Артист, НазваниеПесни, НазваниеАльбома,
    Цена, Жанр,
    Теги)
Значения(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
В целом выражение INSERT в Cassandra выглядит очень похоже на аналогичное в PostgreSQL. Однако имеется одно большое различие в семантике. В Cassandra INSERT фактически является операцией UPSERT, где в строку добавляются последние значения, в случае, если строка уже существует.
Ввод данных происходит аналогично PostgreSQL
INSERTпо-горе
.
MongoDB
Несмотря на то, что MongoDB является NoSQL базой данных, подобно Cassandra, ее операция внесения данных не имеет ничего общего с семантическим поведением в Cassandra. В MongoDB не имеет возможностей UPSERT, что делает его похожим на PostgreSQL. Добавление данных по умолчанию без _idspecified приведет к добавлению нового документа в коллекцию.
db.music.insert( {
 изпълнител: "No One You Know",
 заглавиеНаПесента: "Call Me Today",
 заглавиеНаАлбума: "Somewhat Famous",
 година: 2015,
 цена: 2.14,
 жанр: "Country",
 етикети: {
 Композитори: ["Smith", "Jones", "Davis"],
 дължинаВСекунди: 214
 }
 }
 );
 db.music.insert( {
 изпълнител: "No One You Know",
 заглавиеНаПесента: "My Dog Spot",
 заглавиеНаАлбума: "Hey Now",
 цена: 1.98,
 жанр: "Country",
 оценкаОтКритиците: 8.4
 }
 );
 db.music.insert( {
 изпълнител: "The Acme Band",
 заглавиеНаПесента: "Look Out, World",
 заглавиеНаАлбума:"The Buck Starts Here",
 цена: 0.99,
 жанр: "Rock"
 }
 );
 db.music.insert( {
 изпълнител: "The Acme Band",
 заглавиеНаПесента: "Still In Love",
 заглавиеНаАлбума:"The Buck Starts Here",
 цена: 2.47,
 жанр: "Rock",
 етикети: {
 радиостанцииИзлъчващи:["KHCR", "KBQX", "WTNR", "WJJH"],
 датиНаТурне: {
 Сиатъл: "20150625",
 Кливланд: "20150630"
 },
 ротация: "Heavy"
 }
 }
 );
Запрос таблицы
Возможно, наиболее существенная разница между SQL и NoSQL с точки зрения составления запросов заключается в использовании формулировок FROM и WHERE. SQL позволяет после выражения FROM выбирать несколько таблиц, а выражение с WHERE может быть любой сложности (включая операции JOIN между таблицами). Однако NoSQL имеет тенденцию накладывать жесткое ограничение на FROM, и работать только с одной указанной таблицей, а в WHERE, винаги трябва да се посочва основният ключ. Това се дължи на стремежа да се увеличи производителността на NoSQL, за който говорихме по-рано. Този стремеж води до всякакви ограничения на междутабличните и междучуждестранните взаимодействия. Той може да доведе до голямо забавяне в междузлодовата свързаност при отговор на запитвания и следователно е най-добре да се избягва принципно. Например, Cassandra изисква запросите да бъдат ограничени от определени оператори (разрешени са само =, IN, , =>, <=) на ключовете на разделите, с изключение на случаите на запитване на вторичен индекс (в този случай е разрешен само операторът =).
PostgreSQL
По-долу ще бъдат представени три примера на запитвания, които с лекота могат да бъдат изпълнени от SQL база данни.
- Изведете всичките песни на изпълнителя;
- Изведете всичките песни на изпълнителя, съвпадащи с първата част на заглавието;
- Изведете всичките песни на изпълнителя, които съдържат определена дума в заглавието и имат цена по-малка от 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
От изброените по-горе запитвания PostgreSQL само първото ще работи в Cassandra без промени, тъй като операторът LIKE не може да се прилага към колоните на кластеризация, като например SongTitle. В този случай са разрешени само оператори = и IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Както показват предишните примери, основният метод за създаване на запитвания в MongoDB е . Този метод явно съдържа името на колекцията (music в примера по-долу), така че запитване по няколко колекции е забранено.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Четене на всички редове от таблицата
Четенето на всички редове е просто специфичен случай на шаблона на запитване, който разгледахме по-рано.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Подобно на примера в PostgreSQL по-горе.
MongoDB
db.music.find( {} );Редактиране на данни в таблицата
PostgreSQL
PostgreSQL предоставя инструкция UPDATE за изменение на данни. Тя няма възможности UPSERT, така че изпълнението на тази инструкция ще завърши с грешка, в случай че редовете вече не съществуват в базата данни.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
В Cassandra има UPDATE аналогичен оператор на PostgreSQL. UPDATE има същата семантика UPSERT, подобно на INSERT.
Подобно на примера в PostgreSQL по-горе.
MongoDB
Операция В MongoDB може да се актуализира напълно съществуващ документ или да се актуализират само определени полета. По подразбиране актуализира само един документ без семантика. UPSERT. Актуализирането на няколко документа и поведението е аналогично. UPSERT може да се приложи, като се зададат допълнителни флагове за операцията. Както е показано в следния пример, се извършва актуализация на жанра на конкретен изпълнител по неговата песен.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Изтриване на данни от таблицата
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Подобно на примера в PostgreSQL по-горе.
MongoDB
В MongoDB има два типа операции за изтриване на документи — и . И двата типа изтриват документи, но връщат различни резултати.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Изтриване на таблица
PostgreSQL
DROP TABLE Music;Cassandra
Подобно на примера в PostgreSQL по-горе.
MongoDB
db.music.drop();Заключение
Споровете относно избора между SQL и NoSQL бушуват вече повече от 10 години. Има два основни аспекта на този спор: архитектурата на ядрото на базата данни (монолитен, транзакционен SQL срещу разпределен, нетранзакционен NoSQL) и подходът към проектирането на базата данни (моделиране на данни в SQL срещу моделиране на вашите заявки в NoSQL).
С разпределена транзакционна база данни, като YugaByte DB, дебатите относно архитектурата на базата данни могат лесно да бъдат развенчани. С нарастващите обеми данни, които надхвърлят капацитета, който може да бъде записан на един узел, изцяло разпределената архитектура, която поддържа линейна мащабируемост на записа с автоматично разделяне / ребалансировка, става необходима.
В допълнение, както е казано в една от статиите , транзакционните, строго съгласувани архитектури сега се прилагат по-широко за осигуряване на по-добра гъвкавост в разработването, отколкото нетранзакционните, в крайна сметка съгласувани архитектури.
Връщайки се към дискусията за проектиране на бази данни, е справедливо да се каже, че и двата подхода към проектиране (SQL и NoSQL) са необходими за всяко сложно реално приложение. SQL подходът на "моделиране на данни" дава възможност на разработчиците по-лесно да отговарят на променящите се бизнес изисквания, докато NoSQL подходът "моделиране на запитвания" позволява на същите разработчици да обработват големи обеми от данни с малка забавяне и висока пропускателна способност. Точно поради тази причина YugaByte DB предоставя SQL и NoSQL API в общото ядро, а не популяризира някой от подходите. Освен това, осигурявайки съвместимост с популярни езикове за бази данни, включително PostgreSQL и Cassandra, YugaByte DB гарантира, че разработчиците няма да трябва да учат нов език, за да работят с разпределеното строго съгласувано ядро на базата данни.
В тази статия разгледахме как основите на проектирането на бази данни се различават в PostgreSQL, Cassandra и MongoDB. В следващите статии ще се потопим в напреднали концепции за проектиране, като индекси, транзакции, JOIN'и, директиви TTL и JSON документи.
Желаем ви приятно прекарване на оставащите почивни дни и ви каним на , който ще се проведе на 14 май.
Източник: habr.com
