

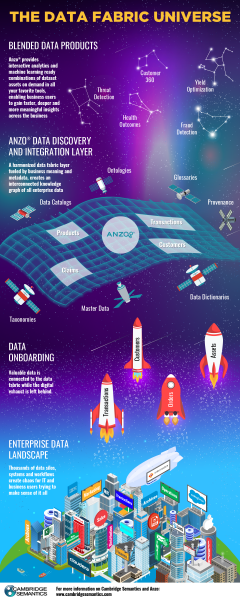
Семантичната мрежа и свързаните данни приличат на близкия космос: няма живот там. За да се отправите там за повече или по-малко дълъг период… ами, не знам какво ви казваха в детството в отговор на "искам да стана космонавт". Но може да наблюдавате какво се случва и оставайки на Земята; да станете астроном любител или дори професионалист е много по-лесно.
В статията ще говорим за новите, не по-стари от няколко месеца, тенденции от света на RDF хранилищата. Метафората в първия абзац беше вдъхновена от епичен рекламeн постер под кат.
Епичен постер
I. GraphQL за достъп до RDF
, че GraphQL претендира да стане универсален език за достъп до бази данни. Как стоят нещата с възможността за достъп чрез GraphQL до RDF?
„От кутията“ такава възможност предлагат:
- Stardog (, );
- продуктите на TopQuadrant (, ).
Ако хранилището не предлага такава възможност, тя може да бъде реализирана самостоятелно, написвайки съответния „разпознавател“ (resolver). Например, така постъпиха във френския проект . Или вече може да не се пише нищо, а просто да се вземе .
. От гледна точка на ортодоксалния привърженик на Семантичната мрежа и свързаните данни, всичко това, разбира се, е тъжно, тъй като изглежда предназначено за интеграции, изградени около нови data silo, а не за подходящи платформи (разбира се, RDF хранилища).
Впечатленията от сравнението между GraphQL и SPARQL остават двусмислени.
- От една страна, GraphQL изглежда като далечен роднина на SPARQL: в него са решени характерни за REST проблеми с повторенията и множеството запитвания — без което, вероятно, и не би могло да се счита за език за запитвания, дори и за web;
- От друга страна, разочарова строга схемност на GraphQL. Съответно, неговата "интроспективност" изглежда много ограничена в сравнение с пълната рефлексивност на RDF. И няма аналог на property paths, така че дори не е много ясно защо се нарича "Graph-".
II. Адаптери за MongoDB
Тенденция, допълваща предишната.
- в Stardog сега — по-специално, всичко на същия GraphQL — да настроите показването на данни от MongoDB в виртуални RDF графове;
- GraphDB от скоро включва в SPARQL фрагменти на MongoDB Query.
Ако говорим по-широко, за адаптери за JSON източници, които позволяват по-или-неща "на лето" да представят съхранявания в тези източници JSON като RDF, можем да споменем и доста отдавна съществуващия , който може да бъде приспособен, , към Apache Jena.
Резюмирайки първите два тренда, можем да кажем, че RDF хранилищата демонстрират пълна готовност за интеграции и функциониране в условия на „многообразно съхранение“ (polyglot persistence). Известно е обаче, че това по последно време не е на мода, а на смяна му мултимодалността. А как стоят нещата с мултимодалността в света на RDF хранилищата?
Накратко, никак. Темата за мултимодалните СУБД иска да посвети отделна статия, но за момента можем да забележим, че мултимодални СУБД, „основани“ на графовата модел (една от разновидностите е RDF), в момента не съществуват. За някаква малка мултимодалност — поддръжката на RDF хранилищата на алтернативен графов модел LPG — ще бъде разказано в .
III. OLTP срещу OLAP
Въпреки това, същият Gartner , че мултимодалността е условие sine qua non в първия ред за операционни СУБД. И това е разбираемо: в условията на „многообразно съхранение“ основните проблеми възникват с транзакционността.
Но къде на скалата OLTP—OLAP се намират RDF хранилищата? Отговорът ми би бил такъв: нито там, нито тук. За обозначаване на това, за което са предназначени, се нуждаем от някаква трета абревиатура. Като вариант бих предложил OLIP — Online Intellectual Processing.
Обаче все пак:
- реализираните в GraphDB механизми за интеграция с MongoDB не на последно място за заобикалянето на проблемите с производителността на записа;
- Stardog върви още по-далеч и напълно движка, отново с цел увеличаване на производителността на записа.
А сега позволете да представя нов играч на пазара. от създателите на IBM Netezza и Amazon Redshift — . Снимката от рекламата на продукта на базата на него беше публикувана в началото на статията. AnzoGraph се позиционира като GOLAP решение. Как ви изглежда SPARQL с прозоречни функции? —
SELECT ?month (COUNT(?event) OVER (PARTITION BY ?month) AS ?events) WHERE { … }IV. RocksDB
По-горе вече към анонса на Stardog 7 Beta, където се казваше, че Stardog планира да използва RocksDB като подлежащата система за съхранение — хранилище „ключ-стойност“, Facebook fork на Google LevelDB. Защо вече е редно да говорим за някаква тенденция?
На първо място, по всичко изглежда , че не само RDF хранилищата „пресаждат“ на RocksDB. Има проекти за използване на RocksDB като хранилищен двигател в ArangoDB, MongoDB, MySQL и MariaDB, Cassandra.
На второ място, в RocksDB се правят проекти (т.е. не продукти) от съответната тематика.
Например, eBay използва RocksDB в за своята „графична база от знания“. Между другото, забавно е да се чете: говорния език на запитванията започна като домашно направен формат, но напоследък преминава към много повече подобие на SPARQL. Както в анекдота: колкото и графове на знанието да правим, все пак се получава RDF.
Друг пример — появилия се преди няколко месеца . Преди неговото съществуване за историческите данни на Викиданни трябваше да се обръщаме чрез към стандартния Mediawiki API. Сега много неща са възможни на чист SPARQL. „Под капака“ там също е RocksDB. Между другото, WDHQS изглежда е направен от човек, занимавал се с импортирането на Freebase в Google Knowledge Graph.
V. Подкрепа за LPG
Напомням основната разлика между LPG-графовете и RDF-графовете.
В LPG на екземплярите на ребрата могат да се прикачват скаларни свойства, докато в RDF те могат да се прикачват само на „типовете“ ребра (обаче не само скаларни свойства, но и обикновени връзки). Това ограничение на RDF в сравнение с LPG чрез различни техники на моделиране. Ограничението на LPG в сравнение с RDF обаче е по-трудно за преодоляване, но LPG-графовете повече от RDF-графовете приличат на картинки от учебника на Харари, затова хората ги искат.
Очевидно, задачата за „подкрепа на LPG“ се разпада на две части:
- внасяне в модела RDF изменения, които дават възможност да се имитират LPG-конструкции;
- внасяне в езиците за запитвания към RDF изменения, които дават възможност да се достъпи до данните в този изменен модел — или реализация на възможността да се правят запитвания към този модел на популярни езици за запитвания към LPG.
V.1. Модел на данни
Тук има няколко възможни подхода.
V.1.1. Singleton Property
Най-буквалният подход за хармонизиране на RDF и LPG е вероятно :
- Вместо, например, предиката
:isMarriedToсе използват предикатите:isMarriedTo1,:isMarriedTo2и др. - След това тези предикати стават субекти на нови триплета:
:isMarriedTo1 :since "2013-09-13"^^xsd:dateи пр. - Връзката между тези екземпляри на предикатите с общия предикат се установява чрез триплети от вида
:isMarriedTo1 rdf:singletonPropertyOf :isMarriedTo. - Очевидно е, че
rdf:singletonPropertyOf rdfs:subPropertyOf rdf:type, но помислете защо не е разумно да напишете просто:isMarriedTo1 rdf:type :isMarriedTo.
Задачата за „подкрепа на LPG“ се решава тук на ниво RDFS. Такова решение изисква внасяне на съответните . Някои изменения може да са необходими от RDF хранилищата, които поддържат свързване на следствия, а засега Singleton Property може да се разглежда просто като още една техника за моделиране.
V.1.2. Рефикация направена правилно
По-малко наивните подходи произтичат от осъзнаването, че екземплярите на свойства могат да бъдат инстанцирани от троици. Има възможност да говорим нещо за троиците, ще получим възможност да говорим и за екземплярите на свойства.
Най-солидният от тези подходи е , известен и като RDR, дълбините на Blazegraph. От самото начало за себе си и AnzoGraph. Солидността на подхода се определя от факта, че в него съответните изменения в . Същността обаче е изключително проста. В Turtle сериализацията на RDF сега може да се пише приблизително така:
<> :since "2013-09-13"^^xsd:date .V.1.3. Други подходи
Може да не се задълбочавате в формалната семантика, а просто да считате, че троиците имат определени идентификатори, които естествено са URI, и да съставяте нови троици с тези URI. Остава само да предоставите достъп до тези URI в SPARQL. Така Stardog.
В Allegrograph по междинния път. Известно е, че идентификаторите на троиците в Allegrograph , но при реализация на triple attributes навън те не излизат. Въпреки това, до формалната семантика остава много. Забележително е, че атрибутите на троиците не са URI и стойностите на тези атрибути също могат да бъдат само литерали. Адептите на LPG получават точно това, което искат. В специално изобретения формат NQX пример, аналогичен на представения по-горе за RDF*, изглежда така:
:bob :marriedTo :alice {"since" : "2013-09-13"}V.2. Языци за запитвания
Подкрепяйки по един или друг начин LPG на ниво модел, е нужно да се предостави възможност за извършване на запитвания към данните в такъв модел.
- Blazegraph за запитвания към RDF* поддържа и . Запитването на SPARQL* изглежда така:
SELECT * { <> :since ?since }- AnzoGraph също поддържа и възнамерява да подкрепи , език за запитвания в Neo4j.
- Stardog поддържа собствено SPARQL и Gremlin. Получаването на URI на троица и "метаинформация" може да стане с помощта на приблизително такава конструкция:
SELECT * {
    BIND (stardog:identifier(:bob, :isMarriedTo, ?wife) AS ?id)
    ?id :since ?since
}- Allegrograph също поддържа собствено SPARQL:
SELECT * { ("since" ?since) franz:attributesNameValue ( :bob :marriedTo ?wife ) }Но, GraphDB известно време поддържаше Tinkerpop/Gremlin, без да поддържа LPG, но в версия 8.0 или 8.1 това спря.
VI. Обостряне на лицензии
В последно време не са настъпили никакви увеличения в пресечението на множествата „triplestore of choice“ и „open source triplestore“. Новите RDF хранилища с отворен код далеч не са добър избор за ежедневна употреба, а изходният код на новите RDF хранилища, които биха искали да се използват (като AnzoGraph), е затворен. По-скоро можем да говорим дори за намаления...
Разбира се, преди отвореният код не се затваря, но някои хранилища с отворен код постепенно престават да се разглеждат като достоен избор. Virtuoso, който има opensource редакция, на мен ми се струва, че потъва в бъгове. Blazegraph беше купен от AWS и легна в основата на Amazon Neptune; сега не е ясно дали ще има още един релиз. Остава само Jena...
Ако обаче отвореният код не е много важен и просто искате да опитате, положението също не е толкова радостно, колкото преди. Например:
- Stardog разпространява безплатна версия (въпреки че пробният период на обикновената версия е удвоен);
- в , където преди можеше да се избере безплатен базов план, регистрацията на нови потребители е спряна.
Общо взето, за обикновения ИТ потребител космосът става все по-достъпен, а овладяването му става привилегия на корпорациите.
Източник: habr.com
