

На първо място, когато започвате работа с нов набор от данни, трябва да го разберете. За да направите това, например, трябва да откриете обхвата на стойностите, приемани от променливите, техните типове, а също така да разберете броя на пропуснатите стойности.
Библиотеката pandas предлага множество полезни инструменти за извършване на разведочен анализ на данни (Exploratory Data Analysis, EDA). Но преди да се възползвате от тях, обикновено е необходимо да започнете с функции от по-общ характер, като df.describe(). Вярно е, че възможностите, предоставяни от подобни функции, са ограничени, а началните стъпки със всеки набор от данни при провеждане на EDA често са много подобни помежду си.
Авторът на материала, който публикуваме днес, казва, че не обича да извършва повторяеми действия. В резултат на това, в търсене на средства за бързо и ефективно провеждане на разведочен анализ на данни, той е открил библиотеката . Резултатите от нейната работа не са представени под формата на отделни показатели, а под формата на доста подробен HTML отчет, съдържащ голяма част от информацията за анализираните данни, която може да бъде полезна преди да започнете по-задълбочена работа с тях.
Тук ще разгледаме особеностите на използването на библиотеката pandas-profiling на примера на набора от данни Titanic.
Разведочен анализ на данни с помощта на pandas
Реших да експериментирам с pandas-profiling на набора от данни Titanic, защото в него има данни от различни типове и наличие на пропуснати стойности. Считам, че библиотеката pandas-profiling е особено интересна в случаите, когато данните все още не са почистени и изискват допълнителна обработка, която зависи от техните особености. За да извършите успешна обработка следва да знаете от къде да започнете и на какво да обърнете внимание. Тук ще ни помогнат възможностите на pandas-profiling.
Първо, ще импортираме данните и ще използваме pandas, за да получим показатели за описателната статистика:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
След изпълнението на този фрагмент от код ще получите това, което е показано на следващата илюстрация.
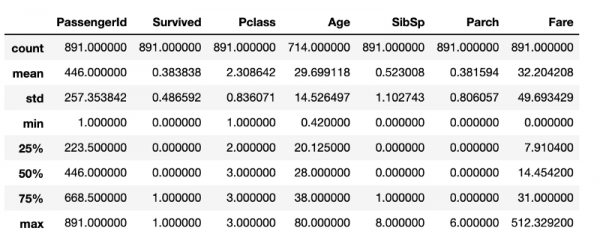
Показателите за описателната статистика, получени с помощта на стандартните средства на pandas
Въпреки че тук има много полезна информация, не всичко, което би било интересно да се знае за проучваните данни, е налично. Например, можем да предположим, че в данните, в структурата на DataFrame, има 891 реда. Ако е необходимо да се провери това, ще е необходима още една ред код, която да определи размера на DataFrame. Въпреки че тези изчисления не са особено ресурсозатратни, постоянното им повторение задължително ще доведе до загуба на време, което вероятно е по-добре да се изразходва за почистване на данните.
Разведочен анализ на данните с помощта на pandas-profiling
Сега ще направим същото, използвайки pandas-profiling:
pandas_profiling.ProfileReport(df)Изпълнението на представения по-горе ред код ще генерира отчет с показатели за разведочен анализ на данните. Кодът, показан по-горе, ще изведе откритата информация за данните, но може да се направи така, че резултатът да е HTML файл, който, например, може да се покаже на някого.
Първата част на отчета ще съдържа раздел Overview (Обзор), даващ основна информация за данните (броя на наблюденията, броя на променливите и т.н.). Освен това той ще съдържа списък с предупреждения, уведомявайки аналитика за това, на какво трябва да се обърне особено внимание. Тези предупреждения могат да служат за индикация за концентрация на усилията при почистване на данните.
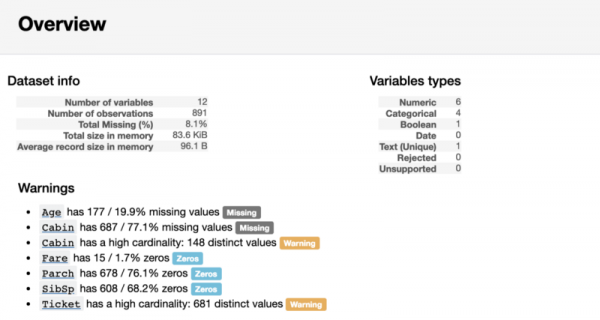
Разделът Overview на отчета
Разведочен анализ на променливите
След раздела Overview в отчета може да се намери полезна информация за всяка променлива. В тях, освен друго, са включени малки диаграми, описващи разпределението на всяка променлива.
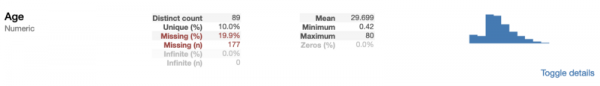
Информация за числовата променлива Age
Както може да се види от предишния пример, pandas-profiling ни предоставя няколко полезни индикатора, като процент и брой на пропуснатите стойности, а също така статистически показатели, които вече видяхме. Тъй като Age е числова променлива, визуализацията на нейното разпределение под формата на хистограма ни позволява да направим извода, че имаме разпределение наклонено вдясно.
Когато разглеждаме категориалната променлива, изведените показатели малко се различават от тези, които бяха намерени за числовата променлива.
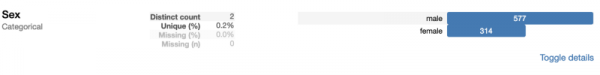
Информация за категориалната променлива Sex
А именно, вместо нахождението на средното, минимума и максимума, библиотеката pandas-profiling открива броя на класовете. Тъй като Пол — бинарна променливa, нейните стойности са представени от два класа.
Ако, както и аз, обичате да изследвате кода, може да ви заинтересува как точно библиотеката pandas-profiling изчислява тези показатели. Да разберете това, имайки предвид, че кодът на библиотеката е отворен и достъпен на GitHub, не е толкова сложно. Тъй като не съм особено любител на използването на 'черни кутии' в проектите си, погледнах изходния код на библиотеката. Например, ето как изглежда механизмът за обработка на числови променливи, представен от функцията :
def describe_numeric_1d(series, **kwargs):
    """Изчислява обобщаваща статистика на числова (`TYPE_NUM`) променлива (Series).
    Също така създава хистограми (мини и пълни) на нейното разпределение.
    Параметри
    ----------
    series : Series
        Променливата, която да се опише.
    Връща
    -------
    Series
        Описание на променливата като Series с индекс ключове на статистиките.
    """
    # Форматира число като процент. Например 0.25 ще се превърне в 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # За да избегнем многократното му изчисляване
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # Dropna() е решение за https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Хистограми
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Въпреки че този фрагмент код може да изглежда доста голям и сложен, всъщност е много лесно да го разберете. Става въпрос за това, че в изходния код на библиотеката има функция, която определя типовете променливи. Ако библиотеката е срещнала числова променлива, споменатата функция ще намери показателите, които обсъждахме. В тази функция се използват стандартните операции на pandas за работа с обекти от тип Series, подобно на series.mean(). Резултатите от изчисленията се запазват в речника stats. Хистограмите се генерират с помощта на адаптирана версия на функцията matplotlib.pyplot.hist. Адаптация е насочена да позволява на функцията да работи с различни видове набори от данни.
Показатели на корелацията и вземаният за изследване проба от данни
След резултатите от анализа на променливите в pandas-profiling, в раздела Корелации ще бъдат изведени корелационните матрици на Пиърсън и Спирмен.
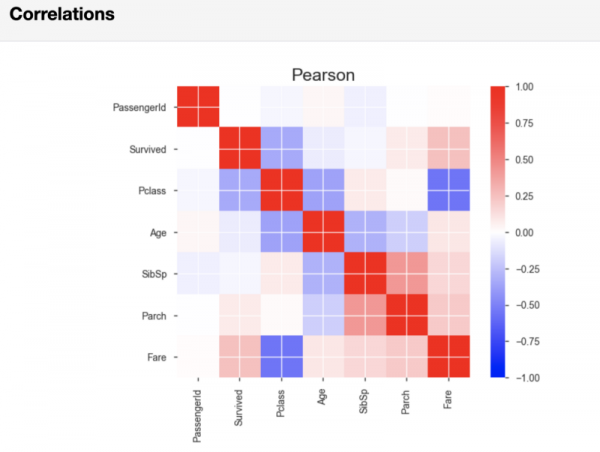
Корелационна матрица на Пиърсън
Ако е необходимо, можете в реда на кода, който стартира генерирането на отчета, да зададете показатели на праговите стойности, приложими при изчислението на корелацията. Правейки това, можете да зададете каква сила на корелацията се счита за важна за вашия анализ.
Накрая, в отчета на pandas-profiling, в раздела Проба, се извежда, като пример, фрагмент от данните, взет от началото на набора от данни. Този подход може да доведе до неприятни изненади, тъй като първите няколко наблюдения могат да представляват проба, която не отразява характеристиките на целия набор от данни.
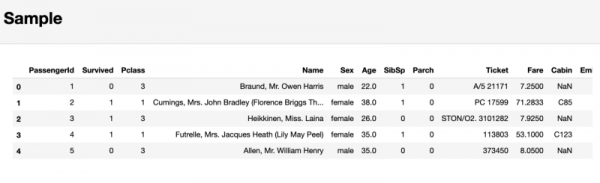
Раздел, съдържащ проба от изследваните данни
В резултат не препоръчвам да се обръща внимание на този последен раздел. Вместо това е по-добре да използвате командата df.sample(5), която произволно избира 5 наблюдения от набора от данни.
Итог
В обобщение, библиотеката pandas-profiling предоставя на аналитиците някои полезни възможности, които са от полза, когато е необходимо бързо да се получи общо приблизително представление за данните или да се предадат данни за отчет на проучвателен анализ на данните. В същото време действителната работа с данните, отразявайки техните особености, се извършва, както и без използване на pandas-profiling, ръчно.
Ако искате да видите как изглежда целият проучвателен анализ на данните в един Jupyter бележник — погледнете на моя проект, създаден с помощта на nbviewer. А в GitHub репозитория можете да намерите съответния код.
Уважаеми читатели! С какво започвате анализата на нови набори от данни?
Източник: habr.com
