

Здравейте на всички! Казвам се Павел Агалецки. Работя като ръководител на екип, който разработва системата за доставки на Lamoda. През 2018 година изнесох лекция на конференцията HighLoad++, а днес искам да представя разшифровката на моя доклад.
Темата ми е посветена на опита на нашата компания в разгръщането на системи и услуги в различни среди. Започвайки от нашите праисторически времена, когато разгръщахме всички системи на обикновени виртуални сървъри, до постепенния преход от Nomad към разгръщане в Kubernetes. Ще разкажа за причините, поради които го направихме, и какви проблеми срещнахме в процеса.

Разгръщане на приложения на VM
Нека започнем от факта, че преди 3 години всички системи и услуги на компанията бяха разгръщани на обикновени виртуални сървъри. Технически това беше организирано така, че целият код на нашите системи се събираше с помощта на автоматизирано изграждане, чрез Jenkins. С помощта на Ansible той се разгръщаше от нашата система за контрол на версиите на виртуалните сървъри. Всяка система в компанията беше разгръщана на поне 2 сървъра: единият - на head, а другият - на tail. Тези две системи бяха абсолютно идентични по всичките си настройки, мощности, конфигурации и т.н. Разликата помежду им беше единствено, че head получаваше потребителския трафик, а tail никога не получаваше трафик от потребители.
Защо беше направено това?
Когато разгръщахме нови версии на нашето приложение, искахме да осигурим възможност за безшевно разгръщане, т.е. без да има забележими последици за потребителите. Това се постига чрез разгръщането на новосъздадената версия с помощта на Ansible на tail. Там хората, занимаващи се с разгръщането, можеха да проверят и да се уверят, че всичко е наред: всички метрики, раздели и приложения работят; нужните скриптове се изпълняват. Само след като се уверят, че всичко е ок, трафикът се пренасочва. Той започва да потича към сървъра, който преди това беше tail. А този, който преди това беше head, оставаше без потребителски трафик, но с предходната версия на нашето приложение.
По този начин за потребителите всичко беше безпроблемно. Защото преминаването е мигновено, тъй като просто се променя балансировщикът. Много е лесно да се върнете към предишната версия, като просто превключите балансировщикът назад. Освен това можехме да се уверим в способността на приложението в продукция още преди да започне потребителският трафик, което беше доста удобно.
Какви предимства видяхме в това всичко?
- На първо място, то е достатъчно просто работи. На всички е ясно как функционира подобна схема на деплой, защото повечето хора някога са деплоили на обикновени виртуални сървъри.
- То е достатъчно надеждно, тъй като технологията на деплоя е проста, тествана от хиляди компании. Миллиони сървъри се деплоят точно така. Трудно е да се счупи нещо.
- И накрая, можехме да получим атомарни деплои. Деплоите, които за потребителите стават мигновено, без забележим етап на превключване между старата и новата версия.
Но в това всичко видяхме и някои недостатъци:
- Освен продукционната среда и средата за разработка, има и други среди. Например, QA и предпродукционна. По това време имахме много сървъри и около 60 услуги. Поради тази причина трябваше да поддържаме актуална версия на виртуалната машина за всяка услуга. И ако искате да обновите библиотеките или да добавите нови зависимости, трябва да го направите във всички среди. Освен това трябваше да синхронизирате времето, когато ще деплоите новата версия на вашето приложение, с времето, когато devops ще направи нужните настройки на околната среда. В такъв случай лесно можете да попаднете в ситуация, когато околната среда ще се различава малко във всички среди наред. Например, в QA средата ще има една версия на библиотеките, а в продукция — друга, което ще доведе до проблеми.
- Сложността при обновяването на зависимостите на вашето приложение. Това зависи не от вас, а от друг екип. А именно, от екипа на devops, който поддържа сървърите. Трябва да поставите за тях съответната задача и да дадете описание на това, което искате да направите.
- В този период също искахме да разделим големите монолити, които имахме, на малки услуги, тъй като осъзнавахме, че ще стават все повече и повече. Тогава вече имахме над 100 такива. Необходимо беше за всяка нова услуга да създадем отделна виртуална машина, която също трябваше да се поддържа и деплойва. Освен това, необходима е не една, а поне две машини. Към всичко това се добавя и QA среда. Това създава проблеми и прави създаването и стартирането на нови системи по сложен, скъп и дълъг процес.
Затова взехме решение, че ще бъде по-удобно да преминем от депой на обикновени виртуални машини към депой на нашите приложения в контейнери docker. С наличието на docker е нужна система, която може да стартира приложението в клъстер, тъй като не можете просто така да стартирате контейнер. Обикновено искате да следите колко контейнера са активни, за да се стартират автоматично. Поради тази причина трябваше да изберем система за управление.
Дълго се замисляхме коя от тях можем да използваме. Факт е, че по това време стекът за деплой на обикновени виртуални сървъри беше вече остарял, тъй като имаше не най-новите версии на операционните системи. В някакъв момент дори имаше FreeBSD, която беше не много удобна за поддръжка. Осъзнавахме, че трябва да мигрираме в docker възможно най-скоро. Нашите девопс погледнаха на опита си с различни решения и избраха система като Nomad.
Преминаване към Nomad
Nomad е продукт на компанията “HashiCorp”. Те са известни и с други свои решения:
«Consul» — средство за откриване на услуги.
«Terraform» — система за управление на сървъри, позволяваща ви да ги конфигурирате чрез т. нар. infrastructure-as-a-code.
«Vagrant» позволява да разгръщате виртуални машини локално или в облака чрез определени конфигурационни файлове.
По това време Nomad изглеждаше като достатъчно простично решение, на което можем бързо да преминем без да променяме цялата инфраструктура. Освен това, е доста лесен за усвояване. Затова именно него избрахме за система за управление на нашия контейнер.
Какво е необходимо, за да деплойнете изобщо вашата система в Nomad?
- Първо и най-важно е необходим docker image вашето приложение. Необходимо е да го съберете и да го поставите в хранилището на образи docker. В нашия случай това е artifactory — система, която позволява да се пуска в нея различни артефакти от различен тип. Тя може да съхранява архиви, docker образи, php composer пакети, npm пакети и други.
- Също е необходимо конфигурационен файл, който ще каже на Nomad какво, къде и в какво количество искате да деплоите.
Когато говорим за Nomad, той използва HCL езика като формат за информационен файл, който се разшифрова като HashiCorp Configuration Language. Това е надмножество на Yaml, което ви позволява да опишете услугата си в термини на Nomad.
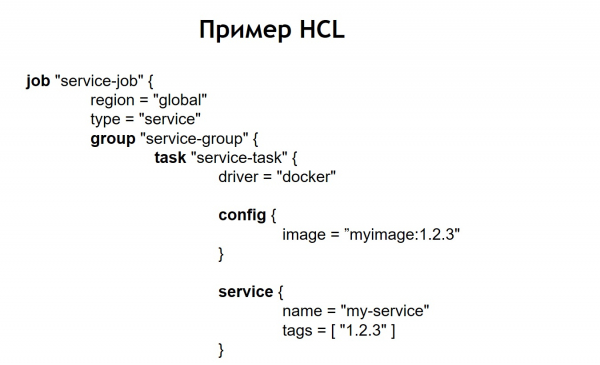
Той позволява да кажете колко контейнери искате да деплоите, от кои images да им предадете различни параметри при деплоя. По този начин, подавате този файл на Nomad, а той стартира контейнерите по този начин в продукция.
В нашия случай разбрахме, че просто да пишем абсолютно идентични HCL файлове за всяка услуга би било неудобно, тъй като услугите са много и понякога искаме да ги обновим. Понякога е така, че една услуга не е деплоинирана в един екземпляр, а в много различни. Например, една от системите, които имаме в продукция, има над 100 инстанции в продакшн. Те се стартират от едни и същи образи, но се различават по конфигурационните настройки и конфигурационните файлове.
Затова решихме, че ще бъде удобно да съхраняваме всички наши конфигурационни файлове за деплой в един общ репозиторий. По този начин те стават обозрими: лесно е да се поддържат и може да се види какви системи имаме. При необходимост също не е сложно да се обнови или промени нещо. Добавянето на нова система също не би било трудно — просто трябва да създадете конфигурационен файл в нова директория. Вътре в нея се намират файловете: service.hcl, който съдържа описанието на нашата услуга, и някои env-файлове, които позволяват на услугата, след като е деплоена в продукция, да бъде настроена.
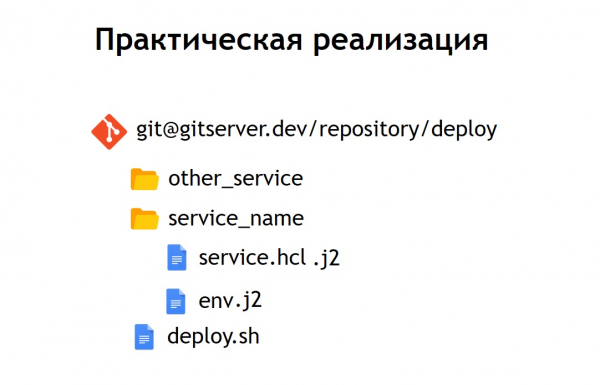
Обаче някои от нашите системи не са деплоинирани в продукция само в един екземпляр, а в няколко едновременно. Затова решихме, че ще бъде удобно да съхраняваме не конфигурациите в чист вид, а в техния шаблонизиран вид. И като език за шаблонизиране избрахме jinja 2. В този формат съхраняваме както конфигурациите на самата услуга, така и env-файловете, необходими за нея.
Освен това, поставихме в репозитория общ скрипт за деплой, който позволява да стартирате и да деплойвате вашата услуга в продукционна среда, в необходимата среда, в целевия таргет. В случай, че преобразувахме нашия HCL конфиг в шаблон, този HCL файл, който преди беше обикновен конфиг на Nomad, в този случай ще изглежда малко по-различно.
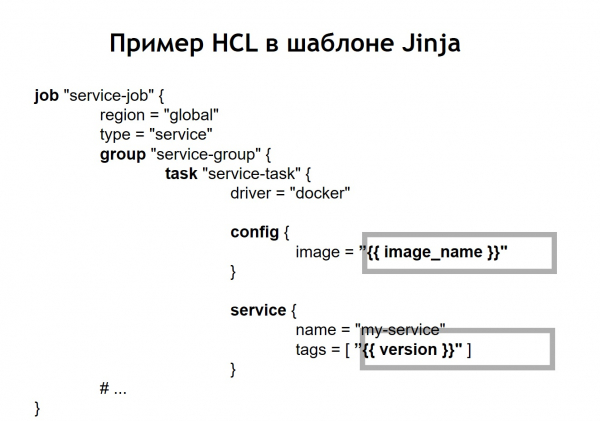
Тоест, заменихме някои променливи места в конфига с вложени променливи, които се взимат от env-файловете или от други източници. Освен това, получихме възможността да генерираме HCL файлове динамично, т.е. можем да прилагаме не само обикновени вложени променливи. Тъй като jinja поддържа цикли и условия, там могат да се създават конфигурационни файлове, които се променят в зависимост от това къде точно деплойвате вашите приложения.
Например, искате да деплойвате вашата услуга в предпроизводствена и производствена среда. Да предположим, че в предпроизводствената среда не искате да стартирате cron-скриптове, а просто искате да видите услугата на отделен домейн, за да се уверите, че функционира. За всеки, който деплойва услуга, процесът изглежда много прост и прозрачен. Достатъчно е да изпълните файла deploy.sh, да посочите коя услуга искате да деплойвате и в кой таргет. Например, искате да деплойвате някаква система в Русия, Беларус или Казахстан. За целта е достатъчно просто да смените един от параметрите и коректният конфигурационен файл ще бъде генериран.
Когато услугата Nomad вече е деплойвана в кластера, тя изглежда по следния начин.
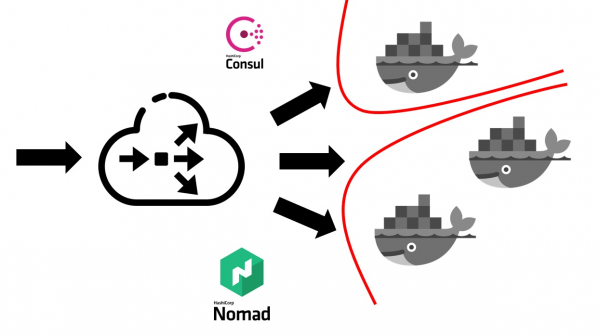
Първо, необходим ви е балансировчик навън, който ще приема целия потребителски трафик. Той ще работи заедно с Consul и ще узнава от него къде, на кой нод, по какъв IP адрес находится конкретния сервис, който съответства на определено доменно име. Услугите в Consul се появяват от самия Nomad. Тъй като това са продукти на едната и съща компания, те са добре свързани помежду си. Може да се каже, че Nomad от кутията умее да регистрира всички стартирани в него услуги в Consul.
След като вашият външен балансировач научи към коя услуга трябва да насочва трафика, той го пренасочва към съответния контейнер или към няколко контейнера, които са свързани с вашето приложение. Разбира се, че в този процес е необходимо да се помисли и за безопасността. Дори и да работят всички услуги на одни и същи виртуални машини в контейнерите, обикновено е необходимо да се забрани свободен достъп от всяка услуга до всяка друга. Ние постигнахме това чрез сегментиране. Всяка услуга работеше в своя собствена виртуална мрежа, на която бяха зададени правила за маршрутизиране и правила за разрешаване/забраняване на достъпа до други системи и услуги. Те можеха да се намират както вътре в този кластер, така и извън него. Например, ако искате да забраните на услуга да се свързва с определена база данни, това може да се направи чрез сегментиране на нивото на мрежата. Тоест дори по грешка не можете случайно да се свържете от тестова среда с вашата производствена база.
Колко човешки ресурси вложихме в процеса на прехода?
Процесът на преминаване на цялата компания в Nomad отне около 5-6 месеца. Преминавахме по услуги, но с достатъчно бързи темпове. Всяка екип трябваше да създаде своите собствени контейнери за услугите.
При нас се приема подход, при който всеки екип самостоятелно отговаря за docker images на своите системи. Девопс екипите осигуряват общата инфраструктура, необходима за деплой, т.е. поддръжка на самия кластер, поддръжка на CI системата и така нататък. И към онзи момент над 60 системи бяха преместени в Nomad, което доведе до около 2000 контейнера.
Девопс екипите отговарят за общата инфраструктура на всичко, свързано с деплой, със сървърите. А всеки екип за разработка от своя страна отговаря за реализирането на контейнерите за конкретната си система, тъй като именно екипът знае какво точно му е необходимо в съответния контейнер.
Причини за отказ от Nomad
Какви предимства получихме, преминавайки към деплой с помощта на Nomad и docker включително?
- Ние осигурихме еднакви условия за всички среди. В разработката, QA среда, предпроизводството и производството се използват едни и същи образи на контейнери с еднакви зависимости. Следователно почти няма шанс, че в производството ще се окаже нещо различно от това, което преди това сте тествали локално или в тестова среда.
- Също така установихме, че е достатъчно лесно да добавите нов сервис. Всякакви нови системи от гледна точка на внедряването се стартират много лесно. Достатъчно е да отидете в хранилището, съдържащо конфигурации, да добавите там поредната конфигурация за вашата система и всичко е готово. Можете да внедрите вашата система в производството без допълнителни усилия от DevOps.
- Всички конфигурационни файлове в едно общо хранилище оказаха се прегледни. В момента, в който внедрявахме нашите системи с помощта на виртуални сървъри, използвахме Ansible, в което конфигурациите се съхраняваха в едно и също хранилище. Въпреки това, за повечето разработчици работата с това беше малко по-трудна. Обемът на конфигурациите и кода, който трябва да добавите, за да внедрите услугата, стана много по-малък. Плюс това за DevOps е много лесно да я коригира или промени. В случай на промяна, например, на новата версия на Nomad, те могат просто да обновят масово всички оперативни файлове, които са в едно и също място.
Но се сблъскахме и с някои недостатъци:
Оказа се, че не успяхме да постигнем безшевност при внедряването в случая с Nomad. При разгръщането на контейнери от различни условия, може да се случи, че контейнерът е стартиран, и Nomad го възприема като готов за прием на трафик контейнер. Това се случваше още преди приложението вътре да успее да се стартира. Поради тази причина системата за кратък период започваше да издава 500-ти грешки, защото трафикът започваше да влиза в контейнер, който още не беше готов да го приеме.
Сталкнахме се с някои бъгове. Най-съществената грешка е, че Nomad не се справя добре с големи клъстери, когато имате много системи и контейнери. Когато желаете да изведете в поддръжка един от сървърите, който е част от клъстера на Nomad, има доста голяма вероятност клъстерът да не се чувства добре и да се разпадне на части. Част от контейнерите може, например, да се сринат и да не се възстановят — това ще ви струва скъпо, ако всички ваши системи в продукция са в клъстера, управляван от Nomad.
Затова решихме да помислим накъде да продължим. Вече осъзнавахме много по-добре какво искаме да постигнем. А именно: търсим надеждност, малко повече функции, отколкото предлага Nomad, и по-зряла, по-стабилна система.
В това отношение нашият избор падна на Kubernetes като най-популярната платформа за стартиране на клъстери. Особено с оглед на факта, че размерът и броят на нашите контейнери бяха доста големи. За такива цели Kubernetes изглеждаше най-подходящата система, на която можехме да се спрем.
Преход към Kubernetes
Ще ви разкажа малко за основните понятия в Kubernetes и с какво се различават от Nomad.
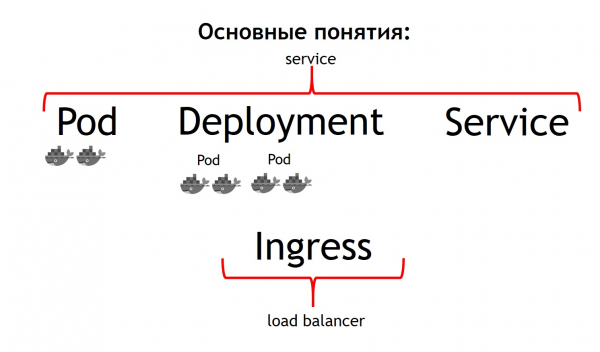
На първо място, най-базовото понятие в Kubernetes е понятието pod. Под — това е група от един или повече контейнера, които винаги се стартират заедно. Те работят така, сякаш винаги са строго на една виртуална машина. Достъпни са помежду си по IP адрес 127.0.0.1 на различни портове.
Да предположим, че имате PHP приложение, което се състои от nginx и php-fpm – класическа схема. Най-вероятно ще пожелаете и nginx, и php-fpm контейнерите винаги да бъдат заедно. Kubernetes позволява това, описвайки ги като един общ pod. Именно това не можехме да постигнем чрез Nomad.
Второто понятие е deployment. Подобно на pod, самият той е ефимерен – стартира се и изчезва. Искате ли първо да убивате всички ваши предишни контейнери, а после да стартирате нови версии, или искате да ги разгръщате постепенно – именно за този процес отговаря понятието deployment. То описва как разгръщате вашите pod-ове, в какво количество и как да ги обновявате.
Третото понятие е service. Вашият service всъщност е вашата система, която приема определен трафик и после го насочва към един или няколко pod-а, съответстващи на вашия сервис. Тоест, позволява да кажем, че целият входящ трафик към такъв сервис с такова име трябва да бъде изпращан на конкретно тези pod-ове. И същевременно осигурява балансировка на трафика. Тоест, можете да стартирате два pod-а на вашето приложение и целият входящ трафик ще бъде равномерно разпределен между свързаните с този сервис pod-ове.
И четвъртото основно понятие — Ingress. Това е сервис, който се стартира в кластера Kubernetes. Той действа като външен балансировчик на натоварването, който поема всички заявки. Чрез API Kubernetes Ingress може да определя къде да бъдат изпратени тези заявки. И го прави много гъвкаво. Можете да кажете, че всички заявки към този хост и такъв URL ги изпращаме към този сервис. А тези заявки, идващи към този хост и на друг URL, изпращаме на друг сервис.
Най-готиното от гледна точка на разработчика на приложения е, че можете да управлявате всичко това самостоятелно. Задавайки конфигурация на Ingress, можете да изпращате целия трафик, който идва към такъв API, на отделни контейнери, написани, например, на Go. А този трафик, който идва на същия домейн, но на друг URL, да изпращате на контейнери, написани на PHP, където има много логика, но не са особено бързи.
Ако сравните всички тези понятия с Nomad, може да се каже, че първите три понятия — всичко това заедно е Service. А последното понятие в Nomad липсва. Ние в негово име използвахме външен балансировчик: това може да бъде haproxy, nginx, nginx+ и така нататък. В случая с куба не е нужно да въвеждате това допълнително понятие отделно. Въпреки това, ако погледнем Ingress отвътре, то това е или nginx, или haproxy, или traefik, но вградено в Kubernetes.
Всички описани от мен понятия — това, по същество, са ресурси, които съществуват в рамките на кластера Kubernetes. За тяхното описание в куба се използва yaml-формат, който е по-четим и познат, отколкото HCL файловете в случая с Nomad. Но структурно описват в случая, например, pod едно и също. Те казват — искам да деплоирам такива pod-ове там, с такива имиджи, в такова количество.
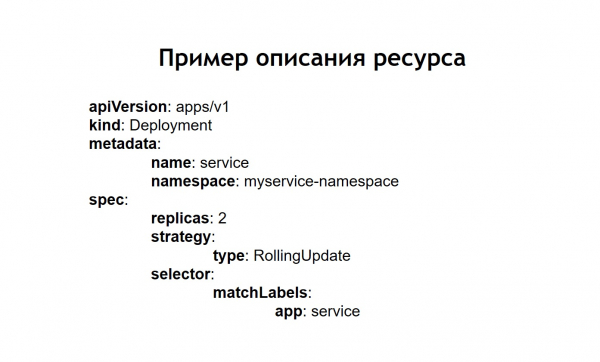
Освен това разбрахме, че не искаме да създаваме всеки отделен ресурс на ръка: deployment, услуги, Ingress и други. Вместо това искахме при деплой да описваме всяка наша система в термини на Kubernetes, за да не се налага ръчно да пресъздаваме всичките необходими зависимости на ресурсите в правилния ред. Използвахме Helm като система, която ни позволи да направим това.
Основни понятия в Helm
Helm е мениджър на пакети за Kubernetes. Той е много подобен на начина, по който работят пакетните мениджъри в езиците за програмиране. Те ви позволяват да съхранявате услуга, която се състои например от deployment на nginx, deployment на php-fpm, конфигурация за Ingress, configmaps (това е същество, което ви позволява да зададете env и други параметри за вашата система) под формата на така наречените чартове. В същото време Helm работи над Kubernetes. Тоест, това не е система, която стои настрани, а просто още една услуга, стартирана в куба. Взаимодействате с него чрез неговото API чрез команден ред. Удобството и красотата му е, че дори ако Helm се повреди или го изтриете от клъстера, вашите услуги няма да изчезнат, тъй като Helm всъщност служи само за стартиране на системата. За работоспособността и състоянието на услугите по-късно отговаря самият Kubernetes.
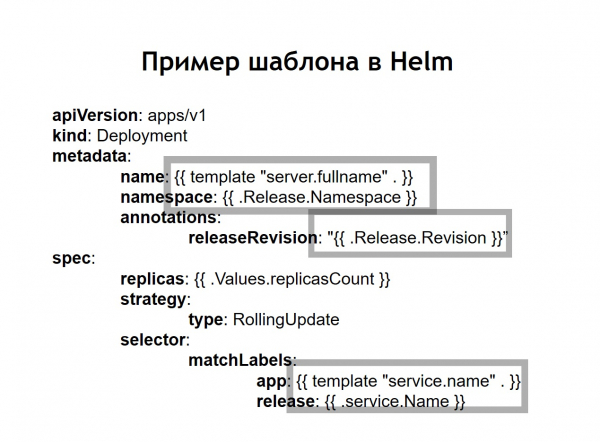
Също така разбрахме, че шаблонизацията, която преди това сме били принудени да правим сами чрез внедряване на jinja в нашите конфигурации, е една от основните възможности на Helm. Всички конфигурации, които създавате за вашите системи, се съхраняват в Helm под формата на шаблони, които малко наподобяват jinja, но всъщност използват шаблонизацията на езика Go, на който е написан Helm, както и Kubernetes.
Helm ни добавя още няколко допълнителни понятия.
Chart — това е описание на вашата услуга. В други пакетни мениджъри биха го нарекли пакет, bundle или нещо подобно. Тук това се нарича chart.
Values – това са променливите, които искате да използвате за изграждане на конфигурациите си от шаблоните.
ReleaseВсеки път, когато услугата, разгръщана с помощта на helm, получава инкрементална версия на релиза. Helm помни каква е била конфигурацията на услугата при предишните релизи. Затова, ако трябва да откатите, е достатъчно да изпълните командата helm callback, посочвайки му предишната версия на релиза. Дори и когато по време на отката съответната конфигурация във вашето хранилище не е налична, helm все пак помни каква е била и ще върне вашата система в състоянието, в което е била при предишния релиз.
В случай, че използваме helm, обичайните конфигурации за Kubernetes също се превръщат в шаблони, в които имате възможност да използвате променливи, функции и да прилагате условни оператори. Така можете да събирате конфигурацията на вашата услуга в зависимост от окружението.
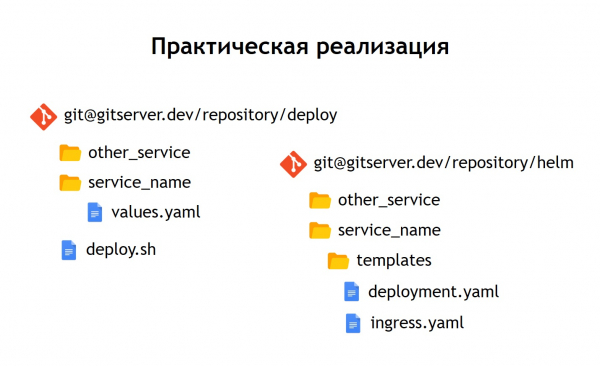
На практика решихме да постъпим малко по-различно, отколкото сме правили в случая с Nomad. Докато в Nomad в едно хранилище се съхраняваха и конфигурациите за разгръщане, и n-променливите, които са нужни за разгръщането на нашата услуга, тук решихме да ги разделим на две отделни хранилища. В хранилището „deploy“ се съхраняват само n-променливите, нужни за разгръщането, а в хранилището „helm“ се съхраняват конфигурации или чарти.
Каква полза ни донесе това?
Въпреки че в самите конфигурационни файлове не съхраняваме наистина чувствителни данни, например пароли за бази данни, които се съхраняват във вид на secrets в Kubernetes, все пак има отделни неща, до които не искаме да даваме достъп на всеки. Затова достъпът до хранилището „deploy“ е по-ограничен, а хранилището „helm“ просто съдържа описание на услугата. Поради тази причина можем безопасно да предоставим достъп на по-широк кръг лица.
Тъй като имаме не само продукционна среда, но и други, благодарение на това разделение можем да преизползваме нашите helm-чарти, за да разгръщаме услуги не само в продукцията, но и, например, в QA-средата. Дори за локално разгръщане, използвайки Minikube — това е инструмент за локално стартиране на Kubernetes.
Вътре в всяко хранилище сме оставили разделение на отделни директории за всеки сервис. Тоест, вътре в всяка директория се намират шаблони, свързани с конкретния чарт и описващи ресурсите, които трябва да бъдат деплойвани за стартиране на нашата система. В хранилището „deploy“ сме оставили само envs. В този случай не използвахме шаблонизиране с помощта на jinja, тъй като helm сам предоставя шаблонизиране от кутията – това е една от основните му функции.
Оставихме скрипт за деплой – deploy.sh, който опростява и стандартизира старта за деплой с помощта на helm. По този начин, за всеки, който иска да деплойва, интерфейсът за деплой изглежда точно така, както беше в случая на деплоя чрез Nomad. Същият deploy.sh, името на вашия сервис и къде искате да го деплойвате. Това води до стартиране на helm. Той от своя страна събира конфигурации от шаблоните, заменя необходимите values-файлове и след това деплойва, пускайки ги в Kubernetes.
Изводи
Сервисът Kubernetes изглежда по-сложен от Nomad.
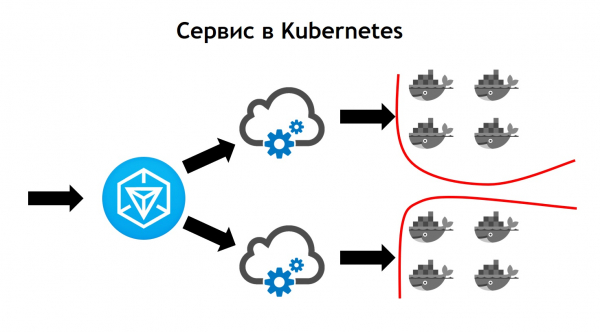
Тук изходящият трафик идва в Ingress. Това е фронт-контролерът, който получава всички заявки и след това ги изпраща на съответните услуги според данните от заявката. Той ги определя на базата на конфигурациите, които са част от описанието на вашето приложение в helm и които разработчиците задават сами. Сервисът изпраща заявки към своите pod, т.е. конкретните контейнери, балансирайки входящия трафик между всички контейнери, свързани с този сервис. И, разбира се, не трябва да забравяме, че в мрежовата сигурност не трябва да се отдалечаваме. Затова в клъстера Kubernetes работи сегментация, основана на етикетиране. Всички услуги имат определени етикети, към които са свързани правата на достъп на услугите до определени външни/вътрешни ресурси в или извън клъстера.
При преминаване установихме, че Kubernetes притежава всички възможности на Nomad, който преди това използвахме, а също така добавя много нови функции. Може да бъде разширяван чрез плугини, а всъщност чрез кастомни типове ресурси. Тоест имате възможността не просто да използвате нещо, което идва с Kubernetes по подразбиране, а да създадете свой собствен ресурс и услуга, която ще чете вашия ресурс. Това предоставя допълнителни възможности за разширяване на системата ви без необходимост от преинсталация на Kubernetes и без нужда от промени.
Пример за такова приложение е Prometheus, който работи при нас вътре в кластера Kubernetes. За да започне да събира метрики от определена услуга, трябва да добавим в описанието на услугата допълнителен тип ресурс, така нареченият сервис-монитор. Prometheus, благодарение на способността си да чете кастомни типове ресурси, стартиран в Kubernetes, автоматично започва да събира метрики от новата система. Това е доста удобно.
Първото разгръщане, което направихме в Kubernetes, беше през март 2018 година. И през това време никога не сме имали проблеми с него. Работи стабилно без съществени бъгове. Освен това можем да го разширяваме. В момента имаме достатъчно от възможностите, които предлага, и темпото на развитие на Kubernetes ни харесва. В момента повече от 3000 контейнери са в Kubernetes. Кластерът заема няколко Node. В същото време е управляем, стабилен и много контролиран.
Източник: habr.com
