

Меня зовут Сергей, я из компании ITSumma, и я хочу да ви разкажа как ние подходим към резервиране в Kubernetes. В последно време много работя консултативно по внедряване на разнообразни devops решения за различни екипи и, в частност, активно работя по проекти с използване на K8s. На конференцията Uptime day 4, която беше посветена на резервирането в сложни архитектури, направих доклад за резервирането на "кубче", и ето неговото в свободен стил резюме. Само предварително ще предупредя, че той не е непосредствено ръководство за действие, а по-скоро обобщение на размисли по темата.
По принцип мониторингът и резервирането са два основни инструмента за повишаване на отказоустойчивостта на всеки проект. Но в кубера всичко се балансира само, ще кажете вие, всичко се мащабира само, и ако нещо се случи – ще се повдигне само... Тоест, при първоначално повърхностно изследване на темата, на въпроса кой как подхожда към резервирането на K8s, интернет ми отговори "а защо?". Много хора мислят, че кубер представлява такава магическа работа, която избавя от всички инфраструктурни проблеми и прави така, че проектът никога да не падне. Но… светът не е това, което изглежда.
Как подхождахме към процеса на резервиране по-рано? Имахме идентични площадки за разполагане – било то виртуални машини, или железни сървъри, на които прилагахме три основни практики:
- синхронизация на кода и статиката
- синхронизация на конфигурациите
- репликация на бази данни
И вау: във всеки момент можем да превключим на резервната площадка, всички са щастливи, ставаме и се разпръскваме.
Какво предлагат за увеличаване на постоянната наличност на нашето kubernetes приложение? Първото, за което говори неофициалната документация, е да поставим много машини, да създадем много мастери — техният брой трябва да отговаря на условията за постигане на кворума в клъстера, и на всеки от майсторите трябва да работи etcd, api, MC, scheduler… И сякаш всичко е чудесно: при повреда на няколко работещи нода или мастери нашият клъстер ще се ребалансира и приложението ще продължи да работи. Отново изглежда като магия! Но често нашият клъстер е в рамките на един център за данни и това може да породи определени въпроси. Какво ще стане, ако дойде багер и изкопае кабел, ако удари мълния или настъпи вселенски потоп? Всичко е приключило, нашият клъстер вече не съществува. Как да подходим към резервиране, като вземем предвид тази страна на проблема?
На първо място, трябва да имате още един клъстер в горещ резерв, т.е. клъстер, на който можете да превключите по всяко време. В този случай от гледна точка на Kubernetes инфраструктурата трябва да бъдат напълно идентични. Тоест, ако има някакви нестандартни плъгини за работа с файловата система, кастомни решения за ingress, те трябва да бъдат напълно идентични на вашите два (или три, или десет, тук зависи колко средства и усилия имат администраторите) клъстера. Необходимо е ясно да се определят два набора приложения (deployment-и, statefulset-ове, daemonset-ове, cronjob-ове и т.н.): кои от тях могат да работят постоянно в резерв, а кои е по-добре да не стартирате до непосредствено превключване.
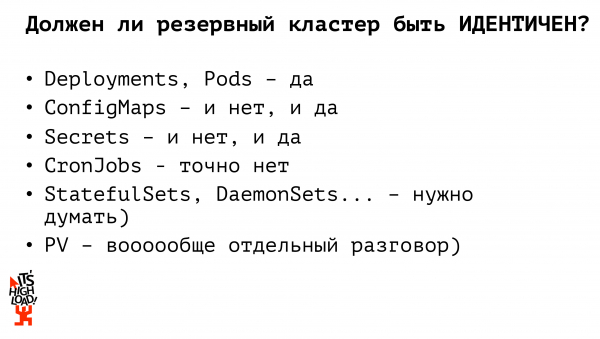
Дали нашият резервен клъстер трябва да бъде напълно идентичен на нашия боен клъстер? Не. Ако преди в контекста на работа с монолитни проекти, с физическа инфраструктура поддържахме практически напълно идентична среда, то в контекста на Kubernetes, аз считам, че това не трябва да бъде така. Нека да разгледаме защо.
Например, давайте започнем с основните елементи на Kubernetes – deployments – те трябва да бъдат идентични. Приложенията, които имате, трябва да бъдат в състояние по всяко време да поемат трафика и да позволят на проекта ни да продължи да съществува. Когато говорим за конфигурационни файлове, е важно да се определи дали те трябва да бъдат идентични или не. Тоест, ако ние, разумните хора, не използваме забранени вещества и не съхраняваме базата данни в K8s, то в configmaps трябва да имаме настройки за достъп до продукционната база (процесът на резервиране на която е изграждан отделно). Съответно, за да осигурим достъп до резервния екземпляр на базата данни, трябва да имаме отделен конфигурационен файл (configmap). По същия начин работим и със secret-ите: пароли за достъп до базата, api ключове; по всяко време може да работи или продукционен secret, или резервен. В края на краищата, вече имаме две Kubernetes същности, резервните версии на които не трябва да бъдат идентични на продукционните. Следващата същност, на която трябва да се спрем – cronjob. Cronjob-ите на резервната система никога не трябва да бъдат идентични на набора cronjob-ове на продукционния клъстер! Ако стартираме резервен клъстер и го стартираме напълно с всички включени cronjob-ове – например, хората ще получават по две писма вместо едно. Или съществуваща синхронизация на данни с външни източници може да се извършва два пъти, в резултат на което започваме да страдаме, да плачем, да викаме и да се караме.
А как ни предлагат да организираме резервния клъстер хората от интернет? Вторият най-популярен отговор след "а защо?" – е използването на Kubernetes Federation.
Какво е това? Това е, да кажем, голям мета-клъстер. Ако си представим архитектурата на Кубер — където имаме мастер и няколко нода — то от гледна точка на федерацията, имаме също мастер и няколко нода, само че всяка нода е отделен клъстер. Тоест, работим с същите същности, с тези самите примитиви, както и с единичния Кубер, само че оперираме не с нашите физически машини, а с цели клъстери. В рамките на федерацията имаме пълна синхронизация на федеративни ресурси от родителите към потомците. Например, ако пуснем някакъв деплоймент през федерацията — той ще се задейства на всеки наш дочерен клъстер. Ако вземем някакъв configmap, секрет, и го разпостраним на федерацията — той ще се разпространи във всички наши дочерни клъстери; в същото време федерацията позволява персонализиране на нашите ресурси на децата. Тоест, вземаме някакъв configmap, разполагаме го през федерацията и след това, ако трябва нещо да коригираме на конкретни клъстери, отиваме да правим корекция на отделния клъстер и това изменение вече няма да бъде синхронизирано никъде.
Kubernetes Federation — е инструмент, който съществува отскоро и не поддържа целия набор ресурси, предоставен от K8s: към момента на публикуване на една от първите версии на документацията, се споменаваше, че поддържа само конфигурационни мапове, доставки под реплика-сет и ingress. Секрети не се поддържат, работата с volume също не е поддържана. Твърде ограничен набор. Особено когато обичаме да експериментираме, — например, да предаваме собствените си ресурси на Kubernetes чрез custom resource definition, — в федерацията вече не можем да ги включим. Тоест, по същество… много близко до истината решение, но ни кара периодично да си стреляне в крака. От друга страна, федерацията позволява гъвкаво управление на нашия replicaset. Например, искаме да имаме 10 копия на приложението си, по подразбиране федерацията ще разпредели това число пропорционално между броя на клъстерите. И всичко това може да се конфигурира! Тоест можем да укажем, че на производствения клъстер трябва да имаме 6 копия на приложението си, а на резервния клъстер, за економия на ресурси или за собствени развлечения — само 4 копия на приложението си. Което е доста удобно. Но с федерацията трябва да използваме нови решения, да добавяме нещо в движение, да се наложи да мислим малко повече…
Може ли да подходим към процеса на резервиране на Kubernetes по някакъв по-прост начин? Какви инструменти имаме изобщо?
На първо място, винаги имаме някаква ci/cd система, тоест не ходим на ръка, не пишем на сървърите create/apply. Системата генерира yaml файлове за нашите контейнери.
На второ място, имаме няколко клъстера, имаме или един, или няколко (ако сме умни) регистри, които също сме взели и резервирали. И има страхотен инструмент kubectl, който може да работи с няколко клъстера едновременно.
И така: според мен най-простото и вярно решение за изграждане на резервен клъстер е примитивен паралелен деплой. Има някакъв пайплайн в ci/cd системата; първо създаваме нашите контейнери, тестваме и разгръщаме приложенията чрез kubectl на няколко независими клъстера. Можем да изградим едновременни версии на няколко клъстера. Съответно, доставката на конфигурации също решаваме на този етап. Можем предварително да определим набор от конфигурации за нашия боен клъстер, набор от конфигурации за резервния клъстер и на ниво ci/cd система да разгръщаме продукционната среда в продукционния клъстер, резервната среда — в резервния клъстер. В сравнение с федерацията не е нужно след определяне на федеративния ресурс да ходим до всеки дочерен клъстер и да преопределяме нещо. Направили сме това предварително. Какви сме младици.
Но... има... аз бях написал, че има "корен на всички злини", но реално те са два. Първо, файловата система. Има някакво PV, или използваме външно хранилище. Ако съхраняваме файловете вътре в клъстера, то трябва да действаме по старите практики, останали от времето на железните инфраструктури: например, да синхронизираме с lsync. Или с някой друг, предпочитан от вас метод. Разгръщаме всичко на други машини и живеем.
На второ място, и наистина, дори по-важна точка, е базата данни. Ако сме умни хора и не държим базата в кубера, то процесът на резервиране на данни по старата схема — мастер-слейв репликация, след това превключване, репликата ще настигнем и ще живеем добре. Но ако държим нашата БД вътре в клъстера, то принципно има много готови решения за организиране на същата мастер-слейв репликация, много решения за изграждане на БД вътре в кубера.
За резервиране на бази данни вече са прочетени милиард доклади, написани милиард статии, нищо ново тук в действителност не е нужно. В общи линии, следвайте мечтите си, живейте както искате, изобретявайте си сложни методи, но непременно обмисляйте как всичко това ще резервирате.
А сега да поговорим за начина, по който принципно ще се извърши процесът на превключване на резервната площадка в случай на пожар. Първо, разгръщаме stateless приложения паралелно. Те не влияят на бизнес логиката на нашите приложения, нашия проект, можем постоянно да поддържаме два набора от работещи приложения и те могат да започнат да приемат трафик. Много е важно при процеса на превключване на резервната площадка да проверим дали е необходимо да преопределим конфигурациите. Например, имаме продуктивен клъстер Kubernetes, имаме резервен клъстер Kubernetes, имаме външна основна база данни и резервна основна база данни. Имаме четири варианта как тези приложения в продукция могат да започнат да взаимодействат помежду си. Може да се превключи базата данни, и се получава, че трябва в продуктивния клъстер да переключим трафика на новата база, или нашият клъстер може да се провали — и ние преминаваме на резервния, но продължаваме да работим с продуктивната база, а третият вариант е, когато и двете неща се провалят, и ние преминаваме на двете приложения, преопределяме нашата конфигурация, за да могат новите приложения да работят с новата база данни.
И така, какви заключения можем да направим от всичко това?
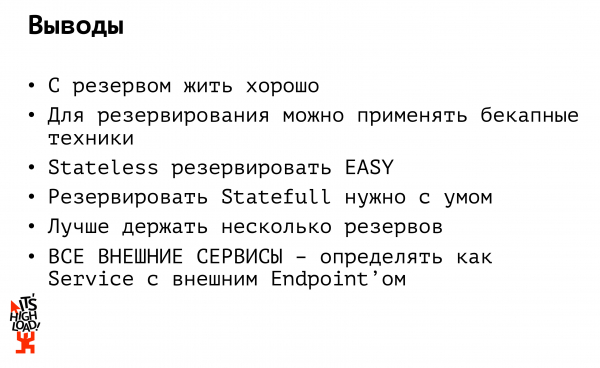
Първото заключение: с резервно копие е добре. Но е скъпо. Идеално е да не разчитате само на едно резервно копие. Всъщност, трябва да имате няколко резервни копия. Първо, резервът трябва да е поне не в един и същ дата център, и второ, поне при друг хостинг provider. Често се е случвало — и в моята практика е било. Не мога да назова конкретни проекти, но когато избухна пожар в дата центъра… Аз: превключваме на резерв! А резервните сървъри стояха в същия рафт...
Или си представете, че Amazon е забранен в Русия (а такова нещо се е случвало). И какво от това, че нашето резервно копие е в друг Amazon? То също е недостъпно. Затова ще повторя: поддържайте резерв, поне в друг дата център, а е за предпочитане — при друг хостинг provider.
Второ изведен: ако в Kubernetes приложението ви комуникира с външни източници (може да бъде база данни или външно API), задължително го определете като услуга с външен Endpoint, за да не преинсталирате 15 от вашите приложения, които се свързват с същата база при смяна. Определете базата като отделна услуга, свържете се с нея, все едно че е вътре в клъстера: ако базата ви се срине, променяте IP адреса на едно място и продължавате да живеете щастливо.
И накрая: обичам 'кубчето', както и експериментите с него. Обичам да споделям резултатите от тези експерименти и изобщо личния си опит. Затова записах серия от уебинари за K8s, добре дошли в за подробности.
Източник: habr.com
