

Въведение
Презентирах това изказване на английски език на конференцията GopherCon Русия 2019 в Москва и на руски – на митапа в Нижни Новгород. Темата е за bitmap индекса – по-малко разпространен от B-tree, но не по-малко интересен. Споделям от изказването на конференцията на английски и текстово транскрибиране на руски.
Ще разгледаме как е сглобен bitmap индексът, кога е по-добър, кога – по-лош от другите индекси и в какви случаи е значително по-бърз от тях; ще видим в кои популярни СУБД вече съществуват bitmap индекси; ще опитаме да напишем свой на Go. А на „десерт“ ще използваме готови библиотеки, за да създадем своя супер бърза специализирана база данни.
Много се надявам, че моят труд ще бъде полезен и интересен за вас. Да започнем!
Въведение

Здравейте на всички! В момента е шест часа вечерта, всички сме супер уморени. Прекрасно време, за да говорим за скучна теория на базите данни, нали? Не се притеснявайте, ще имам няколко реда изходен код тук и там. 🙂
Без шеги, изказването е пренаселено с информация, а ние нямаме толкова време. Затова да започнем.
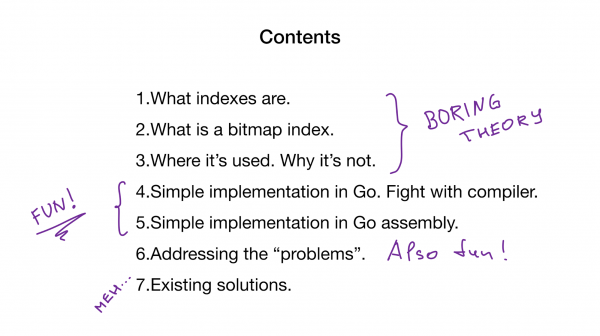
Днес ще говоря за следното:
- какво са индексите;
- какво е bitmap индекс;
- къде се използва и къде НЕ се използва и защо;
- простичка имплементация на Go и малко борба с компилатора;
- чудесно по-малко просто, но значително по-производително имплементиране на Go асемблер;
- „проблеми“ с bitmap индексите;
- съществуващи реализации.
Какво са индексите?
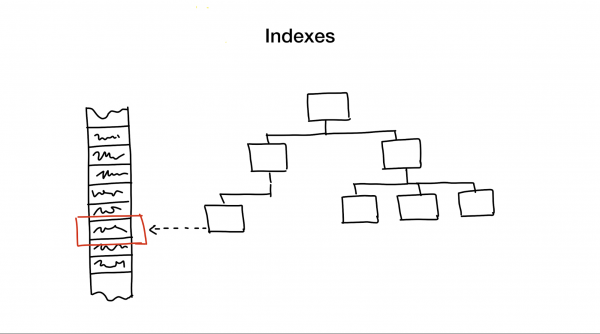
Индексът е отделна структура от данни, която поддържаме и обновяваме в допълнение към основните данни. Използва се за ускоряване на търсенето. Без индекси, търсенето би изисквало пълно преминаване през данните (процес, наречен full scan), а този процес има линейна алгоритмична сложност. Но базите данни обикновено съдържат огромно количество данни и линейната сложност е твърде бавна. В идеалния случай бихме искали да постигнем логаритмична или константна.
Това е огромна и сложна тема, пренаселена с нюанси и компромиси, но след визуализиране на десетилетия разработки и изследвания на различни бази данни, съм готов да твърдя, че съществуват само няколко широко използвани подхода за създаване на БД индекси.
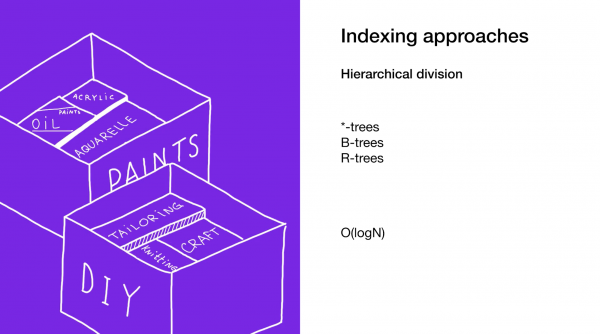
Първият подход е иерархичното намаляване на обхвата на търсене, като се разделя областта на по-малки части.
Обикновено го правим, използвайки различни видове дървета. Пример за това може да е голяма кутия с материали в шкафа ви, в която има по-малки кутии с материали, разделени по различни теми. Ако имате нужда от материали, несъмнено ще търсите в кутията с надпис "Материали", а не в тази, на която пише "Бисквитки", нали?
Вторият подход е да откроим незабавно нужния елемент или група елементи. Правим това в hash maps или обратно индекси. Използването на hash maps е много подобно на предишния пример, само че вместо кутия с кутии имате куп малки кутии с готови предмети в шкафа си.
Третият подход е да се отървем от необходимостта от търсене. Правим това с помощта на Bloom-филтри или cuckoo-филтри. Първите дават отговор мигновено, освобождавайки ви от необходимостта да търсите.
Последният подход е пълното използване на всички мощности, които съвременното желязо ни предоставя. Именно това правим при bitmap-индексите. Да, понякога е необходимо да преминем през целия индекс, но го правим суперефективно.
Както вече споменах, темата за базите данни е широка и пренаситена с компромиси. Това означава, че понякога можем да използваме няколко подхода едновременно: ако трябва да ускорим търсенето още повече или ако е необходимо да покрием всички възможни типове търсене.
Днес ще говоря за най-малко известния подход от именуваните — за bitmap-индексите.
Кой съм аз, за да говоря по тази тема?
Аз съм тимлид в Badoo (възможно е да познавате другия ни продукт — Bumble). Имаме над 400 млн. потребители по целия свят и много функции, които се занимават с това да намират най-добрата двойка за тях. Правим това с помощта на персонализирани услуги, които включват и bitmap-индекси.
Какво всъщност е bitmap-индекс?
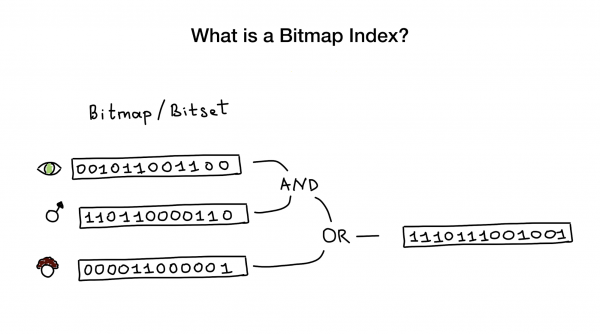
Bitmap индексите, как подсказва̀т името, използват битмапи или битсети, за да реализират търсещ индекс. От височина на птица, този индекс се състои от един или повече такива битмапи, представящи някои същности (като хора) и техните свойства или параметри (възраст, цвят на очите и др.), и от алгоритъм, който използва битови операции (AND, OR, NOT) за отговор на търсене.
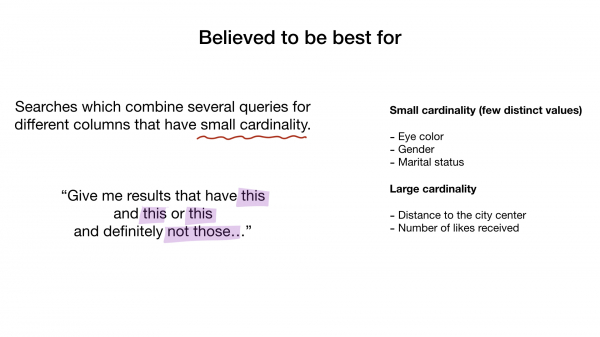
Смята се, че bitmap индексите са най-подходящи и много продуктивни в случаи, когато има търсене, комбиниращо запитвания по много колони с малка кардиналност (представете си «цвят на очите» или «семейно положение» спрямо нещо като «разстояние от центъра на града»). Но по-късно ще покажа, че те работят отлично и с колони с висока кардиналност.
Нека разгледаме най-простия пример на bitmap индекс.
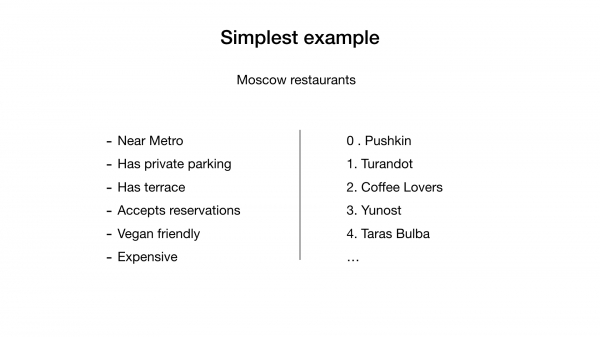
Представете си, че имаме списък с ресторанти в Москва с бинарни свойства като тези:
- близо до метростанция (near metro);
- има частен паркинг (has private parking);
- има тераса (has terrace);
- може да се резервира маса (accepts reservations);
- подходящ за вегетарианци (vegan friendly);
- скъп (expensive).
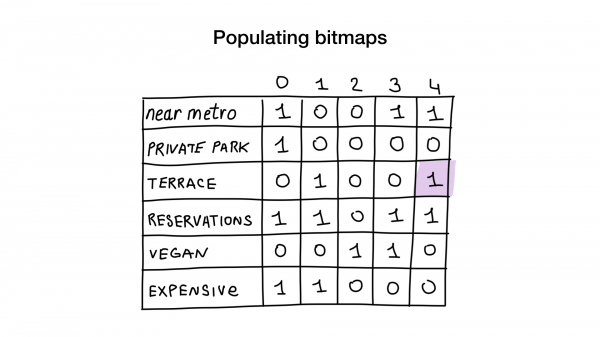
Нека дадем на всеки ресторант пореден номер, започвайки от 0, и да отделим памет за 6 битмапа (по един за всяка характеристика). След това ще запълним тези битмапи в зависимост от това, дали ресторантът притежава съответното свойство или не. Ако ресторант 4 има тераса, то бит №4 в битмапа «има тераса» ще бъде зададен на 1 (ако терасата я няма, то на 0).
Сега имаме най-простия възможен bitmap индекс и можем да го използваме, за да отговаряме на запитвания като:
- «Покажи ми ресторанти, подходящи за вегетарианци»;
- «Покажи ми евтини ресторанти с тераса, където може да се резервира маса».
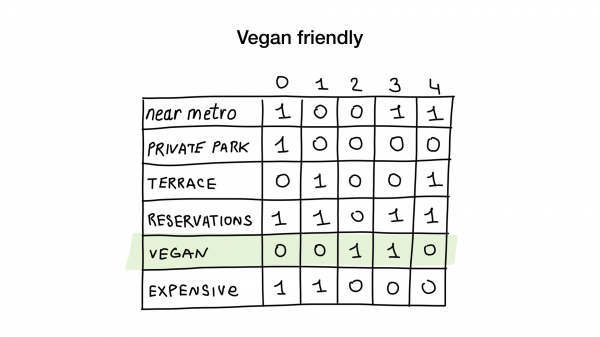
Как? Нека да видим. Първото запитване е много просто. Всичко, което трябва да направим, е да вземем битмапа «подходящ за вегетарианци» и да го превърнем в списък на ресторанти, чийто битове са зададени.
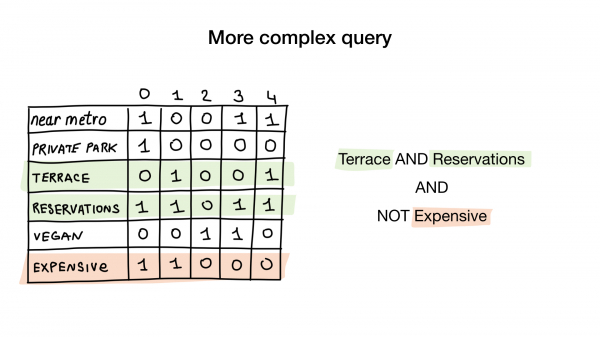
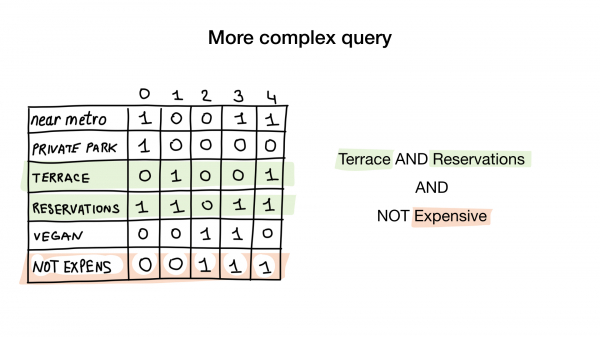
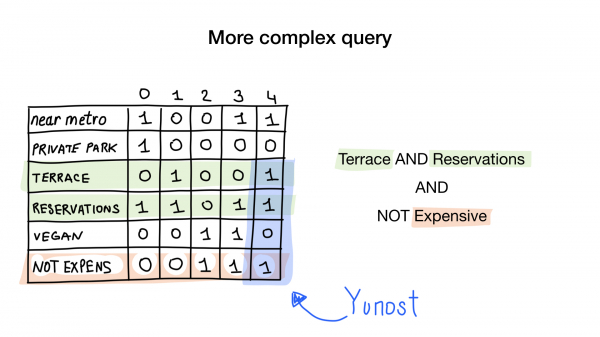
Вторият запит е малко по-сложен. Необходимо е да използваме битовата операция NOT върху битмапа "скъп", за да получим списък с евтини ресторанти, след което да направим AND с битмапа "може да се резервира маса" и да AND-нем резултата с битмапа "има веранда". Полученият битмап ще съдържа списък на заведенията, които отговарят на всичките ни критерии. В този пример това е само ресторант "Юност".
Тук има много теория, но не се притеснявайте, скоро ще видим кода.
Къде се използват битмап индекси?
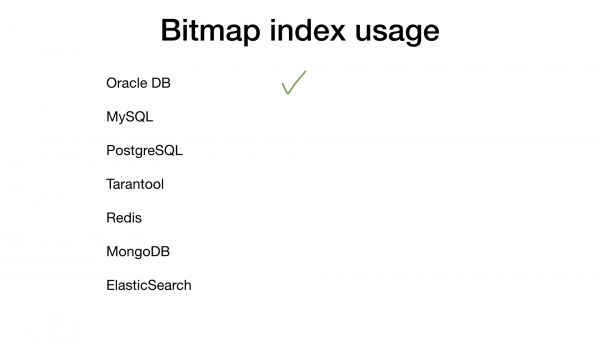
Ако "потърсите" битмап индекси, 90% от отговорите ще бъдат по един или друг начин свързани с Oracle DB. Но и другите СУБД със сигурност поддържат тази готина функция, нали? Не съвсем.
Нека разгледаме списъка с основните заподозрени.
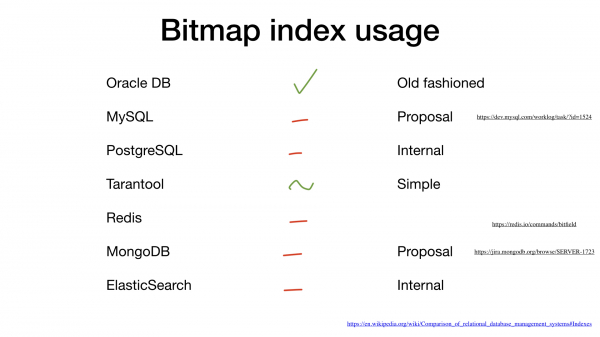
MySQL все още не поддържа битмап индекси, но има предложение за добавяне на тази опция ().
PostgreSQL не поддържа битмап индекси, но използва прости битмапи и битови операции за комбиниране на резултатите от търсене по няколко други индекса.
Tarantool има битсет индекси, той поддържа прост търсене по тях.
Redis разполага с прости битови полета) без възможност за търсене по тях.
MongoDB все още не поддържа битмап индекси, но също така има предложение за добавяне на тази опция
Elasticsearch използва битмапи вътре в).
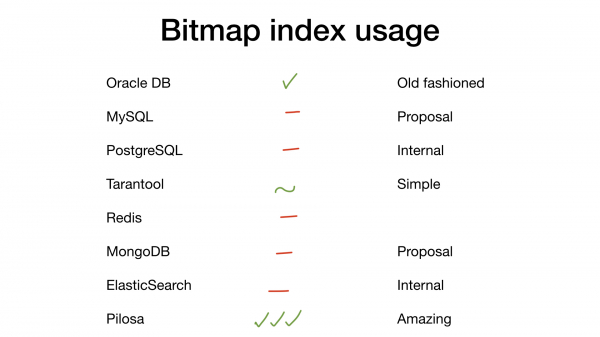
- Но в нашия дом се появи нов съсед: Pilosa. Това е нова нерелационна база данни, написана на Go. Тя съдържа само битмап индекси и всичко е базирано на тях. Ще поговорим за нея малко по-късно.
Имплементация на Go
Но защо битмап индекси се използват толкова рядко? Преди да отговоря на този въпрос, бих искал да ви демонстрирам имплементация на много прост битмап индекс на Go.
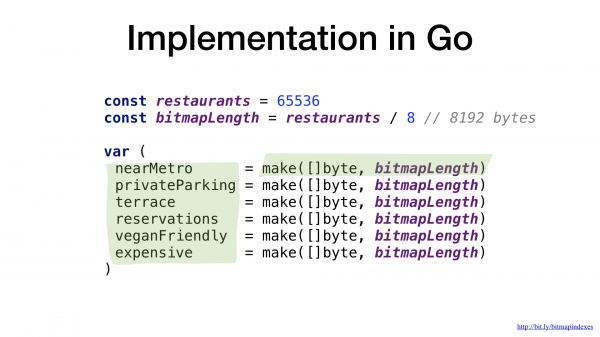
Битмапите по същество са представени просто като блокове от данни. В Go да използваме за това слайсове от байтове.
Имаме един битмап за една характеристика на ресторант и всеки бит в битмапа показва дали конкретният ресторант притежава това свойство или не.
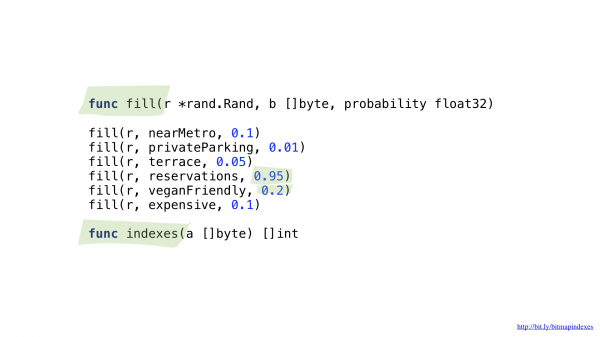
Нуждаем се от две помощни функции. Едната ще бъде използвана за запълване на нашите битмапи с произволни данни. Произволни, но с определена вероятност, че ресторантът притежава всяко от свойствата. Например, считам, че в Москва има много малко ресторанти, в които не може да се резервира маса, и ми се струва, че около 20% от заведенията са подходящи за вегетарианци.
Втората функция ще преобразува битмапа в списък с ресторанти.
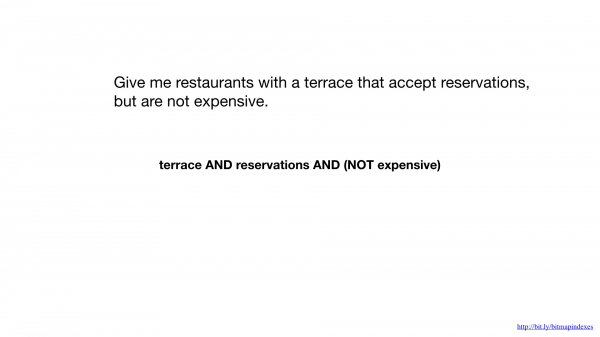
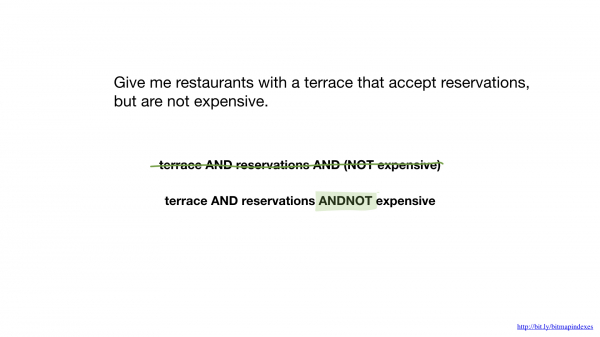
За да отговорим на запитването "Покажи ми евтини ресторанти с веранда и в които може да се резервира маса", ще ни трябват две битови операции: NOT и AND.
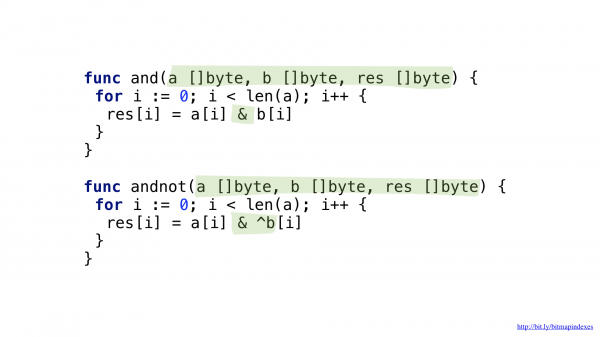
Можем да опростим кода си малко, като използваме по-сложната операция AND NOT.
Имаме функции за всяка от тези операции. И двете преминават по слайсовете, вземат съответните елементи от всеки, комбинират ги с битова операция и поставят резултата в резултатния слайс.
И сега можем да използваме нашите битмапи и функции, за да отговорим на търсенето.
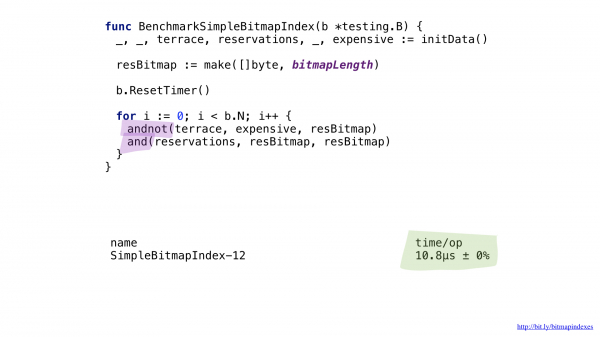
Представянето не е толкова високо, дори след като функциите са много прости и спестихме значително, като не връщахме нов резултатен слайс при всяко извикване на функцията.
След малко профилиране с pprof, забелязах, че компилаторът Go е пропуснал една много проста, но много важна оптимизация: инлайнване на функцията.
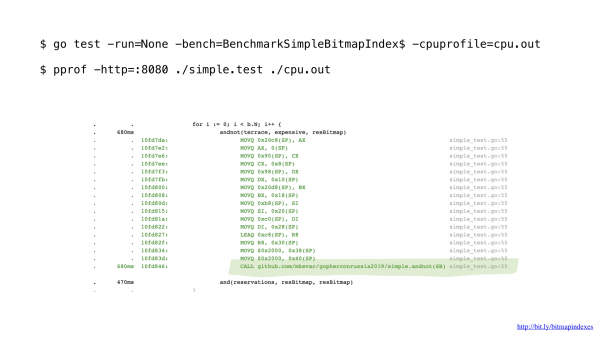
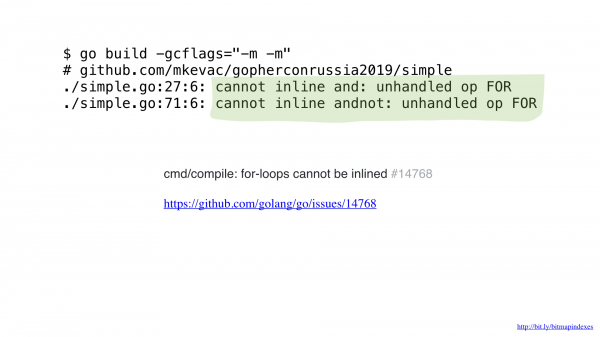
Работата е там, че компилаторът Go ужасно се страхува от цикли, които преминават през слайсове, и категорично отказва да инлайнва функции, които съдържат такива цикли.
Но аз не се страхувам и мога да излъжа компилятора, като използвам goto вместо цикъл, както в добрите стари времена.
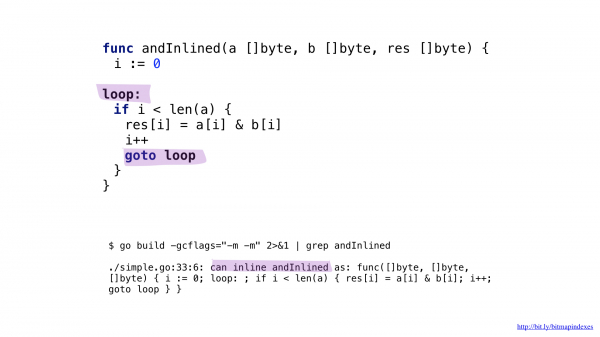
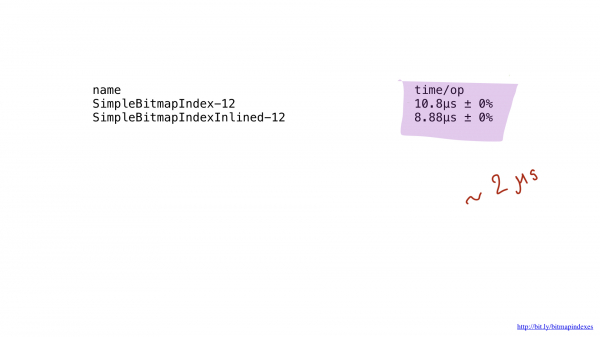
И, както виждате, сега компилаторът gladly инлайнва нашата функция! В крайна сметка успяваме да спестим около 2 микросекунди. Не е зле!
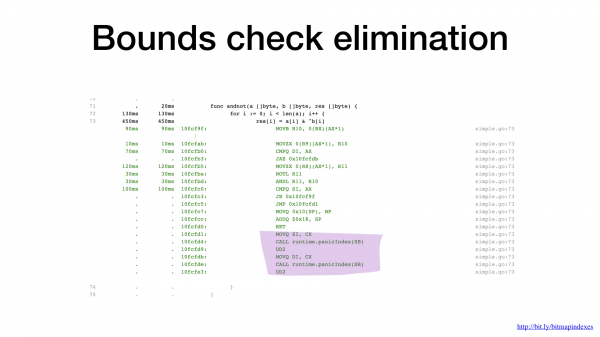
Второто тесно място не е трудно да се види, ако внимателно разгледате асемблерния изход. Компилаторът добавя проверка на границите на слайса точно в нашия най-горещ цикъл. Работата е там, че Go е безопасен език, компилаторът се страхува, че трите ми аргумента (трите слайса) имат различен размер. В края на краищата, тогава ще има теоретичната възможност за възникване на т.н. препълване на буфера (buffer overflow).
Нека успокоим компилатора, за да му покажем, че всички слайсове имат еднакъв размер. Можем да направим това, като добавим проста проверка в началото на нашата функция.
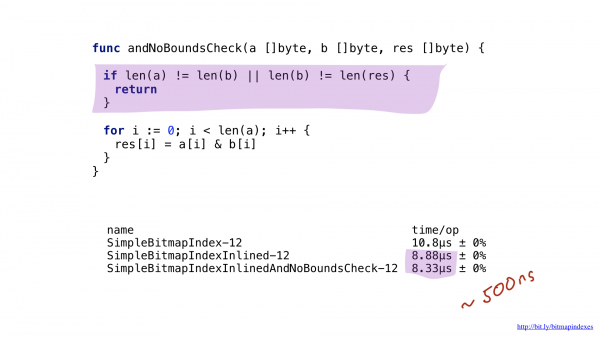
Виждайки това, компилаторът с радост пропуска проверката, а ние в крайна сметка спестяваме още 500 наносекунди.
Големи партиди
Добре, успяхме да извлечем някаква производителност от нашата проста имплементация, но този резултат всъщност е много по-лош от възможното с текущия хардуер.
Всичко, което правим, са базови битови операции, и нашите процесори ги изпълняват много ефективно. Но, за съжаление, 'храним' процесора си с много малки парчета работа. Нашите функции извършват операции по байтове. Можем много лесно да оптимизираме кода си, за да работи с 8-байтни парчета, използвайки слайсове UInt64.
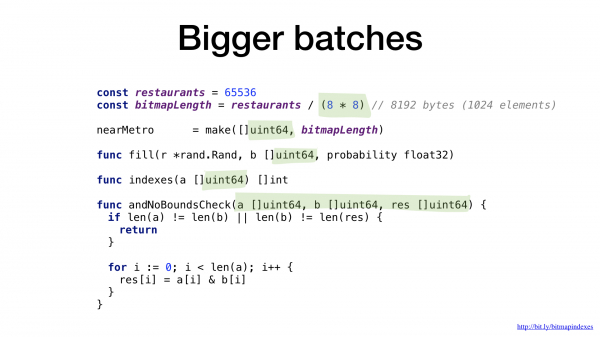
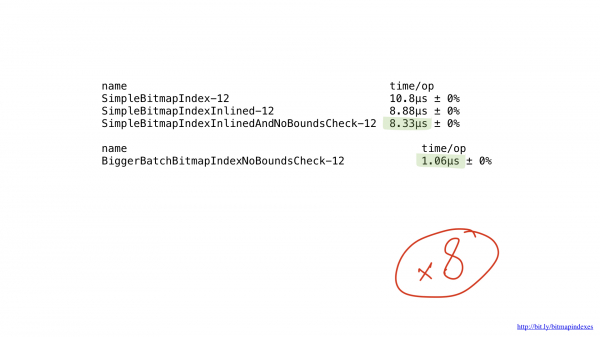
Както виждате, това малко изменение ускори програмата ни осем пъти благодарение на увеличаването на партидата осем пъти. Печалбата, може да се каже, е линейна.
Имплементация на асемблер
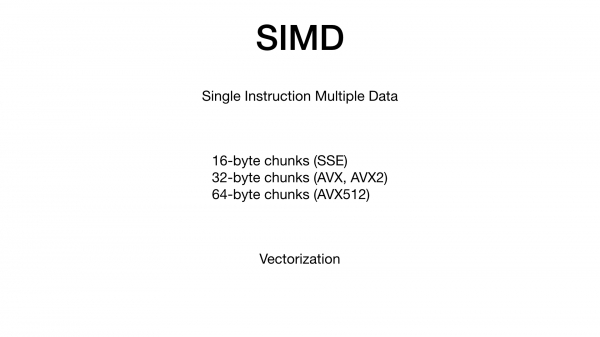
Но това все още не е краят. Нашите процесори могат да работят с парчета от 16, 32 и дори 64 байта. Тези 'широки' операции се наричат single instruction multiple data (SIMD; една инструкция, много данни), а процесът на преобразуване на кода по такъв начин, че да използва тези операции, се нарича векторизация.
За съжаление, Go компилаторът е далеч от идеален в векторизацията. В момента единственият начин за векторизация на код на Go е да вземете и да положите операциите данни ръчно с помощта на Go асемблер.
Go асемблерът е странно същество. Вие вероятно знаете, че асемблерът е нещо, което е силно свързано с архитектурата на компютъра, за който пишете, но в Go не е така. Go асемблерът по-скоро прилича на IRL (intermediate representation language) или междинен език: той е практически платформа-независим. Роб Пайк изнесе отлична презентация по тази тема преди няколко години на GopherCon в Денвър.
В допълнение, Go използва необичаен формат Plan 9, който се различава от общоприетите формати AT&T и Intel.
Може да се каже с увереност, че ръчното писане на Go асемблер не е най-забавната задача.
Но, за щастие, вече има две високо ниво инструменти, които ни помагат в писането на Go асемблер: PeachPy и avo. И двата инструмента генерират Go асемблер от по-високо ниво код, написан на Python и Go съответно.
Тези утилити опростяват задачи като разпределение на регистри (избор на процесорен регистър), написване на цикли и изобщо улесняват процеса на влизане в света на асемблерното програмиране в Go.
Ще използваме avo, така че нашите програми ще бъдат почти обикновени програми на Go.
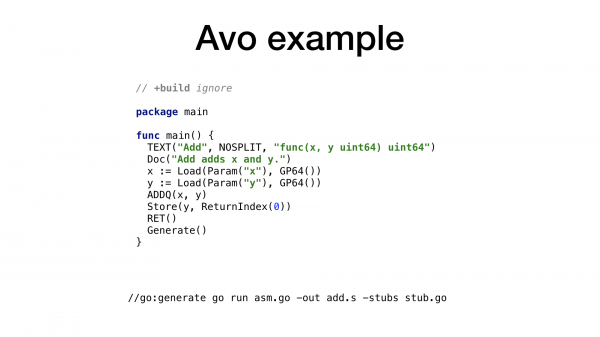
Ето как изглежда най-простият пример на avo-програма. Имаме функция main(), която определя в себе си функция Add(), която цели смятането на две числа. Тук присъстват помощни функции за получаване на параметри по име и получаване на един от свободните и подходящи процесорни регистри. За всяка процесорна операция има съответстваща функция на avo, както се вижда от ADDQ. И накрая, виждаме помощна функция за запазване на резултата.
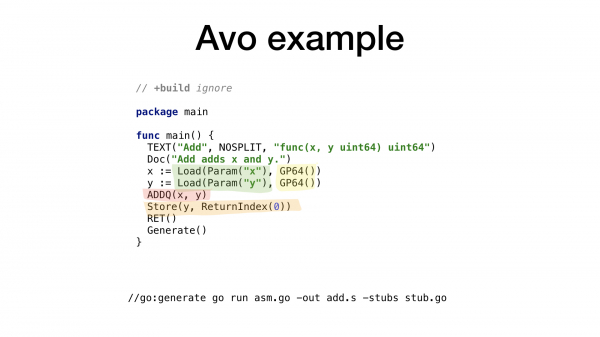
След като извикаме go generate, ще изпълним програмата на avo и в крайна сметка ще бъдат генерирани два файла:
- add.s с резултатния код на Go-асемблер;
- stub.go с заглавия на функции за свързване на двата свята: Go и асемблера.
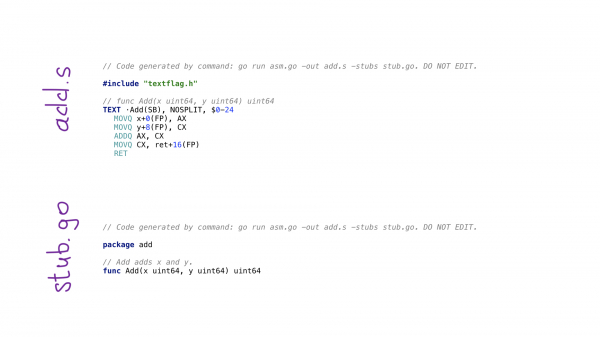
Сега, когато видяхме какво прави avo, нека да разгледаме нашите функции. Реализирах както скаларни, така и векторни (SIMD) версии на функциите.
Първо ще разгледаме скаларните версии.
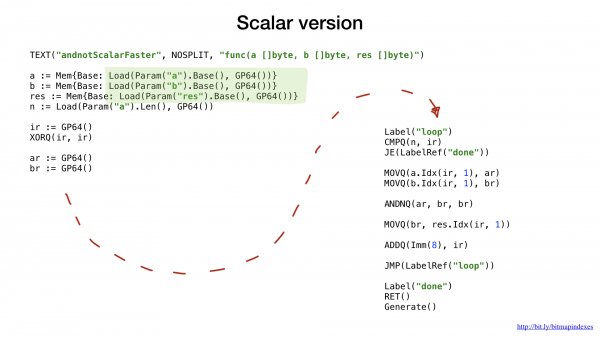
Както в предишния пример, молим да ни предоставят свободен и правилен общ регистър; не е необходимо да изчисляваме смещения и размери за аргументите. Всичко това avo прави вместо нас.
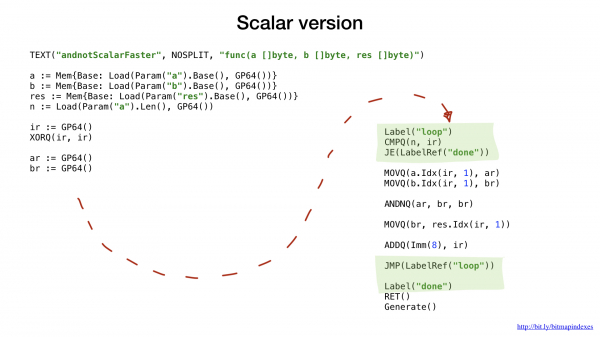
По-рано използвахме етикети и goto (или скокове), за да повишим производителността и да мамим компилатора на Go, но сега правим всичко това от самото начало. Работата е там, че цикъла е по-високо ниво понятие. В асемблера имаме само етикети и скокове.
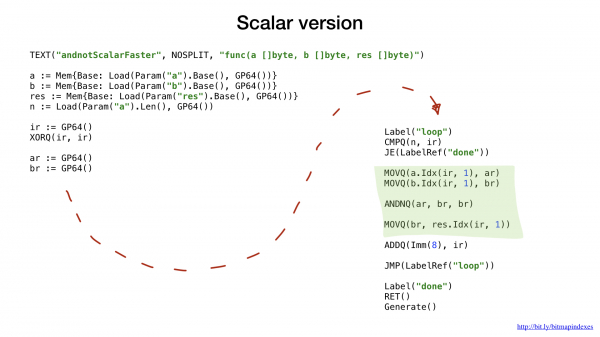
Останалият код трябва да е вече познат и разбираем. Емулираме цикъла с етикети и скокове, взимаме малка част от данните от двата ни слайса, комбинираме ги с битова операция (AND NOT в този случай) и след това поставяме резултата в резултатния слайс. Всичко.
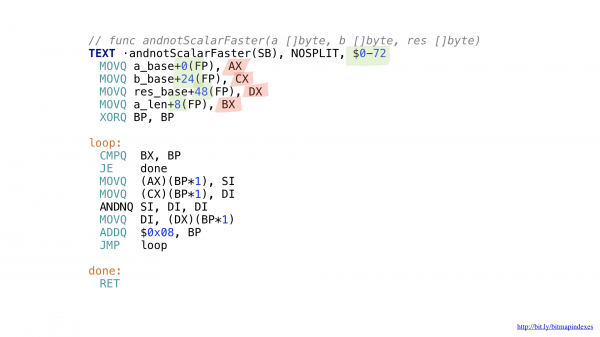
Ето как изглежда окончателният код на асемблера. Не беше нужно да изчисляваме смещения и размери (подчертано в зелено) или да следим използваните регистри (подчертано в червено).
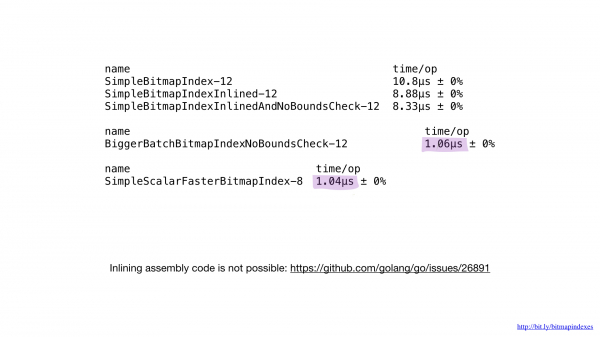
Ако сравним производителността на реализиране на асемблер с производителността на най-добрата реализация на Go, ще видим, че те са еднакви. И това е очаквано. Ние не направихме нищо особено - просто възпроизведохме това, което би направил компилаторът на Go.
За съжаление, не можем да накараме компилатора да инлайнва нашите функции, написани на асемблер. В момента компилаторът на Go не предлага такава възможност, въпреки че искането за добавянето ѝ съществува вече доста време.
Точно затова не можем да получим каквито и да било предимства от малки функции на асемблер. Нужно е да пишем или големи функции, или да използваме новия пакет math/bits, или да избегнем асемблер.
Нека сега да разгледаме векторните версии на нашите функции.
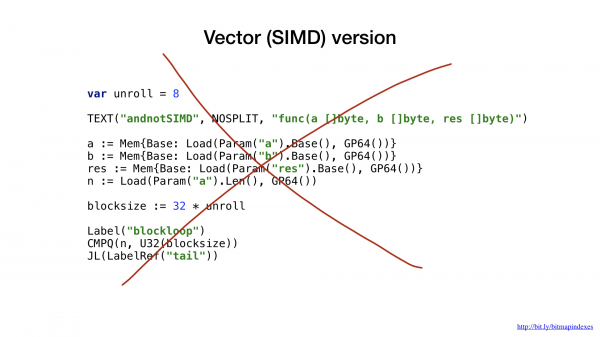
За този пример реших да приложа AVX2, така че ще използваме операции, работещи с 32-байтови блокове. Структурата на кода е много подобна на скаларната версия: зареждане на параметри, искане за свободен общ регистър и т.н.
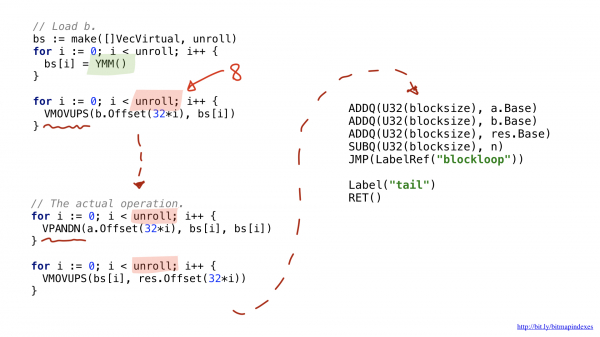
Едно от нововъведенията е, че по-широките векторни операции използват специални широки регистри. В случая с 32-байтовите блокове това са регистри с префикс Y. Затова виждате функцията YMM() в кода. Ако бях използвал AVX-512 с 64-битови блокове, префиксът щеше да е Z.
Второто нововъведение е, че реших да използвам оптимизация, наречена разгръщане на цикъла (loop unrolling), т.е. да направя осем операции на цикъла ръчно, преди да скоча в началото на цикъла. Тази оптимизация намалява броя на разклоненията в кода и е ограничена от броя на наличните свободни регистри.
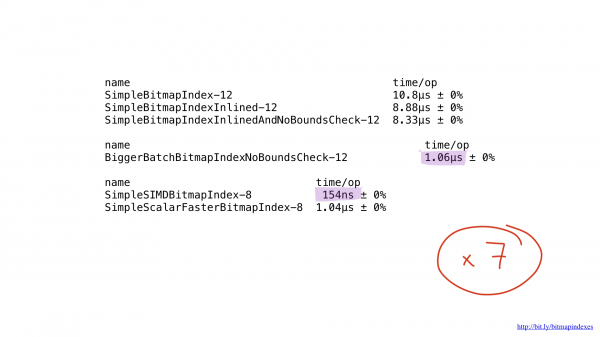
А как е с производителността? Тя е страхотна! Получихме приблизително седем пъти ускорение в сравнение с най-доброто решение на Go. Впечатляващо, нали?
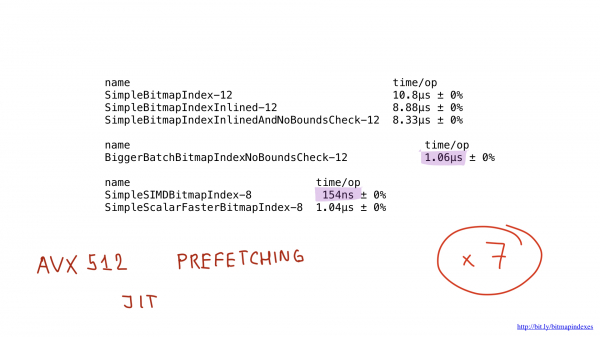
Но дори и тази имплементация потенциално можеше да бъде ускорена, като се използват AVX-512, префетчинг или JIT (just-in-time compiler) за планировчика на запитвания. Но това определено е тема за отделен доклад.
Проблеми с bitmap индексите
Сега, когато вече разгледахме простата реализация на bitmap индекс на Go и значително по-продуктивната на асемблер, нека най-накрая да поговорим защо bitmap индексите се използват толкова рядко.
В старите научни изследвания се споменават три проблема на bitmap индексите, но по-новите научни статии и аз твърдим, че те вече са неактуални. Няма да задълбаваме дълбоко във всяка от тези проблеми, а ще ги разгледаме повърхностно.
Проблема с голямата кардиналност
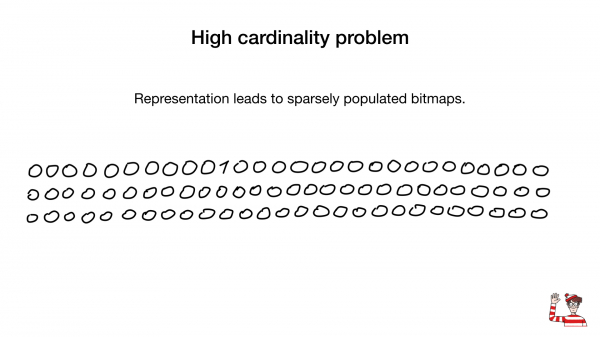
И така, ни казват, че bitmap индексите са подходящи само за полета с ниска кардиналност, т.е. такива, които имат малко стойности (например, пол или цвят на очите), и причината е, че обичайното представяне на такива полета (един бит на стойност) в случай на голяма кардиналност ще заема твърде много място и, освен това, тези bitmap индекси ще бъдат слабо (редко) запълнени.
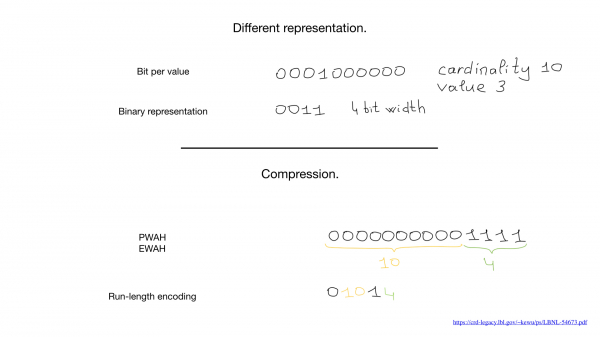
Понякога можем да използваме друго представяне, например стандартното, което използваме за представяне на числа. Но именно появата на алгоритми за компресия всичко промени. През последните десетилетия учени и изследователи създадоха множество алгоритми за компресия на битмапове. Основното им предимство е, че не е нужно да разпаковваме битмаповете за извършване на битови операции — можем да извършваме битови операции директно върху компресираните битмапове.
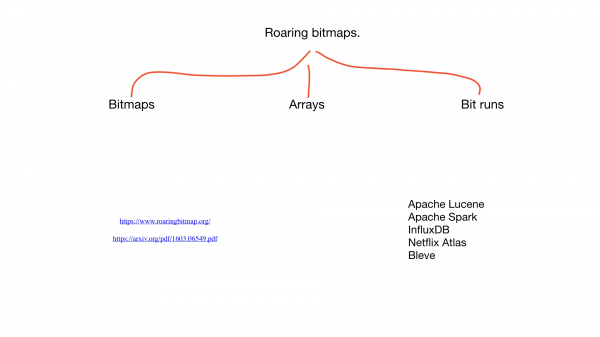
В последно време започнаха да се появяват и хибридни подходи, като например roaring битмаповете. Те използват едновременно три различни представяния за битмапове — самите битмапове, масиви и така наречените bit runs — и балансират помежду им, за да максимизират производителността и минимизират консумацията на памет.
Можете да срещнете roaring битмапове в най-популярните приложения. Вече съществува огромно количество имплементации за най-различни езици за програмиране, включително повече от три имплементации за Go.
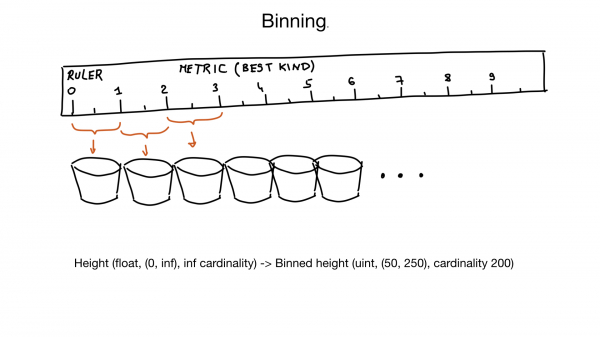
Още един подход, който може да ни помогне да се справим с голямата кардиналност, се нарича групиране (binning). Представете си, че имате поле, представляващо ръста на човек. Ръстът е число с плаваща запетая, но ние, хората, не го възприемаме по този начин. За нас няма значение между ръст от 185,2 см и 185,3 см.
Получава се, че можем да групираме подобни стойности в групи в пределите на 1 см.
Ако знаем, че много малко хора имат ръст под 50 см и над 250 см, можем всъщност да превърнем поле с безкрайна кардиналност в поле с кардиналност приблизително от 200 стойности.
Разбира се, ако е необходимо, можем да извършим допълнителна филтрация и след това.
Проблемът с голямата пропускна способност
Следващият проблем с bitmap индексите е, че обновлението им може да бъде много скъпо.
Базите данни трябва да позволяват актуализиране на данните в момента, когато потенциално стотици други заявки извършват търсене по тези данни. Нуждаем се от локове, за да избегнем проблеми с паралелен достъп до данните или други проблеми с споделен достъп. А там, където има един голям лок, там има проблем — lock contention, когато този лок става тясно място.
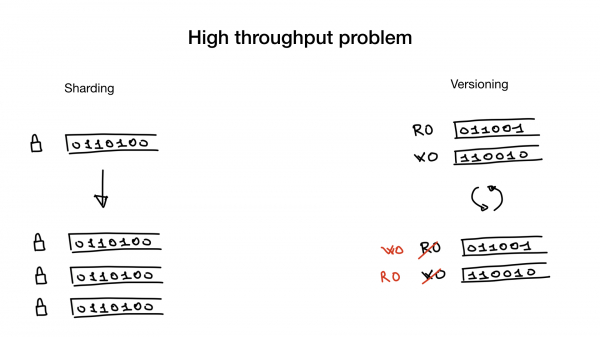
Този проблем може да бъде решен или заобиколен чрез шардинг или използване на версионирани индекси.
Шардингът е нещо просто и общеизвестно. Можете да шардвате bitmap индекс така, както бихте шардвали всякакви други данни. Вместо един голям лок ще получите множество малки локове и по този начин ще избегнете lock contention.
Вторият начин за решаване на проблема е използването на версионирани индекси. Можете да имате едно копие на индекса, което използвате за търсене или четене, и едно — за запис или актуализиране. И на всеки определен интервал от време (например, на всеки 100 ms или 500 ms) вие дублирате и разменяте местата. Разбира се, този подход е приложим само в случаите, когато вашето приложение може да работи със забавен индекс за търсене.
Тези два подхода могат да се използват едновременно: можете да имате шардирован версиониран индекс.
По-сложни заявки
Последният проблем с bitmap индексите е, че, както ни говорят, те не са много подходящи за по-сложни типове заявки, например заявки „по интервал“.
И наистина, ако се замислите, битовите операции като AND, OR и т.н. не са много подходящи за заявки като „Покажи ми хотели с цена на стаята от 200 до 300 долара на вечер“.
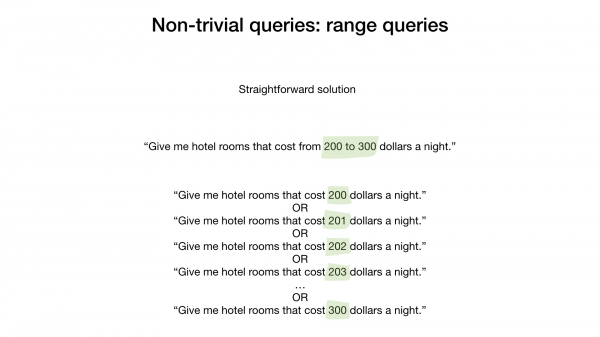
Наивното и много неразумно решение би било да вземете резултатите за всяка доларова стойност и да ги обедините с битова операция OR.
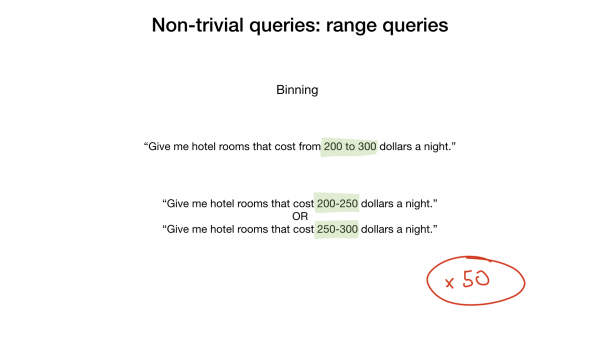
Малко по-правилно решение би било да се използва групиране. Например, в групи по 50 долара. Това би ускорило нашия процес 50 пъти.
Но проблемата също така лесно се решава с използването на представяне, създадено специално за такъв тип запитвания. В научните работи то се нарича битмапи с кодиране по диапазон.
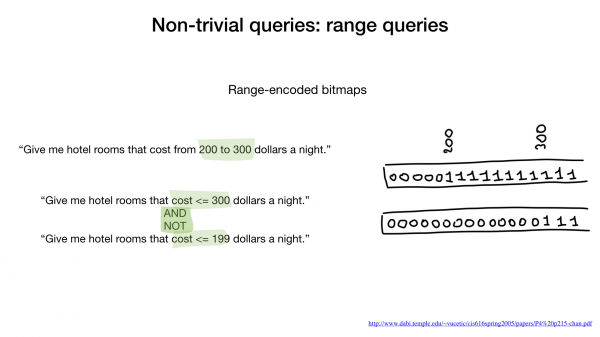
В такова представяне ние не просто задаваме един бит за някаква стойност (например, 200), а задаваме тази стойност и всичко, което е над нея. 200 и нагоре. Същото важи и за 300: 300 и нагоре. И така нататък.
Използвайки това представяне, можем да отговорим на такъв тип търсене, прехвърляйки индекса само два пъти. Първо ще получим списък с хотели, където цената на стаята е под 300 долара, а след това ще отстраним от него тези, където цената на стаята е под 199 долара. Готово.
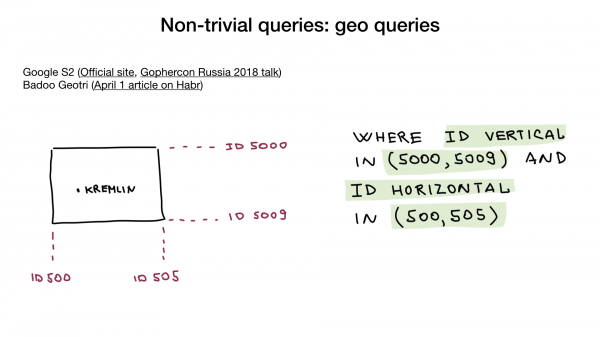
Ще се изненадате, но дори геозапитванията са възможни с използването на битмап индекси. Трикът е да използвате геопредставяне, което обгражда вашата координата с геометрична форма. Например, S2 от Google. Формата трябва да може да бъде представена с три или повече пресичащи се линии, които могат да бъдат номерирани. Така ще можем да превърнем нашето геозапитване в няколко запитвания "по интервал" (по тези номерирани линии).
Готови решения
Надявам се да съм ви заинтересувал малко и в арсенала ви да се е появил още един полезен инструмент. Ако някога ви се наложи да направите нещо подобно, ще знаете в коя посока да гледате.
Въпреки това не всеки има време, търпение и ресурси, за да създаде битмап индекси от нула. Особено по-напредналите, използващи SIMD, например.
За щастие, има няколко готови решения, които ще ви помогнат.
Roaring битмапи
Първо, има библиотеката roaring bitmaps, за която вече споменах. Тя съдържа всички необходими контейнери и битови операции, от които ще имате нужда, за да създадете напълно функционален битмап индекс.
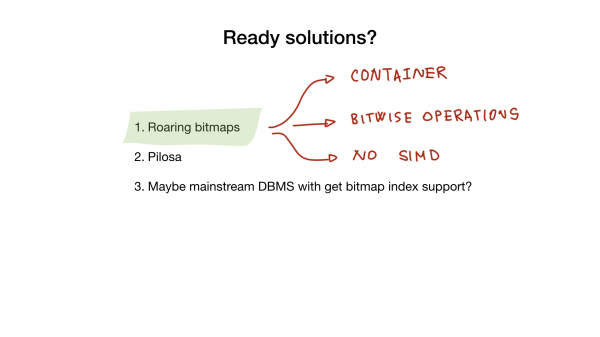
За съжаление, в момента нито една от Go реализациите не използва SIMD, което означава, че Go реализациите са по-малко производителни от тези на C, например.
Pilosa
Друг продукт, който може да ви помогне, е СУБД Pilosa, която основно разчита само на битмап индекси. Това е относително ново решение, но бързо завоюва сърцата.
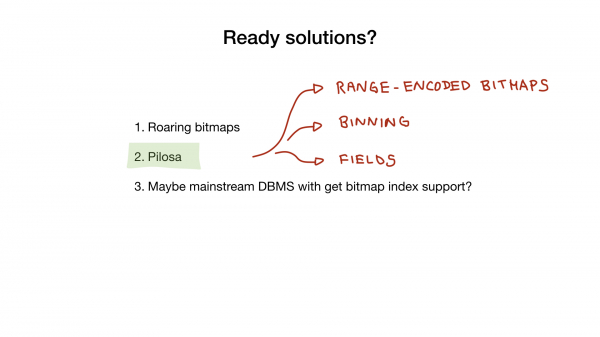
Pilosa използва roaring битмапи в себе си и ви дава възможност да ги използвате, опростява и обяснява всички тези неща, за които говорих по-горе: групиране, битмапи с кодиране по диапазон, концепцията за поле и т.н.
Нека бързо разгледаме пример за използване на Pilosa за отговор на вече познатия ви въпрос.
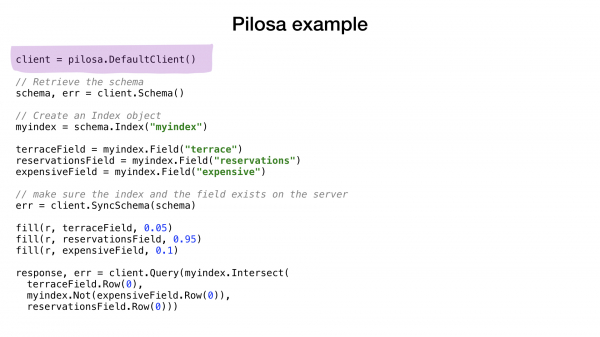
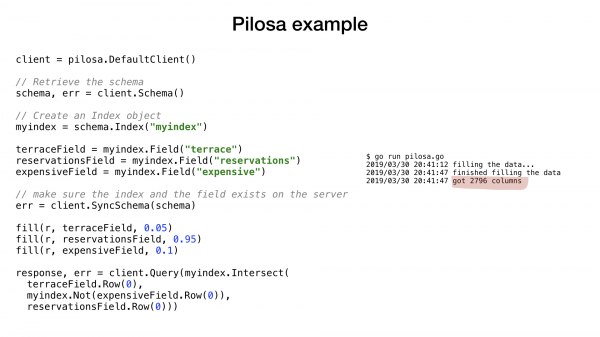
Примерът е много подобен на това, което вече сте видели. Създаваме клиент за сървъра Pilosa, създаваме индекс и необходимите полета, след което запълваме полетата си с произволни данни с вероятности и накрая изпълняваме познатия запит.
След това използваме NOT на полето 'expensive', след това пресичаме получените резултати (или AND-им) с полето 'terrace' и с полето 'reservations'. И накрая, получаваме окончателния резултат.
Много се надявам, че в близкото бъдеще в СУБД като MySQL и PostgreSQL също ще се появи този нов тип индекси — bitmap индекси.
Заключение
Ако все още не сте заспали, благодаря. Трябваше да засегна много теми накратко поради ограниченото време, но се надявам, че докладът беше полезен и може би дори мотивиращ.
Важно е да знаете за bitmap индексите, дори ако в момента не ви трябват. Нека те бъдат още един инструмент в вашия инструментариум.
Разгледахме различни трикове за увеличаване на производителността за Go и нещата, с които компилаторът Go все още не се справя много добре. Но това определено е полезно да знаете за всеки програмист на Go.
Това е всичко, което исках да кажа. Благодаря!
Източник: habr.com
