

Темата за големите инциденти в съвременните центрове за данни повдига въпроси, на които не бе отговорено в първата статия — решихме да я развием.
Ако се вярва на статистиките на Uptime Institute, голяма част от инцидентите в центровете за данни са свързани с неуспехи в електрическите системи — те представляват 39% от инцидентите. Следват ги човешките фактори — още 24% от инцидентите. Третата по значимост причина (15%) са отказите на системите за климатизация, а на четвърто място (12%) са природните бедствия. Общата част на другите неприятности е едва 10%. Без да оспорваме данните на уважаваната организация, ще подчертаем нещо общо в различните инциденти и ще се опитаме да разберем дали е било възможно да се избегнат. Спойлер: в повечето случаи е възможно.
Наука за контактите
Говорейки опростено, има два основни проблема с електрическото захранване: или контактът липсва там, където трябва, или е наличен там, където не трябва. Можем да говорим дълго за надеждността на съвременните системи за непрекъсваемо захранване, но те не спасяват винаги. Да вземем за пример шумния случай с центъра за данни на British Airways, собственост на материнската компания International Airlines Group, разположен близо до летище Хийтроу. Там се намират два такива обекта — Boadicea House и Comet House. В първия от тях на 27 май 2017 г. стана случайно прекъсване на електрическото захранване, което доведе до претоварване и отхвърляне на системата за непрекъсваемо захранване. В резултат, част от ИТ оборудването е било физически повредено, а отстраняването на последния инцидент отнело три дни.
Авиокомпанията е била принудена да отмени или пренасочи над хиляда полета, около 75 хиляди пътници не успели да излетят навреме — за изплащане на компенсации са били изразходвани 128 милиона долара, без да се броят разходите за възстановяване на работоспособността на центровете за данни. Историята с причините за прекъсването остава неясна. Ако вярваме на резултатите от вътрешното разследване, обявени от генералния директор на International Airlines Group Уили Уолш, инцидентът е станал поради грешка на инженерите. Въпреки това, системата за непрекъсваемо захранване е трябвало да издържи такова прекъсване — точно за това е монтирана. Центровете за данни са управлявани от специалисти на аутсорсинг компанията CBRE Managed Services, затова British Airways е опитала да потърси компенсация за щетите през съда в Лондон.
Аварии с електрозахранването се случват по сходни сценарии: първо се случва прекъсване по вина на доставчика на електричество, понякога поради лошо време или вътрешни проблеми (включително грешки на персонала), а след това системата за непрекъсваемо захранване не справя с натоварването или краткосрочно прекъсване на синусоидата причинява откази на много услуги, за възстановяване на работоспособността на които са нужни огромно количество време и средства. Може ли да се избегнат подобни аварии? Безспорно. Ако проектитерат системата правилно, но дори и създателите на големи ЦОД не са застраховани от грешки.
Човешкият фактор
Когато непосредствената причина за инцидента са неправилни действия на персонала на дата центъра, проблемите най-често (но не винаги) засягат софтуерната част на ИТ инфраструктурата. Такива инциденти се случват дори в големи корпорации. През февруари 2017 година част от сървърите на Amazon Web Services бяха изключени заради неправилно въведена команда от член на екипа за техническо обслужване на един от ЦОД. Грешката се случи по време на отстраняване на проблеми в процеса на фактуриране на клиентите на облачната услуга Amazon Simple Storage Service (S3). Служителят се опитваше да изтрие известно количество виртуални сървъри, използвани от биллинговата система, но задели по-голям клъстер.
В резултат на грешката на инженера бяха изтрити сървъри, на които работеха важни софтуерни модули на облачното хранилище Amazon. Първоначално пострада подсистемата за индексиране, съдържаща информация за метаданни и местоположение на всички обекти S3 в американския регион US-EAST-1. Инцидентът засегна също подсистемата, използвана за съхранение на данни и управление на наличното пространство за съхранение. След премахването на виртуалните машини, тези две подсистеми изискваха пълен рестарт, а инженерите на Amazon очакваха изненада — в продължение на дълго време публичното облачно хранилище не успяваше да обслужва исканията на клиентите.
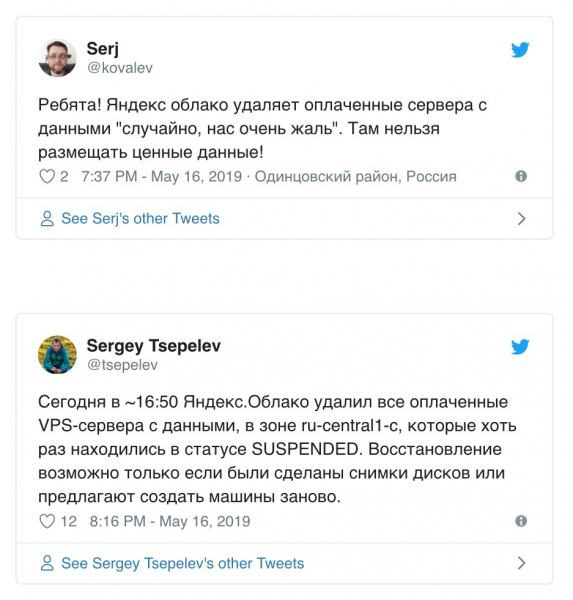
Ефектът се оказа мащабен, тъй като много големи ресурси използват Amazon S3. Неполадките засегнаха Trello, Coursera, IFTTT и, най-лошото, услугите на големи партньори на Amazon от списъка S&P 500. Уредът в такива случаи е трудно да се определи, но сумата изглежда е в размера на стотици милиони долари. Както виждате, за да ликвидирате услугата на най-голямата облачна платформа, е достатъчна една грешна команда. Това не е единичен случай, на 16 май 2019 г. по време на профилактични работи, услугата Яндекс.Облако виртуалните машини на потребителите в зона ru-central1-c, които поне веднъж са били в статус SUSPENDED. Тук вече са пострадали клиентски данни, част от които са били безвъзвратно загубени. Разбира се, хората не са съвършени, но съвременните информационни системи за сигурност отдавна умеят да контролират действията на привилегированите потребители преди изпълнението на въведените от тях команди. Ако в Яндекс или Amazon се внедрят такива решения, подобни инциденти могат да се избегнат.
Замръзнало охлаждане
През януари 2017 г. се случи голям инцидент в центъра за данни на компанията „Мегафон“ в Дмитров. Тогава температурата в московския регион спадна до -35 °C, което доведе до отказ на системата за охлаждане на обекта. Пресс-службата на оператора не разпространи информация относно причините за инцидента — руските компании са изключително неохотни да говорят за аварии на собствените си обекти, в смисъл на публичност, ние значително изоставаме от Запада. В социалните мрежи циркулираше версия за замръзването на топлоносителя в проложените по улицата тръби и изтичането на етиленгликол. Ако се вярва на тази версия, експлоатационната служба не успя поради дългите празници бързо да получи 30 тона хладоносител и се справяше, използвайки подръчни средства, организирайки импровизирано фрикулинг с нарушение на правилата за експлоатация на системата. Силните студове усложниха проблема — през януари в Русия внезапно дойде зима, въпреки че никой не я чакаше. В резултат на това, персоналът трябваше да изключи част от сървърните стелажи, в резултат на което някои услуги на оператора бяха недостъпни в продължение на два дни.
Вероятно, тук може да се говори и за метеорологични аномалии, но такива студове не са нещо необичайно за столичния регион. Температурата през зимата в Подмосковието може да пада и до по-ниски стойности, затова дата центровете се строят с разчет за устойчива работа при -42°C. Най-често системите за охлаждане отказват на студено поради недостатъчно висока концентрация на гликоли и излишък на вода в разтвора на охладителя. Случват се и проблеми с монтажа на тръби или с проектирането и тестването на системата, свързани основно с желанието да се спестят средства. В резултат на това на равна земя се случва сериозна авария, която би могла да бъде избегната.
Природни катастрофи
Най-често гръмотевиците и/или ураганите нарушават работата на инженерната инфраструктура на дата центъра, което води до спиране на услугите и/или физическо повреждане на оборудването. Инциденти, предизвикани от лошото време, се случват доста често. През 2012 г. ураганът Санди премина покрай западното крайбрежие на САЩ с силен дъжд. Разположеният в небостъргач на Долен Манхатън дата център Peer 1 , след като солена морска вода заля мазетата. Аварийните генератори на обекта бяха разположени на 18-тия етаж, а запасът от гориво за тях беше ограничен — въведените в Ню Йорк след терористичните нападения на 11 септември правила забраняват съхранението на голямо количество гориво на горните етажи.
Горивният насос също се повреди, така че персоналът няколко дни носеше дизел за генераторите на ръка. Геройството на екипа спаси дата центъра от сериозна авария, но беше ли то наистина необходимо? Ние живеем на планетата с азотно-кислородна атмосфера и голямо количество вода. Гръмотевиците и ураганите тук са обичайно явление (особено в крайбрежните райони). На проектантите вероятно им е било полезно да отчетат свързаните с тях рискове и да построят подходяща система за непрекъснато електрозахранване. Или поне да изберат по-подходящо място за дата център, отколкото небостъргач на остров.
Всичко останало
В тази категория Uptime Institute определя разнообразни инциденти, сред които е трудно да се избере типичен. Кражби на медни кабели, проникващи във ЦОД, опори на електрически мрежи и трансформаторни подстанции, удряни от автомобили, пожари, които повреждат оптиката, изкопавани от багери, гризачи (плъхове, зайци и дори вомбати, които всъщност са от сумчатите), както и любители на стрелба по проводници — менюто е обширно. Профилактични смущения в електрическото захранване може да предизвика дори плантация на канабис, която краде електричество. В повечето случаи виновниците за инцидента са конкретни хора, т.е. отново имаме работа с човешкия фактор, при който проблемът има име и фамилия. Дори ако на пръв поглед инцидентът е свързан с технически неизправности или природни катаклизми, той може да бъде избегнат при условие на правилно проектиране на обекта и неговата правилна експлоатация. Изключенията са разве случаи на критично увреждане на инфраструктурата на ЦОД или разрушаване на сгради и съоръжения поради природна катастрофа. Това наистина са форсмажорни обстоятелства, а всички останали проблеми са причинени от разстоянието между компютъра и стола — вероятно най-ненадеждната част от всяка сложна система.
Източник: habr.com
