

Предистория
Случайно се случи така, че на сървъра беше атакуван от вирус на шифрователя, който по "щастлива случайност" остави частично незащитени файлове .ibd (файлове на сурови данни от инноDB таблици), но напълно шифрова файлове .fpm (структурни файлове). При това, .idb можеше да бъде разделен на:
- възстановими чрез стандартни средства и ръководства. За такива случаи, има отличен ;
- частично шифровани таблици. Предимно това са големи таблици, за които (както разбрах), на злоумышлениците им е липсвало оперативна памет за пълно шифроване;
- и напълно шифровани таблици, които не могат да бъдат възстановени.
Определих към кой от вариантите принадлежат таблиците, чрез обикновено отваряне в произволен текстов редактор с необходимата кодировка (в моя случай UTF8) и просто преглеждане на файла за наличието на текстови полета, например:
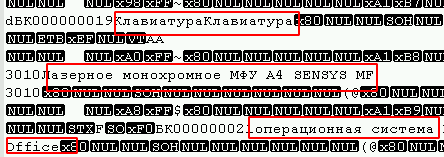
Също така, в началото на файла може да се наблюдава голямо количество нулеви байтове, а вирусите, които използват алгоритми за блоково шифроване (най-разпространени), обикновено засягат и тях.

В моя случай, злонамерителите в края на всеки шифрован файл оставяха редица от 4 байта (1, 0, 0, 0), което опрости задачата. За търсене на неинфекцирани файлове беше достатъчен и скрипта:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Така успях да намеря файловете, принадлежащи на първия тип. Вторият предвижда дълга ръчна работа, но вече намереното беше достатъчно. Всичко щеше да е добре, но е необходимо да знаем абсолютно точната структура и (разбира се) се появи такъв случай, при който трябваше да работя с често променяща се таблица. Никой не помнеше, дали типът на полето се е променял или е добавена нова колона.
Дебри сити за съжаление не можаха да помогнат в такъв случай, затова и се пише тази статия.
По-нататък
Има структура на таблицата от три месеца назад, която не съвпада с текущата (възможно е по едно поле, а може и повече). Структурата на таблицата:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
в същото време, трябва да се извлекат:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
За възстановяване се използва байтов анализ на .ibd файла, последван от преобразуване в по-разбираем формат. Тъй като за търсене на необходимото е достатъчно да анализираме типове данни като int и datetime, в статията ще бъдат описани само те, но понякога ще се позовавам и на други типове данни, което може да помогне в подобни случаи.
Проблем 1: в полета от тип DATETIME и TEXT имаше NULL стойност и те просто се пропускат в файла, поради което не успях да опредя структура за възстановяване в моя случай. В новите колони стойността по подразбиране беше null, а част от транзакцията можеше да бъде изгубена поради настройката innodb_flush_log_at_trx_commit = 0, затова за определянето на структура ще се наложи да се отдели допълнително време.
Проблем 2: следва да се има предвид, че редовете, премахнати чрез DELETE, все пак ще се намират в ibd файла, но при ALTER TABLE тяхната структура няма да бъде актуализирана. В крайна сметка структурата на данните може да варира от началото на файла до края му. Ако често използвате OPTIMIZE TABLE, едва ли ще се сблъскате с подобен проблем.
Обърнете внимание, версията на СУБД влияе на начина на съхранение на данните и този пример може да не сработи за други основни версии. В моя случай бе използвана windows версия mariadb 10.1.24. Освен това, въпреки че в mariadb работите с таблици InnoDB, те всъщност са , което изключва приложимостта на метода с InnoDB mysql.
Анализ на файла
В python типът данни отобразява данни в юникод вместо в обичайната числова форма. Въпреки че файлът може да се разглежда и в такъв вид, за удобство е добре да се преобразуват байтовете в числов вид, като се преобразува масив от байтове в обикновен масив (list(example_byte_array)). Във всеки случай и двата начина ще бъдат полезни за анализа.
Разгледайки няколко ibd файла, могат да се срещнат следните:
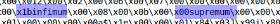
Освен това, ако разделите файла по тези ключови думи, получавате основно равномерни блокове от данни. Нека използваме infimum като разделител.
table = table.split("infimum".encode())Интересно наблюдение, за таблици с малко на брой данни, между infimum и supremum има указател за броя на редовете в блока.
 — тестова таблица с 1 ред
 — тестова таблица с 2 реда
Масивът от низове table[0] може да бъде пропуснат. При прегледа му не успях да открия сурови данни от таблиците. Вероятно този блок служи за съхранение на индекси и ключове.
Започвайки от table[1] и превеждайки я в числов масив, вече можем да забележим някои закономерности, а именно:
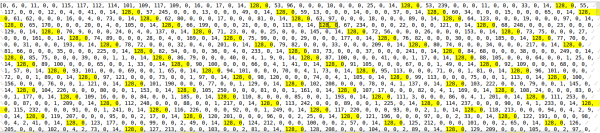
Това са int стойности, съхранявани в низ. Първият байт указва дали числото е положително или отрицателно. В моя случай, всички числа са положителни. От останалите 3 байта можем да определим числото, използвайки следната функция. Скрипт:
def find_int(val: str):  # пример '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Например, 128, 0, 0, 1 = 1, или 128, 0, 75, 108 = 19308.
В таблицата имаше първичен ключ с автоинкремент, и тук също може да бъде открит.
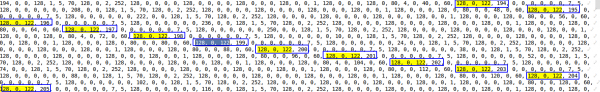
Съотнесвайки данните от тестовите таблици, беше установено, че обектът DATETIME се състои от 5 байта, започващи с 153 (вероятно указващи годишни интервали). Тъй като диапазонът на DATETIME е ‘1000-01-01’ до ‘9999-12-31’, мисля, че броят на байтовете може да варира, но в моя случай данните попадаха в интервала от 2016 до 2019 година, затова ще приемем, че 5 байта са достатъчни.
За определяне на времето без секунди бяха написани следните функции. Скрипт:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
За годината и месеца не успях да напиша работеща функция, затова се наложи да харкодя. Скрипт:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Сигурен съм, ако се отдели n време, това недоразумение може да бъде коригирано.
Следваща, функция, която връща обект datetime от низ. Скрипт:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Успях да открия често повтарящи се стойности от int, int, datetime, datetime 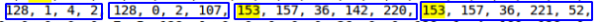 , изглежда това е точно, което трябва. Освен това, такава последователност не се повтаря два пъти в низа.
Използвайки регулярни изрази, намираме необходимите данни:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Обърнете внимание, че при търсене по този израз, не може да се определи NULL стойности в изискваните полета, но в моя случай това не е критично. След това, в цикъл преминаваме през намереното. Скрипт:
резултат = []
за val в fined:
    пред_резултат = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    за it в bd_int:
        пред_резултат.append(find_int(bd_int[it]))
    за bd в bd_date:
        пред_резултат.append(find_data_time(bd))
    резултат.append(пред_резултат)
Всъщност всичко, данните от масива result, това са необходимите ни данни. ###PS.###
Разбирам, че такъв начин няма да подхожда на всички, но основната цел на статията по-скоро е да накара читателя да предприеме действия, отколкото да реши всичките ви проблеми. Мисля, че най-правилното решение би било да започнете да изучавате изходния код самия. , но поради ограниченото време, текущият метод изглеждаше най-бързият.
В някои случаи, след анализ на файла, ще можете да определите приблизителната структура и да възстановите по един от стандартните методи от линковете по-горе. Това ще бъде много по-правилно и ще предизвика по-малко проблеми.
Източник: habr.com
