

Здравейте, приятели. Споделяме с вас превод на статия, подготвена специално за студентите от курса . Да започваме!
Apache Beam и DataFlow за конвейери в реално време
Днешният пост е базиран на задача, по която наскоро работех. Бях наистина развълнуван да я реализирам и да опиша извършената работа в блога, тъй като ми даде възможност да се занимавам с данни и да направя нещо полезно за екипа си. Съвсем наскоро открих, че в нашите системи се съхранява доста голям потребителски лог, свързан с един от нашите продуктите за работа с данни. Оказа се, че никой не е използвал тези данни, затова веднага ми стана интересно какво можем да научим, ако започнем редовно да ги анализираме. Въпреки това, имаше няколко проблема по пътя. Първият проблем беше, че данните се съхраняваха в много различни текстови файлове, които не бяха достъпни за моментален анализ. Вторият проблем беше, че те бяха запазени в затворена система, така че не можех да използвам нито един от любимите ми инструменти за анализ на данни.
Трябваше да реша как да направя достъпа по-лесен и да добавя някаква стойност, интегрирайки този източник на данни в някои от нашите решения за взаимодействие с потребителите. След известно размисъл реших да конструирам конвейер за прехвърляне на тези данни в облачна база данни, дотам, че аз и екипът ми да можем да получим достъп и да започнем да генерираме някакви изводи. След като завърших специализацията по Data Engineering в Coursera преди известно време, бях нетърпелив да приложа в проекта някои инструменти от курса.
Поставянето на данните в облачната база данни изглеждаше разумен начин да реша първия си проблем, но какво можех да направя с проблем номер 2? За щастие, имаше начин да преместя тези данни в среда, където можех да получа достъп до инструменти като Python и Google Cloud Platform (GCP). Въпреки това, това беше дълъг процес, така че трябваше да направя нещо, което да ми позволи да продължа работата, докато чаках предаването на данните. Решението, до което стигнах, беше да създам фалшиви данни, използвайки библиотеката Faker в Python. Никога преди не бях използвал тази библиотека, но бързо разбрах колко полезна е. Използването на този подход ми позволи да започна да пиша код и да тествам конвейера без действителни данни.
С оглед на казаното дотук, в този пост ще разкажа как построих описания по-горе конвейер, използвайки някои от технологиите, налични в GCP. По-специално, ще използвам Apache Beam (версия за Python), Dataflow, Pub/Sub и BigQuery за събиране на потребителски логове, трансформиране на данни и предаване на тях в база данни за по-нататъшен анализ. В моя случай ми беше нужна само пакетна функционалност на Beam, тъй като данните ми не постъпваха в реално време, затова Pub/Sub не беше необходим. Въпреки това ще се спра и на потоковата версия, тъй като с нея може да се сблъскате на практика.
Въведение в GCP и Apache Beam
Google Cloud Platform предлага набор от наистина полезни инструменти за обработка на големи данни. Ето някои от инструментите, които ще използвам:
- — това е услуга за обмен на съобщения, която използва модел Издател-Абонат, която ни позволява да получаваме данни в реално време.
- — това е услуга, която опростява създаването на даннини конвейери и автоматично разрешава такива задачи, като мащабиране на инфраструктурата, което означава, че можем да се концентрираме само върху написването на кода за нашия конвейер.
- — това е облачно хранилище за данни. Ако сте запознати с други SQL бази данни, с BigQuery няма да имате много трудности.
- И накрая, ще използваме Apache Beam, а именно, ще се съсредоточим върху версията на Python за изграждане на нашия конвейер. Този инструмент ще ни позволи да създадем конвейер за потокова или пакетна обработка, който се интегрира с GCP. Той е особено полезен за паралелна обработка и е подходящ за задачи от типа извличане, трансформиране и зареждане (ETL), така че, ако трябва да преместваме данни от едно място на друго с извършване на трансформации или изчисления, Beam е добър избор.
Има много различни инструменти, налични в GCP, затова може да е трудно да се следят всички тях и каква е целта им, но ето един резюме за справка.
В GCP има голямо разнообразие от инструменти, така че може да е трудно да обхванете всички тях, включително предназначението им, но все пак кратко резюме за справка.
Визуализация на нашия конвейер
Нека да визуализираме компонентите на нашия конвейер на рисунка 1. На високо ниво искаме да събираме потребителски данни в реално време, да ги обработваме и да ги предаваме в BigQuery. Логовете се създават, когато потребителите взаимодействат с продукта, изпращайки заявки до сървъра, които след това се логват. Тези данни могат да бъдат особено полезни за разбиране на начина, по който потребителите взаимодействат с нашия продукт и дали той функционира правилно. Общият конвейер ще съдържа следните етапи:
Beam прави този процес много прост, независимо дали имаме потоков източник на данни или файл CSV, и искаме да извършим пакетна обработка. По-късно ще видите, че в кода има само минимални промени, необходими за превключване между тях. Това е едно от предимствата на използването на Beam.
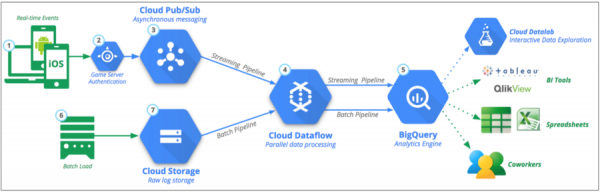
Рисунок 1: Основен конвейер от данни: Източник:
Създаване на псевдоданни с помощта на Faker
Както вече споменах, заради ограничен достъп до данни реших да създам псевдоданни в същия формат, както действителните. Това беше наистина полезно упражнение, тъй като можех да напиша код и да тествам конвейера, докато чаках данните. Предлагам да погледнем на Faker, ако искате да разберете какво още може да предложи тази библиотека. Нашите потребителски данни ще са по същество подобни на примера по-долу. На базата на този формат можем ред по ред да генерираме данни, за да симулираме данни в реално време. Тези журнали ни дават информация като дата, тип заявка, отговор от сървъра, IP адрес и т.н.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Основавайки се на горния ред, искаме да създадем нашата променлива LINE, използвайки 7 променливи в фигурни скоби по-долу. Ще ги използваме и като имена на променливи в нашата схема на таблиците по-късно.
ЛИНИЯ = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Ако извършвахме пакетна обработка, кодът щеше да бъде много подобен, макар че щеше да се наложи да създадем набор от образци в определен времеви диапазон. За да използваме фейкъра, просто създаваме обект и извикваме нужните ни методи. По-специално, Faker беше полезен за генериране на IP адреси, а също и на уебсайтове. Използвах следните методи:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Край на първата част.
В следващите дни ще споделим с вас продължението на статията, а сега традиционно очакваме коментари ;-).
Източник: habr.com
