

Въведение
Добър ден. Вече половин година при нас работи скрипт (по-скоро набор от скриптов), който генерира отчети за състоянието на виртуалните машини (и не само). Реших да споделя опит в създаването и самия код. Разчитам на критики и на това, че този материал може да бъде полезен на някого.
Формиране на нуждите
Имаме много виртуални машини (около 1500 ВМ, разпределени по 3 vCenter). Нови се създават, а стари се изтриват доста често. За да се запази реда, бяха добавени няколко персонализирани полета в vCenter, за да се разделят ВМ на подсистеми, да се укаже дали са тестови и кой и кога ги е създал. Човешкият фактор доведе до това, че над половината машини останаха с незапълнени полета, което усложняваше работата. На всеки шест месеца някой се ядосваше, започваше работа по актуализацията на тези данни, но резултатът спираше да бъде актуален вече след около седмица и половина.
Веднага уточнявам, че всички разбират, че трябва да има заявки за създаване на машини, процес по тяхното създаване и т.н. И при това всички неукоснително следват този процес и навсякъде има ред. У нас, за съжаление, не е така, но това не е предмет на статията 🙂
В общи линии, беше взето решение да се автоматизира проверката на правилността на попълването на полетата.
Решихме, че ежедневно имейл със списък на неправилно попълнените машини до всички отговорни инженери и техните началници ще бъде добро начало.
В момента един от колегите вече беше внедрил скрипт на PowerShell, който всеки ден по график събира информация за всички машини от всички vCenter-и и генерира 3 csv документа (всеки за своя vCenter), които се качват на общ диск. Беше взето решение да се вземе този скрипт за основа и да се допълни с проверки с помощта на езика R, с който имаме известен опит.
В процеса на доработка решението придоби функционалности за информиране по имейл, база данни с основна и историческа таблица (за това по-късно), а също така анализ на логовете на vSphere за търсене на фактическите създатели на ВМ и времето на тяхното създаване.
За разработването бяха използвани IDE RStudio Desktop и PowerShell ISE.
Скриптът се стартира от обикновена Windows виртуална машина.
Описание на общата логика.
Общата логика на скриптовете изглежда следната.
- Събираме данни за виртуалните машини с помощта на PowerShell скрипт, който извикваме чрез R, резултатът обединяваме в един csv. Обратната взаимовръзка между езиците е направена по аналогичен начин. (можеше да се предават данни директно от R в PowerShell под формата на променливи, но това е сложно, а и с наличието на междинни csv е по-лесно за дебъгване и споделяне на междинни резултати).
- С помощта на R формулираме допустими параметри за полета, стойностите на които проверяваме. — Създаваме Word документ, който ще съдържа стойностите на тези полета за вмъкване в информационно писмо, което ще бъде отговор на въпросите на колегите "Не, но как трябва да го запълня?".
- Зареждаме данни за всички ВМ от csv с помощта на R, формулираме dataframe, премахваме ненужните полета и създаваме информационен xlsx документ, който ще съдържа обобщена информация за всички ВМ, който публикуваме на общ ресурс.
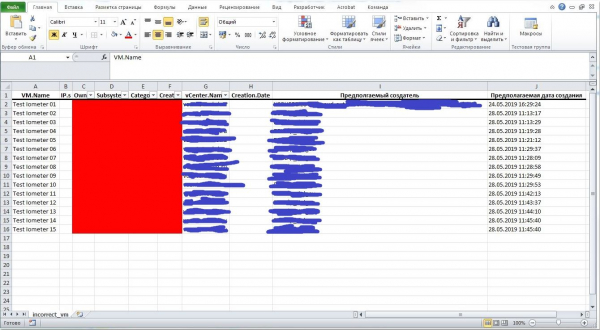
- К dataframe за всички ВМ прилагаме всички проверки за правилност на запълване на полета и създаваме таблица, съдържаща само ВМ с неправилно запълнени полета (и само тези полета).
- Полученият списък с ВМ изпращаме на друг PowerShell скрипт, който ще преглежда логовете на vCenter за събития за създаване на ВМ, което ще позволи да се определи предполагаемото време на създаване на ВМ и предполагаемия създател. Това в случай, че никой не признава чия е машината. Този скрипт не работи бързо, особено ако логовете са много, затова преглеждаме само последните 2 седмици и използваме работен поток, който позволява да се извърши търсене на информация за няколко ВМ едновременно. В примера на скрипта има подробни коментари относно този механизъм. Резултатът се събира в csv, който отново зареждаме в R.
- Създаваме красиво форматиран xlsx документ, в който ще бъдат подчертано с червен цвят неправилно запълнените полета, приложени филтри към някои колони, а също така посочени допълнителни колони, съдържащи предполагаемите създатели и времето на създаване на ВМ.
- Създаваме електронно писмо, към което прилагаме документ, описващ допустимите стойности на полетата, както и таблица с неправилно попълнени виртуални машини. В текста посочваме общия брой неправилно създадени виртуални машини, връзка към общ ресурс и мотивираща картинка. Ако няма неправилно попълнени виртуални машини, изпращаме друго писмо с по-радостна мотивираща картинка.
- Записваме данни за всички виртуални машини в SQL Server база данни, като вземаме предвид внедрения механизъм на историческите таблици (много интересен механизм — за който ще разкажем по-подробно по-късно)
Собствено казано, скриптовете
Основният файл с код на R
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Проверяваме коректността на попълнените полета
full_df <- fullXslx_df %>%
mutate(
# Първо премахваме всички излишни интервали и табулации, след това взимаме разделител запетая, накрая проверяваме наличието в допустимите стойности,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Проверяваме съществуването на файл с всички ВМ и го изтриваме, ако съществува.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Създаваме xslx файл с отчета ####
# Общи данни на отделен лист
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Създаваме xslx файл с неправилно попълнени полета ####
# Създаваме df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Проверяваме съществуването на файл с всички ВМ и го изтриваме, ако съществува.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Запазваме списъка с ВМ с незапълнени полета в csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Филтрираме за вмъкване в имейл
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Броим броя редове
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Проверяваме съществуването на файл с създателите и го изтриваме, ако съществува.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Стартираме PowerShell скрипт, който ще намери създателите на намерените ВМ. На изхода получаваме csv.
system(paste0("powershell -File ", getCreatorsPath))
# Четем файла с създателите
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Филтрираме за вмъкване в имейл, добавяме данни от таблицата с създателите
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Предполагаем създател` = CreatedBy,
`Предполагаема дата на създаване` = CreatedOn)
# Създаваме тялото на имейла
emailBody <- paste0(
'<html>
<h3>Добър ден, уважаеми колеги.</h3>
<p>Цялата актуализирана информация за виртуалните машини можете да видите на диска H: тук:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Също така в приложението списък с <strong>некоректно попълнени</strong> полета. Общо те са <strong>', numberOfRows,'</strong>.</p>
<p>В таблицата се появиха 2 допълнителни колони. <strong>Предполагаем създател</strong> и <strong>Предполагаема дата на създаване</strong>, които се извличат от логовете на vCenter за последните 2 седмици</p>
<p>Моля, създателите на машините да уточнят данните и да попълнят полетата коректно. Правилата за попълване на полетата също в приложението</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Проверяваме съществуването на файла
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Формираме красива таблица с формати и т.н.
source(file = "email.R", local = T, encoding = "utf-8")
#### Формираме писмо с лошо подписани машини ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "ВМ с некоректно попълнени полета",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### После ще последва блок, ако няма проблеми с ВМ ####
} else {
# Формираме тялото на писмото
emailBody <- paste0(
'<html>
<h3>Добър ден, уважаеми колеги</h3>
<p>Цялата актуализирана информация за виртуалните машини можете да видите на диска H: тук:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Също така, в момента, всички полета на ВМ са коректно попълнени</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Формираме писмо без лошо попълнени ВМ ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Сводна информация",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Записваме данни в БД #####
source(file = "DB.R", local = T, encoding = "utf-8")
Скрипт за получаване на списък с виртуални машини на PowerShell
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
Скрипт на PowerShell, който изтегля от логовете създателите на виртуални машини и датите на тяхното създаване
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Отделно внимание заслужава библиотеката , която позволи да направим приложението към писмото визуално форматирано (както харесва ръководството), а не просто csv таблица.
Създаване на красив xlsx документ със списък на неправилно попълнените машини
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
На изхода получаваме нещо подобно:
Имаше също интересен нюанс по настройката на Windows Scheduler. Никак не можеше да се подберат правилните параметри на правата и настройките, за да се стартира всичко както трябва. В крайна сметка беше намерена библиотека на R, която сама създава задача за стартиране на R скрипт и дори не забравя за файла с логовете. След това може ръчно да се коригира задачата.
Парче код на R с два примера, което създава задача в Windows планирача
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## стартираме скрипта след 62 секунди
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## стартираме скрипта всеки ден в 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## изтриваме задачите
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Преглеждаме логовете (последните 4 реда)
tail(readLines("all_vm.log"), sep ="n", n = 4)
Отделно за базата данни
След настройката на скрипта започнаха да се появяват други въпроси. Например, искаше се да се намери датата, когато виртуалната машина беше изтрита, а логовете в vCenter вече бяха изтъркани. Тъй като скриптът поставя файлове в папка всеки ден и не ги чисти (почистваме на ръка, когато си спомним), може да се прегледат стари файлове и да се намери първият файл, в който тази виртуална машина я няма. Но това не е наистина удобно.
Искало се създаването на историческа база данни.
На помощ дойде функционалността на MS SQL SERVER — времеви таблици с версии. Обикновено се превеждат като временни (не времеви) таблици.
Можете да прочетете подробно в .
Накратко — създаваме таблица, указваме, че тя ще бъде с версии и SQL Server създава 2 допълнителни колони с дата и час в тази таблица (датата на създаване на записа и датата на приключване на живота на записа) и допълнителна таблица, в която ще се записват промените. В резултат получаваме актуална информация и, чрез прости заявки, примери на които са дадени в документацията, можем да видим или жизнения цикъл на конкретна виртуална машина, или състоянието на всички ВМ в определен момент.
От гледна точка на производителността — транзакцията на записа в основната таблица няма да бъде завършена, докато не бъде завършена транзакцията на записа в времевата таблица. Тоест, при таблици с голям брой записващи операции, тази функционалност трябва да се внедрява с внимание, но в нашия случай това наистина е нещо много готино.
За да работи механизмът коректно, беше необходимо да допиша малък фрагмент код на R, който да сравнява новата таблица с данните за всички ВМ с тази, която се съхранява в БД и да записва в нея само променените редове. Кодът не е особено сложен, използва библиотеката compareDF, но също ще го представя по-долу.
Код на R за записване на данни в БД
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
Общо
В резултат на внедряването на скрипта, за няколко месеца беше приведен и поддържан ред. Понякога неправилно попълнени ВМ се появяват, но скриптът служи като добро напомняне и рядка ВМ попада в списъка 2 дни подред.
Също така беше направен опит за анализ на исторически данни.
Ясно е, че много от това може да се реализира не "на коляно", а с професионален софтуер, но задачата беше интересна и може да се каже факултативна.
R отново показа, че е прекрасен универсален език, който отлично подхожда не само за решаване на статистически задачи, но и служи като прекрасен "мост" между други източници на данни.
Източник: habr.com
