

Здравейте, занимавам се с разработка на приложения за СУБД — е разработена в Mail.ru Group платформа, която съчетава високо производителна СУБД и сървър за приложения на езика Lua. Високата скорост на решенията, базирани на Tarantool, се постига отчасти благодарение на поддръжката на in-memory режим на СУБД и възможността за изпълнение на бизнес логика на приложението в един адресен пространство с данните. В същото време се осигурява персистентност на данните, използвайки ACID транзакции (на диска се води WAL журнал). Tarantool има вградена поддръжка за репликация и шардизация. От версия 2.1 се поддържат запитвания на SQL език. Tarantool има отворен код и се разпространява под лиценз Simplified BSD. Има и търговска версия Enterprise.
Почувствайте силата! (…или се насладете на производителността)
Всички изброени факти правят Tarantool привлекателна платформа за създаване на приложения с високо натоварване, работещи с БД. В такива приложения често възниква необходимост от репликация на данни.
Както беше казано по-горе, в Tarantool има вградена репликация на данни. Принципът на работа е последователното изпълнение на репликантите на всички транзакции, съдържащи се в журнала на мастера (WAL). Обикновено такова репликиране (сега наречено нискоуровнева) се използва за осигуряване на устойчивост на приложенията и/или за разпределяне на натоварването при четене между нодовете на кластера.
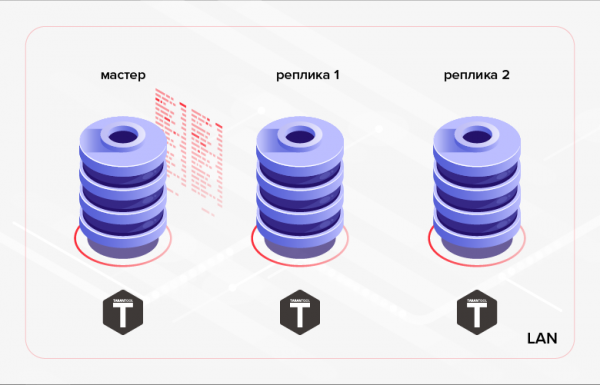
Рис. 1. Репликация вътре в кластера
Пример за алтернативен сценарий може да бъде предаването на данни, създадени в една БД, в друга БД за обработка/мониторинг. В последния случай по-удобно решение може да бъде използването на високоуровнева репликация — репликация на данни на ниво бизнес логика на приложението. Т.е. не използваме готово решение, вградено в СУБД, а самостоятелно реализираме репликацията в разработваното от нас приложение. Тази подход има както предимства, така и недостатъци. Нека изброим плюсовете.
1. Спестяване на трафик:
- може да се предават не всички данни, а само част от тях (например, може да предавате само определени таблици, някои от колоните им или записи, отговарящи на определен критерий);
- в отличие от низкоуровневата репликация, която се извършва непрекъснато в асинхронен (реализирано в текущата версия Tarantool — 1.10) или синхронен (ще бъде реализирано в бъдещите версии Tarantool) режим, високоуровнева репликация може да се извършва сесии (т.е. приложението първо извършва синхронизация на данни — сесия за обмен на данни, след което настъпва пауза в репликацията, след която следва следваща сесия за обмен и т.н.);
- ако записа се е променял няколко пъти, може да се предаде само неговата последна версия (в отличие от нискоуровневата репликация, при която на репликите последователно ще бъдат проиграни всички промени, направени на мастера).
2. Липсват затруднения с реализирането на обмена по HTTP, което позволява синхронизиране на отдалечени БД.
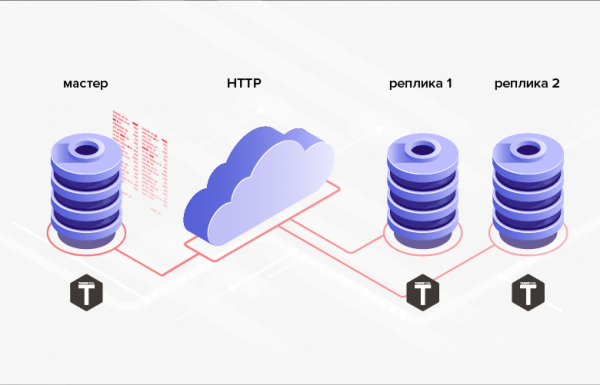
Рис. 2. Репликация по HTTP
3. Структурите на БД, между които се предават данни, не е необходимо да бъдат идентични (по-скоро, в общия случай е възможно дори използването на различни СУБД, програмни езици, платформи и т.н.).
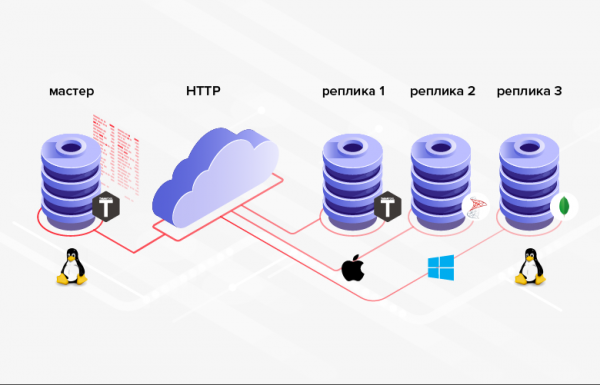
Рис. 3. Репликация в хетерогенни системи
Недостатъкът е, че в средно програмирането е по-трудно/скъпо, отколкото конфигурирането, и вместо настройка на вградена функционалност ще е необходимо да реализирате своя собствена.
Ако в вашата ситуация посочените плюсове играят решаваща роля (или са необходимото условие), то има смисъл да се използва високоуровнева репликация. Нека разгледаме няколко начина за реализиране на високоуровнева репликация на данни в СУБД Tarantool.
Минимизиране на трафика
И така, едно от предимствата на високоуровневата репликация е икономията на трафик. За да се прояви това предимство в пълна степен, е необходимо да се минимизира количеството данни, предавани при всяка сесия за обмен. Разбира се, в крайна сметка приемникът на данни трябва да бъде синхронизиран с източника (поне по онова количество данни, което участва в репликацията).
Как да минимизираме количеството данни, предавани при високоуровнева репликация? Решението "в лоб" може да бъде селекция на данни по дата-време. За това може да се използва вече наличното в таблицата поле дата-време (ако такова съществува). Например, документът "заявка" може да има поле "изисквано време за изпълнение на заявката" — време за доставка. Проблемата на това решение е, че стойностите в това поле не е задължително да са в последователност, съответстваща на създаването на поръчките. Следователно, не можем да запомним максималната стойност на полето. време за доставка, предадена по време на предишната обменна сесия, и при следващата обменна сесия да изберем всички записи с по-висока стойност на полето. време за доставка. В промеждутъка между обменните сесии е възможно да са добавени записи с по-ниска стойност на полето. време за доставка. Също така, поръчката можеше да претърпи промени, които все пак не са засегнали полето. време за доставка. Във всички случаи промените няма да бъдат предадени от източника на получателя. За решаване на тези проблеми ще е необходимо да предаваме данни „наслоено“. Т.е. при всяка обменна сесия ще предаваме всички данни със стойност на полето време за доставка, надвишаваща определен момент в миналото (например, N часа от текущия момент). Въпреки това е очевидно, че за големи системи този подход е много излишен и може да елиминира спестяването на трафик, към което се стремим. Освен това, в предаваната таблица може да няма поле, свързано с дата-време.
Друго решение, по-сложно откъм реализиране, е потвърждаването на получаване на данни. В този случай при всяка обменна сесия се предават всички данни, чиято получаване не е потвърдено от получателя. За реализиране ще е необходимо да се добави булева колона в таблицата-източник (например, is_transferred). Ако получателят потвърди получаването на записа, съответното поле получава стойност истинно, след което записът вече не участва в обмените. Такъв вариант на реализиране има следните недостатъци. Първо, за всеки предаден запис е необходимо да се генерира и изпрати потвърждение. Грубо казано, това може да е сравнимо с удвояване на количеството предавани данни и да доведе до удвояване на броя на рундтриповете. На второ място, липсва възможност за изпращане на един и същ запис на няколко получатели (първият получил потвърдил получаването за себе си и за всички останали).
Метод, свободный от недостатков, упомянутых выше, заключается в добавлении в передаваемую таблицу столбца для отслеживания изменений ее строк. Такой столбец может иметь тип дата-время и должен устанавливаться/обновляться приложением на текущее время каждый раз при добавлении/изменении записей (атомарно с добавлением/изменением). В качестве примера назовем столбец update_time. Сохранив максимальное значение поля этого столбца для переданных записей, мы сможем начать следующий сеанс обмена с этого значения (отобрать записи со значением поля update_time, превышающим сохраненное ранее значение). Проблема, связанная с последним подходом, заключается в том, что изменения данных могут происходить в пакетном режиме. В результате значения полей в столбце update_time могут быть не уникальными. Таким образом, этот столбец не может быть использован для порционной (постраничной) выдачи данных. Для постраничной выдачи данных придется изобретать дополнительные механизмы, которые, скорее всего, будут иметь очень низкую эффективность (например, извлечение из БД всех записей со значением update_time выше заданного и выдача определенного количества записей, начиная с некоторого смещения от начала выборки).
Можно повысить эффективность передачи данных, немного усовершенствовав предыдущий подход. Для этого в качестве значений полей столбца для отслеживания изменений будем использовать целочисленный тип (длинное целое). Назовем столбец row_ver. Значение поля этого столбца по-прежнему должно устанавливаться/обновляться каждый раз при создании/изменении записи. Но в данном случае полю будет присваиваться не текущее дата-время, а значение некоторого счетчика, увеличенного на единицу. В результате столбец row_ver будет содержать уникальные значения и сможет быть использован не только для выдачи «дельты» данных (данных, добавившихся/изменившихся после завершения предыдущего сеанса обмена), но и для простой и эффективной разбивки их на страницы.
Последний предложенный способ минимизации количества данных, передаваемых в рамках высокоуровневой репликации, представляется мне наиболее оптимальным и универсальным. Остановимся на нем подробнее.
Передача данных с использованием счетчика версий строк
Реализация на сървърната / основната част
В MS SQL Server за реализиране на подобен подход съществува специален тип колона — rowversion. Всяка БД притежава брояч, който се увеличава с единица всеки път, когато се добавя / променя запис в таблицата, съдържаща колона от тип rowversion. Стойността на този брояч автоматично се присвоява на полето на тази колона в добавеният / промененият запис. СУБД Tarantool няма аналогичен вграден механизъм. Въпреки това в Tarantool е лесно да се реализира ръчно. Нека видим как става.
Преди да започнем, малко терминология: таблиците в Tarantool се наричат спейсове (space), а записите — кортежи (tuple). В Tarantool можете да създавате последователности (sequence). Последователностите са именувани генератори на подредени стойности на цели числа. Тоест, точно това, което ни е необходимо за нашите цели. По-долу ще създадем такава последователност.
Преди да извършите някаква операция с базата данни в Tarantool, трябва да изпълните следната команда:
box.cfg{}В резултат на това Tarantool ще започне да записва текущите снимки на БД (snapshot) и журнала на транзакциите.
Нека създадем последователност row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Опция if_not_exists позволява многократно изпълнение на скрипта за създаване: ако обектът съществува, Tarantool няма да се опитва да го създаде отново. Тази опция ще бъде използвана във всички следващи DDL команди.
Нека създадем спейс за пример.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Тук зададохме името на спейса (goods), имената на полета и техните типове.
Автоинкрементни полета в Tarantool също се създават с помощта на последователности. Нека създадем автоинкрементен първичен ключ по полето id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool поддържа няколко типа индекси. Най-често се използват индекси от типовете TREE и HASH, които основани на съответстващите им структури. TREE е най-универсалният тип индекс. Той позволява извличане на данни в подреден вид. Но за избор по равенство HASH е по-подходящ. Следователно, за първичния ключ е разумно да използваме HASH (както и направихме).
За да се използва колоната row_ver за предаване на променените данни, е необходимо да се свържат с полетата на тази колоната стойности от последователността row_ver. Но за разлика от първичния ключ, стойността на полето на колоната row_ver трябва да се увеличава с единица не само при добавяне на нови записи, но и при промяна на съществуващите. За това могат да се използват тригери. В Tarantool има два типа тригери за спейсове: before_replace и on_replace. Тригери се стартират при всяка промяна на данните в спейса (за всеки кортеж, засегнат от промените, се стартира функцията на тригера). В отличие от on_replace, before_replace-тригери позволяват модифициране на данните на кортежа, за който се изпълнява тригерът. Следователно, ни подхожда последният тип тригери.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Представеният тригер заменя стойността на полето row_ver на съхранявания кортеж с следващата стойност от последователността. row_version.
За да можем да извличаме данни от спейса goods по колоната row_ver, ще създадем индекс:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Типът индекс е дърво (TREE), тъй като трябва да извличаме данни в нарастващ ред на стойностите в колоната. row_ver.
Добавяме в спейса някои данни:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Тъй като първото поле е автоинкрементен брояч, предаваме вместо него nil. Tarantool автоматично ще подстави следващата стойност. По подобен начин можем да предаваме nil като стойност на полетата на колоната или да не указваме стойност изобщо, тъй като тази колона заема последната позиция в спейса. row_ver Да проверим резултата от вмъкването:
Нека проверим резултата от вмъкването:
tarantool> box.space.goods:select()
---
- - [1, ' химикалка', 123, 1]
  - [2, 'молив', 321, 2]
  - [3, 'четка', 100, 3]
  - [4, 'акварел', 456, 4]
  - [5, 'албум', 101, 5]
  - [6, 'блокнот', 800, 6]
  - [7, 'гума', 531, 7]
  - [8, 'линеал', 135, 8]
...
Както виждаме, първото и последното поле се попълват автоматично. Сега ще бъде лесно да напишем функция за странично извличане на промените от пространството. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
Функцията приема като параметър стойност, row_ver, от която е необходимо да се извърши извличането на промените и връща порция променени данни.
Извличането на данни в Tarantool се извършва чрез индекси. Функцията get_goods използва итератор по индекса row_ver за получаване на променени данни. Типът итератор е GT (Greater Than, повече от). Това означава, че итераторът ще извърши последователно обхождане на стойностите на индекса, започвайки от предадения ключ (стойността на полето row_ver).
Итераторът връща кортежи. За да можем после да предадем данни по HTTP, е необходимо да преобразуваме кортежите в структура, удобна за последваща сериализация. В примера за това се използва стандартната функция tomap. Вместо да използвате tomap можете да напишете собствена функция. Например, можем да искаме да преименуваме полето name, да не предаваме полето code и да добавим полето comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'някакъв коментар'
    obj.row_ver = tuple.row_ver
    return obj
end
Размерът на страницата на извлечените данни (броят на записите в една порция) се определя от променливата page_size. В примера стойността page_size равно 5. В действителност, размер на страницата обикновено има по-голямо значение. Той зависи от средния размер на кортежа на спейса. Оптималният размер на страницата може да се определи емпирично, измервайки времето за предаване на данни. Колкото по-голям е размерът на страницата, толкова по-малко са количествата на рундтриповете между предаващата и приемаща страна. По този начин можем да намалим общото време за извличане на промените. Въпреки това, при прекалено голям размер на страницата, ще застояваме на сървъра твърде дълго време, сериализирайки избора. В резултат на това могат да възникнат забавяния при обработката на други заявки, пристигащи на сървъра. Параметър page_size може да бъде зареден от конфигурационния файл. За всеки предавания спейс може да се зададе собствена стойност. Въпреки това, за повечето спейсове може да е подходяща стойност по подразбиране (например, 100).
Нека изпълним функция get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: молив
    id: 1
  - row_ver: 2
    code: 321
    name: химикал
    id: 2
  - row_ver: 3
    code: 100
    name: четка
    id: 3
  - row_ver: 4
    code: 456
    name: акварел
    id: 4
  - row_ver: 5
    code: 101
    name: албум
    id: 5
...
Да вземем стойността на полето row_ver от последния ред и отново да извикаме функцията:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: тетрадка
    id: 6
  - row_ver: 7
    code: 531
    name: гумичка
    id: 7
  - row_ver: 8
    code: 135
    name: линия
    id: 8
...
И отново:
tarantool> get_goods(8)
---
- []
...
Както виждаме, при това използване функцията последователно връща всички записи на спейса goods. След последната страница следва празен избор.
Нека направим промени в спейса:
box.space.goods:update(4, {{'=', 6, 'учебник'}})
box.space.goods:insert{nil, 'клип', 234}
box.space.goods:insert{nil, 'папка', 432}
Променихме стойността на полето name за един запис и добавихме два нови записа.
Нека повторим последното извикване на функцията:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: учебник
    id: 6
  - row_ver: 10
    code: 234
    name: клип
    id: 9
  - row_ver: 11
    code: 432
    name: папка
    id: 10
...
Функцията върна променените и добавените записи. Така, функцията get_goods позволява да получим данни, които са се променили от последното ѝ извикване, което е основата на разглеждания метод за репликация.
Оставяме извеждането на резултатите по HTTP в формат JSON извън обхвата на настоящата статия. Можете да прочетете за това тук:
Реализация на клиентската/долна част
Нека разгледаме как изглежда реализацията на приемащата страна. Ще създадем спейс на приемащата страна за съхранение на заредените данни:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Структура на пространството наподобява структурата на пространството в източника. Но тъй като не възнамеряваме да предаваме получените данни никъде другаде, колоната row_ver в пространството на получателя липсва. В полето id ще се записват идентификаторите на източника. Следователно на страна на получателя няма необходимост да го правим автоинкрементен.
Освен това, ще ни трябва пространство за запазване на стойности row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
За всяко зареждано пространство (полето space_name) ще запазваме тук последната заредена стойност row_ver (полето value). Като първичен ключ служи колоната space_name.
Създаваме функция за зареждане на данни от пространството goods по HTTP. За целта ще ни е необходима библиотека, реализираща HTTP клиент. Следният ред зарежда библиотеката и създава инстанция на HTTP клиента:
local http_client = require('http.client').new()Също така, ще ни е необходима библиотека за десериализация на json:
local json = require('json')Това е достатъчно за създаване на функцията за зареждане на данни:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
Функцията извършва HTTP заявка на адреса url, предава в него row_ver като параметър и връща десериализирания резултат от заявката.
Функцията за запазване на получените данни изглежда по следния начин:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
Цикълът за запазване на данните в пространството goods е поставен в транзакция (за това се използва функцията box.atomic) за намаляване на броя на операциите с диска.
Накрая, функцията за синхронизиране на локалното пространство goods с източника може да се реализира по следния начин:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Първо, прочитаме запазената по-рано стойност row_ver за пространството goods. Ако я няма (първа сесия на обмена), взимаме в качестве row_ver нула. След това в цикъл извършваме странично зареждане на променените данни от източника по зададения url. На всяка итерация запазваме получените данни в съответното локално пространство и обновяваме стойността row_ver (в пространството row_ver и в променливата row_ver) — вземаме стойността row_ver от последния ред на заредените данни.
За защита от случайна цикличност (в случай на грешка в програмата) цикълът докато може да бъде заменен с for:
за _ = 1, max_req правим ... В резултат на изпълнението на функцията sync_goods пространството goods в приемника ще съдържа последните версии на всички записи от пространството goods в източника.
Очевидно е, че такъв начин не може да транслира изтриването на данни. Ако такава необходимост съществува, може да се използва маркировка за изтриване. Добавяме в пространството goods логическо поле is_deleted и вместо физическо изтриване на записа използваме логическо изтриване — задаваме стойността на полето is_deleted на стойността истинно. Понякога вместо логическото поле is_deleted по-удобно е да се използва полето deleted, в което се съхранява дата-времето на логическото изтриване на записа. След извършване на логическото изтриване, означеният за изтриване запис ще бъде предаден от източника на приемника (според разгледаната по-горе логика).
Последователността row_ver може да се използва за предаване на данни от други пространства: няма нужда от създаване на отделна последователност за всяко предавано пространство.
Разгледахме ефективен начин за високоуровнева репликация на данни в приложения, използващи СУБД Tarantool.
Изводи
- СУБД Tarantool — атрактивен, перспективен продукт за създаване на високо натоварени приложения.
- Високоуровневата репликация на данни има редица предимства пред нискоуровневата репликация.
- Разгледаният в статията начин за високоуровнева репликация позволява минимизиране на количеството предавани данни, като се предават само онези записи, които са се променили след последната сесия на обмен.
Източник: habr.com
