

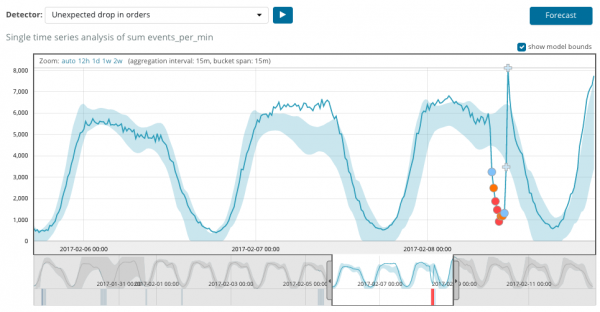
Напомняме, че основата на Elastic Stack е нерелационната база данни Elasticsearch, уеб интерфейсът Kibana и обработчици на данни (най-известният е Logstash, различни Beats, APM и други). Едно от приятните допълнения на целия изброен стек е анализът на данни с помощта на алгоритми за машинно обучение. В статията разглеждаме какво представляват тези алгоритми. Моля, продължете.
Машинното обучение е платена функция на условно-безплатния Elastic Stack и влиза в пакета X-Pack. За да започнете да го използвате, е достатъчно след инсталацията да активирате 30-дневен пробен период. След изтичането на пробния период можете да поискате поддръжка за удължаването му или да закупите абонамент. Цената на абонамента се изчислява не по обема на данните, а по броя на използваните нодове. Да, обемът на данните, разбира се, влияе на броя на необходимите нодове, но все пак този подход към лицензирането е по-хуманен спрямо бюджета на компанията. Ако няма нужда от висока производителност — може да се спести.
ML в Elastic Stack е написан на C++ и работи извън JVM, в който работи самият Elasticsearch. Тоест процесът (който, между другото, се нарича autodetect) консумира всичко, което не усвоява JVM. На демо стенд това не е толкова критично, но в продуктивна среда е важно да се отделят отделни нодове за задачи по машинно обучение.
Алгоритмите за машинно обучение се делят на две категории — и . В Elastic Stack алгоритъмът е от категорията "без учител". Чрез можете да видите математическия апарат на алгоритмите за машинно обучение.
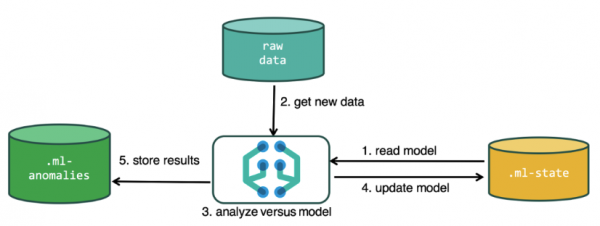
За провеждане на анализ алгоритъмът за машинно обучение използва данни, съхранявани в индексите на Elasticsearch. Заданията за анализ могат да се създават както от интерфейса Kibana, така и чрез API. Ако го правите чрез Kibana, някои неща не е необходимо да знаете. Например, допълнителните индекси, които алгоритъмът използва по време на работа.
Допълнителните индекси, използвани по време на анализа.ml-state — информация за статистическите модели (настройките за анализ);
.ml-anomalies-* — резултатите от работата на алгоритмите ML;
.ml-notifications — настройки за известия по резултатите от анализа.
Структура на данните в базата Elasticsearch се състои от индекси и съхранявани в тях документи. Ако сравним с релационна база данни, индексът може да се сравни с схема на базата данни, а документът с запис в таблица. Това сравнение е условно и е приведено за опростяване на разбирането на по-нататъшния материал за тези, които само са чували за Elasticsearch.
Чрез API е достъпен същият функционал, както чрез уеб интерфейса, затова за яснотата и разбирането на концепциите ще показваме как да настраняваме чрез Kibana. В лявото меню има раздел Machine Learning, в който може да създадете нова задача (Job). В интерфейса на Kibana това изглежда като на изображението по-долу. Сега ще разгледаме всеки тип задача и ще покажем видовете анализи, които може да конструирате тук.
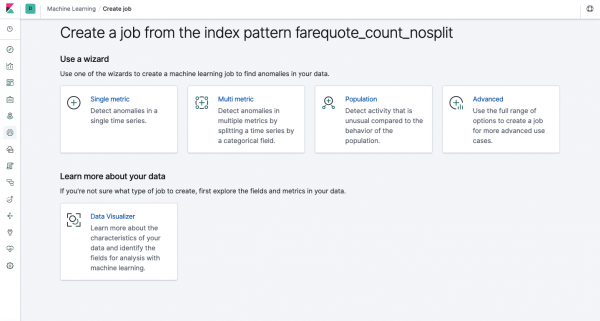
Single Metric — анализ на една метрика, Multi Metric — анализ на две и повече метрики. В двата случая всяка метрика се анализира в изолирана среда, т.е. алгоритъмът не взема предвид поведението на паралелно анализираните метрики, както може да изглежда в случая с Multi Metric. За да се проведе изчисление с оглед на корелацията между различни метрики, може да се приложи Population-анализ. А Advanced — това е прецизна настройка на алгоритмите с допълнителни опции за специфични задачи.
Single Metric
Анализ на промените на една единствена метрика — най-простото нещо, което може да се направи тук. След натискане на Create Job алгоритъмът ще търси аномалии.
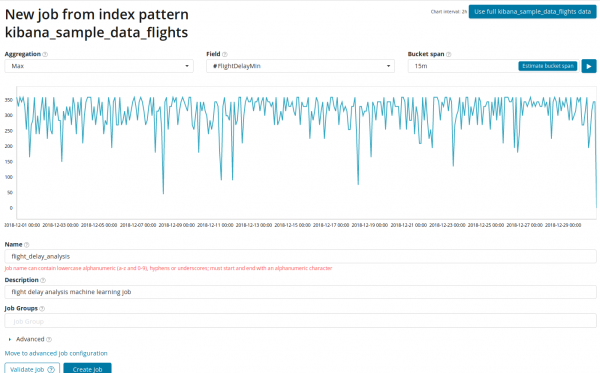
В полето Aggregation може да изберете подход за търсене на аномалии. Например, при Min аномалните ще се считат стойности под типичните. Има Max, High Mean, Low, Mean, Distinct и други. Описание на всички функции може да се види .
В полето Field посочва се числово поле в документа, по което ще провеждаме анализа.
В полето — грануларността на интервалите на времевата линия, по която ще се води анализ. Може да се доверите на автоматиката или да изберете ръчно. На изображението по-долу е показан пример за твърде ниска грануларност — може да пропуснете аномалия. С помощта на тази настройка можете да променяте чувствителността на алгоритъма към аномалии.
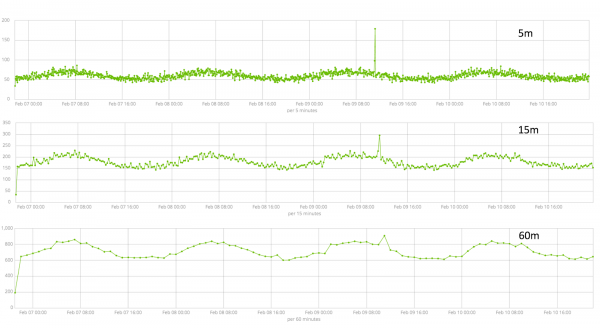
Продължителността на събраните данни — ключов фактор, който влияе на ефективността на анализа. При анализа алгоритъмът определя повтарящи се интервали, изчислява доверителния интервал (базови линии) и открива аномалии — нетипични отклонения от обичайното поведение на метриката. Просто за пример:
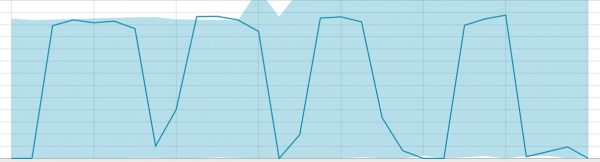
Основни линии при малък обем данни:
Когато алгоритъмът има на какво да се учи — основните линии изглеждат така:
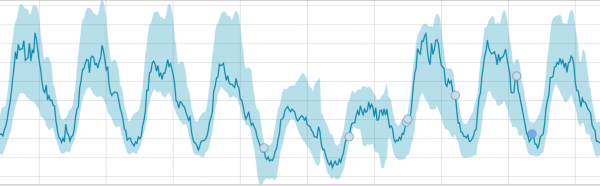
След стартиране на задачата, алгоритъмът определя аномални отклонения от нормата и ги подрежда по вероятност на аномалия (в скобите е посочен цветът на съответната етикет):
Warning (синьо): по-малко от 25
Minor (жълто): 25-50
Major (оранжево): 50-75
Critical (червено): 75-100
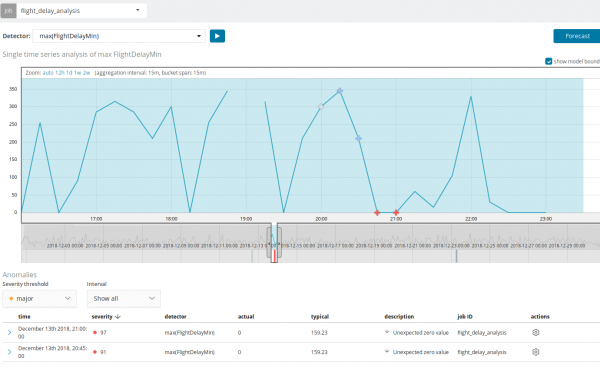
На графиката по-долу е даден пример с намерени аномалии.
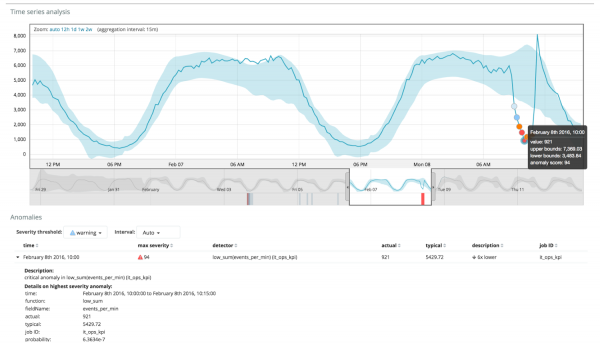
Тук се вижда числото 94, което обозначава вероятността за аномалия. Ясно е, че понеже стойността е близка до 100, пред нас има аномалия. В колоната под графиката е посочена минималната вероятност 0.000063634% за появата на стойност на метриката там.
Освен за намиране на аномалии в Kibana можете да стартирате прогнозиране. Това се прави елементарно и от същото представяне с аномалии — бутона Forecast в горния десен ъгъл.
Прогнозата се строи максимално на 8 седмици напред. Дори ако много искате — повече не може по дизайн.
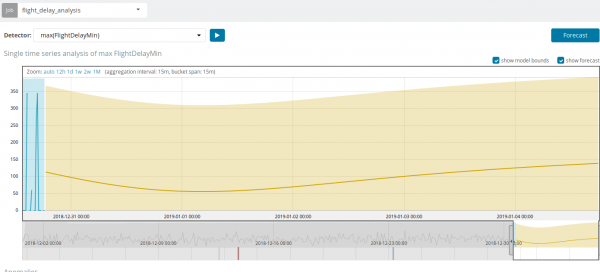
В някои ситуации прогнозата ще бъде много полезна, например, когато се следи потребителското натоварване на инфраструктурата.
Multi Metric
Преминаваме към следващата възможност за ML в Elastic Stack — анализа на няколко метрики в една партида. Но това не означава, че ще се анализира зависимостта на една метрика от друга. Това е същото, както и Single Metric, само че с множество метрики на един екран за удобство при сравнението на влиянието на една върху друга. За анализа на зависимостта на една метрика от друга ще разкажем в частта Population.
След натискане на квадрата с Multi Metric ще се появи прозорец с настройки. На тях ще се спрем по-подробно.
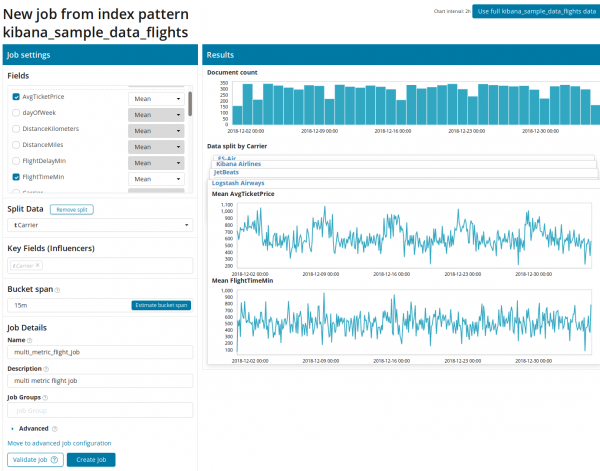
Първо трябва да изберете полета за анализ и агрегация на данни по тях. Вариантите за агрегация тук са същите, както при Single Metric (Max, High Mean, Low, Mean, Distinct и други). След това данните могат да бъдат разбити, по желание, по едно от полетата (поле Split Data). В примера ние направихме това по полето OriginAirportID. Обърнете внимание, че графикът на метриките вдясно сега е представен под формата на множество графици.
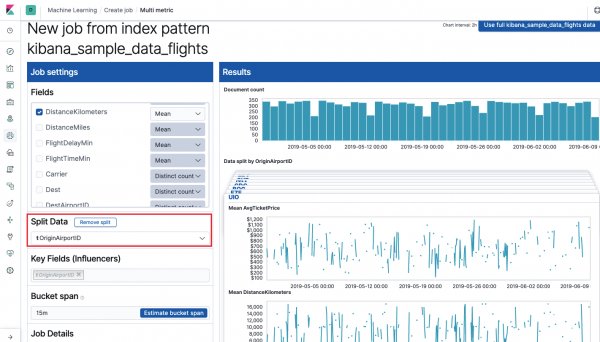
Поле Key Fields (Influencers) пряко влияе на намерените аномалии. По подразбиране тук винаги ще има поне една стойност, а вие можете да добавите допълнителни. Алгоритъмът ще отчита влиянието на тези полета при анализа и ще показва най-"влиятелните" стойности.
След стартиране в интерфейса на Kibana ще се появи приблизително такава картина.
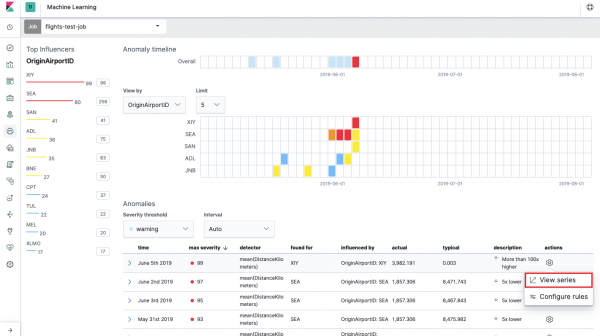
Това е т.н. топлинна карта на аномалиите по всяка стойност на полето OriginAirportID, което посочихме в Split Data. Както при Single Metric, цветът обозначава нивото на аномално отклонение. Подобен анализ може да се направи удобно, например, при работните станции, за да се проследи къде има подозрително много авторизации и т.н. Вече написахме , които също могат да се събират и анализират тук.
Под топлинната карта е списъкът с аномалии, от всяка може да се премине към представянето на Single Metric за детален анализ.
Population
С цел намиране на аномалии сред корелациите между различни метрики в Elastic Stack съществува специализиран анализ Population. Именно с негова помощ можем да търсим аномални стойности в производителността на определен сървър в сравнение с останалите, например при увеличение на броя заявки към целевата система.
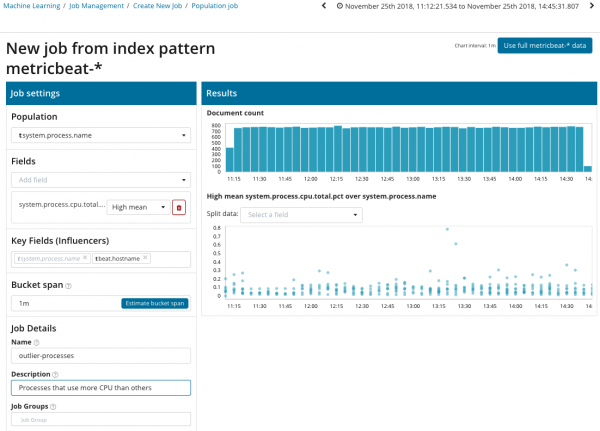
На тази илюстрация в полето Population е посочено стойността, към която ще се отнасят анализираните метрики. В случая това е името на процеса. В резултат ще видим как натоварването на процесора от всеки от процесите влияе един на друг.
Обърнете внимание, че графикът на анализираните данни се различава от случаите с Single Metric и Multi Metric. Това е направено в Kibana по дизайн за подобрено възприемане на разпределението на стойностите на анализираните данни.
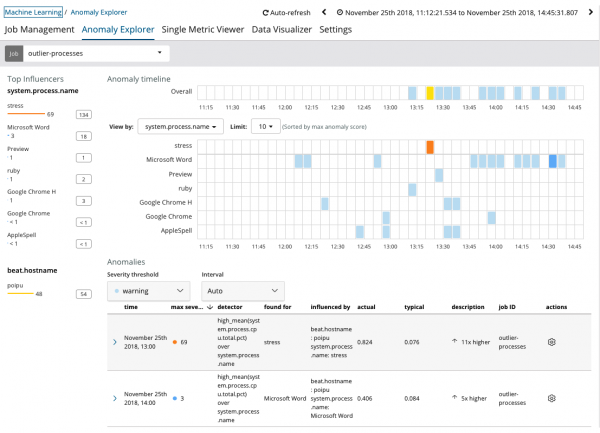
От графика става ясно, че процесът stress (между другото, генериран от специален инструмент) на сървъра poipu, е повлиял (или се е оказал инфлуенсър) на възникването на тази аномалия.
Advanced
Анализ с фина настройка. При Advanced анализа в Kibana се появяват допълнителни настройки. След натискане в менюто за създаване на плочката Advanced се отваря такова прозорче с раздели. Разделът Job Details беше пропуснат умишлено, там са основни настройки, които не се отнасят пряко към настройването на анализа.
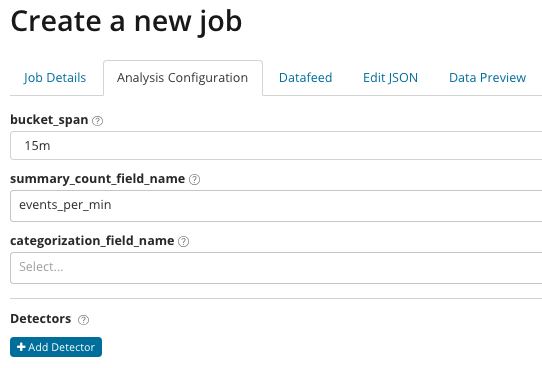
В summary_count_field_name по избор може да се посочи името на полето в документите, съдържащо агрегирани стойности. В този пример — брой на събитията в минута. В се посочва името на полето в документа, което съдържа променлива стойност. По маската на това поле могат да се разделят анализираните данни на подмножества. Обърнете внимание на бутона Add detector на предишната илюстрация. По-долу е резултатът от натискането на този бутон.
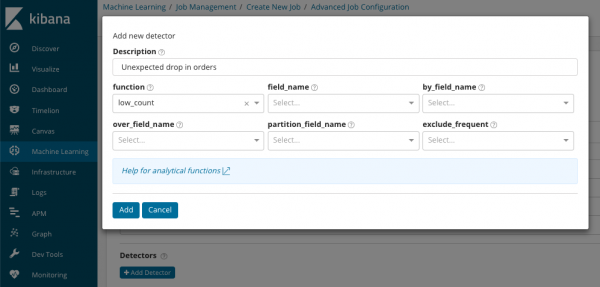
Тук е допълнителен блок настройки за конфигуриране на детектора на аномалии за конкретна задача. Конкретни случаи на употреба (особено в областта на сигурността) ще разгледаме в следващите статии. Например, един от разгледаните случаи. Той е свързан с откриването на рядко срещащи се стойности и се реализира .
В полето function може да изберете определена функция за търсене на аномалии. Освен rare, има и още няколко интересни функции — . Те разкриват аномалии в поведението на метриките в течение на деня или седмицата, съответно. Останалите функции за анализ .
В field_name посочва полето на документа, по което ще се извършва анализ. By_field_name може да се използва за разделяне на резултатите от анализа по всяка отделна стойност на посоченото тук поле на документа. Ако попълните over_field_name ще получите population-анализ, който разгледахме по-горе. Ако посочите стойност в partition_field_name, тогава по това поле на документа ще бъдат изчислени отделни основни линии за всяка стойност (като стойност може да служи, например, името на сървъра или процеса на сървъра). В exclude_frequent може да изберете all или none, което ще означава изключване (или включване) на често срещаните стойности на полетата на документите.
В статията се опитахме максимално стегнато да представим възможностите на машинното обучение в Elastic Stack, зад кадър останаха още много детайли. Кажете в коментарите какви случаи успяхте да решите с помощта на Elastic Stack и за какви задачи го използвате. За връзка с нас можете да използвате лични съобщения на Хъбра или .
Източник: habr.com
