

Как да прочетете тази статия: извинявайте, че текстът стана толкова дълъг и хаотичен. За да спестя вашето време, всяка глава започвам с въведението „Какво научих“, в което с едно-две изречения обобщавам същността на главата.
„Просто покажи решението!“ Ако искате просто да видите до какво стигнах, преминете към главата „Ставам по-изобретателен“, но смятам, че е по-интригуващо и полезно да се прочетат неуспехите.
Наскоро ми беше възложено да настроя процеса на обработка на голям обем от генетични последователности (технически това е SNP-чип). Трябваше бързо да получаваме данни за задано генетично местоположение (което се нарича SNP) за последващо моделиране и други задачи. С помощта на R и AWK успях да почистя и организирам данните по естествен начин, което значително ускори обработката на заявките. Това ми отне много усилия и изискваше многобройни итерации. Тази статия ще ви помогне да избегнете някои от моите грешки и ще покаже какво накрая постигнах.
Първо, някои въведителни пояснения.
Данни
Нашият университетски център за обработка на генетична информация ни предостави данни във формат TSV с обем от 25 TB. Получих ги разделени на 5 пакета, компресирани с Gzip, всеки от които съдържаше около 240 четиригигабайтни файла. Всеки ред съдържаше данни за един SNP на един човек. Общо бяха предадени данни за ~2,5 милиона SNP и ~60 хиляди души. Освен информацията за SNP в файловете имаше многобройни колони с числа, отразяващи различни характеристики, като интензивност на четене, честота на различни алели и т.н. Общо имаше около 30 колони с уникални стойности.
Цел
Както при всеки проект за управление на данни, най-важното беше да определим как ще се използват данните. В този случай в по-голямата си част ще подбираме модели и работни процеси за SNP на базата на SNP. Тоест, едновременно ще ни трябват данни само за един SNP. Трябваше да намеря начин да извличам всички записи, свързани с един от 2,5 милиона SNP, колкото се може по-просто, по-бързо и по-евтино.
Какво да не правя
Ще цитирам подходящата клише:
Не съм се провалил хиляда пъти, просто открих хиляда начина да не парсвам куп данни в удобен за заявки формат.
Първият опит
Какво научих: не съществува евтин начин да се парсират 25 Тб наведнъж.
След като слушах курса "Разширени методи за обработка на големи данни" в Университета Вандербилт, бях сигурен, че всичко ще се нареди. Може би час или два ще отнеме настройването на Hive-сървър, за да се пробегне през всичките данни и да се отчетат резултатите. Тъй като нашите данни се съхраняват в AWS S3, използвах услугата , която позволява прилагане на Hive SQL заявки към данните в S3. Не е нужно да се настройва/вдига Hive клъстер, а плащаш само за данните, които търсиш.
След като показах на Athena своите данни и формата им, пуснах няколко теста с подобни заявки:
select * from intensityData limit 10;И бързо получих добре структурирани резултати. Готово.
Докато не опитахме да използваме данните в работа...
Помолиха ме да извадя цялата информация по SNP, за да тествам модела на тях. Пуснах заявка:
select * from intensityData
where snp = 'rs123456';
…и започнах да чакам. След осем минути и повече от 4 Тб запитани данни получих резултата. Athena таксува по обем на намерените данни, по $5 за терабайт. Така че тази единствена заявка ми струваше $20 и осем минути чакане. За да се пусне моделът по всички данни, щеше да се наложи да чакам 38 години и да платя $50 милиона. Очевидно, това не ни устройваше.
Трябваше да се използва Parquet...
Какво научих: внимавайте с размера на вашите Parquet файлове и тяхната организация.
Първо опитах да поправя ситуацията, конвертирайки всички TSV в . Те са удобни за работа с големи набори от данни, защото информацията в тях се съхранява в колоночен вид: всяка колона лежи в собствен сегмент памет/диск, за разлика от текстовите файлове, в които редовете съдържат елементите на всяка колона. И ако трябва да се намери нещо, е достатъчно да се прочете необходимата колона. Освен това, в всеки файл в колоната се съхранява диапазон от стойности, така че, ако търсената стойност липсва в диапазона на колоната, Spark няма да губи време в сканиране на целия файл.
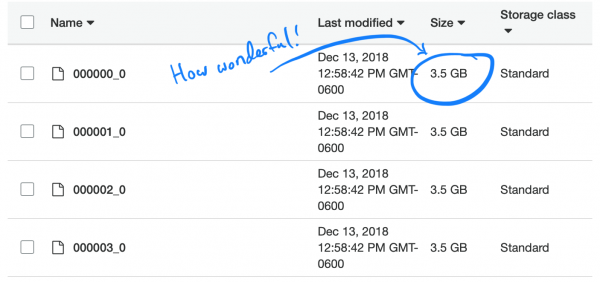
Пуснах проста задача за преобразуването на нашите TSV в Parquet и качването на нови файлове в Athena. Това отне около 5 часа. Но когато пуснах запитването, преминаването му отне приблизително толкова време и малко по-малко пари. Това, което стана, е, че Spark, опитвайки се да оптимизира задачата, просто разпакова един TSV част и го постави в собствен Parquet част. И тъй като всяка част беше достатъчно голяма и съдържаше цели записи на много хора, всеки файл съдържаше всички SNP, така че Spark трябваше да отвори всички файлове, за да извлече необходимата информация.
Любопитно е, че по подразбиране (и препоръчителен) тип компресия в Parquet — snappy, — не е разделяем (splitable). Затова всеки изпълнител (executor) зацикли на задачата за разопаковане и зареждане на пълния датасет от 3,5 Гб.
Разглеждаме проблема
Какво научих: трудно е да се сортира, особено ако данните са разпределени.
Стигнах до извода, че сега разбрах същността на проблема. Трябваше ми само да сортирам данните по колоната SNP, а не по хората. Тогава в отделна част от данните ще се съхраняват няколко SNP и „умната“ функция на Parquet „отваря само ако значението е в диапазона“ ще прояви себе си в цялата си слава. За съжаление, сортиране на милиарди редове, разпределени из клъстера, се оказа сложно предизвикателство.
Me taking algorithms class in college: «Ugh, no one cares about computational complexity of all these sorting algorithms»
Me trying to sort on a column in a 20TB table: «Why is this taking so long?» struggles.
— Nick Strayer (@NicholasStrayer)
AWS със сигурност не иска да върне парите поради причината «Аз съм разсеян студент». След като пуснах сортиране на Amazon Glue, то работи 2 дни и завърши с грешка.
Какво ще кажеш за партициониране?
Какво научих: партициите в Spark трябва да са балансирани.
След това ми дойде на ум идеята да партиционирам данните по хромозоми. Има 23 от тях (и още няколко, ако вземем предвид митохондриалната ДНК и неопределените области).
Това ще позволи разделянето на данните на по-малки порции. Ако добавя в Spark функцията за експортиране в скрипта Glue само една редица partition_by = "chr", данните трябва да бъдат разпределени в кофи (buckets).
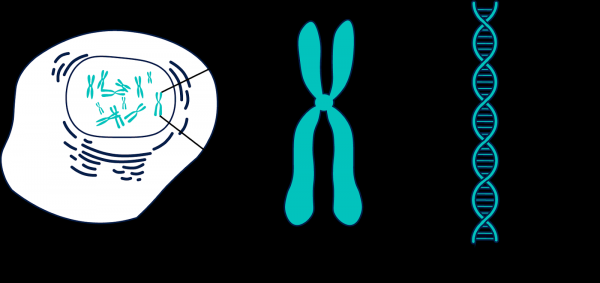
Геномът се състои от многобройни фрагменти, наречени хромозоми.
За съжаление, това не сработи. Хромозомите имат различни размери, което означава и различно количество информация. Това значи, че задачите, които Spark изпращаше на работниците, не бяха балансирани и се изпълняваха бавно, тъй като някои възли завършваха по-рано и оставаха без дейност. Все пак задачите бяха изпълнени. Но при запитването на един SNP, несбалансираността отново стана причина за проблеми. Цената за обработка на SNP в по-големите хромозоми (т.е. от там, откъдето искаме да получим данни) намаля само около 10 пъти. Много, но недостатъчно.
Ами ако разделим на още по-малки партиции?
Какво научих: никога не се опитвайте да правите 2,5 милиона партиции.
Реших да отида до край и партиционирах всеки SNP. Това гарантира еднакъв размер на партициите. БЕШЕ ЛОША ИДЕЯ. Използвах Glue и добавих невинна стринга partition_by = 'snp'. Задачата стартира и започна да се изпълнява. Ден по-късно проверих и видях, че в S3 все още не е записано нищо, затова убих задачата. Изглежда, че Glue е записвал промеждутъчни файлове на скрито място в S3 и много файлове, вероятно около два милиона. В резултат на това, моята грешка ми струваше над хиляда долара и не зарадва моя ментор.
Партициониране + сортиране
Какво научих: все още е трудно да се сортира, както и да се настрои Spark.
Последният ми опит за партициониране беше, че партиционирах хромозомите и след това сортирах всяка партиция. Теоретично, това щеше да ускори всяко запитване, защото желаните данни за SNP трябваше да бъдат в рамките на няколко Parquet-чанкове в зададения диапазон. За съжаление, сортирането дори на партиционирани данни се оказа трудна задача. В резултат на това преминах на EMR за персонализиран кластер и използвах осем мощни инстанса (C5.4xl) и Sparklyr, за да създам по-гъвкава работна среда…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…въпреки това задачата все още не беше изпълнена. Настройвах по всякакъв начин: увеличавах отделената памет за всеки изпълнител на запитвания, използвах възли с по-голям обем памет, прилагах широковещателни променливи (broadcasting variable), но всеки път това се оказваха полумери, и постепенно изпълнителите започваха да се провалят, докато всичко не спря.
Update: започва.
— Nick Strayer (@NicholasStrayer)
Става все по-изобретателен
Какво научих: понякога специфичните данни изискват специализирани решения.
Всяко SNP има значение на позиция. Това е число, което съответства на броя на основите, разположени по хромозомата му. Това е добър и естествен начин за организиране на данните ни. Първоначално исках да направя партициониране по области на всяка хромозома. Например, позиции 1 — 2000, 2001 — 4000 и т.н. Но проблемът е, че SNP са разпределени неравномерно по хромозомите, затова размерът на групите ще варира значително.
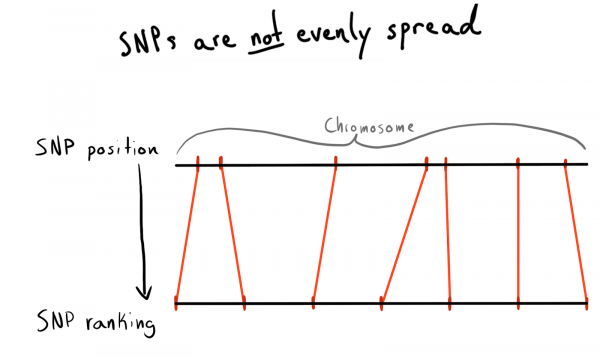
В резултат на това стигнах до категориално разпределение (rank) на позициите. С данните, които вече бяха заредени, изпълних заявка за получаване на списък с уникални SNP, техните позиции и хромозоми. След това сортирах данните в рамките на всяка хромозома и групирах SNP в групи (bin) с зададен размер. Да кажем, по 1000 SNP. Това ми даде връзката между SNP и групата в хромозомата.
В крайна сметка направих групи (bin) по 75 SNP, причината ще обясня по-долу.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Първият опит със Spark
Какво научих: обединението в Spark работи бързо, но партиционирането все още е скъпо.
Исках да прочета този малък (2,5 млн. реда) фрейм данни в Spark, да го обединя с необработените данни и след това да го партиционирам по новосъздадената колона. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Използвах sdf_broadcast(), по този начин Spark разбира, че трябва да изпрати фрейма данни на всички възли. Това е полезно, ако данните са малки и необходими за всички задачи. В противен случай Spark се опитва да бъде умен и разпределя данните при нужда, което може да доведе до забавяния.
И отново моята идея не сработи: задачите работеха известно време, завършваха обединението, а след това, подобно на изпълнителите с партициониране, започнаха да се провалят.
Добавям AWK
Какво научих: не спете, когато ви учат основите. Някой със сигурност вече е решил проблема ви още през 80-те години.
До този момент причината за всичките ми неуспехи със Spark беше разбъркването на данните в кластера. Може би ситуацията може да се подобри с предварителна обработка. Реших да опитам да разделя необработените текстови данни на колони на хромозомите, така се надявах да предоставя на Spark 'предварително партиционирани' данни.
Потърсих в StackOverflow как да разделя по стойности на колони и намерих С AWK можете да разделите текстов файл по стойности на колоните, записвайки скрипт, а не изпращайки резултатите в stdout.
За проба написах Bash-скрипт. Свалих един от опакованите TSV, след което го разпаковах с помощта на gzip и изпратих в awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30">"chunked/"$chr"_chr"$15".csv"}'
Проработи!
Запълване на ядрата
Какво научих: gnu parallel — това е магическо нещо, всеки трябва да го използва.
Разделянето ставаше доста бавно, и когато стартирах htop, за да проверя използването на мощен (и скъп) EC2-инстанс, установих, че използвам само едно ядро и около 200 MB памет. За да реша проблема и да не изгубя много пари, трябваше да измисля как да паралелирам работата. За щастие, в напълно невероятната книга на Джерона Джансенса намерих глава, посветена на паралелизацията. От нея научих за gnu parallel, много гъвкав метод за реализиране на многопоточност в Unix.
Когато стартирах разделянето с помощта на новия процес, всичко беше прекрасно, но оставаше тясно място — свалянето на S3-обектите на диск не беше много бързо и не беше напълно паралелизирано. За да го поправя, направих следното:
- Разбрах, че може да се реализира етапа на S3 сваляне директно в конвейера, напълно изключвайки междинното съхраняване на диска. Това означава, че мога да избегна записването на сурови данни на диск и да използвам още по-малко, а следователно и по-евтино съ хранилище на AWS.
- С командата
aws configure set default.s3.max_concurrent_requests 50значително увеличих броя на нишките, които използва AWS CLI (по подразбиране са 10). - Преминах на инстанс EC2, оптимизиран за скорост на мрежата, с буквата n в името. Установих, че загубата на изчислителна мощност при използване на n-инстанси с лихва се компенсира от увеличението на скоростта на поместване. За повечето задачи използвах c5n.4xl.
- Смених
gzipна , това е gzip инструмент, който може да прави страхотни неща за паралелизиране на първоначално непаралелизирана задача по разопаковане на файлове (това помогна най-малко).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Тези стъпки са комбинирани помежду си, за да работят много бързо. Благодарение на увеличената скорост на сваляне и отказването от запис на диск, сега можех да обработя 5-тербайтов пакет само за няколко часа.
Няма нищо по-сладко от това да видиш всички ядра, за които плащаш в AWS, да бъдат използвани. Благодарение на gnu-parallel мога да разархивирам и разделям 19GB CSV точно толкова бързо, колкото мога да го изтегля. Не успях дори да накарам Spark да работи с това.
— Nick Strayer (@NicholasStrayer)
В този туит трябваше да се споменава 'TSV'. Уви.
Използване на повторно парсирани данни
Какво научих: Spark обича некомпресирани данни и не обича да комбинира партиции.
Сега данните бяха в S3 в некомпресиран (четлив, разделен) и полуорганизиран формат, и можех отново да се върна към Spark. Очакваше ме изненада: отново не успях да постигна желания резултат! Беше много трудно да кажа на Spark как са партиционирани данните. И дори когато го направих, се оказа, че партициите са твърде много (95 хиляди) и когато с помощта на coalesce намалих броя им до разумни граници, това наруши моето партициониране. Сигурен съм, че може да се поправи, но след няколко дни търсене не успях да намеря решение. В крайна сметка завърших всички задачи в Spark, въпреки че отне време, а моите разделени Parquet файлове не бяха много малки (~200 КБ). Но данните бяха там, където трябваше да бъдат.
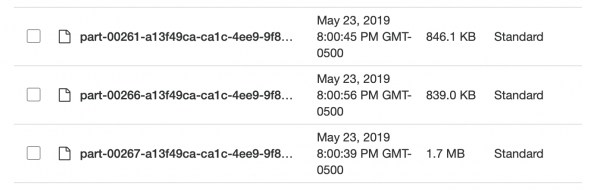
Твърде малки и нееднакви, чудесно!
Тестване на локални Spark заяви
Какво научих: в Spark има прекалено много разходи при решаване на прости задачи.
Като заредих данните в добре обмислен формат, успях да тествам скоростта. Настроих скрипт на R, за да стартирам локален Spark сървър, а след това заредих Spark DataFrame от указаното Parquet хранилище (бини). Опитах се да заредя всички данни, но не успях да накарам Sparklyr да разпознае партиционирането.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Стартирайте таймер
start_time <- Sys.time()

# Заредете желаното бин в Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Подразделете бин на snp и след това съберете локално
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
Изпълнението отне 29.415 секунди. Значително по-добре, но не достатъчно добре за масово тестване на нещо. Освен това не можах да ускоря работата с кеширане, защото, когато опитвах да кеширам DataFrame в паметта, Spark винаги се сриваше, дори когато отделих повече от 50 GB памет за набор от данни, който тежеше под 15.
Връщане към AWK
Какво научих: асоциативните масиви в AWK са много ефективни.
Знаех, че мога да постигна по-висока скорост. Спомних си за удивителното Четох за страхотна функция, която се нарича «». По същността си, това са двойки ключ-стойност, които по някаква причина в AWK са наречени по друг начин и затова не съм се сещал за тях особено. ми напомни, че терминът «асоциативни масиви» е много по-стар от термина «пара ключ-стойност». Дори ако в , този термин няма да го видите, но ще намерите асоциативни масиви! Освен това, «пара ключ-стойност» най-често се асоциира с бази данни, затова е много по-логично да се сравнява с hashmap. Разбрах, че мога да използвам тези асоциативни масиви, за да свържа моите SNP с таблицата на групите (bin table) и суровите данни без използване на Spark.
За това в AWK-скрипта използвах блока BEGIN. Това е фрагмент код, който се изпълнява преди първият ред данни да бъде предаден на основното тяло на скрипта.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Екип while(getline...) зареди всички редове от CSV на групата (bin), зададе първата колона (името на SNP) като ключ за асоциативния масив bin и втората стойност (група) като стойност. След това в блока { }, който се изпълнява за всички редове от основния файл, всеки ред се изпраща в изходния файл, получаващ уникално име в зависимост от неговата група (bin): ..._bin_"bin[$1]"_....
Променливи batch_num и chunk_id отговаряха на данните, предоставени от конвейера, което позволи да се избегне състояние на гонка и всеки изпълнителен поток, стартиран parallel, пишеше в собствен файл с уникално име.
Тъй като всичките мои сурови данни бяха разпределени по папки по хромозоми, останали след предишния ми опит с AWK, сега можех да напиша друг Bash-скрипт, за да обработвам по хромозома едновременно и да подавам в S3 по-дълбоко партиционирани данни.
DESIRED_CHR='13'

# Изтегли данни за хромозома от s3 и раздели на бинове
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Обедини всички процеси от паралелно изпълнение в един файл и ги качи на rds, използвайки R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
В скрипта има два раздела parallel.
В първата част се четат данни от всички файлове, съдържащи информация за необходимата хромозома, след което тези данни се разпределят по потоци, които разпределят файловете в съответните групи (bin). За да не възникне състезателно състояние, при което няколко потока записват в един файл, AWK предава имената на файловете за запис на данни на различни места, например, chr_10_bin_52_batch_2_aa.csv. В резултат на диска се създават множество малки файлове (за това използвах терабайтни EBS томове).
Конвейерът от втората част parallel преминава през групите (bin) и обединява техните отделни файлове в общи CSV с cat, а след това ги изпраща за експортиране.
Предаване в R?
Какво научих: можете да се обърнете към stdin и stdout от R-скрипта, а следователно и да го използвате в конвейера.
В Bash скрипта може би сте забелязали следния ред: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Той предава всички конкатенирани файлове на групата (bin) в следния R-скрипт. {} е специална методика parallel, която всякакви данни, които тя изпраща в указания поток, вмъква направо в самата команда. Опцията {#} предоставя уникален ID на потока на изпълнение, а {%} представлява номер на слота на задачата (повтаря се, но никога едновременно). Списък на всички опции можете да намерите в
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Когато променливата file("stdin") се предава в readr::read_csv, данните, предадени в R-скрипта, се зареждат в рамка, която след това под формата на .rds-файл с помощта на aws.s3 се записва директно в S3.
RDS е нещо като по-малка версия на Parquet, без изисканите характеристики на колонното хранилище.
След завършването на Bash скрипта получих купчина .rds-файлове, лежащи в S3, което ми позволи да използвам ефективно компресиране и вградени типове.
Въпреки че използвах бавен R, всичко работеше много бързо. Не е изненада, че фрагментите на R, отговорни за четене и запис на данни, са добре оптимизирани. След тестване на една хромозома със среден размер, задачата се изпълни на инстанция C5n.4xl за около два часа.
Ограничения S3
Какво научих: благодарение на умната реализация на пътищата, S3 може да обработва много файлове.
Бях загрижен дали S3 ще може да обработи множество файлове, изпратени към нея. Можех да направя имената на файловете смислени, но как S3 ще ги търси?
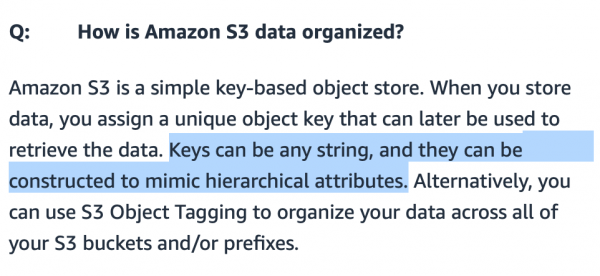
Папките в S3 са просто за красота, в действителност системата не я интересува символ /.
Изглежда, S3 представя пътя до конкретен файл под формата на прост ключ в своеобразна хеш-таблица или база данни, основана на документи. Бакетът може да се счита за таблица, а файловете — за записи в тази таблица.
Тъй като скоростта и ефективността са важни за печалбата в Amazon, не е изненада, че тази система "ключ-в-като-път-к-файла" е страхотно оптимизирана. Опитвах се да намеря баланс: да не е необходимо да правя множество get-запитвания, но да се извършват бързо. Оказа се, че е най-добре да се правят около 20 хиляди bin-файла. Мисля, че ако продължа с оптимизацията, мога да постигна увеличение на скоростта (например, да направя специален бакет само за данни, по този начин намалявайки размера на търсещата таблица). Но за по-нататъшни експерименти просто нямаха време и средства.
Какво е положението с кръстосаната съвместимост?
Какво научих: главната причина за загуба на време е преждевременната оптимизация на метода ви за съхранение.
В този момент е много важно да се запитате: "Защо да използвате собствен файлов формат?" Причината се крие в скоростта на зареждане (компресираните gzip CSV-файлове се зареждаха 7 пъти по-дълго) и съвместимостта с работните ни потоци. Мога да преразгледам решението си, ако R може лесно да зарежда Parquet (или Arrow) файлове без натоварване от Spark. В нашата лаборатория всички използват R, и ако ми се наложи да конвертирам данните в друг формат, все още разполагам с оригиналните текстови данни, така че мога просто да пусна конвейера отново.
Разделение на работата
Какво научих: не се опитвайте да оптимизирате задачите ръчно, оставете компютъра да го направи.
Отладих работния поток на една хромозома, сега е необходимо да обработя всички останали данни.
Исках да стартирам няколко инстанса EC2 за преобразуване, но в същото време се опасявах да не получа изключително неbalanced натоварване в различни задачи за обработка (подобно на това, как Spark страда от неbalanced партиции). Освен това, не ми се искаше да стартирам по един инстанс за всяка хромозома, защото за AWS акаунтите има ограничение по подразбиране от 10 инстанса.
Тогава реших да напиша на R скрипт за оптимизиране на задачите за обработка.
Първо помолих S3 да изчисли колко място в хранилището заема всяка хромозома.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Извлекаем хромосому из имени файла
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Делим, чтобы получить размер в ГБ


# Тиббл: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … с 17 дополнительными строками
Следующим шагом я написал функцию, которая берёт общий размер, перемешивает порядок хромосом и делит их на группы num_jobs и сообщает, насколько различаются размеры всех заданий на обработку.
num_jobs <- 7
# Каков был бы размер каждого задания, если бы они были равномерно распределены?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# Тиббл: 1 x 2
     sd data

1  153.
Затем я прогнал с помощью purrr тысячу перемешиваний и выбрал лучшее.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Таким образом, я получил набор заданий, очень схожих по размеру. Затем оставалось только обернуть мой предыдущий Bash-скрипт в большой цикл. for. На написание этой оптимизации ушло около 10 минут. Это намного меньше времени, чем я потратил бы на ручное создание заданий в случае их несбалансированности. Поэтому я считаю, что с этой предварительной оптимизацией я не прогадал.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Код для обработки одной хромосомы
fi
В конце я добавляю команду выключения:
sudo shutdown -h now … и у меня всё получилось! С помощью AWS CLI я разворачивал инстансы и передавал им Bash-скрипты для обработки заданий через опцию user_data они выполнялись и автоматически выключались, поэтому я не платил за излишнюю вычислительную мощность.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Упаковываем!
Какво научих: API должен быть простым ради удобства и гибкости использования.
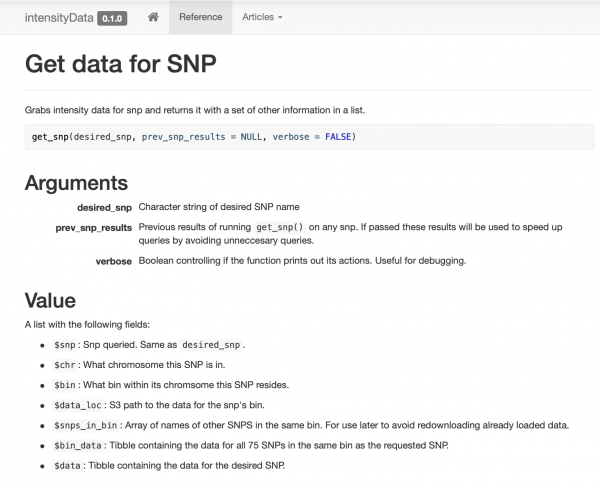
Наконец-то я получил данные в нужном месте и формате. Теперь осталось упростить процесс работы с данными, чтобы моим коллегам было легче. Я хотел создать простой API для формирования запросов. Если в будущем я решу перейти с .rds Ако става въпрос за Parquet файлове, това трябва да бъде проблем за мен, а не за колегите. Затова реших да направя вътрешен R пакет.
Събрах и документирах много прост пакет, съдържащ само няколко функции за достъп до данните, събрани около функцията get_snp. Също така направих за колегите сайт , за да могат лесно да видят примери и документация.
Интелигентно кеширане
Какво научих: ако вашите данни са добре подготвени, кеширането ще бъде лесно!
Тъй като един от основните работни потоци прилагаше същия аналитичен модел за пакета SNP, реших да използвам групиране (binning) в моя полза. Когато предавам данни за SNP, към върнатия обект се прикрепя и всяка информация от групата (bin). Тоест старите заявки могат (в теоретичен аспект) да ускорят обработката на новите заявки.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
При сглобяването на пакета направих много бенчмаркове, за да сравня скоростта при използване на различни методи. Препоръчвам да не се пренебрегва, защото понякога резултатите са неочаквани. Например, dplyr::filter се оказа много по-бързо за улавяне на редове чрез филтриране на базата на индексиране, а получаването на една колона от филтрираната рамка с данни работеше много по-бързо от прилагането на синтаксис на индексирането.
Обърнете внимание, че обектът prev_snp_results съдържа ключа snps_in_bin. Това е масив от всички уникални SNP в групата (bin), позволяващ бърза проверка дали вече имаме данни от предишната заявка. Освен това опростява цикличния достъп до всички SNP в групата (bin) с този код:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Резултати
Сега можем (и започнахме сериозно) да тичаме модели и сценарии, които преди не бяха достъпни за нас. Най-доброто е, че на колегите ми в лабораторията не им се налага да мислят за всякакви сложности. Те просто имат работеща функция.
И макар пакетът да ги освобождава от детайлите, се опитвах да направя формата на данните достатъчно прост, за да могат да се разберат, ако утре изведнъж изчезна...
Скоростта значително нарасна. Обикновено сканираме функционално значими фрагменти от генома. Преди не можехме да го правим (беше твърде скъпо), но сега, благодарение на груповата (bin) структура и кеширане, на заявка за един SNP отнема средно по-малко от 0.1 секунди, а използването на данни е толкова ниско, че разходите за получаването им са смешно малки.
Наскоро поехах да управлявам с повече от 25 TB сурови генетични данни за моята лаборатория. Когато започнах, използването на Spark отнемаше 8 минути и струваше 20 долара, за да се запитам за SNP. След като използвах AWK + за обработка, сега отнема по-малко от десета от секундата и струва 0.00001 долара. Личният ми успех.
— Nick Strayer (@NicholasStrayer)
Заключение
Тази статия не е ръководство. Решението се оказа индивидуално и почти сигурно не е оптимално. По-скоро е разказ за пътуването. Искам другите да разберат, че подобни решения не се появяват напълно оформени в главата, а са резултат от проби и грешки. Освен това, ако търсите специалист по анализ на данни, имайте предвид, че за ефективното използване на тези инструменти е нужно опит, а опитът изисква средства. Щастлив съм, че имах средства за заплащане, но много други, които могат да свършат същата работа по-добре от мен, никога няма да имат такава възможност заради липсата на средства дори за опит.
Инструментите за големи данни са универсални. Ако имате време, почти със сигурност можете да напишете по-бързо решение, ако приложите „умно“ почистване на данни, хранилище и методи за извличане. В крайна сметка всичко се свежда до анализ на разходите и ползите.
Какво научих:
- не съществува евтин начин да се обработят 25 TB наведнъж;
- внимавайте с размера на вашите Parquet файлове и тяхната организация;
- партициите в Spark трябва да бъдат балансирани;
- никога не се опитвайте да създавате 2.5 милиона партиции;
- сортирането все още е трудно, както и настройването на Spark;
- понякога специални данни изискват специални решения;
- обединението в Spark работи бързо, но партиционирането все още е скъпо;
- не спите, когато ви преподават основи, със сигурност някой вече е решил проблема ви още през 80-те;
gnu parallel— това е магическа вещ, всички трябва да я използват;- Spark обича несжатите данни и не обича да комбинира партиции;
- в Spark има твърде много разходи за изпълнение на прости задачи;
- асоциативните масиви в AWK са много ефективни;
- можете да получите достъп до
stdinиstdoutот R-скрипт, което означава да го използвате в работния поток; - благодарение на умната реализация на S3 пътища, можете да обработвате много файлове;
- главната причина за загуба на време е преждевременната оптимизация на вашия метод на съхранение;
- не се опитвайте да оптимизирате задачите ръчно, оставете компютъра да го направи;
- API-то трябва да бъде просто заради простотата и гъвкавостта на използването;
- ако вашите данни са добре подготвени, кеширането ще бъде лесно!
Източник: habr.com
