

Въведение
Информационната система от гледна точка на потребителя е добре дефинирана в ГОСТ РВ 51987 — „автоматизирана система, чийто резултат от функционирането е представянето на изходна информация за последващо използване“. Ако разгледаме вътрешната структура, всъщност всяка ИС е система от взаимосвързани алгоритми, реализирани в код. В широко разбиране на тезиса на Тюринг-Чърч, алгоритъмът (и следователно ИС) извършва трансформация на множество входни данни в множество изходни данни.
Може дори да се каже, че в трансформацията на входните данни се състои смисълът на съществуването на информационната система. Съответно, стойността на ИС и целия комплекс от ИС се определя чрез стойността на входните и изходните данни.
Изхождайки от това, проектирането трябва да започне и да взема за основа данните, приспособявайки архитектурата и методите към структурата и значимостта на данните.
Съхранявани данни
Ключов етап в подготовката за проектиране е получаването на характеристики на всички набори данни, които ще се обработват и съхраняват. Тези характеристики включват:
— Обем на данните;
— Информация за жизнения цикъл на данните (прираст на нови данни, срок на живот, обработка на остарели данни);
— Класификация на данните от гледна точка на въздействието върху основния бизнес на компанията (т.е. триадата конфиденциалност, цялостност, достъпност) заедно с финансовите показатели (напр. разходи за загуба на данни на последния час);
— География на обработката на данни (физическо разположение на системите за обработка);
— Изисквания на регулатори за всеки клас данни (напр. ФЗ-152, PCI DSS).
Информационни системи
Данните не само се съхраняват, но и се обработват (трансформират) от информационни системи. Следващата стъпка след получаване на характеристиките на данните е максимално пълна инвентаризация на информационните системи, техните архитектурни особености, взаимозависимости и изисквания към инфраструктурата в условни единици по четирите вида ресурси:
— Процесорна изчислителна мощност;
— Обем на оперативната памет;
— Изисквания към обема и производителността на системата за съхранение на данни;
— Изисквания към мрежата за предаване на данни (външни канали, канали между компонентите на ИС).
Изискванията за всеки сервис/микросервис в рамките на ИС трябва да бъдат налични.
Отделно е необходимо да се отбележи наличието на информация за влиянието на ИС върху основния бизнес на компанията, под формата на стойност на престоя на ИС (рубли на час).
Модел на заплахите
Задължително трябва да бъде налична формална модел на заплахи, от които се планира да се защитят данни/услуги. Моделът на заплахите включва не само аспекти на конфиденциалността, но и на целостта и наличността. Т.е. например:
— Повреда на физическия сървър;
— Повреда на комутатора top-of-the-rack;
— Прекъсване на оптичния канал между ЦОД;
— Повреда на оперативната СХД като цяло.
В някои случаи моделите на заплахи се пишат не само за инфраструктурни компоненти, но и за конкретни ИС или техни компоненти, като например отказ на СУБД с логическо разрушаване на структурата на данните.
Всички решения в рамките на проекта за защита срещу неописаната заплаха са излишни.
Изисквания на регулаторите
Ако обработваните данни попадат под действие на специални правила, установявани от регулаторите, задължително е наличието на информация за набори от данни и правила за обработка/съхранение.
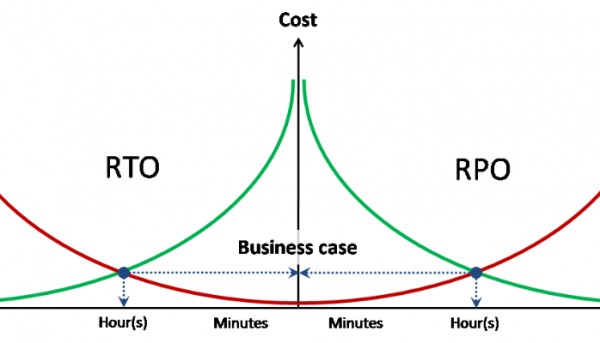
Целеви показатели RPO/RTO
Проектирането на всякакъв вид защита изисква наличието на показатели за целева загуба на данни и целево време за възстановяване на услугата за всяка от описаните заплахи.
При идеални условия RPO и RTO трябва да имат асоциирани стойности за загуба на данни и престой за единица време.
Разделение на ресурси в пулове
След събиране на цялата първоначална информация, първата стъпка е групиране на набори от данни и ИС в пулове, на базата на модели на заплахи и изисквания на регулаторите. Определя се видът на разделение на различни пулове - софтуерно на ниво системен софтуер или физически.
Примери:
— Контур, обработващ лични данни, е напълно физически отделен от останалите системи;
— Резервните копия се съхраняват на отделна СХД.
При това пуловете могат да имат непълна независимост, например, определят се два пула изчислителни ресурси (процесорна мощност + оперативна памет), които използват единен пул за съхранение на данни и единен пул за ресурси за предаване на данни.
Процесорна мощност
Абстрактните нужди от процесорна мощност на виртуализирания ЦОД се измерват в броя виртуални процесори (vCPU) и коефициента на тяхната консолизация върху физическите процесори (pCPU). В конкретния случай 1 pCPU = 1 физическо ядро на процесор (без да се отчитат Hyper-Threading). Броят на vCPU се сумира от всички конкретно определени ресурси (всеки от които може да има свой коефициент на консолизация).
Коефициентът на консолизация за натоварени системи се получава емпирично, въз основа на вече съществуващата инфраструктура, или при пилотна инсталация и стрес тестове. За ненатоварени системи се прилагат „добрите практики“. В частност, VMware определя среден коефициент 8:1.
Оперативна памет
Общата необходимост от оперативна памет се получава чрез просто сумиране. Използването на преразпределение на оперативната памет не се препоръчва.
Ресурси за съхранение
Изискванията по ресурсите за съхранение се получават чрез просто сумиране на всички пулове по обем и производителност.
Изискванията по производителност се изразяват в IOPS в съчетание със средното съотношение четене/писане и при необходимост с максималната забавяне на отговора.
Отделно трябва да бъдат посочени изискванията за качество на обслужването (QoS) за конкретни пулове или системи.
Ресурси за мрежова предавателна способност
Изискванията по мрежовата предавателна способност се получават чрез просто сумиране на всички пулове на пропускната способност.
Отделно трябва да бъдат посочени изискванията за качество на обслужването (QoS) и забавяния (RTT) за конкретни пулове или системи.
Във връзка с изискванията за ресурсите на мрежовата предавателна способност се посочват също изискванията за изолация и/или шифроване на мрежовия трафик и предпочитаните механизми (802.1q, IPSec и др.).
Избор на архитектура
В рамките на това ръководство не се разглежда друг избор освен архитектурата x86 и 100% виртуализация на сървърите. Следователно изборът на архитектура на изчислителната подсистема се свежда до избора на платформа за виртуализация на сървърите, форм-фактор на сървърите и общи изисквания за конфигурация на сървърите.
Ключовият момент при избора е определеността в използването на класическия подход с разделение на функции за обработка, съхранение и предаване на данни или конвергентен.
Класическа архитектура предполагава използването на интелигентни външни системи за съхранение и предаване на данни, докато сървърите допринасят за общия пул от физически ресурси само с процесорната мощ и оперативната памет. В краен случай сървърите стават напълно анонимни, без свои дискове и дори без системен идентификатор. В този случай се използва зареждане на ОС или хипервизор от вградени флаш носители или от външна система за съхранение на данни (boot from SAN).
В рамките на класическата архитектура изборът между блейд (blade) и стелажни (rack) се извършва преди всичко на базата на следните принципи:
— Икономическа ефективност (в средно стелажните сървъри са по-евтини);
— Изчислителна плътност (при блейдите е по-висока);
— Енергийна консумация и топлинно отделяне (при блейдите е по-висока на единица);
— Масштабируемост и управляемост (блейдите изискват по-малко усилия при големи инсталации);
— Използване на разширителни карти (за блейдите е много ограничен избор).
Конвергентна архитектура (известна също като хиперконвергентна) предполага съвместяване на функции за обработка и съхранение на данни, което води до използването на локални дискове на сървърите и следователно до отказ от форм-фактора на класическите блейдове. За конвергентни системи се използват или стелажни сървъри, или клъстерни системи, обединяващи в едно шаси няколко блейд сървъра и локални дискове.
CPU / Памет
За коректно изчисление на конфигурацията е необходимо да се разбере типът натоварване за средата или всеки от независимите клъстери.
CPU bound – среда, ограничена по производителност до процесорната мощ. Добавянето на оперативна памет нищо няма да промени по отношение на производителността (броя на ВМ на сървъра).
Memory bound – среда, ограничена до оперативната памет. По-голямото количество оперативна памет на сървъра позволява да се стартира повече ВМ на сървъра.
GB / MHz (GB / pCPU) – средно съотношение на потребление на оперативна памет и процесорна мощ за конкретна натовареност. Може да се използва за изчисление на необходимия обем памет при зададена производителност и обратно.
Изчисление на конфигурацията на сървера
Първо трябва да се определи всичките видове натоварване и да се вземе решение за обединяване или разделяне на различни изчислителни пулове по различни клъстери.
След това, за всеки от определените клъстери, се определя съотношението GB / MHz при познато предварително натоварване. Ако натоварването не е познато предварително, но има приблизителна представа за нивото на натоварване на процесорната мощ, може да се използват стандартни коефициенти vCPU:pCPU за преобразуване на изискванията на пуловете в физически.
За всеки клъстер, сумата на изискванията на пуловете vCPU се дели на коефициента:
vCPUсумм / vCPU:pCPU = pCPUсумм – необходимо количество физически ядра
pCPUсумм / 1.25 = pCPUht – брой ядра с поправка за Hyper-Threading
Да предположим, че е необходимо да се направи изчисление за клъстер с 190 ядра / 3.5TB RAM. При това приемаме целево 50% натоварване на процесорната мощ и 75% за оперативната памет.
pCPU
190
CPU util
50%
Mem
3500
Mem util
75%
Socket
Ядро
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
В този случай винаги използваме закръгляване нагоре до най-близкото цяло число (=ROUNDUP(A1;0)).
От таблицата става очевидно, че балансираните по целевите показатели конфигурации на сървърите са няколко:
— 26 сървъра 2*6c / 192 GB
— 19 сървъра 2*10c / 256 GB
— 10 сървъра 2*18c / 512 GB
Изборът от тези конфигурации в последствие трябва да се прави, основавайки се на допълнителни фактори, като например топлинния пакет и наличното охлаждане, вече използвани сървъри или цената.
Специфики на избора на конфигурация на сървъра
Широки ВМ. При нужда от разполагане на широки ВМ (сравними с 1 узел NUMA и повече) се препоръчва, по възможност, да се избере сървър с конфигурация, позволяваща на тези ВМ да останат в границите на NUMA узел. При голям брой широки ВМ възниква опасност от фрагментация на ресурсите на клъстера, и в този случай се избират сървъри, позволяващи разполагането на широки ВМ максимално плътно.
Размер на домейна на единичната повреда.
Изборът на размера на сървъра също се извършва от принципа на минимизиране на домейна на единичната повреда. Например, при избор между:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
При иначе равни условия е необходимо да се избере вторият вариант, тъй като при изключване на един сървър (или обслужване) се губят не 33% от ресурсите на клъстера, а 17%. По същия начин се намалява наполовина броят на ВМ и ИС, на които се е отразила аварията.
Изчисление на класическата СХД спрямо производителността
Класическата СХД винаги се изчислява по най-лошия сценарий (worst case scenario), изключвайки влиянието на оперативния кеш и оптимизацията на операциите.
Като основни показатели за производителност приемаме механичната производителност от диска (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
След това количеството дискове в дисковия пул се изчислява по следната формула: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Където:
— TotalIOPS – общата необходима производителност в IOPS от дисковия пул
— RW – процентната част на операциите за четене
— RAIDpen – RAID наказание за избраното ниво на RAID
Повече за устройството RAID и RAID Penalty е описано тук — и и
На базата на полученото количество дискове се изчисляват възможните варианти, удовлетворяващи изискванията за капацитет на съхранение, включително варианти с многостепенно съхранение.
Изчислението на системи с използване на SSD като ниво на съхранение се разглежда отделно.
Особености на изчислението на системи с Flash Cache
Flash Cache – общото наименование за всички фирмени технологии за използване на флаш паметта като вторичен кеш. При използване на флаш кеш, СХД обикновено се изчислява за осигуряване на фиксирана натовареност от магнитни дискове, докато пикова натовареност се обслужва от кеша.
При това е необходимо да се разбере профилът на натовареност и степента на локализация на обращенията към блоковете на съхранение. Флаш кеш е технология за натоварвания с висока локализация на запитванията и практически не се прилага за равномерно натоварени томове (като например за аналитични системи).
Изчисление на хибридни системи low-end / mid-range
Хибридните системи от нисък и среден клас използват многостепенно съхранение с преместване на данните между нивата по график. Размерът на блока за многостепенно съхранение при най-добрите модели е 256 MB. Тези особености не позволяват технологията за многостепенно съхранение да се счита за технология за увеличаване на производителността, както грешно се смята от много хора. Многостепенното съхранение в системи от нисък и среден клас е технология за оптимизация на разходите за съхранение при системи с ясно изразена неравномерност на натоварването.
За многослойно съхранение преди всичко се изчислява производителността на горния слой, докато долният слой за съхранение се счита само за допълващ нестихайна капацитет. За хибридна многослойна система е задължително използването на технология за кеш с флаш памет за многослойния пул с цел компенсиране на спадане на производителността за внезапно загрени данни от долния слой.
Използване на SSD в многослоен дисков пул
Използването на SSD в многослойния дисков пул има вариации в зависимост от особеностите на реализацията на алгоритмите за кеш с флаш памет от съответния производител.
Общата практика при политиката на съхранение за дисков пул с ниво SSD е SSD first.
Read Only Flash Cache. За кеша само за четене, нивото на съхранение на SSD се появява при значителна локализация на операциите за запис, независимо от кеша.
Read / Write Flash Cache. При кеша за запис първо се определя максималният обем на кеша, а нивото на съхранение на SSD се появява само при недостатъчност на размера на кеша за обслужване на цялото локализирано натоварване.
Изчисляването на производителността на SSD и кеша се извършва всеки път въз основа на препоръките на производителя, но винаги за най-лошия вариант.
Източник: habr.com
