

В Linux има много инструменти за дебъгване на ядрото и приложения. Повечето от тях отрицателно влияят на производителността на приложенията и не могат да бъдат използвани в продукция.
Преди няколко години беше — eBPF. Той предлага възможност за трасировка на ядрото и потребителските приложения с нисък овер헤д и без необходимост от повторно компилиране на програмите и зареждане на външни модули в ядрото.
Вече съществуват много приложни утилити, които използват eBPF, и в тази статия ще разгледаме как да напишем собствена утилита за профилиране на базата на библиотеката . Статията е основана на реални събития. Ще преминем през процеса от появата на проблема до неговото решаване, за да покажем как съществуващи утилити могат да бъдат използвани в конкретни ситуации.
Ceph е бавен
В кластер Ceph беше добавен нов хост. След миграцията на част от данните към него забелязахме, че скоростта на обработка на записите е значително по-ниска в сравнение с другите сървъри.
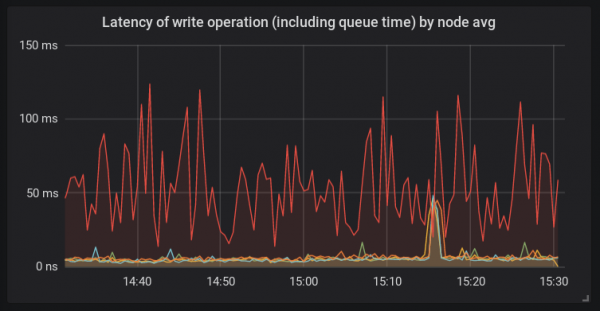
В отличие от другите платформи, на този хост се използваше bcache и ново ядро linux 4.15. Тази конфигурация на хост е била използвана тук за първи път. И в този момент беше ясно, че проблема може да е причинен от множество фактори.
Разследване на хоста
Да започнем с това, което се случва вътре в процеса ceph-osd. За това ще използваме и (повече подробности можете да прочетете ):
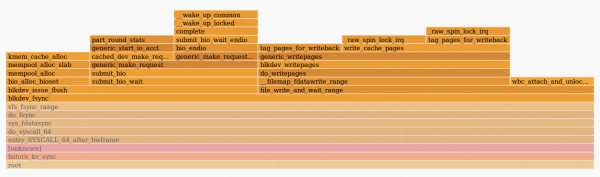
Изображението ни казва, че функцията fdatasync() прекарала много време, когато е изпратила заявка на функцията generic_make_request(). Това означава, че причината за проблемите едва ли е в самия демон osd. Може да е или в ядрото, или в дисковете. Изходните данни от iostat показваха висока латентност при обработката на заявки от bcache-дисковете.
При проверка на хоста установихме, че демонът systemd-udevd консумира много време на процесора — около 20% на няколко ядра. Това е странно поведение, така че е нужно да разберем причината. Тъй като systemd-udevd работи със събития uevent, решихме да ги наблюдаваме през udevadm monitor. Оказа се, че се генерират огромен брой събития change за всяко блочно устройство в системата. Това не е обичайно, затова ще трябва да погледнем какво генерира тези събития.
Използване на BCC Toolkit
Както вече установихме, ядрото (и демонът ceph в системния повик) прекарва много време в generic_make_request(). Некамер да измерим скоростта на тази функция. В вече има отличен инструмент — funclatency. Ще проследим демона по неговия PID с интервал между извежданията на информация от 1 секунда и ще изведем резултата в милисекунди.
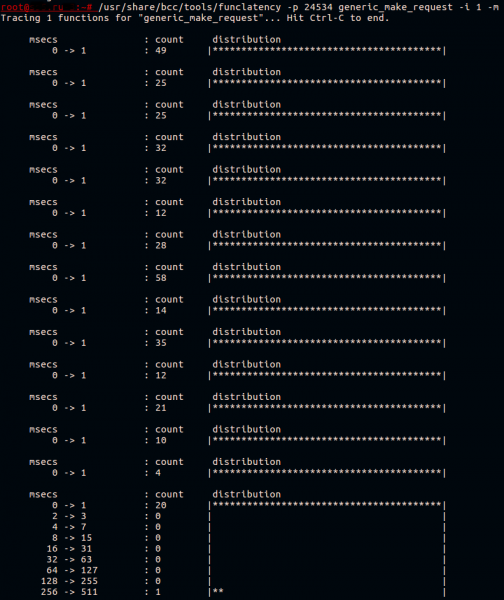
Обикновено тази функция работи бързо. Всичко, което прави, е да предава заявка в опашката на устройството.
Bcache е сложно устройство, което всъщност се състои от три диска:
- backing device (кеширан диск), в този случай това е бавен HDD;
- caching device (кеширащ диск), тук това е един дял от устройството NVMe;
- виртуално устройство bcache, с което работи приложението.
Знаем, че предаването на заявка забавя, но за кое от тези устройства? Нека разберем по-късно.
В момента знаем, че uevent-ите вероятно причиняват проблеми. Да намерим какво точно ги генерира, не е толкова просто. Нека предположим, че това е някакъв софтуер, който се стартира периодично. Нека видим какъв софтуер се стартира в системата, с помощта на скрипта execsnoop от същия . Нека го стартираме и насочим изхода в файл.
Например така:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Няма да представяме целия изход от execsnoop, но един интересуващ ни ред изглеждаше така:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Третата колона е PPID (parent PID) на процеса. Процес с PID 5802 се оказа един от потоковете на нашата система за мониторинг. При проверка на конфигурацията на системата за мониторинг бяха открити неправилно зададени параметри. Температурата на HBA адаптера се измерваше на всеки 30 секунди, което е значително по-често, отколкото е необходимо. След промяна на интервала на проверка на по-дълъг, установихме, че забавянето при обработката на заявките на този хост вече не се забелязва на фона на останалите хостове.
Но все още е неясно, защо bcache устройството така забавяше. Подготвихме тестова платформа с идентична конфигурация и опитахме да възпроизведем проблема, стартирайки fio на bcache, периодично стартирайте udevadm trigger за генериране на uevents.
Писане на инструменти, базирани на BCC
Нека опитаме да напишем прост инструмент за проследяване и извеждане на екрана на най-бавните повиквания generic_make_request(). Интересува ни и името на диска, за който е било извикано това функция.
Планът е прост:
- Регистрираме kprobe на generic_make_request():
- Запазваме в паметта името на диска, достъпно чрез аргумента на функцията;
- Запазваме времевата отметка.
- Регистрираме kretprobe при връщане от generic_make_request():
- Получаваме текущата времева метка;
- Търсим запазената времева метка и я сравняваме с текущата;
- Ако резултатът е по-голям от зададеното, намираме запазеното име на диска и го извеждаме на терминала.
Kprobes и kretprobes използват механизъм на точки за спиране, за да променят кода на функциите на летящо. Можете да прочетете и статия по темата. Ако погледнем кода на различни утилити в , можем да забележим, че имат идентична структура. В тази статия ще пропуснем парсинга на аргументите на скрипта и ще преминем направо към самата BPF програма.
Текстът на eBPF в python-скрипта изглежда по следния начин:
bpf_text = """ # Тук ще бъде кодът на bpf програмата """
За обмен на данни между функциите, eBPF програмите използват . Така ще постъпим и ние. Като ключ ще използваме PID на процеса, а като стойност ще определим структурата:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Тук регистрираме хеш-таблица, която се нарича p, с ключ от тип u64 и стойност от тип struct data_t. Таблицата ще бъде достъпна в контекста на нашата BPF програма. Макросът BPF_PERF_OUTPUT регистрира друга таблица, наречена events, която се използва за в потребителското пространство.
При измерване на закъсненията между извикването на функцията и връщането от нея, или между извикванията на различни функции, трябва да се има предвид, че получените данни трябва да принадлежата на един и същ контекст. С други думи, трябва да помним за възможното паралелно изпълнение на функциите. Имаме възможност да измерим закъснението между извикването на функция в контекста на един процес и връщането от тази функция в контекста на друг процес, но това, вероятно, ще бъде безполезно. Добър пример тук може да служи , където като ключ на хеш-таблицата се задава указател на struct request, която отразява една заявка към диска.
След това трябва да напишем код, който ще се изпълнява, когато се извика изследваната функция:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Тук вторият аргумент ще бъде заменен с първия аргумент на извиканата функция . След това получаваме PID на процеса, в контекста на който работим, и текущата времева маркировка в наносекунди. Записваме всичко това в новосъздадената struct data_t data. Името на диска получаваме от структурата bio, която се предава при извикването generic_make_request(), и го запазваме в същата структура data. Последната стъпка е добавянето на запис в хеш-таблицата, за която споменахме по-рано.
Следващата функция ще бъде извикана при връщането от generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Тази функция е подобна на предишната: научаваме PID на процеса и времевата маркировка, но не заделяме памет за нова структура data. Вместо това търсим в хеш-таблицата вече съществуваща структура по ключа == текущия PID. Ако структурата е намерена, то разбираме името на стартирания процес и го добавяме в нея.
Бинерното изместване, което използваме тук, е необходимо, за да получим GID на нишката, т.е. PID на основния процес, който е стартирал нишката, в контекста на който работим. Извикваме функцията върща както GID на нишката, така и нейния PID в едно 64-битово стойност.
При извеждането в терминала не ни интересува нишката, а основният процес. След като сравним получената латенция с зададения праг, предаваме нашата структура data в потребителското пространство през таблицата events, след което изтриваме записа от p.
В Python скрипта, който ще зарежда този код, е необходимо да заменим MIN_US и FACTOR с праговете на латенцията и единиците време, които ще предадем чрез аргументите:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Сега трябва да подготвим BPF програмата чрез и да регистрираме пробите:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Също така ще трябва да определим struct data_t в нашия скрипт, иначе няма да можем да четем:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Последната стъпка е извеждане на данните на терминала:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# форматиране на изхода
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Скриптът е наличен на . Ще се опитаме да го стартираме на тестова платформа, където работи fio, писещо на bcache, и да извикаме udevadm monitor:
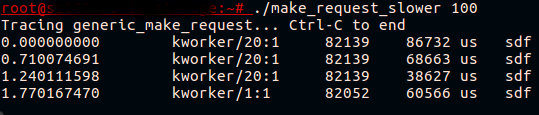
Най-накрая! Сега виждаме, че това, което изглеждаше като забавено bcache устройство, всъщност е забавяне на повикване generic_make_request() за кеширания диск.
Проучете ядрата
Какво точно забавя по време на изпращане на заявка? Виждаме, че забавянето се появява дори преди началото на обявяването на заявката, т.е. отчитането на конкретната заявка за последваща статистика (извеждана от /proc/diskstats или iostat) все още не е започнало. Лесно е да се провери, стартирайки iostat по време на възпроизвеждането на проблема, или , който се основава на началото и края на обявяването на заявките. Нито един от тези инструменти няма да покаже проблеми с заявките за кеширания диск.
Ако погледнем функцията generic_make_request(), ще видим, че преди началото на обявяването на заявката се извикват още две функции. Първата — generic_make_request_checks(), извършва проверки за легитимност на заявката спрямо настройките на диска. Втората — , в която има интересна повикване :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
В него ядрото изчаква размразяване на опашката. Давайте да измерим забавянето blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Наблюдение на 1 функции за "blk_queue_enter"... Натиснете Ctrl-C, за да завършите.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Изглежда, че сме близо до разгадаването. Функциите, използвани за „замразяване/размразяване“ на опашката, са и . Те се използват, когато е необходимо да се променят настройки на опашките за заявки, потенциално опасни за заявките, намиращи се в тази опашка. При повикване на blk_mq_freeze_queue() функция се увеличава броячът q->mq_freeze_depth. След това ядрото изчаква изпразването на опашката в .
Времето за изчакване на освобождаването на тази опашка е еквивалентно на закъснението на диска, тъй като ядрото изчаква завършването на всички операции, поставени в опашката. След като опашката е празна, се прилагат настройките. След това се извиква , намаляваща брояча freeze_depth.
Сега знаем достатъчно, за да разрешим ситуацията. Командата udevadm trigger води до приложението на настройките за блочното устройство. Тези настройки са описани в правилата на udev. Можем да разберем какви именно настройки "замразяват" опашката, като се опитаме да ги променим чрез sysfs или да погледнем изходния код на ядрото. Можем също да опитаме инструмента BCC , който ще изведе на терминала трасета на стека на ядрото и потребителското пространство за всеки повикване на blk_freeze_queue, например:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Правилата на udev се променят доста рядко и обикновено това се случва под контрол. Така че виждаме, че дори приложението на вече зададени стойности предизвиква покачване на закъснението при предаване на заявките от приложението към диска. Разбира се, генерирането на udev-събития, когато няма промени в конфигурацията на дисковете (например, устройството не е свързано/отключено), не е много добра практика. Въпреки това, можем да помогнем на ядрото да не извършва безполезна работа и да не "замразява" опашката за заявки, ако това не е необходимо. решават ситуацията.
Заключение
eBPF е много гъвкав и мощен инструмент. В статията разгледахме един практически случай и демонстрирахме малка част от това, което може да се направи. Ако ви интересува разработването на BCC-инструменти, струва си да погледнете , който добре описва основите на работата.
Има и други интересни инструменти за отстраняване на грешки и профилиране, базирани на eBPF. Един от тях е , позволяващ написването на мощни едноредови скриптове и малки програми на awk-подобен език. Другият е , който позволява събиране на нискоуровневи високорезолюционни метрики директно в вашия prometheus сървър, с възможност за последваща атрактивна визуализация и дори предупреждения.
Източник: habr.com
