

В описах фреймворка за мрежова автоматизация. Според отзивите, на някои хора дори този първи подход към проблема вече е изяснил някои въпроси. И това много ме радва, защото нашата цел в цикъла не е да покрием ансибъл с питоновски скриптове, а да изградим система.
Този фреймворк задава реда, по който ще разгледаме въпроса.
А виртуализацията на мрежата, на която е посветен този брой, не се вписва особено в тематиката на АДСМ, където разглеждаме автоматизацията.
Но нека погледнем на нея от друга гледна точка.
Вече отдавна една мрежа се ползва от много услуги. В случай на оператор на телекомуникации това е 2G, 3G, LTE, ШПД и B2B, например. В случай на центрове за данни: свързаност за различни клиенти, Интернет, блочно хранилище, обектно хранилище.
И всички услуги изискват изолация една от друга. Така се появиха оверлейни мрежи.
И всички услуги не искат да чакат, когато човек настрои всичко ръчно. Така се появиха оркестратори и SDN.
Първият подход към систематичната автоматизация на мрежата, по-точно на нейна част, отдавна е предприет и навсякъде внедрен: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
С него днес и ще се занимаваме.
Съдържание
- Причини
- Терминология
- Подлегло — физическа мрежа
- Оверлей — виртуална мрежа
- Оверлей от ToR
- Оверлей от хост
- На примера на Tungsten Fabric
- Комуникация вътре в една физическа машина
- Комуникация между ВМ, разположени на различни физически машини
- Изход към външния свят
- Често задавани въпроси
- Заключение
- Полезни връзки
Причини
И след като заговорихме за това, струва си да споменем предпоставките за виртуализация на мрежата. Всъщност този процес не е започнал вчера.
Навярно, неведнъж сте чували, че мрежата винаги е била най-инертната част от всяка система. И това е вярно във всички смисли. Мрежата е основата, на която се опира всичко, и извършването на промени в нея е доста трудно — услугите не търпят, когато мрежата е неработеща. Често изключването на един възел може да повлияе на голяма част от приложенията и на много клиенти. Отчасти затова мрежовият екип може да се противопоставя на всякакви промени — защото сега работи по някакъв начин (възможно е дори да не знаем как), а сега трябва да настроим нещо ново, и не е ясно как то ще повлияе на мрежата.
За да не чакаме, когато мрежовиците прокарат VLAN и да не настройваме услуги на всеки един възел в мрежата, хората измислиха да използват оверлей - наложени мрежи - от които има голямо разнообразие: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE и т.н.
Тяхната привлекателност се състои в две прости неща:
- Настройват се само крайни възли - транзитните остават недосегаеми. Това значително ускорява процеса и понякога дори позволява да се изключи отделът за мрежова инфраструктура от процеса на въвеждане на нови услуги.
- Натоварването е скрито дълбоко в заглавията - транзитните възли не трябва да знаят нищо за него, за адресирането на хостовете и маршрутите на наложената мрежа. А това означава, че е нужно да се съхранява по-малко информация в таблиците, което означава, че можем да вземем по-просто/по-евтино устройство.
В този не съвсем пълен брой не планирам да разглеждам всички възможни технологии, а по-скоро да опиша рамката на работата на оверлейните мрежи в ДЦ.
Цялата серия ще описва датацентър, състоящ се от редици от идентични рафтове, в които е инсталирано идентично сървърно оборудване.
На това оборудване се стартират виртуални машини/контейнери/серверлесс, реализиращи услуги.
Терминология
В цикъла сървър ще наричам програмата, която реализира сървърната страна на клиент-сървърната комуникация.
Физическите машини в рафтовете ще наричаме сървъри не по този начин.
Физическа машина — x86 компютър, инсталиран в рафт. Най-често се използва терминът хост. Така и ще я наричаме «машина» или хост.
Хипервизор — приложение, работещо на физическа машина, емулиращо физически ресурси, на които се стартират Виртуални Машини. Понякога в литературата и мрежата думата «хипервизор» се използва като синоним на «хост».
Виртуална машина — операционна система, стартирана на физическа машина над хипервизора. За нас в рамките на този цикъл не е толкова важно, дали наистина е виртуална машина или просто контейнер. Ще я наричаме «ВМ«
Тенант — широко понятие, което в тази статия ще определя като отделна услуга или отделен клиент.
Мулти-тенантност или мултиарендност — използване на едно и също приложение от различни клиенти/услуги. При това изолацията на клиентите един от друг се постига благодарение на архитектурата на приложението, а не чрез отделно стартирани екземпляри.
ToR — комутатор Top of the Rack — комутатор, инсталиран в шкафа, към който са свързани всички физически машини.
Освен ToR топологията, различни доставчици практикуват End of Row (EoR) или Middle of Row (въпреки че последната е пренебрежителна рядкост и аз не съм срещал абревиатури MoR).
Подлежащата мрежа или андърлей — физическа мрежова инфраструктура: комутатори, маршрутизатори, кабели.
Налагаща мрежа или оверлей — виртуална мрежа от тунели, работеща върху физическата.
L3 фабрика или IP фабрика — невероятно изобретение на човечеството, позволяващо на събеседниците да не повтарят STP и да не учат TRILL. Концепция, при която цялата мрежа до ниво достъп е изцяло L3, без VLAN и съответно огромни разширени широковещателни домейни. Защо тук е думата „фабрика“ ще разберем в следващата част.
SDN — Software Defined Network. Едва ли се нуждае от представяне. Подход за управление на мрежата, при който промените в мрежата се извършват не от човек, а от програма. Обикновено означава изнасяне на Control Plane извън крайни мрежови устройства към контролер.
NFV — Network Function Virtualization — виртуализация на мрежови устройства, предполагаща, че част от функциите на мрежата могат да се изпълняват във вид на виртуални машини или контейнери за ускоряване на внедряването на нови услуги, организиране на Service Chaining и по-лесна хоризонтална скалируемост.
VNF — Virtual Network Function. Конкретно виртуално устройство: маршрутизатор, комутатор, защитна стена, NAT, IPS/IDS и т.н.
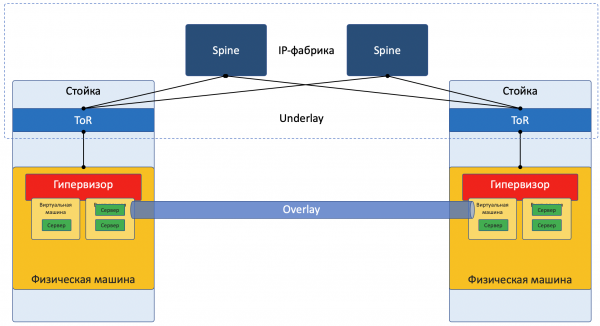
В момента умишлено опростявам описанието до конкретна реализация, за да не обърквам читателя. За по-внимателно четене го насочвам към секцията . Освен това, Рома Горге, който критикува тази статия за неточности, обещава да напише отделен брой за технологиите за виртуализация на сървъри и мрежи, по-дълбок и внимателен към детайлите.
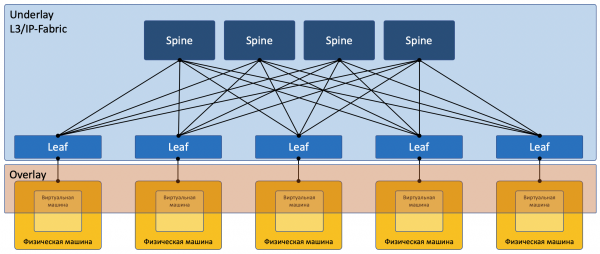
Повечето мрежи днес могат да се разделят на две части:
Подлежащата — физическа мрежа със стабилна конфигурация.
Налагаща — абстракция над подлежащата, за изолиране на тентите.
Това важи както за случая ДЦ (който ще разгледаме в тази статия), така и за ISP (който няма да разглеждаме, защото вече беше в ). С ентерпрайзните мрежи, разбира се, ситуацията е малко по-различна.
Снимка с фокус върху мрежата:
Подлежащата
Underlay е физическата мрежа: хардуерни комутатори и кабели. Устройствата в андерлея знаят как да стигнат до физическите машини.
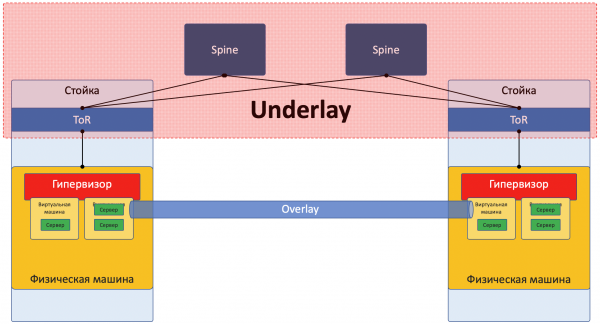
Той се основава на стандартни протоколи и технологии. Не на последно място, защото хардуерните устройства все още работят с проприетарен софтуер, който не позволява програмиране на чипа или имплементиране на свои протоколи, следователно е нужна съвместимост с други производители и стандартизация.
Но някой като Google може да си позволи да разработва собствени комутатори и да се откаже от общоприетите протоколи. Но LAN_DC не е Google.
Underlay сравнително рядко се променя, защото неговата задача е основна IP свързаност между физическите машини. Underlay не знае нищо за услугите, клиентите и тенантите, работещи над него — той просто трябва да достави пакет от една машина до друга.
Underlay може да бъде например такъв:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
Неговата мрежа се настройва по класически начин: CLI/GUID/NETCONF.
Ръчно, със скриптове, проприетарни инструменти.
По-подробно на андерлея ще бъде посветена следващата статия от цикъла.
Налагаща
Overlay е виртуална мрежа от тунели, протегната над Underlay, която позволява на виртуалните машини на един клиент да комуникират помежду си, като в същото време осигурява изолация от други клиенти.
Данните на клиента се инкапсулират в каквито и да е тунелиращи заглавия за предаване през общата мрежа.
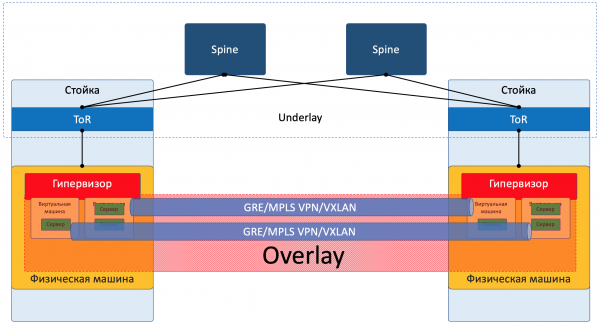
По този начин виртуалните машини на един клиент (на една услуга) могат да комуникират помежду си през Overlay, дори не предполагайки какъв точно път преминава пакетът.
Overlay може да бъде например такъв, какъвто вече споменах по-горе:
- GRE тунел
- VXLAN
- EVPN
- L3VPN
- GENEVE
Overlay мрежата обикновено се настройва и поддържа чрез централен контролер. От него конфигурацията, Control Plane и Data Plane се доставят на устройства, които се занимават с маршрутизиране и инкапсулиране на клиентски трафик. Малко да разгледаме това на примери.
Да, това е SDN в чист вид.
Съществуват два принципно различаващи се подхода за организиране на Overlay мрежа:
- Оверлей от ToR
- Оверлей от хост
Оверлей от ToR
Overlay може да започне на комутатор за достъп (ToR), стоящ в шкафа, каквато е например ситуацията при VXLAN фабрика.
Това е проверен механизъм в мрежите на ISP и всички производители на мрежово оборудване го поддържат.
Въпреки това, в този случай ToR-комутаторът трябва да може да разделя различните услуги, съответно, а мрежовият администратор трябва в определена степен да си сътрудничи с администраторите на виртуални машини и да внася промени (дори автоматично) в конфигурацията на устройствата.
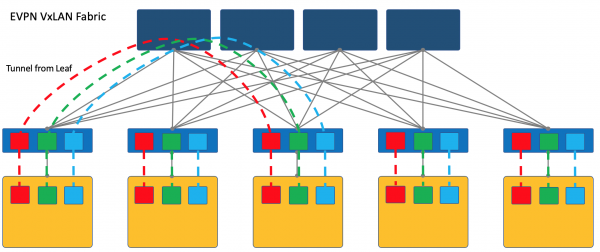
Тук ще насоча читателя към статията за нашия стар приятел .
В тази подробно са описани подходите за изграждане на мрежа на ДЦ с EVPN VXLAN-фабрика.
А за по-пълно потапяне в реалността, може да прочетете книгата на Cisco .
Забелязвам, че VXLAN е само метод за инкапсулация и терминализацията на тунелите може да се извършва не на ToR, а на хоста, както се случва например в случая с OpenStack.
Въпреки това, VXLAN-фабрика, където overlay започва на ToR, е един от утвърдените дизайни на оверлейната мрежа.
Оверлей от хост
Друг подход е да се започне и терминира тунелите на крайни хостове.
В този случай мрежата (Underlay) остава максимално проста и статична.
А хостът сам прави всички необходими инкапсуляции.
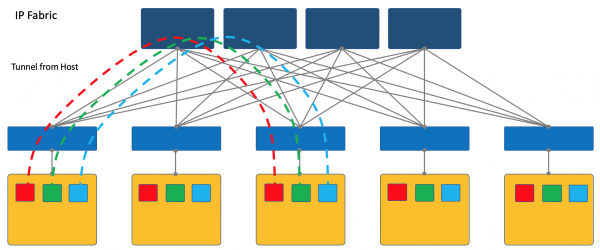
За целта, разбира се, ще е необходимо да се стартира специално приложение на хостовете, но то си заслужава.
Първо, по-лесно е да стартирате клиент на linux машина или, да кажем, - изобщо е възможно - докато на комутатора, вероятно, ще трябва все още да се обръщате към проприетарни SDN решения, което убива идеята за многостранност.
На второ място, ToR-комутаторът в този случай може да бъде оставен максимално прост, както от гледна точка на Control Plane, така и на Data Plane. Наистина - с SDN контролер, тогава не е необходимо да взаимодейства с него, и да съхранява мрежи/ARP на всички свързани клиенти - е достатъчно просто да знае IP адреса на физическата машина, което значително улеснява таблиците за комутация/маршрутиране.
В серията АДСМ избрах подхода на оверлей с хоста - по-нататък ще говорим само за него и няма да се връщаме към VXLAN фабрика.
Най-лесно е да се разгледа на примери. И за подопитен обект ще вземем OpenSource SDN платформата OpenContrail, известна днес като .
В края на статията ще предоставя някои размисли по темата на аналогията с OpenFlow и OpenvSwitch.
На примера на Tungsten Fabric
На всяка физическа машина има vRouter — виртуален маршрутизатор, който знае за свързаните мрежи и на кои клиенти те принадлежат — по същество — PE-маршрутизатор. За всеки клиент той поддържа изолирана таблица за маршрутизиране (чети VRF). И всъщност vRouter извършва Overlay тунелиране.
Няколко думи повече за vRouter — в края на статията.
Всяка ВМ, разположена на хипервизора, се свързва с vRouter на тази машина чрез .
TAP — Terminal Access Point — виртуален интерфейс в ядрото на Linux, който позволява извършването на мрежова комуникация.
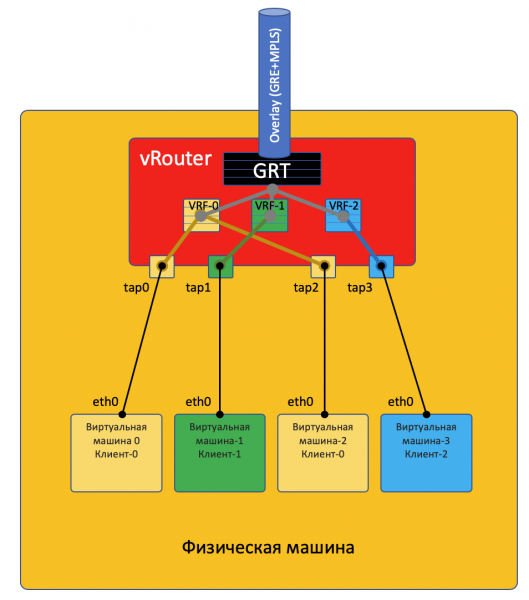
Ако зад vRouter има няколко мрежи, за всяка от тях се създава виртуален интерфейс, на който се назначава IP-адрес — той ще бъде адреса на шлюза по подразбиране.
Всички мрежи на един клиент се поставят в един VRF (една таблица), докато различни — в различни.
Искам да направя възражение, че не всичко е толкова просто и ще насоча любопитния читател в края на статията.
За да могат vRouter-ите да комуникират помежду си, а съответно и ВМ-ите, които са зад тях, те обменят маршрутна информация чрез SDN-контролер.
За да се излезе във външния свят, съществува т.нар. точка за изход от матрицата — шлюз на виртуалната мрежа VNGW — Virtual Network GateWay (термин, мой).
Сега нека разгледаме примери за комуникации — и ще е ясно.
Комуникация вътре в една физическа машина
VM0 иска да изпрати пакет на VM2. Да предположим засега, че това е ВМ на един и същ клиент.
Data Plane
- VM-0 има маршрут по подразбиране към своя интерфейс eth0. Пакетът се изпраща там.
Този интерфейс eth0 всъщност е виртуално свързан с виртуалния маршрутизатор vRouter чрез TAP-интерфейс tap0. - vRouter анализира на кой интерфейс е постъпил пакетът, т.е. към кой клиент (VRF) принадлежи, и сравнява адреса на получателя с таблицата за маршрутизиране на този клиент.
- Откривайки, че получателят е на същата машина през друг порт, vRouter просто изпраща пакета към него без никакви допълнителни заглавия — за този случай на vRouter вече съществува ARP-запис.
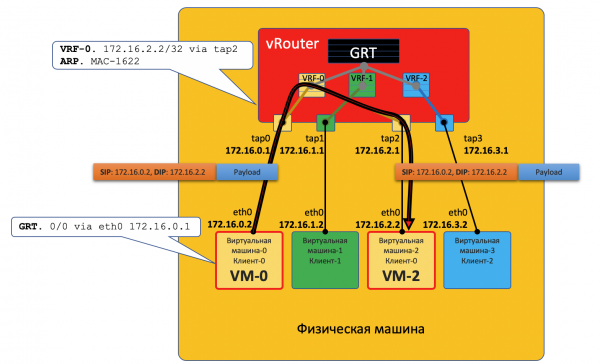
Пакетът в този случай не попада в физическата мрежа — той е маршрутизиран вътре в vRouter.
Control Plane
Хипервизорът при стартиране на виртуалната машина съобщава:
- Собствения й IP-адрес.
- Маршрут по подразбиране — през IP-адреса на vRouter в тази мрежа.
На vRouter чрез специален API хипервизорът съобщава:
- Какво е необходимо да се създаде виртуален интерфейс.
- Какъв Virtual Network (VN) е необходимо да се създаде.
- Към кой VRF да бъде свързан.
- Статичен ARP запис за тази VM - на кой интерфейс е IP адреса й и на кой MAC адрес е присвоен.
И отново, реалната процедура на взаимодействие е опростена с цел разбирането на концепцията.
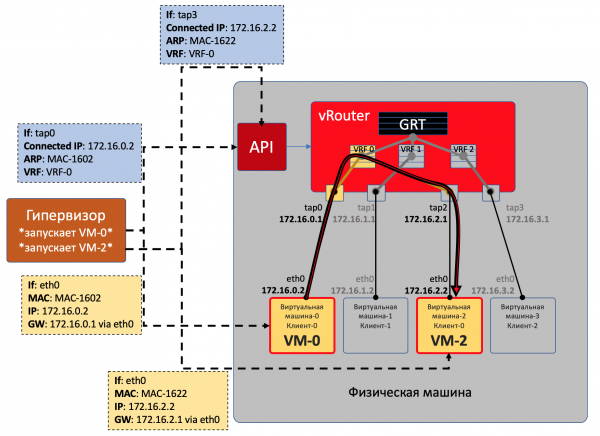
Така всички ВМ на един клиент на тази машина vRouter вижда като директно свързани мрежи и може самостоятелно да маршрутизира между тях.
А VM0 и VM1 принадлежат на различни клиенти и следователно, са в различни таблици на vRouter.
Дали те могат да комуникират директно помежду си, зависи от настройките на vRouter и дизайна на мрежата.
Например, ако ВМ на двамата клиенти използват публични адреси или NAT се извършва на самия vRouter, може да се направи и директно маршрутизиране на vRouter.
В противен случай е възможно пресичане на адресните пространства - нужно е да се минава през NAT сървър, за да се получи публичен адрес - това е като излизане в външни мрежи, за които ще говорим по-долу.
Комуникация между ВМ, разположени на различни физически машини
Data Plane
- Началото е точно такова: VM-0 изпраща пакет с получател VM-7 (172.17.3.2) по своя дефолт.
- vRouter го получава и този път вижда, че получателят е на друга машина и е достъпен през тунела Tunnel0.
- Първо той поставя MPLS етикет, идентифициращ отдалечения интерфейс, за да може от другата страна vRouter да определи къде да постави този пакет без допълнителни заобикаляния.
- При Tunnel0 източникът е 10.0.0.2, получателят: 10.0.1.2.
vRouter добавя GRE (или UDP) заглавия и нов IP към изходния пакет. - В таблицата за маршрутизиране vRouter има маршрут по подразбиране през адрес ToR1 10.0.0.1. Там и изпраща.

- ToR1, като участник в Underlay мрежата, знае (например, чрез OSPF) как да стигне до 10.0.1.2 и изпраща пакета по маршрута. Обърнете внимание, че тук се включва ECMP. На илюстрацията има два nexthop-a, и различните потоци ще се разпределят в тях по хеш. В случай на истинска фабрика, тук вероятно ще има 4 nexthop-a.
В същото време, да знае какво се намира под външния IP заглавия не му е нужно. Тоест, всъщност под IP може да има сандвич от IPv6 over MPLS over Ethernet over MPLS over GRE over over over GRE.
- Съответно на получаващата страна vRouter сваля GRE и по MPLS етикета разбира в кой интерфейс трябва да предаде този пакет, разгъва го и изпраща в първоначалния вид на получателя.
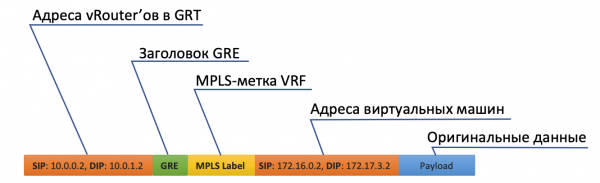
Control Plane
При стартиране на машината се случва всичко, което беше описано по-горе.
И плюс още следното:
- За всеки клиент vRouter разпределя MPLS-етикет. Това е сервисен етикет L3VPN, по който клиентите ще се разделят в рамките на една физическа машина.
Всъщност MPLS-етикетът се разпределя от vRouter винаги — все пак не е ясно предварително, че машината ще взаимодейства само с други машини зад същия vRouter и вероятно дори не е така.
- vRouter установява връзка с SDN контролера по протокола BGP (или подобен на него — в случая TF - това е XMPP 0_o).
- Чрез тази сесия vRouter съобщава на SDN контролера маршрутите до свързаните мрежи:
- Адрес на мрежата
- Метод на инкапсулация (MPLSoGRE, MPLSoUDP, VXLAN)
- MPLS-етикет на клиента
- Свой IP адрес като nexthop
- SDN контролерът получава такива маршрути от всички свързани vRouter-и и ги отразява на другите. Тоест той служи като Route Reflector.
Същото се случва и в обратната посока.
Overlay може да се променя дори всяка минута. Приблизително така се случва в публичните облаци, когато клиентите редовно стартират и спират своите виртуални машини.
Централният контролер поема всички трудности с поддържане на конфигурацията и контрола над таблиците за комутация/маршрутизация на vRouter.
Грубо казано, контролерът се свързва с всички vRouter-и по BGP (или подобен протокол) и просто предава маршрутната информация. BGP, например, вече има Address-Family за предаване на метода на инкапсулация. или .
При това по никакъв начин не се променя конфигурацията на Underlay мрежата, която, между другото, е много по-трудна за автоматизация, а да се повреди с небрежно движение е по-лесно.
Изход към външния свят
Някъде симулацията трябва да приключи, и от виртуалния свят трябва да се излезе в реалния. И е нужен шлюз за таксофони.
Се практикуват два подхода:
- Слага се хардуерен рутер.
- Стартира се някакво устройство, реализиращо функции на рутер (да-да, след SDN се сблъскахме и с VNF). Нека го наречем виртуален шлюз.
Предимството на втория подход е в евтината хоризонтална мащабируемост — не стига мощността — стартираме още една виртуалка със шлюз. На всяка физическа машина, без нужда от търсене на свободни стойки, юнити, захранване, покупка на самото устройство, транспортиране, инсталиране, свързване, конфигуриране, а после и подмяна на счупени компоненти.
Недостатъците на виртуалния шлюз са, че физическото рутерно устройство е значително по-мощно от многоядрената виртуалка, а софтуерът, проектиран за него, работи много по-стабилно (недостъпен). Не може да се отрече и фактът, че софтуерно-апаратният комплекс просто функционира, изисквайки единствено настройки, докато стартирането и поддържането на виртуален шлюз е работа за опитни инженери.
С едната си страна шлюзът гледа към виртуалната мрежа Overlay, подобно на обикновена Виртуална Машина, и може да взаимодейства с всички останали ВМ. В същото време той може да завършва мрежите на всички клиенти и съответно да осъществява маршрутизация между тях.
С другата си страна шлюзът поглежда към магистралната мрежа и знае как да излезе в Интернет.
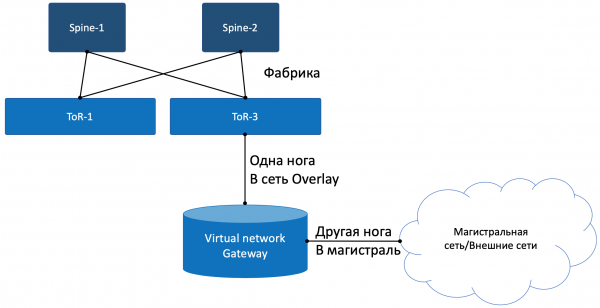
Data Plane
Тоест процесът изглежда така:
- VM-0, с дефолтен vRouter, изпраща пакет до адресата във външния свят (185.147.83.177) през интерфейс eth0.
- vRouter получава този пакет и прави търсене на целевия адрес в таблицата за маршрутиране — намира маршрута по подразбиране през шлюза VNGW1 през Tunnel 1.
Той също така вижда, че това е GRE тунел с SIP 10.0.0.2 и DIP 10.0.255.2, а също така трябва първо да прикрепи MPLS етикет на този клиент, който VNGW1 очаква. - vRouter опакова първоначалния пакет с MPLS, GRE и нов IP заглавия и го изпраща на адрес ToR1 10.0.0.1 по подразбиране.
- Подмрежата доставя пакета до шлюза VNGW1.
- Шлюзът VNGW1 премахва заглавията за тунелиране GRE и MPLS, вижда целевия адрес, консултира се с таблицата си за маршрутиране и разбира, че той е насочен към Интернет — следователно, през Full View или Default. При необходимост извършва NAT транслация.
- Може да има обикновена IP мрежа от VNGW до бордера, но това е малко вероятно.
Може да има класическа MPLS мрежа (IGP+LDP/Rsvp TE), може да има обратно фабрика с BGP LU или GRE тунел от VNGW до бордера през IP мрежа.
Както и да е, VNGW1 извършва необходимите инкапсуляции и изпраща първоначалния пакет в посока бордера.
Трафикът в обратна посока преминава през същите стъпки в обратен ред.
- Бордерът доставя пакета до VNGW1.
- Той го разпакова, гледа адреса на получателя и вижда, че е достъпен през тунела Tunnel1 (MPLSoGRE или MPLSoUDP).
- Съответно, добавя MPLS етикет, GRE/UDP заглавие и нов IP и го изпраща на своя ToR3 10.0.255.1.
Адрес за тунела е IP адресът на vRouter-а, зад който се намира целевата ВМ - 10.0.0.2. - Underlay мрежата доставя пакета до необходимия vRouter.
- Целевият vRouter отключва GRE/UDP, определя интерфейса по MPLS маркера и изпраща чист IP пакет на своя TAP интерфейс, свързан с eth0 на ВМ.
Control Plane
VNGW1 установява BGP съседство със SDN контролера, от който получава цялата маршрутна информация за клиентите: кой IP адрес (vRouter) принадлежеше на кой клиент и с кой MPLS маркер е идентифициран.
Аналогично, той съобщава на SDN контролера дефолтния маршрут с маркера на този клиент, посочвайки себе си като nexthop. А след това този дефолт идва на vRouter-ите.
На VNGW обикновено се извършва агрегация на маршрути или NAT транслация.
И в обратната посока, той отдава именно този агрегатен маршрут на сесията с бордърите или Route Reflector-ите. А от тях получава маршрут по подразбиране или Full-View, или нещо друго.
По отношение на инкапсулацията и обмена на трафик, VNGW не се различава от vRouter.
Ако малко разширим обхвата, към VNGW и vRouter-ите могат да се добавят и други мрежови устройства, като защитни стени, farms за премахване или обогатяване на трафика, IPS и така нататък.
И с помощта на последователно изграждане на VRF и правилно анонсиране на маршрути, можем да накараме трафика да се движи така, както желаем, което се нарича Service Chaining.
Тоест и тук SDN контролерът изпълнява ролята на Route Reflector между VNGW, vRouter-ите и другите мрежови устройства.
Но всъщност контролерът предоставя допълнителна информация за ACL и PBR (Routing на базата на политика), като принуждава отделни потоци на трафика да се движат, различно от зададения маршрут.
Често задавани въпроси
Защо постоянно правиш забележка за GRE/UDP?
Ами всъщност, това може да се каже, че е специфично за Tungsten Fabric - всъщност може изобщо да не се взема под внимание.
Но ако го вземем под внимание, TF, докато все още беше OpenContrail, поддържаше и двете инкапсулации: MPLS in GRE и MPLS in UDP.
UDP е добър с това, че в Source Port в заглавката му е много лесно да се кодират хеш-функции от оригиналните IP+Proto+Port, което позволява балансиране на натоварването.
В случай на GRE, за съжаление, има само външни заглавия IP и GRE, които са идентични за целия инкапсулиран трафик и няма възможност за балансиране - малко хора могат да погледнат толкова дълбоко в пакета.
Досега маршрутизаторите, ако можеха да правят динамични тунели, то това беше само в MPLSoGRE, и едва наскоро научиха да работят с MPLSoUDP. Затова винаги се налага да подчертавам възможността за две различни инкапсулации.
За справедливост, трябва да се отбележи, че TF напълно поддържа L2 свързаност чрез VXLAN.
Обеща, че ще направиш паралели с OpenFlow.
Наистина, те са напълно логични. vSwitch в същия OpenStack върши доста подобни неща, използвайки VXLAN, който, между другото, също използва UDP заглавка.
В Data Plane работят почти по един и същи начин, но Control Plane значително се различава. Tungsten Fabric използва XMPP за предаване на информация за маршрути на vRouter, докато OpenStack работи с OpenFlow.
Можеш ли малко повече за vRouter?
Той се дели на две части: vRouter Agent и vRouter Forwarder.
Първият работи в User Space на хостовата ОС и комуникира с SDN контролера, обменяйки информация за маршрути, VRF и ACL.
Вторият реализира Data Plane — обикновено в Kernel Space, но може да работи и на SmartNIC — мрежови карти с CPU и отделен програмиран чип за превключване, което позволява да се облекчи натоварването на CPU на хост машината, а мрежата става по-бърза и предсказуема.
Съществува и сценарий, при който vRouter е DPDK приложение в User Space.
vRouter Agent предава конфигурацията на vRouter Forwarder.
Какво представлява Virtual Network?
Споменах в началото на статията за VRF, че всеки тенант е свързан с неговия VRF. И ако за повърхностно разбиране на работата на овърлейната мрежа това беше достатъчно, на следващата итерация е необходимо уточнение.
Обикновено в механизмите на виртуализация субектът Virtual Network (може да се счита за собствено име) се въвежда отделно от клиентите/тентанти/виртуални машини — напълно самостоятелна категория. А този Virtual Network може да бъде свързан с един тенант, с друг, с два, дори където поискате. Например, по този начин се реализира Service Chaining, когато трафикът трябва да премине през определени нодове в необходимата последователност, просто създавайки и свързвайки Virtual Network-ове в правилната последователност.
Затова няма пряко съответствие между Virtual Network и тенант.
Заключение
Това е сравнително повърхностно описание на работата на виртуалната мрежа с overlay от хоста и SDN контролера. Но каквато и платформа за виртуализация да вземете днес, тя ще работи по подобен начин, независимо дали е VMware, ACI, OpenStack, CloudStack, Tungsten Fabric или Juniper Contrail. Те ще се различават по видовете инкапсулации и заглавия, протоколите за доставка на информация до крайните мрежови устройства, но принципът на софтуерно конфигурируемата overlay мрежа, работеща върху сравнително проста и статична underlay мрежа, остава същият.
Може да се каже, че областите за създаване на частно облако в днешно време SDN, основан на overlay мрежи, доминират. Въпреки това, това не означава, че OpenFlow е изгубил своето място в съвременния свят — той се използва в OpenStack и във VMware NSX, а до колкото ми е известно, Google го използва за настройването на underlay мрежата.
По-долу съм предоставил връзки към по-подробни материали, ако искате да проучите въпроса по-дълбоко.
А какво става с нашата Underlay?
Ами всъщност нищо. Тя през цялото време не се е променяла. Всичко, което трябва да прави по време на overlay от хоста, е да обновява маршрутите и ARP-ите при появата и изчезването на vRouter/VNGW и да пренася пакети между тях.
Нека формулираме списък от изисквания към Underlay мрежата.
- Да може да работи с някакъв протокол за маршрутизиране, в нашия случай — BGP.
- Да има широка честотна лента, за предпочитане без пренасочване, за да не се губят пакети поради претоварване.
- Поддържането на ECMP е неотменима част от фабриката.
- Да може да осигури QoS, включително сложни неща, като ECN.
- Да поддържа NETCONF — за бъдещето.
Посветил съм много малко време на самата работа на Underlay мрежата. Това е така, защото в поредицата ще се съсредоточа точно на нея, а Overlay ще споменаваме само мимоходом.
Очевидно, аз силно ограничавам всички нас, използвайки мрежата на ЦОД, изградена на фабриката на Clos с чиста IP маршрутизация и overlay от хоста, за пример.
Сигурен съм, че всяка мрежа с дизайн може да бъде описана в формални термини и автоматизирана. Просто тук целта ми е да разберем подходите към автоматизацията, а не да запутваме всички, решавайки задачата по общите линии.
В рамките на ADSM планираме с Роман Горге да публикуваме отделно издание за виртуализацията на изчислителни ресурси и нейното взаимодействие с виртуализацията на мрежата. Останете на линия.
Полезни връзки
- .
- . 6 часа за Яндекс.Облако, където също се обсъжда виртуалната мрежа на TF.
- .
- . Тук се говори за цялата мрежа на центъра за данни, включително Underlay, Overlay, подходи към мулти-хоуминг и управление.
Благодаря
- — бивш водещ на подкаста linkmeup, а сега експерт в облачните платформи. За коментарите и корекциите. Очакваме в близко бъдеще и неговата по-дълбока статия за виртуализацията.
- — моят колега и експерт в разработването на виртуални мрежи. За коментарите и корекциите.
- — моят колега и експерт в областта на Tungsten Fabric. За коментарите и корекциите.
- — илюстратор на linkmeup. За КДПВ.
- Александру Лимонову. За мема «automato».
Източник: habr.com
