

През лятото традиционно намалява както покупателската активност, така и интензивността на промените в инфраструктурата на уеб проектите, казва ни Капитан Очевидност. Просто защото дори айтишниците, понякога, отиват на ваканция. И CTO също. Толкова по-трудно е на тези, които остават на поста, но сега не е време за това: може би именно затова лятото е най-добрият период да обмислим съществуващата схема за резервиране и да съставим план за нейното подобрение. А за това опитът на Егора Андреев от , за който той разказа на конференцията .
При изграждането на резервни платформи, при резервиране съществуват няколко капана, в които можем да попаднем. А попадането в тях е абсолютно недопустимо. И ни погубва в това, както и в много други аспекти, перфекционизмът и… леността. Опитваме се да направим всичко перфектно, а перфектно не е нужно! Трябва да вършим само определени неща, но да ги направим правилно, да ги завършим, за да работят нормално.
Failover — това не е някаква весела забавна функция, "за да има"; това е нещо, което трябва да направи едно — да намали времето за простои, за да губи компанията по-малко пари. И във всички методи за резервиране предлагам да мислим в следния контекст: къде са парите?
Първият капан: когато изграждаме големи надеждни системи и се занимаваме с резервиране — намаляваме броя на аварии. Това е страшно погрешно схващане. Когато се занимаваме с резервиране, броят на аварии вероятно се увеличава. И ако направим всичко правилно, колективно ще намалим времето за простои. Аварии ще има повече, но те ще се случват с по-малки загуби. Защото какво е резервирането? — това е усложняване на системата. Всяко усложнение — това е лошо: появяват се повече малки компоненти, повече зъбни колела, а следователно, по-висок шанс за повреда. И те наистина ще се счупят. И ще се чупят по-често. Прост пример: да кажем, че имаме определен сайт, с PHP, MySQL. И той спешно трябва да бъде резервиран.
И така, взимаме втора платформа, изграждаме идентична система… Сложността нараства два пъти — имаме две същности. Освен това добавяме определена логика за прехвърляне на данни от едната платформа на другата — тоест репликация на данни, копиране на статиката и така нататък. И така, логиката за репликация — обикновено е много сложна и следователно, общата сложност на системата може да бъде не 2, а 3, 5, 10 пъти по-висока.
Втората примка: когато изграждаме наистина големи сложни системи, фантазираме какво искаме да постигнем в крайна сметка. Вуаля: искаме да получим супер надеждна система, която работи без никакви прекъсвания, превключва се за половин секунда (а още по-добре — мигновено), и започваме да реализираме мечтите си. Но тук също има нюанс: колкото по-малко е желаното време за превключване, толкова по-сложна става логиката на системата. Колкото по-сложна е логиката, толкова по-често системата ще се поврежда. И може да се окаже в много неприятна ситуация: опитваме се да намалим времето на прекъсване, а всъщност всичко усложняваме и когато нещо не върви както трябва, времето на престоя в крайна сметка ще бъде по-дълго. Често си хващаш мисълта: ето… по-добре да не бяхме резервирали. По-добре да работеше само едно с ясно време на престой.
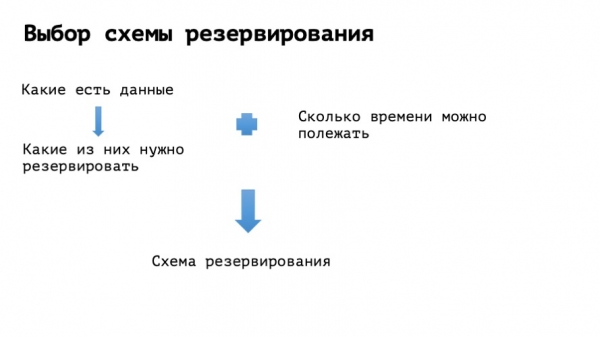
Как можем да се справим с това? Трябва да спрем да си лъжем, да спрем да се ласкаем, че тук ще построим космически кораб, а адекватно да разберем колко време проектът може да изчака. И в рамките на това максимално време ще изберем какви методи да използваме, за да повишим надеждността на нашата система.
Сега е моментът за „истории от живота“… от живота, разбира се.
Пример номер едно
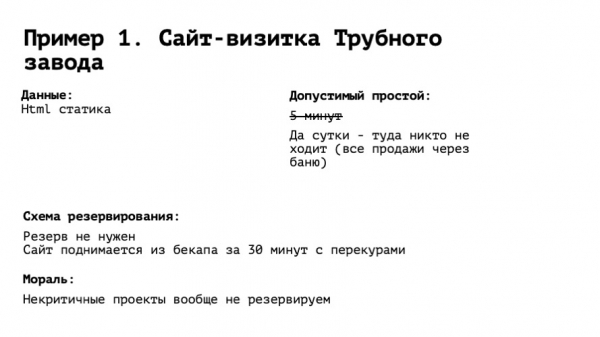
Представете си уебсайт на компания за производство на тръби №1 в град N. На него е написано с огромни букви - ЗАВОД ЗА ТРЪБИ №1. По-долу - слоган: „Нашите тръби са най-кръглите тръби в N“. И най-долу номерът на телефона на изпълнителния директор и неговото име. Разбираме, че е необходимо резервиране - това е много важен въпрос! Започваме да изследваме от какво е съставен. Html-статиката - тоест няколко картинки, на които изпълнителният директор с партньора си обсъждат някаква сделка. Започваме да си мислим за времето на простоя. В главата ми идва: трябва да лежи там пет минути, не повече. И тук идва въпросът: колко продажби вообще е направил този наш сайт? Колко-колко? Какво означава „нула“? А това, че всичките четири сделки от миналата година изпълнителният директор е направил на същата маса, с хората, с които ходят на баня и седят на масата. И разбираме, че дори и един ден да лежи сайтът - няма да се случи нищо страшно.
Изхождайки от подадената информация, имаме един ден за повдигане на тази ситуация. Започваме да мислим за схемата на резервиране. И избираме най-добрата схема за резервиране за този случай: ние не използваме резервиране. Цялото нещо може да бъде повдигнато от всеки администратор за половин час с кратки паузи. Инсталиране на уеб сървър, поставяне на файлове - всичко. То ще заработи. Няма нужда да се следи нещо, нищо не трябва да се обръща особено внимание. Тоест извода от пример номер едно е доста очевиден: услугите, които не трябва да се резервират - не трябва да се резервират.
Пример номер две
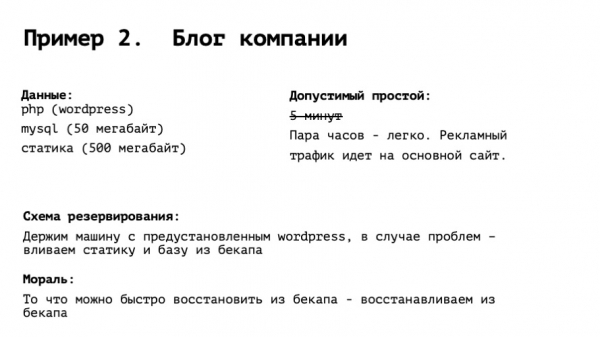
Блог на компанията: специално обучени пишат там новини, ето как ние участвахме в изложението и как пуснахме нов продукт и така нататък. Да предположим, това е стандартен PHP с WordPress, малка база данни и малко статично съдържание. Разбира се, отново ми идва на ум, че не можем да стоим неподвижно — "не повече от пет минути!", всичко това. Но да помислим по-дълбоко. Какво прави този блог? Там идват хора от Яндекс, от Гугъл по различни заявки, по органичен трафик. Чудесно. А как е свързано с продажбите? Осъзнаване: не особено. Рекламният трафик е насочен към основния сайт, който е на друга машина. Започваме да обмисляме схема за резервиране на блога. По принцип, за няколко часа трябва да го възстановим и би било хубаво да се подготвим за това. Разумно е да вземем машина в друг датацентър, да настроим средата, тоест уеб сървър, PHP, WordPress, MySQL и да оставим всичко да е в състояние на покой. В момента, когато разберем, че всичко се е счупило, трябва да направим две неща — да възстановим дамп на MySQL от 50 MB, който ще мине за минута, и да възстановим там определено количество снимки от бекъпа. Това също не е сложно. Така за половин час всичко е готово. Никакви репликации, или, господ да ни прости, автоматичен failover. Извод: това, което можем бързо да възстановим от бекъпа — не е нужно да бъде резервирано.
Пример номер три, малко по-сложен
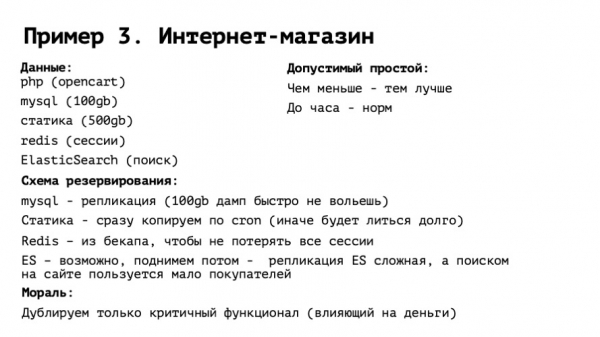
Интернет-магазин. PHP с малко преработен open heart, MySQL с солидна база. Доста статично съдържание (във всеки интернет-магазин има красиви HD снимки и всичко останало), Redis за сесии и Elasticsearch за търсене. Започваме да обмисляме време на престой. И тук е очевидно, че интернет-магазинът не може да стои безболезнено един ден. Защото колкото по-дълго е неактивен, толкова повече пари губим. Трябва да ускорим процеса. Но до колко? Предполагам, че ако постоим един час, никой няма да полудее. Да, нещо ще изгубим, но ако започнем да се стараем — ще стане само по-лошо. Определяме схемата на допустимия престой за час.
Как може да резервирате всичко това? Колата е необходима по всякакъв начин: един час време е доста малко. Mysql: тук вече е нужна репликация, активна репликация, защото за един час 100 ГБ в дамп, вероятно, няма да се вместят. Статиката, картинките: отново, за час 500 ГБ може да не успеят да се влеят. Затова е по-добре веднага да копирате картинките. Redis: тук е по-интересно. В Redis се съхраняват сесиите — просто да го вземем и да го изтрием, не можем. Защото това няма да е особено добре: всички потребители ще се окажат разлогинени, количките ще бъдат изчистени и т.н. Хората ще трябва да въвеждат отново своето логин и парола, и много от тях може да се откажат и да не завършат покупката. Отново, конверсията ще падне. От друга страна, Redis, който имаме, е актуален, с последните влезли потребители, сигурно също не е необходим. И добро компромисно решение е да вземете Redis и да го възстановите от архив, вчерашния, или, ако момичето ви прави архиви всеки час — на час назад. Важно е, че възстановяването му от архив е просто копиране на един файл. А най-интересната история е Elasticsearch. Кой някога е настройвал репликация на MySQL? Кой някога е настройвал репликация на Elasticsearch? И на кого тя е работила нормално след това? Става дума за видима в нашата система определена същност. Тя изглежда полезна — но е сложна.
Трудно в том смысле, что наши инженеры не имеют опыта работы с этой технологией. Либо есть негативный опыт. Либо мы понимаем, что это достаточно новая технология с нюансами или недостатками. Мы думаем... О, elastic тоже большой, его восстановление из резервной копии занимает много времени, что делать? Понимаем, что elastic в нашем случае используется для поиска. А как наш интернет-магазин осуществляет продажи? Мы обращаемся к маркетологам, чтобы узнать, откуда приходят пользователи. Они отвечают: "90% приходят с Яндекс-маркета прямо на страницу товара". И либо они покупают, либо нет. Следовательно, поиск нужен лишь 10% пользователей. А поддержка репликации elastic, особенно между различными дата-центрами в разных зонах, действительно имеет много нюансов. Какой выход? Мы используем elastic на резервированной площадке и ничего с ним не делаем. Если ситуация затянется, то мы, возможно, поднимем его позже, но это не точно. В общем, вывод плюс-минус прежний: сервисы, которые не влияют на доход, мы не резервируем. Чтобы схема оставалась проще.
Пример номер четири, еще сложнее
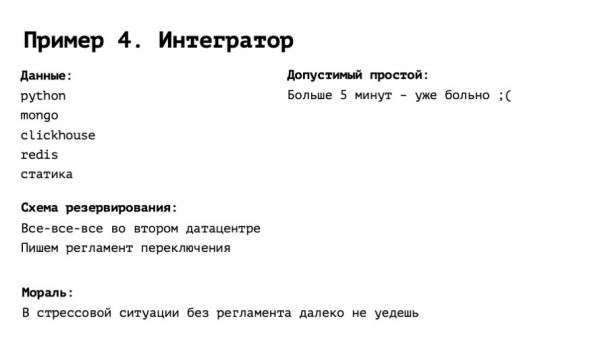
Интегратор: продажи цветов, вызов такси, продажа товаров, в общем, что угодно. Серьезная система, работающая 24/7 на большое количество пользователей. С полноценным интересным стеком, где есть интересные базы, решения, высокая нагрузка, и самое главное, она не может лежать больше 5 минут. Не только потому, что люди не купят, а потому что они увидят, что эта система не работает, расстроятся и могут вообще не вернуться.
Окей. Пять минут. Что будем делать с этим? В этом случае мы по-взрослому, с полной серьезностью строим настоящую резервную площадку, с репликацией всего и вся, и, возможно, даже максимально автоматизируем переключение на эту площадку. Кроме того, нельзя забывать о важной вещи: собственно, написать регламент переключения. Регламент, даже если у вас все автоматизировано, может быть очень простым. Например: «запустите данный сценарий ansible», «в route 53 установите такую-то галочку» и так далее — но это должен быть точный список действия.
И всичко изглежда ясно. Превключването на репликацията е тривиална задача, или тя ще се превключи сама. Пренаписването на домейн името в dns е от същото естество. Проблемът е, че когато подобен проект се срине, започва паника, и дори най-силните, опитни администратори могат да бъдат подложени на нея. Без ясна инструкция «отвори терминала, влез тук, адресът на нашия сървър все още е такъв» е трудно да издържиш времето от 5 минути, отредено за реанимация. И плюс, когато използваме този регламент, е лесно да фиксираме някакви промени в инфраструктурата, например, и съответно да изменим регламента.
Ако системата за резервиране е много сложна и в някакъв момент сме направили грешка, можем да загубим и нашата резервна площадка, а данните да се превърнат в тиква и на двете площадки — това ще бъде много тъжно.
Пример номер пет, пълен хардкор
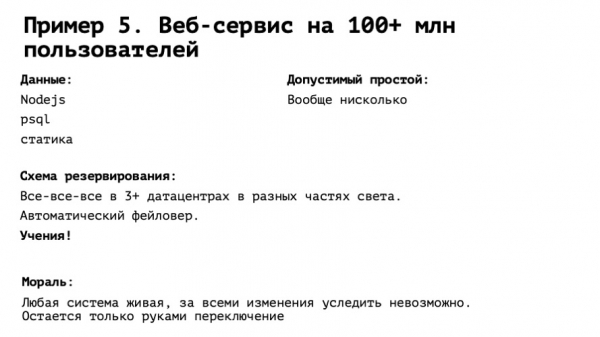
Международен сервис с стотици милиони потребители по целия свят. Всички часови зони, които съществуват, highload на максималните параметри, не може да има никакви откази. Една минута — и ще бъде тъжно. Какво да правим? Резервираме, отново, напълно. Направихме всичко, за което говорих в предишния пример, и още малко повече. Идеалният свят, и нашата инфраструктура — по всички понятия DevOps IaaC. Тоест всичко е в git, просто натискай бутона.
Какво липсва? Едно — учения. Без тях не може. Изглежда, че всичко е перфектно, всичко е под контрол. Натискаме бутона, всичко се случва. Дори и да е така — а ние разбираме, че така не е — нашата система взаимодейства с някои други системи. Например, това е dns от route 53, s3-хранилища, интеграция с някои api. Не можем да предвидим всичко в този умозрителен експеримент. И докато наистина не изключим ключа — няма да разберем дали ще работи или не.
На това, може би, е всичко. Не се мързелувайте и не се прекалявайте. И нека uptime бъде с вас!
Източник: habr.com
