

Здравей, Хабр! В тази статия искам да ти разкажа за един забележителен инструмент за разработка на партидни процеси за обработка на данни, например, в инфраструктурата на корпоративния DWH или твоето DataLake. Речта ще бъде за Apache Airflow (по-нататък Airflow). Той несправедливо е пренебрегнат на Хабр и в основната част ще се опитам да те убедя, че поне Airflow заслужава внимание, когато избираш планировчик за твоите ETL/ELT процеси.
По-рано написах серия от статии на тема DWH, когато работех в Тинькофф Банка. Сега станах част от екипа на Mail.Ru Group и се занимавам с развитието на платформа за анализ на данни в игровата индустрия. Собствено, с появата на новини и интересни решения, ние с екипа ще разказваме тук за нашата платформа за аналитика на данни.
Преамбула
И така, да започнем. Какво е Airflow? Това е библиотека (или ) за разработка, планиране и мониторинг на работни потоци. Основната особеност на Airflow е, че за описанието (разработката) на процесите се използва код на Python. Оттук произлизат многобройни предимства за организацията на проекта и разработката: по същество твоят (например) ETL проект е просто Python проект и можеш да го организираш както ти е удобно, имайки предвид особеностите на инфраструктурата, размера на екипа и други изисквания. Инструментално всичко е просто. Използвай, например, PyCharm + Git. Това е прекрасно и много удобно!
Сега нека разгледаме основните единици на Airflow. Разбирайки тяхната същност и предназначение, ще организираш оптимално архитектурата на процесите. Може би основната единица е Directed Acyclic Graph (по-нататък DAG).
DAG
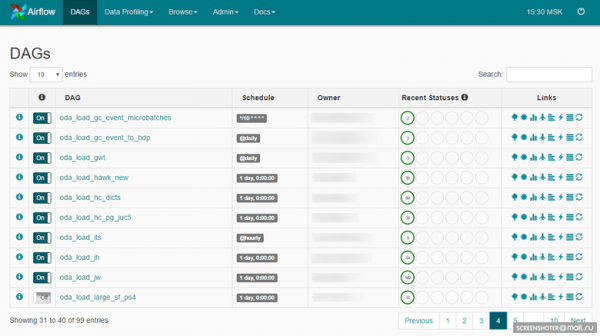
DAG е своеобразно смислово обединение на задачите, които искаш да изпълниш в строго определена последователност по определено разписание. Airflow предлага удобен уеб интерфейс за работа с DAG’и и други единици:
DAG може да изглежда по следния начин:
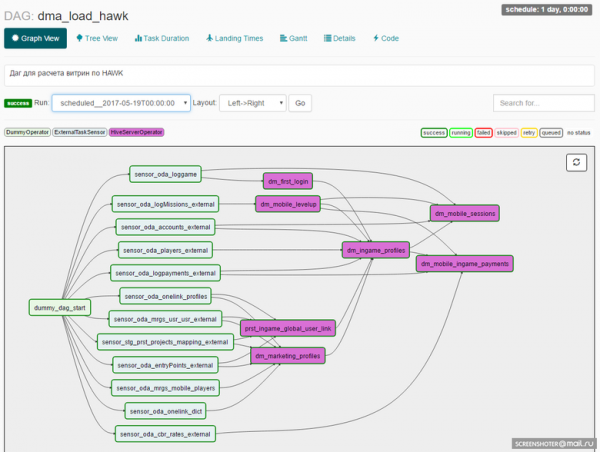
Когато разработчик проектира DAG, той определя набор оператори, на които ще се изградят задачите вътре в DAG’а. Тук стигаме до още една важна единица: Airflow Operator.
Оператори
Оператор е единица, на базата на която се създават екземпляри на задания, в които се описва какво ще се случва по време на изпълнението на екземпляра на заданието. вече съдържат набор от оператори, готови за използване. Примери:
- BashOperator — оператор за изпълнение на bash команда.
- PythonOperator — оператор за извикване на Python код.
- EmailOperator — оператор за изпращане на имейл.
- HTTPOperator — оператор за работа с HTTP заявки.
- SqlOperator — оператор за изпълнение на SQL код.
- Sensor — оператор за изчакване на събитие (достигане на определено време, появяване на необходим файл, ред в базата данни, отговор от API и т.н.).
Има по-специфични оператори: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Можете също така да разработвате оператори, съобразени с вашите специфики, и да ги използвате в проекта. Например, ние създадохме MongoDBToHiveViaHdfsTransfer, оператор за експортиране на документи от MongoDB в Hive, и няколко оператора за работа с : CHLoadFromHiveOperator и CHTableLoaderOperator. По същество, когато в проекта възникне често използван код, базиран на основни оператори, можете да помислите за създаването на нов оператор. Това ще улесни по-нататъшната разработка и ще обогати библиотеката ви от оператори в проекта.
След това всички тези екземпляри на задачи трябва да бъдат изпълнени, и сега ще говорим за планировчика.
Планировчик
Планировчикът на задачи в Airflow е построен на . Celery е Python библиотека, която позволява организиране на опашка плюс асинхронно и разпределено изпълнение на задачи. От страна на Airflow всички задачи се разделят на пули. Пулите се създават ръчно. Обикновено целта им е да ограничат натоварването при работа с източника или да типизират задачите в DWH. Пулове могат да се управляват през уеб интерфейс:
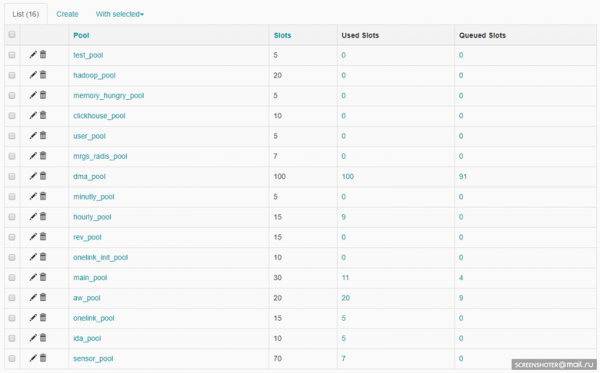
Всеки пул има ограничение на броя слотове. При създаването на DAG, му се задава пул:
ALERT_MAILS =  Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
Пулът, зададен на ниво DAG, може да бъде преопределен на ниво задача.
За планирането на всички задачи в Airflow отговаря отделен процес — Scheduler. Всъщност, Scheduler се занимава с механиката на поставянето на задачите за изпълнение. Задачата, преди да бъде изпълнена, преминава през няколко етапа:
- В DAG'а са изпълнени предишните задачи, новата може да бъде поставена в опашка.
- Опашката се сортира в зависимост от приоритета на задачите (приоритетите също могат да се управляват) и, ако в пула има свободен слот, задачата може да бъде поета за работа.
- Ако има свободен worker celery, задачата се отправя към него; започва работа, която сте програмирали в задачата, използвайки определен оператор.
Достатъчно е просто.
Scheduler работи с множество DAG'ове и всички задачи внутри DAG'ов.
За да започне Scheduler да работи с DAG'а, DAG'ът трябва да зададе график:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Има набор от готови preset'ове: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Също така можете да използвате cron-изрази:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Execution Date
За да разберете как работи Airflow, е важно да разберете какво е Execution Date за DAG'а. В Airflow DAG има измерение Execution Date, т.е. в зависимост от графика на работа на DAG'а се създават инстанции на задачите за всяка Execution Date. И за всяка Execution Date задачите могат да се изпълняват повторно — или, например, DAG'ът може да работи едновременно в няколко Execution Date. Това е наглядно показано тук:
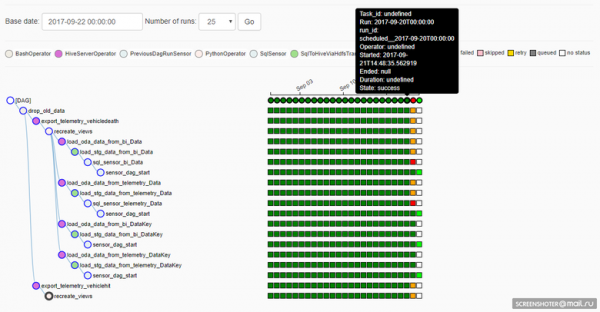
За съжаление (или може би и на щастие: зависи от ситуацията), ако се коригира реализацията на задачата в DAG'а, изпълнението в предишните Execution Date ще се случи вече с отчитане на корекциите. Това е добре, ако трябва да пресметнете данните за предишни периоди с нов алгоритъм, но е лошо, защото се губи възпроизводимостта на резултата (разбира се, никой не пречи да върнете необходимата версия на изходния код от Git и да сметнете това, което трябва, по начина, по който трябва).
Генерация на задачи
Реализацията на DAG'а е код на Python, затова имаме много удобен начин да съкратим обема на кода, например при работа с шардировани източници. Нека имате три шарда MySQL като източник, трябва да влезете в всеки от тях и да вземете определени данни. Освен това независимо и паралелно. Кодът на Python в DAG'а може да изглежда така:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG-ът изглежда така:
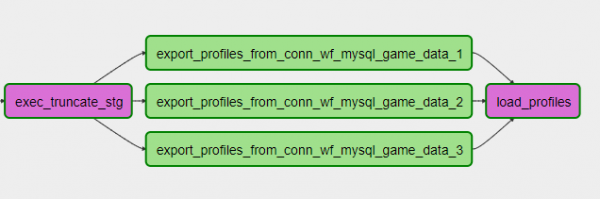
Можете също така да добавяте или премахвате шард, просто като коригирате настройките и обновите DAG. Удобно е!
Можете да използвате и по-сложна генерация на код, например, да работите с източници под формата на бази данни или да опишете табличната структура, алгоритъма за работа с таблицата и, взимайки предвид особеностите на инфраструктурата DWH, да генерирате процес за зареждане на N таблици във вашето хранилище. Или, например, работа с API, което не поддържа работа с параметър под формата на списък; можете да генерирате N задачи в DAG-а по този списък, да ограничите паралелизма на запитванията в API с пул и да извлечете необходимите данни от API. Гъвкаво!
Репозитория
В Airflow има собствен бекенд-репозиторий, база данни (може да е MySQL или Postgres, при нас е Postgres), в която се съхраняват състояния на задачите, DAG-ове, настройки на връзките, глобални променливи и т.н. Тук бих искал да подчертая, че репозиторият в Airflow е много прост (около 20 таблици) и удобен, ако искате да изградите собствен процес върху него. Спомням си за 100500 таблици в репозитория на Informatica, които трябваше да се изучават дълго, преди да разбера как да изградя запитване.
Мониторинг
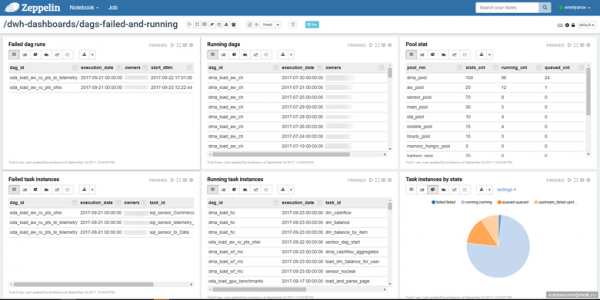
С оглед на простотата на репозитория, можете сами да изградите удобен за вас процес за мониторинг на задачите. Ние използваме блокнот в Zeppelin, където следим състоянието на задачите:
Това може да бъде и уеб интерфейсът на самия Airflow:
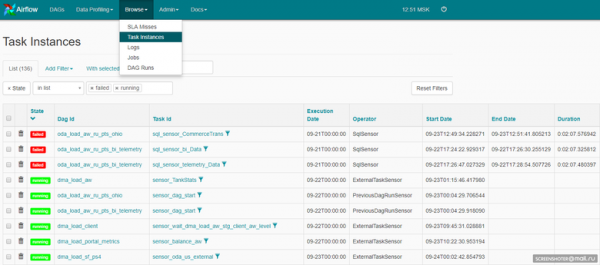
Кодът на Airflow е отворен, затова добавихме аларми в Telegram. Всеки работещ инстанс на задача, при възникване на грешка, спамва в групата в Telegram, където е целият екип за разработка и поддръжка.
Получаваме оперативна реакция чрез Telegram (ако е необходимо), а чрез Zeppelin — обща картина на задачите в Airflow.
Общо
Airflow е преди всичко с отворен код и не трябва да очаквате чудеса от него. Бъдете готови да отделите време и усилия, за да изградите работещо решение. Целта е постижима, вярвайте, че си заслужава. Скоростта на разработка, гъвкавостта, простотата на добавяне на нови процеси — ще ви хареса. Разбира се, трябва да обърнете много внимание на организацията на проекта и стабилността на самия Airflow: чудеса не се случват.
В момента Airflow ежедневно обработва около 6500 задачи. По характеру те са доста различни. Има задачи за зареждане на данни в основното DWH от много различни и много специфични източници, има задачи за изчисляване на витрини в основното DWH, има задачи за публикуване на данни в бързото DWH, има много-много различни задачи — и Airflow всичките ги обработва ден след ден. Ако говорим с числа, то това 2,3 хиляди ELT задачи с различна сложност вътре в DWH (Hadoop), около 2,5 стотин бази данни източници, това е екип от 4 ETL разработчици, които се разделят на ETL обработка на данни в DWH и на ELT обработка на данни вътре в DWH и, разбира се, на един администратор, който се занимава с инфраструктурата на услугата.
Планове за бъдещето
Броят на процесите неизбежно нараства, и основното, с което ще се занимаваме в частта инфраструктура на Airflow, е мащабиране. Искаме да изградим Airflow кластер, да отделим няколко нозе за работниците на Celery и да направим дублираща се глава с процеси за планиране на задания и репозиторий.
Епилог
Разбира се, това далеч не е всичко, което бих искал да разкажа за Airflow, но основните моменти се опитах да осветля. Апетитът идва с яденето, опитайте — и ще ви хареса 🙂
Източник: habr.com
