

Идеята на статията се роди спонтанно от дискусия в коментарите към статия. .
Става дума за това, че вътрешната специфика на работата на нашите услуги се състои в съхраняването на огромно количество малки файлове. В момента разполагаме с около стотици терабайти от тези данни. И срещнахме известно количество очевидни и не толкова очевидни проблеми и успешно ги преодоляхме.
Затова споделям нашия опит, може би някому ще бъде от полза.
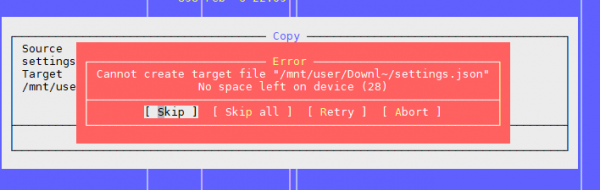
Проблем номер едно: «No space left on device»
Както се споменава в споменатата статия, проблемът е, че свободните блокове на файловата система са налични, но inode-ите са свършили.
Броят на използваните и свободни inodes може да се провери с командата df -ih:
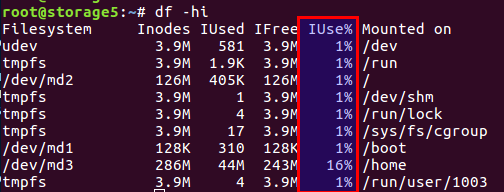
Няма да повтарям статията, така че накратко, на диска има както блокове директно за данни, така и блокове за метаинформация, т.нар. inodes (index node). Тяхното количество се задава при инициализацията на файловата система (става въпрос за ext2 и нейните наследници) и след това не се променя. Балансът между блоковете данни и inodes се изчислява от статистически данни, но в нашия случай, при многото малки файлове, балансът трябва да се наклони в посока на броя на inodes — те трябва да бъдат повече.
В Linux вече са предвидени варианти с различен баланс, а всички тези предварително изчислени конфигурации са в файла /etc/mke2fs.conf.
Следователно, при първоначалната инициализация на файловата система чрез mke2fs можете да зададете необходимия профил.
Ето няколко примера от файла:
    small = {
        blocksize = 1024
        inode_size = 128
        inode_ratio = 4096
    }

    big = {
        inode_ratio = 32768
    }

    largefile = {
        inode_ratio = 1048576
        blocksize = -1
    }
Можете да изберете необходимия вариант на приложение с опцията «-T» при извикването на mke2fs. Можете също така ръчно да зададете нужните параметри, ако няма готово решение.
Повече подробности са описани в ръководствата за mke2fs.conf и mke2fs.
Необсъждана в споменатата статия особеност — можете да зададете размера на блока данни. Очевидно е, че за големи файлове има смисъл да се използва по-голям размер на блока, а за малките — по-малък.
Но трябва да се вземе предвид и интересна особеност, като архитектурата на процесора.
В един момент се замислих, че за големи файлове снимки ми е нужен по-голям размер на блока. Беше в домашни условия, на домашен файл хранилище на WD с архитектура ARM. Без много да мисля, зададох размера на блока на 8к или 16к вместо стандартните 4к, предварително измервайки спестяването. И всичко беше чудесно, докато самото хранилище не излезе от строй, при все че диска беше жив. Поставяйки диска в обикновен компютър с обикновен Intel процесор, получих изненада: неподдържан размер на блока. Приплувахме. Данните са налични, всичко е наред, но не можеше да бъде прочетено. Процесорите i386 и подобни не умеят да работят с размери на блока, които не съответстват на размера на страницата в паметта, а той е точно 4к. Като цяло, всичко завърши с използване на утилити от потребителска среда, всичко беше бавно и тъжно, но данните бяха спасени. На когото му е интересно — гуглете по името на утилитата. fuseext2. Морал: или планирайте всичките случаи предварително, или не се правете на супергерой и ползвайте стандартните настройки за домакинства.
UPD. По забележка на потребителя уточнявам, че за i386 размерът на блока не трябва да надхвърля 4к, но не е задължително да е точно 4к, т.е. допустими са 1к и 2к.
И така, как решаваме проблемите.
На първо място, с проблема се сблъскахме, когато многотерабайтният диск беше запълнен с данни и не можехме да променим конфигурацията на файловата система.
На второ място, решението беше спешно.
В крайна сметка стигнахме до извода, че трябва да променим баланса, намалявайки броя на файловете.
За да намалим броя на файловете, решихме да съберем файловете в един общ архив. Като вземем предвид нашата специфика, натрупвахме в един архив всички файлове за определен период от време и правехме архивиране с cron задача ежедневно през нощта.
Избрахме zip-архив. В коментарите на предишната статия се предлагаше tar, но с него има едно усложнение: той няма съдържание, а файловете в него са подредени последователно (не просто така „tar“ — това е съкращение от „Tape Archive“, наследство от ленточните носители), т.е. ако трябва да прочетете файл в края на архива — трябва да прочетете целия архив, тъй като в него няма отмествания за всеки файл спрямо началото на архива. И затова, това е дълга операция. При zip всичко е много по-добре: той има съответното съдържание и отмествания на файловете в архива, и времето за достъп до всеки файл не зависи от неговото местоположение. А в нашия случай можеше да се зададе опция за компресия „0“, тъй като всички файлове вече бяха предварително компресирани в gzip.
Клиентите свалят файловете през nginx, и съгласно старото API се посочва просто името на файла, например така:
http://www.server.com/hydra/20170416/0453/3bd24ae7-1df4-4d76-9d28-5b7fcb7fd8e5
За да разархивираме файловете на лета, намерихме и свързахме модула nginx-unzip-module () и конфигурирахме два upstream-а.
В резултат на това получихме такава конфигурация:
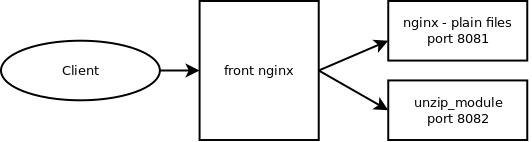
Двата хоста в настройките изглеждаха така:
server {
  listen *:8081;

  location / {
    root /home/filestorage;
  }
}
server {
listen *:8082;
location ~ ^/hydra/(\d+)/(\d+)/(.*)$ {
root /home/filestorage;
file_in_unzip_archivefile "/home/filestorage/hydra/$1/$2.zip";
file_in_unzip_extract "$2/$3";
file_in_unzip;
}
}
И конфигурацията на upstream-ите на по-горния nginx:
upstream storage {
  server server.com:8081;
  server server.com:8082;
}
Как работи:
- Клиентът отива на front nginx
- Front nginx се опитва да предостави файла от първия upstream, т.е. директно от файловата система
- Ако файла го няма — се опитва да го предостави от втория upstream, който се опитва да намери файла в архива
Втората проблема: отново „No space left on device“
Това е втората проблема, с която се сблъскваме, когато в каталога има много файлове.
Опитваме се да създадем файл, системата се оплаква, че няма места. Променяме името на файла и отново се опитваме да го създадем.
Получава се.
Изглежда по този начин:

Проверка на inodes не даде резултат — има много свободни.
Проверка за място — същото.
Помислихме, че може да има твърде много файлове в каталога, и за това има ограничение, но отново не: Максимален брой файлове на директория: ~1.3 × 10^20
Но и файл може да бъде създаден, ако се смени името.
Извод — проблемът е в името на файла.
По-нататъшните търсения показаха, че проблемът е в алгоритъма за хеширане при изграждането на индекса на каталога, при голям брой файлове се наблюдават колизии със всички произтичащи последствия. По-подробно можете да прочетете тук:
Тази опция може да бъде деактивирана, но... търсенето на файл по име може да отнеме непредсказуемо дълго време, когато се извършва проверка на всички файлове.
tune2fs -O "^dir_index" /dev/sdb3
Общо взето, като временно решение може да сработи.
Морал: много файлове в директорията обикновено е лоша идея. Не трябва да правим така.
Обикновено в такива случаи се създават вложени директории, по първите букви на името на файла или по други параметри, например по дати, което в повечето случаи помага.
Но общият брой на малките файлове все пак е проблематичен, дори ако са организирани в директории — тогава вижте първия проблем.
Проблем трети: как да видим списъка с файлове, ако те са много.
В нашата ситуация, когато имаме много файлове, така или иначе се сблъскваме с проблема как да видим съдържанието на директорията.
Стандартното решение е командата ls.
Добре, нека да видим какво става с 4772098 файла:
$ time ls /home/app/express.repository/offercache/ >/dev/null

real	0m30.203s
user	0m28.327s
sys	0m1.876s
30 секунди... малко много. Основното време се изразходва за обработка на файловете в потребителското пространство, а не за работа на ядрото.
Но има решение:
$ time find /home/app/express.repository/offercache/ >/dev/null

real	0m3.714s
user	0m1.998s
sys	0m1.717s
3 секунди. 10 пъти по-бързо.
Ура!
UPD.
Още по-бързо решение от потребителя — деактивиране на сортирането на ls
time ls -U /home/app/express.repository/offercache/ >/dev/null
real	0m2.985s
user	0m1.377s
sys	0m1.608s
Проблем четвърти: висок LA при работа с файлове.
Периодично възниква ситуация, когато трябва да копирате много файлове от една машина на друга. При това често LA нараства значително, тъй като всичко зависи от производителността на самите дискове.
Най-разумното решение е да се използват SSD. Реално е страхотно. Въпросът е само в цената на многотерабайтните SSD.
Но ако дисковете са обикновени, файловете трябва да се копират, а това е в производствена система, където претоварването води до недоволство от клиентите? Има поне два полезни инструмента: nice и ionice.
nice — намалява приоритета на процеса, следователно шедулерът разпределя повече времеви квоти на други, по-приоритетни процеси.
В нашата практика е помогнало да настроим nice на максимума (19 — това е минимален приоритет, -20 (минус 20) — максимален).
ionice — съответно коригира приоритета на входно/изходното разписание (I/O scheduling).
Ако използвате RAID и той внезапно трябва да се синхронизира (след неуспешен ребут или нужда от възстановяване на RAID масив след смяна на диск), в определени ситуации има смисъл да намалите скоростта на синхронизация, за да могат останалите процеси да работят сравнително адекватно. За целта ще помогне следната команда:
echo 1000 > /proc/sys/dev/raid/speed_limit_max
Проблем пети: Как да синхронизираме файлове в реално време
Имаме същите огромни количества файлове, които трябва да архивираме на втория сървър, за да избегнем… Файловете постоянно се записват, така че, за да имаме минимални загуби, трябва да ги копираме максимално бързо.
Стандартното решение: Rsync по SSH.
Това е добро решение, освен ако не е нужно да го правите на всеки няколко секунди. А файловете са много. Дори ако не ги копираме — трябва по някакъв начин да разберем какво се е променило, а сравнението на няколко милиона файла е време и натоварване на дисковете.
Т.е. трябва да знаем веднага какво трябва да копираме, без да стартираме сравнение всеки път.
Спасението е — lsyncd. Lsyncd — . Той също работи чрез rsync, но допълнително наблюдава файловата система за промени, използвайки inotify и fsevents, и стартира копирането само за тези файлове, които са се появили или променили.
Проблем шести: как да разберем, кой натоварва дисковете
Това вероятно е известно на всички, но все пак за пълната картина: за мониторинг на дисковата подсистема има команда iotop — подобно на top, но показва процесите, които най-активно използват дисковете.
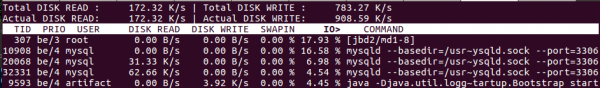
Между другото, старият добър top също позволява да се разбере, дали има проблеми с дисковете. За целта има два най-подходящи параметъра: Средно натоварване и IOwait.
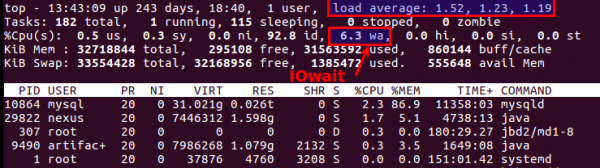
Първият показва колко процеси стоят в опашката за обслужване, обикновено над 2 — вече нещо не е наред. При активно копиране на архивни сървъри допускаме до 6-8, след това ситуацията се счита за аварийна.
Вторият — до колко процесорът е ангажиран с дисковите операции. IOwait >10% — причина за притеснение, въпреки че при нас на сървъри със специфичен натоварен профил може стабилно да достига 40-50%, и това е наистина норма.
С това ще завърша, макар че със сигурност има много моменти, с които не сме се сблъсквали, с удоволствие ще очаквам коментари и описания на интересни реални случаи.
Източник: habr.com
