

В живота е казано, че всичко трябва да се опита поне веднъж. И ако сте свикнали да работите с релейни бази данни, запознаването на практика с NoSQL заслужава да се направи най-вече за общо развитие. В момента, с бурното развитие на тази технология, съществуват много противоречиви мнения и оживени спорове по тази тема, което особено подгрява интереса.
Ако се потопите в същността на всички тези спорове, ще видите, че те произтичат от неправилния подход. Тези, които използват NoSQL бази точно там, където те са нужни, са доволни и получават всички предимства от това решение. А експериментаторите, които разчитат на тази технология като панацея там, където тя не е приложима изобщо, изпитват разочарование, губейки силните страни на релейните бази без да получат значителни ползи.
Ще разкажа за опита ни с внедряването на решение, основано на базата данни Cassandra: с какви трудности се сблъскахме, как се справяхме в трудните ситуации, успяхме ли да получим предимство от използването на NoSQL и къде трябваше да инвестираме допълнителни усилия/средства.
Първоначалната задача е изграждането на система, която записва обаждания в определено хранилище.
Принципът на действие на системата е следният. На входа постъпват файлове с определена структура, описваща формата на обаждането. След това приложението осигурява запазването на тази структура в съответните колони. Запазените обаждания впоследствие се използват – за показване на информация за потреблението на трафик за абонатите (начисления, обаждания, история на баланса).
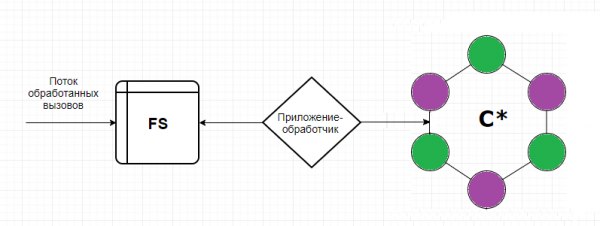
Защо избрахме Cassandra е напълно разбираемо — тя записва като автоматичен пистолет, лесно се мащабира и е отказоустойчива.
И така, ето какво ни донесе опитът.
Да, излезнала нода не е трагедия. Това е същността на отказоустойчивостта на Cassandra. Но нода може да е жива и все пак да започне да се представя с по-ниска производителност.. Както се оказа, това веднага се отразява на производителността на целия кластер.
Cassandra не осигурява защита там, където Oracle спасява с ограниченията си.. И ако авторът на приложението предварително не е разбрал това, то постъпилият дублиран запис за Cassandra никак не е по-лош от оригинала. Раз тaм е, значи ще вкараме.
Безплатната Cassandra "от кутията" рязко не хареса ИБ: няма логиране на действията на потребителите, нито разпределение на правата.. Информация за повикванията се отнася до лични данни, което означава, че всички опити за тяхното искане/промяна трябва да бъдат регистрирани с възможност за последващ одит. Също така, трябва да се осъзнава необходимостта от разделяне на правата на различни нива за различни потребители. Обикновеният инженер по експлоатация и супер администратор, който свободно може да изтрие целия ключов пространствен обект – това са различни роли, различна отговорност, компетентност. Без такова разграничение на правата за достъп, стойността и целостта на данните ще бъдат поставени под въпрос много по-бързо, отколкото при ниво на съвместимост ANY.
Не взехме предвид, че за повикванията е необходима както сериозна аналитика, така и периодични извадки по най-различни условия. Тъй като избраните записи по-късно се предполага, че ще бъдат изтрити и презаписани (в рамките на задачата трябва да поддържаме процеса на актуализиране на данните при първоначално неверни данни), то Кассандра не е наш приятел тук. Кассандра, като касичка – удобно е да се съхранява, но не може да се смята.
Сблъскахме се с проблема с преноса на данни в тестовите зони. (5 нода в теста срещу 20 в продукцията). В такъв случай не може да се използва дамп.
Проблем с актуализацията на схемата на приложението, което записва в Кассандра. Откатът ще създаде множество надгробия, което непредсказуемо може да ни подведе към загуба на производителност.. Кассандра е оптимизирана за запис, и преди да запише, не мисли много. Всяка операция с съществуващи данни в нея също е запис. Т.е. като изтриваме ненужното, просто ще произведем още повече записи, и само част от тях ще бъдат маркирани като надгробия.
Таймаути при вставката. Кассандра е прекрасна при записите, но понякога входящият поток може да я затрудни значително.. Това се случва, когато приложението започне да върти няколко записа, които не могат да бъдат инсталирани поради някаква причина. И ще ни се наложи да имаме истински DBA, който да следи gc.log, системните и дебъг логовете за бавни заявки, метрики за чакане на компактиране.
Няколко дата центъра в клъстера. От къде да четем и къде да пишем?
Възможно ли е да разделим на четене и запис? И ако да, трябва ли ДЦ за запис или за четене да бъде по-близо до приложението? И няма ли да получим истински split brain, ако неправилно изберем нивото на съгласуваност? Много въпроси, много неизследвани настройки и възможности, които искаме да разгледаме.
Как решихме
За да предотвратим спад на нодата, изключихме SWAP. И сега, при недостиг на памет, нодата трябва да падне, а не да генерира дълги паузи за gc.
Така че вече не разчитаме на логиката в БД. Разработчиците на приложението започват да се обучават отново и активно да се подсигуряват в собствения си код. Идеалното ясно разделение на съхранение и обработка на данни.
Закупихме поддръжка от DataStax. Коробъчната Касандра вече не се разработва (последният комит е от февруари 2018 г.). В същото време, Datastax предлага отличен сервиз и много адаптирани решения за съществуващи ИС.
Искам още да отбележа, че Касандра не е много удобна за селективни запитвания. Разбира се, CQL е голяма стъпка напред за потребителите (в сравнение с Trift). Но ако имате цели отдели, свикнали с удобно свързване, свободна филтрация по всяко поле и възможности за оптимизация на запитванията, и тези отдели работят, за да решават проблеми и аварии, то решението на Касандра изглежда като враждебно и нелепо за тях. И започнахме да решаваме как нашите колеги да правят селекции.
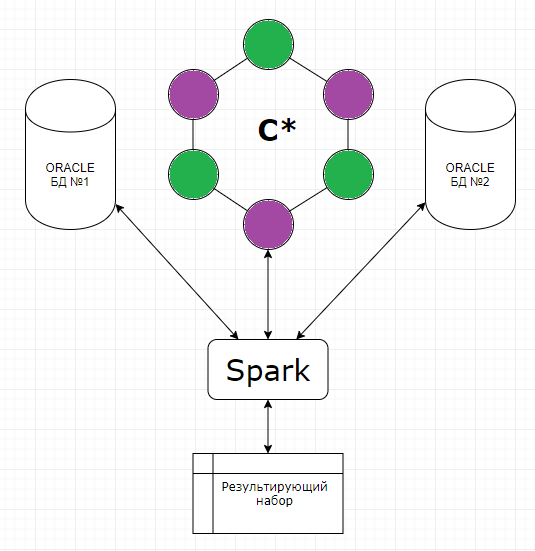
Обсъдихме два варианта. В първия вариант записваме извиквания не само в C*, но и в архивната БД Oracle. Само че, в отличие от C*, в тази БД се съхраняват извиквания само за текущия месец (достатъчна дълбочина на съхранение на извикванията за случаите на повторно тарифиране). Тук веднага се видя следния проблем: ако записваме синхронно, губим всичките предимства на C*, свързани с бързото вмъкване, а ако асинхронно – няма гаранция, че всички нужни извиквания изобщо попадат в Oracle. Плюсът беше един, но значителен: за експлоатация остава същият познат PL/SQL Developer, т.е. практически реализираме шаблона „Фасада“. Алтернативен вариант. Реализираме механизъм, който извлича извиквания от C*, тегли определени данни за обогатяване от съответните таблици в Oracle, обединява получените извадки и предлага получения резултат, който после по някакъв начин използваме (откатваме, повтаряме, анализираме, възхищаваме се). Недостатъци: процесът се оказва доста многопластов, а освен това липсва интерфейс за служителите по експлоатация.
В крайна сметка се спряхме все пак на втория вариант. За извадки от различни банки използвахме Apache Spark. Същността на механизма се състоеше в Java код, който по посочените ключове (абонат, време на извикването – ключове на раздела) извлича данни от C*, както и нужните данни за обогатяване от всяка друга БД. След което ги обединява в паметта си и извежда резултата в резултатната таблица. Над Spark създадохме уеб интерфейс и това се оказа напълно пригодно за експлоатация.
При решаването на проблема с обновяването на данните, промо тест отново разгледа няколко начина за решение. Както преносът чрез Sstloader, така и вариантът с разделяне на клъстера в тестовата зона на две части, от които всяка последователно влиза в един клъстер с промоционалния, захранвайки се по този начин от него. При обновяването на теста планирахме да ги разменим: частта, която работеше в теста, да се изчисти и да се въведе в промо, а другата да започне да работи с данните отделно. Въпреки това, след като се замислихме отново, оценихме по-рационално данните, които си струва да бъдат пренесени, и разбрахме, че самите извиквания - неконсистентна същност за тестовете, бързо генерирана при необходимост, и именно промоционалният набор от данни няма стойност за пренос в теста. Има няколко обекта-накопители, които си струва да се пренесат, но това буквално са две таблици, и то не много тежки. Затова ни в качеството на решение отново ни помогна Spark, с помощта на който написахме и започнахме активно да използваме скрипт за пренос на данни между таблиците промо-тест.
Нашата текуща политика за разгръщане ни позволява да работим без връщане назад. Пред промоцията е задължителен накат на тест, където грешката не е толкова скъпа. При неуспех винаги можем да изтрием кейспейса и да приложим цялата схема отначало.
За осигуряване на непрекъсната наличност на Кассандра е нужен DBA и не само той. Всички, които работят с приложението, трябва да разбират къде и как да следят текущото състояние и как да диагностицират проблеми навреме. За тази цел активно използваме DataStax OpsCenter (Администриране и мониторинг на работни натоварвания), системни метрики на Cassandra Driver (броя на таймаутите при запис в C*, броя на таймаутите при четене от C*, максимална латентност и т.н.), следим работата на самото приложение, което работи с Кассандра.
Когато се замислихме за предишния въпрос, осъзнахме къде може да се крие основният риск. Това са формите за представяне на данни, които извличат информация от няколко независими запитвания към хранилището. По този начин можем да получим доста противоречива информация. Но този проблем би бил актуален и ако работехме само с един дата център. Най-разумното в този случай е, разбира се, да се направи батчова функция за четене на данни от странично приложение, което осигурява получаване на данни в единичен период от време. Що се отнася до разделението на четене и запис в плана за производителност, тук ни спря риска, че при евентуално прекъсване на свързаността между дата центровете можем да получим два напълно несъгласувани клъстера.
В крайна сметка, в момента спряхме се на нивото на съгласуваност за запис EACH_QUORUM, за четене – LOCAL_QUORUM
Кратки впечатления и изводи
За да оценим полученото решение от гледна точка на експлоатационна поддръжка и перспективите за бъдещо развитие, решихме да помислим къде още може да се приложи такава разработка.
Ако трябва да спомена, то е скоринг на данни за програми от типа „Плати, когато удобно“ (качваме информация в С* с разчети на скриптове Spark), управление на рекламации с агрегация по направления, съхранение на роли и изчисление по ролевата матрица на правата на достъп на потребителите.
Както виждаме, репертоарът е широк и разнообразен. И ако трябва да изберем страна между привържениците/противниците на NoSQL, ние ще се присъединим към привържениците, тъй като получихме своите предимства, и именно там, където очаквахме.
Дори вариантът Cassandra от кутията позволява да се осъществява хоризонтално мащабиране в реално време, напълно безболезнено решавайки проблема с увеличаването на данните в системата. Успяхме да изнесем в отделен контур много натоварен механизъм за изчисление на агрегати по повиквания, както и да разделим схемата и логиката на приложението, освобождавайки се от порочната практика на написване на кастомни джобове и обекти в самата база данни. Получихме възможността да изберем и настроим, за ускорение, на кои дата центрове ще извършваме изчисления, а на кои запис на данни, като се защитихме от падания както на отделни нодове, така и на целия дата център.
Прилагая нашата архитектура към новите проекти, с вече натрупан опит, бихме искали веднага да вземем предвид посочените по-горе детайли и да избегнем някои грешки, както и да изгладим остри ъгли, които не успяхме да избегнем в началото.
Например, да проследяваме навреме актуализациите на самата Касандра, защото доста от проблемите, които срещнахме, вече бяха известни и решавани.
Да не поставяме и самата БД, и Спарк на едни и същи възли (или стриктно да разделяме по количеството разрешено използване на ресурси), тъй като Спарк може да използва повече ОП, отколкото е позволено, и бързо ще получим проблема номер 1 от нашия списък.
Да развиваме мониторинга и компетенцията по експлоатацията още на етапа на тестване на проекта. Първоначално да вземем предвид максимално всички потенциални потребители на нашето решение, защото именно от това ще зависи в крайна сметка структурата на БД.
Няколко пъти да прегледаме получения план за възможна оптимизация. Да определим кои полета можем да сериализираме. Да разберем какви допълнителни таблици трябва да създадем, за да вземем под внимание и след това да предоставим по заявка необходимата информация (например, допускайки, че същите данни можем да съхраняваме в различни таблици, като взимаме предвид различно разпределение по различни критерии, можем значително да спестим процесорно време при операции за четене).
Не е зле веднага да предвидим добавяне на TTL и почистване на остарели данни.
При извличане на данни от Касандра логиката на приложението трябва да работи на принципа FETCH, за да не се зареждат всички редове в паметта едновременно, а да се избират на групи.
Предпочитателно е преди прехвърлянето на проекта на описаното решение да проверим устойчивостта на системата, провеждайки серия от тестове за срив, като например загуба на данни в един ЦОД, възстановяване на повредени данни за определен период, спад в мрежата между ЦОД-ите. Такива тестове не само ще позволят да оценим предимствата и недостатъците на предлаганата архитектура, но и ще дадат добра практика на инженери, провеждащи ги, а придобитият опит няма да е излишен, ако системните откази се повторят в производството.
Ако работим с критична информация (като данни за фактуриране, изчисление на задълженията на абоната), е важно да обърнем внимание на инструментите, които ни позволяват да намалим рисковете, произтичащи от спецификите на СУБД. Например, можем да използваме утилитата nodesync (Datastax), като разработим оптимална стратегия за нейното използване, така че да не създаваме излишно натоварване на Кассандра заради консистентността и да я използваме само за определени таблици в конкретен период.
Какво да кажем, след половин година с Кассандра? В общи линии, няма нерешени проблеми. Не допуснахме сериозни аварии и загуба на данни. Да, наложи се да помислим за компенсация на някои проблеми, които не се бяха появявали преди, но в крайна сметка това не развали архитектурното ни решение. Ако искате и не се страхувате да опитате нещо ново, и същевременно не искате да бъдете силно разочаровани, бъдете готови да приемете, че нищо не е безплатно. Ще трябва да се запознаете, да навлезете в документацията и да съберете собствените си индивидуални трудности повече, отколкото със старото legacy решение, и никаква теория не може предварително да ви подскаже какви точно трудности ви очакват.
Източник: habr.com
