

В времена, когато Kubernetes беше още v1.0.0, съществуваха плъгини за томове (volume plugins). Те бяха необходими за свързване на системи за съхранение на постоянни данни на контейнерите с Kubernetes. Броят им не беше голям, а сред първите бяха доставчици на хранилища като GCE PD, Ceph, AWS EBS и други.
Плъгините се доставяха заедно с Kubernetes, откъдето получиха името си — in-tree. Въпреки това, мнозина намериха съществуващия набор от плъгини за недостатъчен. Занимавали се с добавяне на прости плъгини в ядрото на Kubernetes с помощта на пачове, след което компилираха собствен Kubernetes и го инсталираха на своите сървъри. Но с времето разработчиците на Kubernetes разбраха, че риба проблемът не може да бъде решен. На хората им е необходима въдица. И с изданието на Kubernetes v1.2.0 тя се появи…
Плъгин Flexvolume: въдица на минималките
Разработчиците на Kubernetes създадоха плъгин FlexVolume, който представлява логическа обвивка от променливи и методи за работа с изградените от трети разработчици Flexvolume-драйвъри.
Нека се спрем и да разгледаме по-подробно какво представлява драйверът FlexVolume. Това е нещо изпълним файл (бинарен файл, Python скрипт, Bash скрипт и т.н.), който при изпълнение приема аргументи от командния ред и връща съобщение с предварително известни полета в JSON формат. Първият аргумент на командния ред по подразбиране винаги е метод, а останалите аргументи — неговите параметри.
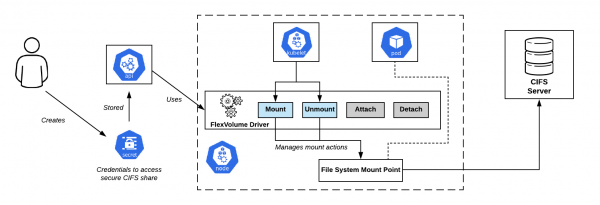
Схема за свързване на CIFS Shares в OpenShift. Драйверът Flexvolume — точно в центъра
Минимален набор от методи изглежда така:
flexvolume_driver mount # отговаря за присъединяване на тома към pod'а
# Формат на возвращаемото съобщение:
{
  "status": "Success"/"Failure"/"Not supported",
  "message": "Причината, поради която беше върнат точно този статус",
}

flexvolume_driver unmount # отговаря за отсъединяване на тома от pod'а
# Формат на возвращаемото съобщение:
{
  "status": "Success"/"Failure"/"Not supported",
  "message": "Причината, поради която беше върнат точно този статус",
}

flexvolume_driver init # отговаря за инициализация на плъгина
# Формат на возвращаемото съобщение:
{
  "status": "Success"/"Failure"/"Not supported",
  "message": "Причината, поради която беше върнат точно този статус",
  // Определя, използва ли драйвера методи attach/deatach
  "capabilities":{"attach": True/False}
}
Използване на методи attach и detach определя сценария, по който в бъдеще kubelet ще действа при извикване на драйвера. Съществуват също така специални методи expandvolume и expandfs, които отговарят за динамичната промяна на размера на обема.
Като пример за промяната, която добавя методът expandvolume, заедно с него — и възможността за извършване на промяна на размерите на обемите в реално време, може да се запознаете с в Rook Ceph Operator.
А ето и пример за реализация на Flexvolume-драйвера за работа с NFS:
usage() {
    err "Невалидно използване. Използване: "
    err "t$0 init"
    err "t$0 mount <директория за монтиране> <json параметри>"
    err "t$0 unmount <директория за монтиране>"
    exit 1
}

err() {
    echo -ne $* 1>&2
}

log() {
    echo -ne $* >&1
}

ismounted() {
    MOUNT=`findmnt -n ${MNTPATH} 2>\/dev\/null | cut -d' ' -f1`
    if [ "${MOUNT}" == "${MNTPATH}" ]; then
        echo "1"
    else
        echo "0"
    fi
}

domount() {
    MNTPATH=$1

    NFS_SERVER=$(echo $2 | jq -r '.server')
    SHARE=$(echo $2 | jq -r '.share')

    if [ $(ismounted) -eq 1 ] ; then
        log '{"status": "Успех"}'
        exit 0
    fi

    mkdir -p ${MNTPATH} &> \/dev\/null

    mount -t nfs ${NFS_SERVER}:\/ ${SHARE} ${MNTPATH} &> \/dev\/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Неуспех", "message": "Неуспех при монтиране на ${NFS_SERVER}:${SHARE} в ${MNTPATH}"}"
        exit 1
    fi
    log '{"status": "Успех"}'
    exit 0
}

unmount() {
    MNTPATH=$1
    if [ $(ismounted) -eq 0 ] ; then
        log '{"status": "Успех"}'
        exit 0
    fi

    umount ${MNTPATH} &> \/dev\/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Неуспех", "message": "Неуспех при демонтиране на обем в ${MNTPATH}"}"
        exit 1
    fi

    log '{"status": "Успех"}'
    exit 0
}

op=$1

if [ "$op" = "init" ]; then
    log '{"status": "Успех", "capabilities": {"attach": false}}'
    exit 0
fi

if [ $# -lt 2 ]; then
    usage
fi

shift

case "$op" in
    mount)
        domount $*
        ;;
    unmount)
        unmount $*
        ;;
    *)
        log '{"status": "Не поддържа се"}'
        exit 0
esac

exit 1
И така, след подготовката на самия изпълним файл е необходимо да инсталирате драйвера в Kubernetes клъстера.Драйверът трябва да се намира на всеки възел на клъстера според предварително зададен път. По подразбиране беше избран:
/usr/libexec/kubernetes/kubelet-plugins/volume/exec/имя_поставщика_хранилища~имя_драйвера/
… но при използване на различни дистрибуции на Kubernetes (OpenShift, Rancher…) пътят може да бъде друг.
Проблеми с Flexvolume: как да закачите въдицата правилно?
Инсталирането на Flexvolume драйвера на възлите на клъстера се оказа нетривиална задача. След като извършите операцията веднъж ръчно, лесно можете да се сблъскате със ситуация, при която в клъстера ще се появят нови възли: поради добавяне на нов възел, автоматично хоризонтално мащабиране, или — което е още по-лошо — замяна на възел поради неизправност. В този случай, работата с хранилището на тези възли ще продължи не е възможно, докато вие все още не добавите ръчно Flexvolume драйвера на тях.
Решението на този проблем е един от примитивите на Kubernetes — DaemonSet. При появата на нов възел в клъстера, автоматично се задава pod от нашия DaemonSet, на който се присъединява локален том по пътя за намиране на Flexvolume драйвери. При успешно създаване, pod копира необходимите файлове за работа на драйвера на диска.
Ето пример за такъв DaemonSet за разгръщане на Flexvolume плъгина:
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: flex-set
spec:
  template:
    metadata:
      name: flex-deploy
      labels:
        app: flex-deploy
    spec:
      containers:
        - image:
          name: flex-deploy
          securityContext:
              privileged: true
          volumeMounts:
            - mountPath: /flexmnt
              name: flexvolume-mount
      volumes:
        - name: flexvolume-mount
          hostPath:
            path:
… и пример за Bash скрипт за разгръщане на Flexvolume драйвера:
#!/bin/sh

set -o errexit
set -o pipefail

VENDOR=k8s.io
DRIVER=nfs

driver_dir=$VENDOR${VENDOR:+"~"}${DRIVER}
if [ ! -d "/flexmnt/$driver_dir" ]; then
  mkdir "/flexmnt/$driver_dir"
fi

cp "/$DRIVER" "/flexmnt/$driver_dir/.$DRIVER"
mv -f "/flexmnt/$driver_dir/.$DRIVER" "/flexmnt/$driver_dir/$DRIVER"

while : ; do
  sleep 3600
done
Важно е да не забравяте, че операцията по копиране не е атомарна. Има голяма вероятност kubelet да започне да използва драйвера, преди процесът на подготовка да е завършен, което ще предизвика грешка в работата на системата. Правилният подход е първо да копирате файловете на драйвера под друго име, след което да използвате атомарна операция за преименуване.
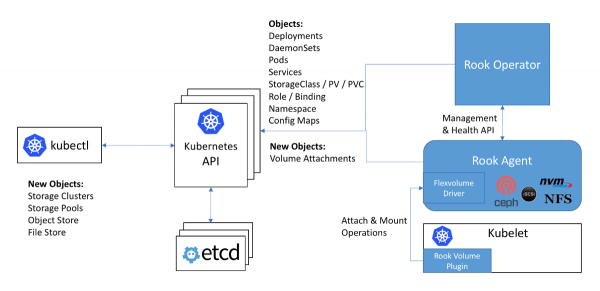
Схема на работа с Ceph в оператора Rook: драйверът Flexvolume е в схемата вътре в агента Rook
Следващият проблем при използването на Flexvolume драйвери е, че за повечето хранилища на възела в клъстера трябва да бъде инсталиран необходимият за това софтуер (например, пакет ceph-common за Ceph). Първоначално плъгинът Flexvolume не е замислен за реализиране на толкова сложни системи.
Първоначалното решение на този проблем може да се види в реализирането на Flexvolume драйвера на оператора Rook:
Самият драйвер е реализиран като RPC клиент. IPC сокетът за комуникация се намира в същата директория, в която е и самият драйвер. Помним, че за копиране на файловете на драйвера е добре да се използва DaemonSet, който свързва директорията с драйвера като том. След копирането на необходимите файлове на драйвера, pod този не умира, а се свързва с IPC сокета чрез свързания том като полноценен RPC сървър. Пакетът ceph-common вече е инсталиран вътре в контейнера на pod-а. IPC сокетът дава увереност, че kubelet ще комуникира точно с този pod, който се намира на същия възел. Всичко велико е просто!..
Сбогом, нашите мили... in-tree плъгини!
Разработчиците на Kubernetes откриха, че броят на плъгините за хранилища в ядрото е двадесет. И промените във всеки от тях по един или друг начин преминават през целия цикъл на освобождаване на Kubernetes.
Оказва се, че за да използвате новата версия на плъгина за хранилище, трябва да актуализирате целия клъстер. В допълнение към това можете да се изненадате, че новата версия на Kubernetes изведнъж ще стане несъвместима с използваното ядро на Linux... И така, вие избърсвате сълзите и с преглъщане на зъби съгласувате с шефовете и потребителите времето за обновление на ядрото на Linux и клъстера на Kubernetes. С възможен престой в предоставянето на услуги.
Ситуацията е повече от комична, не мислите ли? На цялата общност стана ясно, че този подход не работи. С решение от върха, разработчиците на Kubernetes обявяват, че нови плъгини за работа с хранилища повече няма да бъдат приемани в ядрото. Освен това, както вече знаем, при реализирането на плъгина Flexvolume бяха открити редица недостатъци...
За веднъж завинаги да се реши въпросът с персистентните хранилища на данни, последният добавен плъгин за томове в Kubernetes — CSI. Неговата алфа версия, по-подробно наречена Out-of-Tree CSI Volume Plugins, бе анонсирана в изданието .
Container Storage Interface, или спинниг CSI 3000!
Първото нещо, което трябва да се отбележи, е, че CSI не е просто плъгин за томове, а действителен за създаване на потребителски компоненти за работа с хранилища на данни. Предполагаше се, че системите за оркестрация на контейнери, като Kubernetes и Mesos, трябва да 'научат' как да работят с компонентите, реализирани по този стандарт. И ето, Kubernetes вече научи.
Какъв е устройството на CSI плъгина в Kubernetes? CSI плъгинът работи с специализирани драйвери (CSI драйвери), написани от външни разработчици. CSI драйверът в Kubernetes минимално трябва да се състои от две компоненти (pod’ove):
- Контролер — управлява външните персистентни хранилища. Реализира се под формата на gRPC сървър, за който се използва примитив
StatefulSet. - Узел — отговаря за монтиране на персистентни хранилища към възлите на клъстера. Също се реализира в под формата на gRPC сървър, но за него се използва примитив
DaemonSet.
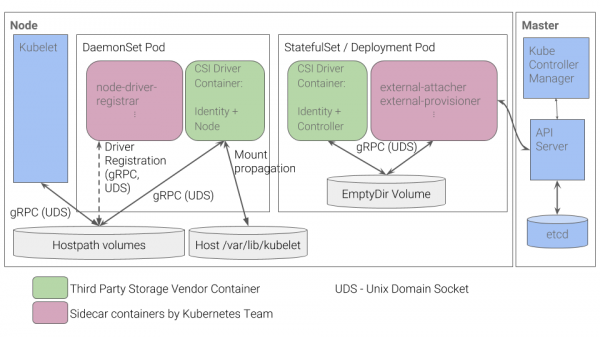
Схема на работа на CSI плъгина в Kubernetes
За някои други подробности относно работата на CSI можете да научите, например, от статията "», публикувахме преди година.
Предимствата на такова реализиране
- За основни неща – например, за регистрацията на драйвера за възел – разработчиците на Kubernetes реализираха набор от контейнери. Вече не е необходимо сами да форматираме JSON отговор с capabilities, както беше при плъгина Flexvolume.
- Вместо да "поставяме" изпълнявани файлове на възлите, вече разполагаме pod-ове в кластера. Това е именно, което очакваме от Kubernetes: всички процеси се случват в контейнери, разположени с помощта на примитиви на Kubernetes.
- За реализиране на сложни драйвери вече не е необходимо да разработваме RPC-сървър и RPC-клиент. Клиентът е реализиран от разработчиците на Kubernetes.
- Передаването на аргументи за работа по протокола gRPC е много по-удобно, гъвкаво и надеждно, отколкото тяхното предаване чрез аргументи на командния ред. За да разберем как да добавим в CSI поддръжка за метрики по използване на тома чрез добавяне на стандартизиран gRPC метод, можем да се запознаем с за драйвера vsphere-csi.
- Комуникацията става чрез IPC сокети, за да не се обърка къде pod-ът kubelet е изпратил заявка.
Този списък не ви напомня ли на нещо? Предимствата на CSI са разрешение на същите тези проблеми, които не бяха взети предвид при разработката на плъгина Flexvolume.
Изводи
CSI като стандарт за реализация на потребителски плъгини за взаимодействие с хранилища за данни беше приет много топло от общността. Освен това, благодарение на своите предимства и универсалност, CSI драйвери се създават дори за такива хранилища като Ceph или AWS EBS, плъгини за работа с които бяха добавени още в самата първа версия на Kubernetes.
В началото на 2019 година in-tree плъгините . Планува се продължаване на поддръжката на плъгина Flexvolume, но нови функционалности за него няма да се разработват.
Ние вече имаме опит с ceph-csi, vsphere-csi и сме готови да попълнем този списък! Засега CSI се справя отлично с поставените му задачи, а времето ще покаже.
Не забравяйте, че всичко ново е добре преосмислено старо!
P.S.
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
