

В големите облачни системи въпросът за автоматичното балансиране или изправяне на натоварването на изчислителните ресурси е особено актуален. За този въпрос се застъпи и Тионикса (разработчик и оператор на облачни услуги, част от групата компании Ростелеком).
И, тъй като нашата основна платформа за разработка е OpenStack, а ние, подобно на всички хора, сме мързеливи, решихме да намерим готов модул, който вече съществува в платформата. Изборът ни падна на Watcher, който решихме да използваме за нашите нужди.
Първо да се запознаем с термините и определенията.
Термини и определения
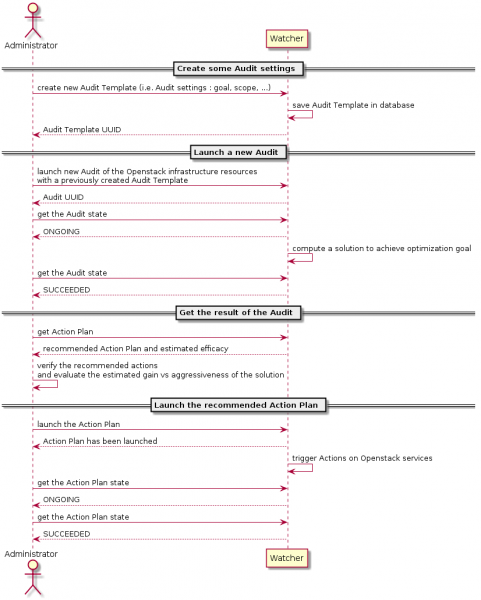
Цел — това е човекоразбираем, наблюдаем и измерим краен резултат, който трябва да бъде постигнат. За постигане на всяка цел съществуват една или повече стратегии. Стратегията е реализация на алгоритъм, способен да намери решение за поставената цел.
Действие (Action) — това е елементарна задача, която променя текущото състояние на целевия управляван ресурс на клъстера OpenStack, като например: миграция на виртуална машина (migration), изменение на състоянието на захранването на възел (change_node_power_state), изменение на състоянието на услугата nova (change_nova_service_state), изменение на флевора (resize), регистрация на NOP съобщение (nop), отсъствие на действия за определен период от време — пауза (sleep), преместване на диск (volume_migrate).
План на действията (Action Plan) — специфичен поток от действия, извършвани в определен ред за постигане на конкретна цел. Планът на действията също така включва оценената глобална ефективност с набор от показатели за ефективност. Планът на действията се генерира от Watcher при успешно проведен одит, в резултат на който използваната стратегия намира решение за постигане на целта. Планът на действията се състои от списък с последователни действия.
Одит (Audit) — това е заявка за оптимизация на клъстера. Оптимизацията се извършва с цел постигане на една цел в определения клъстер. За всеки успешен одит Watcher генерира План на действията.
Област на одита (Audit Scope) — това е набор от ресурси, в рамките на които се извършва одит (зона(и) на достъп, агрегатори на възли, отделни изчислителни възли или хранилища и т.н.). Областта на одита е определена в всеки шаблон. Ако не е посочена област на одит, се извършва одит на целия кластер.
Шаблон за одит (Audit Template) — запазен набор от настройки за изпълнение на одит. Шаблоните са необходими, за да се извършват многократни одити с еднакви настройки. Шаблонът трябва задължително да съдържа целта на одита; ако стратегиите не са посочени, се избират най-подходящите от съществуващите стратегии.
Кластер (Cluster) — това е набор от физически машини, които предоставят изчислителни ресурси, ресурси за съхранение и мрежови ресурси и се управляват от един и същи управляващ възел на OpenStack.
Модел на данни на клъстера (Cluster Data Model, CDM) — това е логично представяне на текущото състояние и топология на ресурсите, управлявани от клъстера.
Индекс на ефективност (Efficacy Indicator) — показател, който указва как се изпълнява решението, създадено с помощта на тази стратегия. Индексите на ефективност са специфични за конкретната цел и обикновено се използват за изчисляване на глобалната ефективност на окончателния план за действие.
Спецификация на ефективността (Efficacy Specification) — това е набор от специфични характеристики, свързани с всяка цел, който определя различни показатели на ефективността, които стратегията, осигуряваща постигането на съответната цел, трябва да осигури в своето решение. Всъщност, всяко решение, предложено от стратегията, ще бъде проверено за съответствие със спецификацията, преди да се изчисли глобалната му ефективност.
„Счетоводен“ механизъм (Scoring Engine) — това е изпълним файл, който има ясно определени входни данни, ясно определени изходни данни и извършва чисто математическа задача. Следователно, изчислението не зависи от средата, в която се извършва — то ще даде същия резултат навсякъде.
Watcher планировчик (Watcher Planner) — част от механизма за вземане на решения Watcher. Този модул приема набор от действия, генерирани от стратегията, и създава план за работния процес, който определя как да се планират във времето тези различни действия и какви са предварителните условия за всяко действие.
Цели и стратегии на Watcher
Цел
Стратегии
Фиктивна цел
Фиктивна стратегия
Фиктивна стратегия с примерни оценки
Фиктивна стратегия с преместване
Пестене на енергия
Стратегия за пестене на енергия
Консолидация на сървъри
Основна офлайн консолидация на сървъри
Стратегия за консолидация на работни натоварвания на ВМ
Баланс на работните натоварвания
Стратегия за миграция на баланс на работните натоварвания
Стратегия за балансиране на капацитета за съхранение
Стабилизация на работното натоварване
Шумен съсед
Шумен съсед
Термична оптимизация
Стратегия, базирана на температурата на изхода
Оптимизация на въздушния поток
Стратегия за миграция на равномерен въздушен поток
Поддръжка на хардуера
Миграция на зона
Некласифициран
Актуатор
Фиктивна цел — резервна цел, която се използва за тестване.
Свързани стратегии: Фиктивна стратегия, Фиктивна стратегия с примерни оценки и Фиктивна стратегия с преместване. Фиктивната стратегия е използвана за интеграционно тестване чрез Tempest. Тази стратегия не осигурява никаква полезна оптимизация, единствената й цел е да използва тестовете Tempest.
Фиктивната стратегия с примерни оценки е сходна с предишната, различава се само по използването на образец „оценяващ двигател“, водещ до отчет с използване на методи на машинното обучение.
Фиктивната стратегия с преместване е сходна с предишната, различава се само по използването на промяна на флейвора (миграция и преместване).
Не се използва в продукция.
Пестене на енергия — минимизиране на потреблението на енергия. Стратегията за тази цел Стратегия за пестене на енергия заедно със стратегията за консолидация на работни натоварвания на ВМ (Консолидация на сървъри) може да изпълнява функции на динамично управление на захранването (DPM), които спестяват електричество чрез динамична консолидация на работните натоварвания дори в периоди на ниско натоварване на ресурсите: виртуалните машини се преместват на по-малък брой възли, а ненужните възли — изключват. След консолидацията стратегията предлага решение за включване/изключване на възлите в съответствие с зададени параметри: „min_free_hosts_num“ — брой свободни включени възли, които очакват натоварване, и „free_used_percent“ — процентното съотношение на свободните включени възли спрямо броя на възлите, които са заети от машини. За работата на стратегията трябва да бъде включен и настроен Ironic за работа с включване/изключване на захранването на възлите.
Параметри на стратегията
параметър
тип
по подразбиране
описание
free_used_percent
Брой
10.0
съотношение между броя на свободни изчислителни възли и броя на изчислителните възли с виртуални машини
min_free_hosts_num
Int
1
минимален брой свободни изчислителни възли
В облака трябва да има минимум два възела. Използваният метод е промяна на състоянието на захранването на възела (change_node_power_state). Стратегията за събиране на метрики не изисква.
Серверната консолидиране — минимизиране на броя на изчислителните възли (консолидация). Има две стратегии: Basic Offline Server Consolidation и VM Workload Consolidation Strategy.
Стратегията Basic Offline Server Consolidation минимизира общия брой на използваните сървъри, както и минимизира броя на миграциите.
Основната стратегия изисква следните метрики:
метрика
услуга
плъгини
коментар
compute.node.cpu.percent
none
cpu_util
none
Параметрите на стратегията: migration_attempts — брой комбинации за търсене на потенциални кандидати за изключване (по подразбиране, 0, без ограничения), period — интервал от време в секунди за получаване на статична агрегация от източника на данни за метрики (по подразбиране, 700).
Използваните методи: миграция, промяна на състоянието на услугата nova (change_nova_service_state).
Стратегията VM Workload Consolidation Strategy е основана на хевристичния алгоритъм first-fit, който се фокусира върху измереното натоварване на CPU и се опитва да минимизира възлите, които имат твърде голямо или твърде малко натоварване, като взема предвид ограниченията на ресурсите. Тази стратегия предоставя решение, което води до по-ефективно използване на ресурсите на кластера, като използва следните четири етапа:
- Фаза на разтоварване — обработка на преизползваните ресурси;
- Фаза на консолидация — обработка на недостатъчно използваните ресурси;
- Оптимизация на решението — намаляване на броя на миграциите;
- Изключване на неизползваните изчислителни възли.
Стратегията изисква следните метрики:
метрика
услуга
плъгини
коментар
memory
none
disk.root.size
none
Следващите метрики не са задължителни, но повишават точността на стратегията, ако са налични:
метрика
услуга
плъгини
коментар
memory.resident
none
cpu_util
none
Параметри на стратегията: period — интервал от време в секунди за получаване на статична агрегация от източника на данни за метрики (по подразбиране, 3600).
Използва същите методи, както предишната стратегия. Повече информация .
Баланс на работните натоварвания — балансиране на работното натоварване между изчислителните възли. Целта има три стратегии: Workload Balance Migration Strategy, Workload stabilization, Storage Capacity Balance Strategy.
Стратегия миграции рабочего баланса запускает миграции виртуальных машин в зависимости от рабочей нагрузки узловых виртуальных машин. Решение о переносе принимается каждый раз, когда процент использования CPU или ОЗУ узла превышает указанный порог. При этом перемещаемая виртуальная машина должна приблизить узел к средней рабочей нагрузке всех узлов.
Изисквания
- Използване на физически процесори;
- Минимум два физически изчислителни възли;
- Инсталиран и конфигуриран компонент Ceilometer — ceilometer-agent-compute, работещ на всеки изчислителен възел, и Ceilometer API, както и събиране на следните метрики:
метрика
услуга
плъгини
коментар
cpu_util
none
memory.resident
none
Параметри на стратегията:
параметър
тип
по подразбиране
описание
metrics
Стринг
‘cpu_util’
Метриките, които стоят в основата: ‘cpu_util’, ‘memory.resident’.
праг
Брой
25.0
Праг на работното натоварване за миграция.
период
Брой
300
Общ период на Ceilometer.
Използваният метод — миграция.
Стабилизация на работното натоварване — стратегия, насочена към стабилизиране на работното натоварване чрез жива миграция. Стратегията е основана на алгоритъм за стандартно отклонение и определя дали има претоварване в клъстера и реагира на него, като стартира миграция на машините за стабилизиране на клъстера.
Изисквания
- Използване на физически процесори;
- Минимум два физически изчислителни възли;
- Инсталиран и конфигуриран компонент Ceilometer — ceilometer-agent-compute, работещ на всеки изчислителен възел, и Ceilometer API, както и събиране на следните метрики:
метрика
услуга
плъгини
коментар
cpu_util
none
memory.resident
none
Стратегия за баланс на капацитета за съхранение (стратегията е реализирана от Queens) — стратегията пренасочва дисковете в зависимост от натоварването на Cinder пуловете. Решението за преместване се взима всеки път, когато коефициентът на използване на пуловете надвишава зададения праг. Преместеният диск трябва да приближи пула до средното натоварване на всички Cinder пулове.
Изисквания и ограничения
- Минимум два Cinder пула;
- Възможност за миграция на дискове.
- Модел на данни на клъстера — колектор на данни за Cinder кластер.
Параметри на стратегията:
параметър
тип
по подразбиране
описание
обемна_праг
Брой
80.0
Прагова стойност на дисковете за балансиране на обеми.
Използваният метод — миграция на диск (volume_migrate).
Шумен съсед — идентифициране и преместване на „шумния съсед“ — виртуална машина с нисък приоритет, която негативно влияе на производителността на виртуалната машина с висок приоритет от гледна точка на IPC, прекомерно използвайки Last Level Cache. Собствена стратегия: Шумен съсед (използван параметър на стратегията — cache_threshold (по подразбиране — 35), като производителността падне до зададеното значение, стартира миграцията. За работата на стратегията е необходимо активиране на метрики на LLC (Last Level Cache), последният Intel сървър, поддържащ CMT,, а също така събиране на следните метрики:
метрика
услуга
плъгини
коментар
cpu_l3_cache
none
Необходим е Intel .
Модел на данни от клъстер (по подразбиране): Nova кластерен модел за събиране на данни. Използваният метод е миграция.
Работата с тази цел чрез Dashboard не е напълно реализирана в Queens.
Термична оптимизация — оптимизиране на температурния режим. Температурата на изхода (вътрешен въздух) е една от важните термални телеметрични системи за измерване на състоянието на термалната / работната натовареност на сървъра. За целта има една стратегия — стратегия на базата на температурата на изхода, която взема решения за прехвърляне на работните натоварвания на възли с благоприятен температурен режим (най-ниска температура на изхода), когато температурата на изхода на основните хостове достигне зададения праг.
За работа на стратегията е необходим сървър с инсталиран и конфигуриран Intel Power Node Manager , а също така събиране на следните метрики:
метрика
услуга
плъгини
коментар
hardware.ipmi.node.outlet_temperature
IPMI
Параметри на стратегията:
параметър
тип
по подразбиране
описание
праг
Брой
35.0
Температурен праг за миграция.
период
Брой
30
Интервал от време в секунди за получаване на статистическа агрегация от източника на данни за метриката.
Използваният метод — миграция.
Оптимизация на въздушния поток — оптимизиране на режима на вентилация. Собствената стратегия е — Еднороден въздушен поток с помощта на жива миграция. Стратегията стартира миграцията на виртуалната машина всеки път, когато въздушният поток от вентилатора на сървъра надвиши зададения праг.
За работа на стратегията са необходими:
- Хардуер: изчислителни възли <с поддръжка на NodeManager 3.0;
- Минимум два изчислителни възли;
- Инсталиран и конфигуриран на всеки изчислителен възел компонент ceilometer-agent-compute и Ceilometer API, който може успешно да отчита такива метрики като въздушен поток, мощност на системата, температура на входа:
метрика
услуга
плъгини
коментар
hardware.ipmi.node.airflow
IPMI
hardware.ipmi.node.temperature
IPMI
hardware.ipmi.node.power
IPMI
За работа на стратегията е необходим сървър с инсталиран и конфигуриран Intel Power Node Manager 3.0 или по-нова версия.
Ограничения: Концепцията не е предназначена за продукция.
Препоръчва се да се използва този алгоритъм с непрекъснати одити, тъй като за една итерация е планирано мигрирането само на една виртуална машина.
Възможни са живи миграции.
Параметри на стратегията:
параметър
тип
по подразбиране
описание
threshold_airflow
Брой
400.0
Праг на въздушния поток за миграция. Единицата е 0.1CFM.
threshold_inlet_t
Брой
28.0
Праг на температурата на входа за решението за миграция.
threshold_power
Брой
350.0
Праг на мощността на системата за решението за миграция.
период
Брой
30
Интервал от време в секунди за получаване на статистическа агрегация от източника на данни за метриката.
Използваният метод — миграция.
Поддръжка на хардуер — поддръжка на хардуер. Стратегия, свързана с тази цел, — Зона на миграция. Стратегията е инструмент за ефективна автоматична и минимална миграция на виртуални машини и дискове при необходимост от извършване на техническа поддръжка на хардуер. Стратегията изгражда план за действие в съответствие с теглата: набор от действия, който има по-голямо тегло, ще бъде планиран по-рано от другите. Съществуват два параметъра за конфигурация: тегла на действията (action_weights) и паралелизация (parallelization).
Ограничения: необходима е настройка на теглата на действията и паралелизацията.
Параметри на стратегията:
параметър
тип
по подразбиране
описание
compute_nodes
array
None
Възлите за изчисление за миграция.
storage_pools
array
None
Възли за съхранение за миграция.
parallel_total
integer
6
Общото количество действия, които трябва да се извършват паралелно.
parallel_per_node
integer
2
Броят на действията, извършвани паралелно за всеки изчислителен възел.
parallel_per_pool
integer
2
Броят на действията, извършвани паралелно за всеки пул за съхранение.
priority
обект
None
Списък с приоритети за виртуални машини и дискове.
with_attached_volume
boolean
False
False — виртуалните машини ще бъдат пренесени след преместването на всички дискове. True — виртуалните машини ще бъдат пренесени след миграцията на всички свързани дискове.
Елементи на масива с изчислителни възли:
параметър
тип
по подразбиране
описание
src_node
стринг
None
Изчислителен възел, от който се прехвърлят виртуалните машини (задължително).
dst_node
стринг
None
Изчислителен възел, на който мигрират виртуалните машини.
Елементи на масива с възли за съхранение:
параметър
тип
по подразбиране
описание
src_pool
стринг
None
Пул за съхранение, от който се прехвърлят дисковете (задължително).
dst_pool
стринг
None
Пул за съхранение, на който се прехвърлят дисковете.
src_type
стринг
None
Изходен тип диск (задължително).
dst_type
стринг
None
Краен тип диск (задължително).
Елементи с приоритетност:
параметър
тип
по подразбиране
описание
проект
array
None
Имена на проекти.
compute_node
array
None
Имена на изчислителни възли.
storage_pool
array
None
Имена на пуловете за съхранение.
compute
enum
None
Параметри на виртуалната машина [“vcpu_num”, “mem_size”, “disk_size”, “created_at”].
хранилище
enum
None
Параметри на дисковете [“size”, “created_at”].
Използваните методи — миграция на виртуални машини, миграция на дискове.
Некласифициран — спомагателна цел, използвана за улесняване на процеса на разработка на стратегия. Не съдържа спецификации и може да се използва всеки път, когато стратегията все още не е свързана с вече съществуваща цел. Тази цел може да се използва и като преходен етап. Свързаната с тази цел стратегия — Актюатор.
Създаване на нова цел
Watcher Decision Engine има интерфейс на плъгин "външна цел", който позволява интегрирането на външна цел, която може да бъде постигната с помощта на стратегия.
Преди да създадете нова цел, уверете се, че нито една от съществуващите цели не отговаря на вашите нужди.
Създаване на нов плъгин
За да създадете нова цел, трябва да разширите класа на целта, да реализацията на метода на класа get_name () за връщане на уникален идентификатор на новата цел, която искате да създадете. Този уникален идентификатор трябва да съвпада с името на входната точка, която посочвате по-късно.
След това е необходимо да реализирате метода на класа get_display_name () за връщане на преведено показващо име на целта, която искате да създадете (не използвайте променлива за връщане на преведена низ, за да може автоматично да се събира от инструмента за превод.).
Реализирайте метода на класа get_translatable_display_name (), за да върнете ключа за превод (в действителност показващото име на английски) на вашата нова цел. Върнатата стойност трябва да съвпада със строката, преведена в get_display_name ().
Реализирайте неговия метод get_efficacy_specification (), за да върнете спецификацията на ефективността на вашата цел. Методът get_efficacy_specification () връща инстанция Unclassified (), предоставена от Watcher. Тази спецификация на ефективността е полезна в процеса на разработка на вашата цел, тъй като съответства на празна спецификация.
→
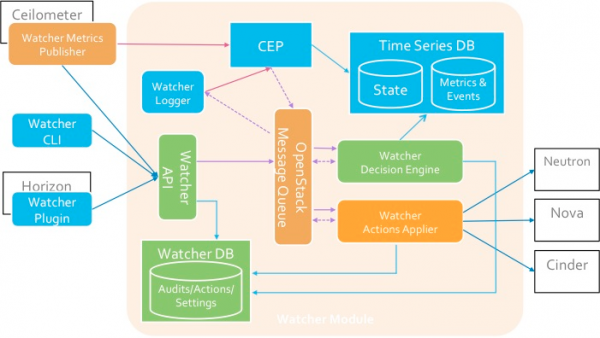
Архитектура на Watcher (повече информация ).
FAudio
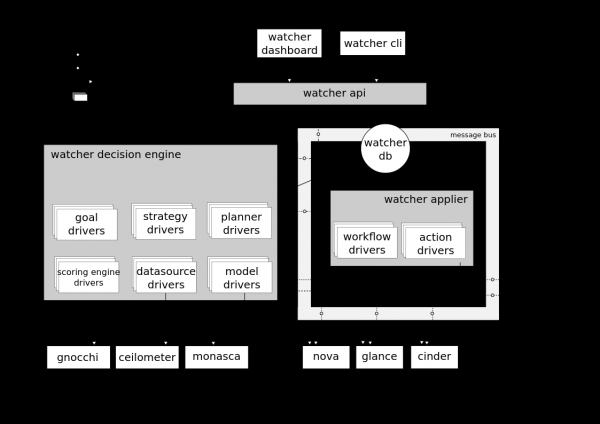
Watcher API — компонент, реализиращ REST API, предоставян от Watcher. Механизми за взаимодействие: CLI, плъгин Horizon, Python SDK.
Watcher DB — база данни на Watcher.
Watcher Applier — компонент, реализиращ изпълнението на плана за действия, създаден от компонента Watcher Decision Engine.
Watcher Decision Engine — компонент, отговорен за изчисляването на набора от потенциални действия за оптимизация за изпълнение на целта за одит. Ако стратегията не е посочена, компонентът самостоятелно избира най-подходящата.
Watcher Metrics Publisher — компонент, който събира и изчислява някои метрики или събития и ги публикува в крайната точка CEP. Функционалността на компонента може също да бъде предоставена от Ceilometer publisher.
Complex Event Processing (CEP) Engine — механизъм за комплексна обработка на събития. С оглед на производителността могат да работят няколко инстанции на CEP Engine едновременно, всяка от които обработва определен тип метрика / събития. В системата Watcher CEP задейства два типа действия: — записва съответните събития / метрики в базата данни на времеви редове; — изпраща съответните събития към компонента Watcher Decision Engine, когато това събитие може да повлияе на резултата от текущата стратегия за оптимизация, тъй като клъстерът Openstack не е статична система.
Взаимодействието между компонентите става чрез протокола AMQP.
→
Схема на взаимодействие с Watcher
Резултати от тестването на Watcher
- На страницата Optimization — Action plans се получава грешка 500 (както на чистото Queens, така и на стенда с модулите Тионикс), появява се само след като бъде стартиран одит и генериран план за действие, а празен се отваря нормално.
- На таба Action details се получават грешки, не може да бъде получена целта и стратегията на одита (както на чистото Queens, така и на стенда с модулите Тионикс).
- Одитите с цел Dummy (тестови) се създават и стартират нормално, генерират се планове за действия.
- Одитите с цел Unclassified не се създават, тъй като целта не е функционална и е предназначена за междинна настройка при създаване на нови стратегии.
- Одитите с цел Workload Balancing (стратегия Storage Capacity balance) се създават успешно, но планът за действие не се генерира. Оптимизация на хранилищата не е необходима.
- Одитите с цел Workload Balancing (стратегия Workload Balance Migration Strategy) се създават успешно, но планът за действие не се генерира.
- Одитите с цел Workload Balancing (стратегия Workload Stabilization Strategy) завършват с грешка.
- Одитите с цел Noisy Neighbor се създават успешно, но планът за действие не се генерира.
- Одитите с цел Hardware maintenance се създават успешно, планът за действие не се генерира в пълен обем (генерират се показатели за ефективност, но самият списък с действия не се генерира).
- Промените в конфигурациите на nova.conf (в секцията по подразбиране compute_monitors = cpu.virt_driver) на изчислителния и управляващия възел не коригират грешките.
- Одитите с цел Server Consolidation (стратегия Basic) също завършват с грешка.
- Одитите с цел Server Consolidation (стратегия VM workload consolidation) завършват с грешка. В логовете е налице грешка при получаване на изходни данни. Обсъждане на грешката, по-конкретно, .
Опитахме се да зададем в конфигурационния файл на Watcher (не помогна — в резултат на грешки на всички страници Optimization, връщането към оригиналното съдържание на конфигурационния файл не решава ситуацията):[watcher_strategies.basic]
datasource = ceilometer, gnocchi - Аудитите с цел Saving Energy завършват с грешка. Судя по логовете, проблемът все пак е в отсъствието на Ironic, няма да работи без baremetal service.
- Аудитите с цел Thermal Optimization завършват с грешка. Трейсбекът е същият, като при Server Consolidation (стратегия VM workload consolidation) (грешка в изходните данни)
- Аудитите с цел Airflow Optimization завършват с грешка.
Срещат се също и следните грешки при завършването на аудита. Трейсбекът в логовете decision-engine.log (не е определено състоянието на кластера).
→ Обсъждане на грешката
Заключение
Резултатът от нашите двемесечни изследвания е недвусмислено заключение, че за да получим пълноценна, работеща система за баланс на натоварването, ще трябва в тази част да се заемем сериозно с доработката на инструмента за платформата Openstack.
Watcher се показа като сериозен и бързо развиващ се продукт с огромен потенциал, за пълноценното използване на който е необходима голяма и сериозна работа.
Но за това – в следващите статии от цикъла.
Източник: habr.com
