

През 2017 година спечелихме конкурс за разработка на транзакционното ядро на инвестиционния бизнес на Альфа-Банк и започнахме работа (на HighLoad++ 2018 с доклад за ядрото на инвестиционния бизнес Владимир Дрынкин, ръководител на направление транзакционното ядро на инвестиционния бизнес на Альфа-Банк). Тази система трябваше да агрегира данни за сделки от различни източници в различни формати, да приведe данните в унифициран вид, да ги съхранява и да предоставя достъп до тях.
В процеса на разработка системата еволюира и натрупва функционалност, и в някакъв момент осъзнахме, че се кристализира нещо много повече от просто приложение, създадено за решаване на строго определен кръг задачи: получихме система за изграждане на разпределени приложения с персистентно хранилище. Полученият от нас опит легна в основата на новия продукт — (TDG).
Искам да разкажа за архитектурата на TDG и за решенията, до които стигнахме в процеса на разработка, да ви запозная с основната функционалност и да покажа как нашият продукт може да стане основа за изграждане на завършени решения.
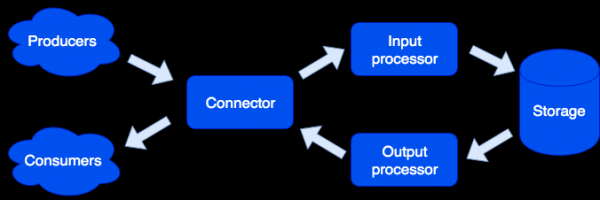
Архитектурно разделихме системата на отделни роли, всяка от които отговаря за решаването на определен кръг задачи. Един стартиран екземпляр на приложението реализира един или няколко типа роли. В клъстера може да има няколко роли от един тип:
Connector
Конекторът отговаря за връзката с външния свят; задачата му е да приеме заявка, да я анализира и, ако анализът е успешен, да изпрати данни за обработка в входния процесор. Поддържаме формати HTTP, SOAP, Kafka, FIX. Архитектурата позволява лесно добавяне на нови формати, скоро ще се появи поддръжка за IBM MQ. Ако анализът на заявката завърши с грешка, конекторът ще върне грешка; в противен случай ще отговори, че заявката е обработена успешно, дори и да е възникнала грешка при по-нататъшната ѝ обработка. Това е направено специално, за да се работи със системи, които не могат да повтарят заявки — или обратно, правят това твърде настоятелно. За да не се губят данни, се използва ремонтна опашка: обектът първо попада в нея и само след успешна обработка се изтрива оттам. Администраторът може да получава уведомления за обектите, останали в ремонтната опашка, а след отстраняване на софтуерна грешка или хардуерен срив да извърши повторна опит.
Входен процесор
Входният процесор категоризира получените данни по характерни признаци и извиква подходящи обработчици. Обработчиците са код на Lua, изпълняван в пясъчна среда, по този начин те не могат да влияют на функционирането на системата. На този етап данните могат да бъдат приведени в необходимия вид, а при необходимост може да се стартират произволен брой задачи, които реализират необходимата логика. Например, в продукта MDM (Master Data Management), построен на Tarantool Data Grid, при добавяне на нов потребител, за да не забавяме обработката на заявката, създаването на златната запись е отделна задача. Пясъчникът поддържа заявки за четене, промяна и добавяне на данни, позволява изпълнение на определена функция на всички роли от типа storage и агрегиране на резултата (map/reduce).
Обработчиците могат да бъдат описани във файлове:
sum.lua

local x, y = unpack(...)
return x + y
И след това, да бъдат обявени в конфигурацията:
functions:
  sum: { __file: sum.lua }
Защо Lua? Lua е много прост език. Въз основа на нашия опит, след няколко часа запознаване с него, хората започват да пишат код, решаващ тяхната задача. И това не са само професионални разработчици, а например, анализатори. Освен това, благодарение на JIT компилатора, Lua работи много бързо.
Хранилище
Системата за съхранение съхранява персистентни данни. Преди да се запазят, данните преминават валидация за съответствие на схемата. За описание на схемата използваме разширен формат. . Пример:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
На базата на това описание автоматично се генерира DDL (Data Definition Language) за СУБД Тарантул и схема за достъп до данните.
Поддържа се асинхронна репликация на данни (в плановете е добавяне на синхронна).
Output processor
Понякога е необходимо да уведомим външните потребители за постъпването на нови данни, за което съществува ролята Output processor. След запазването на данните, те могат да бъдат предадени на съответния обработчик (например, за да бъдат форматирани според изискванията на потребителя) — а след това предадени на connector за изпращане. Тук също се използва ремонтна опашка: ако никой не приеме обекта, администраторът може да направи нов опит по-късно.
Мащабиране
Ролите connector, input processor и output processor нямат състояние, което ни позволява да мащабираме системата хоризонтално, просто добавяйки нови инстанции на приложението с активирана роля от необходимия тип. За хоризонтално мащабиране на storage се използва за организиране на клъстера с използване на виртуални контейнери. След добавяне на нов сървър част от контейнерите от старите сървъри в бекграунд прехвърлят на новия сървър; това се случва прозрачно за потребителите и не влияе на работата на цялата система.
Свойства на данните
Обектите могат да бъдат много големи и да съдържат други обекти. Ние осигуряваме атомарност при добавяне и актуализиране на данни, съхранявайки обекта със всички зависимости в един виртуален контейнер. Така се изключва „разпръсването“ на обекта по няколко физически сървъра.
Поддържа се версияне: всяко обновление на обект създава нова версия, и ние винаги можем да направим времева разрезка и да видим как е изглеждал светът тогава. За данни, на които не е нужна дълга история, можем да ограничим броя на версиите или дори да съхраняваме само една — последната, т.е. фактически да деактивираме версиянето за определен тип. Също така можем да ограничим историята по време: например, да изтриваме всички обекти от определен тип, по-стари от 1 година. Поддържа се и архивиране: можем да експортираме обекти, по-стари от зададеното време, освобождавайки място в кластера.
Задачи
От интересните функции трябва да се отбележи възможността за стартиране на задачи по график, по заявка на потребителя или програмно от песочницата:
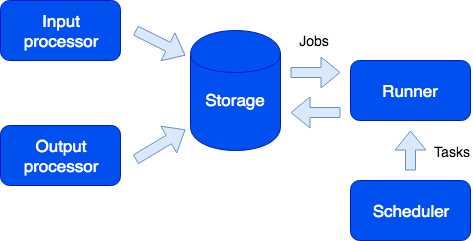
Тук виждаме още една роля — runner. Тази роля не е статична и при нужда в кластера могат да се добавят допълнителни екземпляри на приложението с тази роля. Отговорността на runner е да изпълнява задачи. Както беше споменато, от песочницата е възможно да се генерират нови задачи; те се съхраняват в опашка на storage и след това се изпълняват на runner. Този тип задачи се нарича Job. Имаме и тип задачи, наречен Task — това са задачи, определяни от потребителя и стартирани по график (използва се синтаксис cron) или при поискване. За стартиране и проследяване на такива задачи разполагаме с удобен мениджър на задачи. За да е налична тази функционалност, е необходимо да се активира ролята scheduler; тази роля е статична, следователно не се мащабира, което всъщност не е необходимо; в същото време тя, както и другите роли, може да има реплика, която започва работа, ако майсторът въпреки това се провали.
Logger
Още една роля се нарича logger. Тя събира логовете от всички членове на кластера и предлага интерфейс за тяхното експортиране и преглеждане през уеб интерфейс.
Услуги
Струва си да се спомене, че системата позволява лесно създаване на услуги. В конфигурационния файл може да се посочат кои заявки да се насочват към написания от потребителя обработчик, изпълняван в песочницата. В този обработчик може, например, да се извърши някакво аналитично запитване и да се върне резултатът.
Услугата се описва в конфигурационния файл:
services:
   sum:
      doc: "добавя две числа"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API се генерира автоматично и услугата става достъпна за извикване:
query {
   sum(x: 1, y: 2)
}
Това ще доведе до извикване на обработвача sum, който ще върне резултата:
3
Профилиране на заявки и метрики
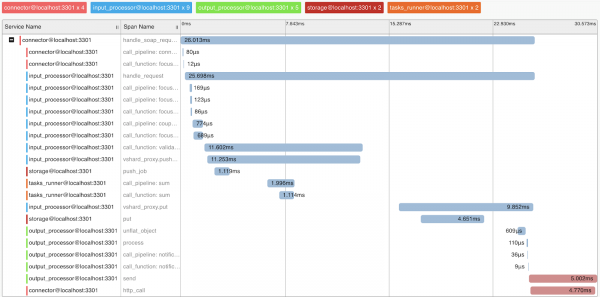
За разбиране на работата на системата и профилирането на заявки, реализирахме поддръжка на протокола OpenTracing. Системата може при поискване да изпраща информация на инструменти, поддържащи този протокол, например Zipkin, което ще помогне да разберем как е изпълнена заявката:
Разбира се, системата предоставя вътрешни метрики, които могат да бъдат събирани с помощта на Prometheus и визуализирани с помощта на Grafana.
Деплой
Tarantool Data Grid може да бъде инсталиран от RPM пакети или архив, с помощта на инструменти от доставката или Ansible, също така има поддръжка за Kubernetes ().
Приложението, реализиращо бизнес логиката (конфигурация, обработвачи) се зарежда в разположения клъстер Tarantool Data Grid под формата на архив през UI или чрез скрипт, използвайки предоставения от нас API.
Примери за приложения
Какви приложения можете да създадете с помощта на Tarantool Data Grid? Всъщност повечето бизнес задачи така или иначе са свързани с обработка на потока данни, съхранение и достъп до тях. Затова, ако имате големи потоци данни, които трябва да бъдат надеждно съхранявани и достъпни, нашият продукт може да спести много време за разработка, за да се насочите към бизнес логиката си.
Например, искаме да събираме информация за пазара на недвижими имоти, за да имаме информация за най-изгодните оферти. В този случай ще определим следните задачи:
- Роботи, събиращи информация от отворени източници — това ще бъдат нашите източници на данни. Тази задача можете да решите, като използвате готови решения или напишете код на който и да е език.
- След това Tarantool Data Grid ще приеме и запази данните. Ако форматът на данните от различни източници се различава, можете да напишете код на Lua, който да преобразува данните в единен формат. На етапа на предварителна обработка също можете, например, да филтрирате повтарящи се оферти или допълнително да актуализирате информацията за агентите, работещи на пазара в базата данни.
- Сега вече имате мащабируемо решение в клъстера, което можете да запълвате с данни и да правите заявки за данни. След това можете да реализирате нова функционалност, например, да напишете услуга, която ще направи заявка към данните и ще предостави най-изгодното предложение за деня — това изисква само няколко реда в конфигурационния файл и малко код на Lua.
Какво следва?
Нашият приоритет е повишаване на удобството за разработка чрез . Например, това е IDE с поддръжка на профилиране и отстраняване на грешки на обработчици, работещи в песен.
Също така, ние отделяме голямо внимание на въпросите на безопасността. В момента преминаваме сертификация от ФСТЕК на Русия, за да потвърдим високото ниво на безопасност и да отговорим на изискванията за сертификация на софтуерни продукти, използвани в информационни системи за лични данни и държавни информационни системи.
Източник: habr.com
