

Здравейте на всички. В тази статия ще ви разкажа защо в Авито избрахме Kafka преди девет месеца и какво представлява тя. Ще споделя един от случаите на приложение — брокер на съобщения. И накрая ще говорим за това какви предимства получихме от използването на подхода Kafka as a Service.
Проблема
Първо, малко контекст. Преди известно време започнахме да се отдалечаваме от монолитната архитектура и в момента в Авито вече имаме няколко стотици различни услуги. Те имат свои хранилища, свой стек технологии и отговарят за своята част от бизнес логиката.
Една от проблемите с голям брой услуги е комуникацията. Услуга А често иска информация, с която разполага услуга Б. В този случай, услуга А се обръща към услуга Б чрез синхронен API. Услуга В иска да знае какво става с услугите Г и Д, а те, от своя страна, се интересуват от услугите А и Б. Когато такива „любопитни“ услуги станат много, връзките между тях се превръщат в заплетен клубок.
В същото време, във всеки момент услуга А може да стане недостъпна. Какво да прави услуга Б и всички останали услуги, които зависят от нея? А ако за изпълнението на бизнес операция е необходимо да се извърши верига от последователни синхронни повиквания, вероятността за отказ на цялата операция става още по-висока (и тя е толкова по-висока, колкото по-дълга е тази верига).
Избор на технология
Добре, проблемите са ясни. Можем да ги отстраним, като направим централизирана система за обмен на съобщения между услугите. Сега на всяка услуга ѝ е достатъчно да знае само за тази система за обмен на съобщения. В допълнение, самата система трябва да бъде отказоустойчива и хоризонтално мащабируема, както и в случай на аварии да събира буфер за последваща обработка.
Сега нека изберем технология, на която ще се реализира доставката на съобщения. За това първо ще разберем какви очаквания имаме от нея:
- съобщенията между услугите не трябва да се губят;
- съобщенията могат да се дублират;
- съобщенията могат да се съхраняват и четат за дълбочина от няколко дни (постоянен буфер);
- услугите могат да се абонират за интересните им данни;
- няколко услуги могат да четат едни и същи данни;
- съобщенията могат да съдържат детализиран, обемен payload (event-carried state transfer);
- понякога е нужна гаранция за реда на съобщенията.
Също така беше изключително важно да изберем максимално мащабируема и надеждна система с висока пропускна способност (не по-малко от 100k съобщения с размер няколко килобайта на секунда).
На този етап се сбогувахме с RabbitMQ (трудно е да се запази стабилна при високи rps), PGQ от SkyTools (не е достатъчно бърз и трудно мащабируем) и NSQ (не персистентен). Всички тези технологии се използват в компанията ни, но не подхождат за решавания проблем.
След това започнахме да разглеждаме нови за нас технологии — Apache Kafka, Apache Pulsar и NATS Streaming.
Първи отхвърлихме Pulsar. Решихме, че Kafka и Pulsar са доста подобни помежду си решения. И въпреки че Pulsar е тестван от големи компании, по-нов е и предлага по-ниска латентност (в теория), решихме от тези две да оставим Kafka, като de facto стандарт за подобни задачи. Вероятно ще се върнем към Apache Pulsar в бъдеще.
И така, останаха двама кандидати: NATS Streaming и Apache Kafka. Подробно проучихме и двете решения, и и двете отговарят на задачата. Но в крайна сметка се притеснихме от относителната младост на NATS Streaming (и от факта, че един от основните разработчици, Tyler Treat, реши да напусне проекта и да започне свой собствен — Liftbridge). В същото време режимът на Clustering на NATS Streaming не позволяваше силно хоризонтално мащабиране (вероятно вече не е проблем след добавянето на режим на партициониране през 2017 година).
Въпреки това, NATS Streaming е страхотна технология, написана на Go и имаща подкрепата на Cloud Native Computing Foundation. За разлика от Apache Kafka, тя не се нуждае от Zookeeper за работа (възможно е ), тъй като вътрешно реализира RAFT. В същото време NATS Streaming е по-лесен за администриране. Не изключваме, че в бъдеще може да се върнем отново към тази технология.
И все пак, днес нашият победител стана Apache Kafka. В нашите тестове тя показа себе си като достатъчно бърза (над един милион съобщения в секунда за четене и запис при размер на съобщенията от 1 килобайт), достатъчно надеждна, добре мащабируема и проверена от опит в продукцията от големи компании. Освен това, Kafka поддържа поне няколко големи търговски компании (например, ние използваме версията на Confluent), а също така Kafka има развита екосистема.
Преглед на Kafka
Преди да започнем, веднага ще препоръчам отлична книга — «Kafka: The Definitive Guide» (има и на руски, но термините малко бъркат мозъка). В него можете да намерите информация, необходима за основното разбиране на Kafka и дори малко повече. Самата документация от Apache и блогът на Confluent също са отлично написани и лесно четими.
И така, нека да погледнем на Kafka от височина на птичи поглед. Основната топология на Kafka се състои от producer, consumer, broker и zookeeper.
Брокер
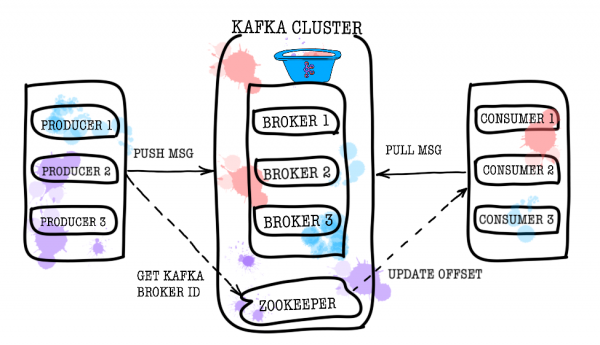
Зад съхранението на вашите данни отговаря брокерът (broker). Всички данни се съхраняват в бинарен вид, а брокерът знае малко за това какво представляват те и каква е тяхната структура.
Всеки логичен тип събития обикновено се намира в своя собствена тема (topic). Например, събитието за създаване на обява може да попада в темата item.created, а събитието за нейното изменение — в item.changed. Темите могат да се разглеждат като класификатори на събития. На нивото на темата можете да зададете такива конфигурационни параметри, като:
- обем на съхраняваните данни и/или техният възраст (retention.bytes, retention.ms);
- фактор на излишък на данни (replication factor);
- максимален размер на едно съобщение (max.message.bytes);
- минимален брой одобрени реплики, при който в темата могат да се запишат данни (min.insync.replicas);
- възможност за извършване на failover на несинхронна изоставаща реплика с потенциална загуба на данни (unclean.leader.election.enable);
- и много други ().
От своя страна, всяка тема се разбива на една или повече партиции (partition). Именно в партицията в крайна сметка попадат събитията. Ако в клъстера има повече от един брокер, партициите ще бъдат равномерно разпределени между всички брокери (доколкото е възможно), което ще позволи мащабиране на натоварването на запис и четене в една тема на няколко брокера едновременно.
На диска данните за всяка партиция се съхраняват под формата на файлове сегменти, по подразбиране равни на един гигабайт (контролирано чрез log.segment.bytes). Важна особеност — изтриването на данни от партициите (при задействане на retention) става именно в сегменти (не може да се изтрие едно събитие от партицията, може да се изтрие само целият сегмент, и то само неактивен).
Zookeeper
Zookeeper изпълнява ролята на хранилище на метаданни и координатор. Именно той може да каже дали брокерите са живи (можете да го видите през zookeeper-shell с командата ls /brokers/ids), кой от брокерите е контролерът (get /controller), дали партициите синхронизирано състояние със своите реплики (get /brokers/topics/topic_name/partitions/partition_number/state). Също така именно zookeeper първо ще бъде запитан от producer и consumer, за да узнае на кой брокер какви теми и партиции се съхраняват. В случаи, когато за тема е зададен replication factor, по-голям от 1, zookeeper ще посочи, кои партиции са лидери (в тях ще се записва и от тях ще се чете). При падане на брокер, точно в zookeeper ще бъде записана информация за новите лидер-партиции (от версия 1.1.0 асинхронно, ).
В по-старите версии на Kafka zookeeper отговаряше и за съхранение на офсети, но сега те се съхраняват в специална тема __consumer_offsets на брокера (въпреки че можете все още да използвате zookeeper за тези цели).
Най-простият начин да превърнете вашите данни в тиква е именно загубата на информация от zookeeper. В такъв сценарий ще бъде много трудно да разберете какво и откъде да четете.
Производител
Producer — това най-често е услуга, която реализира пряко записване на данни в Apache Kafka. Producer избира тема, в която ще се съхраняват неговите тематични съобщения, и започва да записва информация в нея. Например, producer може да бъде услуга за обявления. В такъв случай той ще изпраща в тематичните топики събития като „обявление създадено“, „обявление обновено“, „обявление изтрито“ и т.н. Всяко събитие в този случай представлява двойка ключ-стойност.
По подразбиране всички събития се разпределят по партициите на темата с round-robin, ако ключът не е зададен (загуба на подреденост), и чрез MurmurHash (ключ), ако ключът присъства (подреденост в рамките на една партиция).
Тук веднага трябва да отбележим, че Kafka гарантира реда на събитията само в рамките на една партиция. Но на практика това често не е проблем. Например, можете гарантирано да добавяте всички изменения на едно и също обявление в една партиция (по този начин запазвайки реда на тези изменения в рамките на обявлението). Освен това можете да предавате пореден номер в едно от полетата на събитието.
Consumer
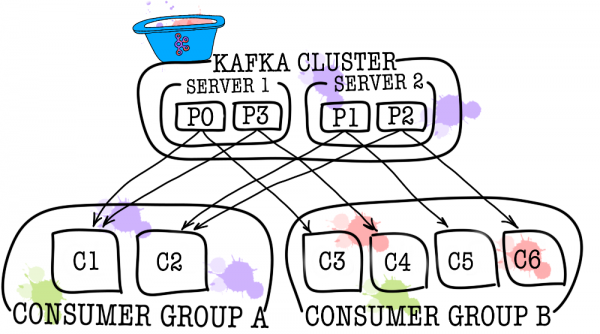
Консумиращият извършва получаване на данни от Apache Kafka. Ако се върнем към примера по-горе, консуматорът може да бъде модераторен сървис. Този сървис ще се абонира за темата на сървиса за обяви и при появата на нова обява ще я получи и анализира по отношение на определени зададени политики.
Apache Kafka помни какви последни събития е получил консуматорът (за това се използва служебната тема __consumer__offsets), като по този начин гарантира, че при успешно прочитане консуматорът не получава едно и също съобщение два пъти. Въпреки това, ако се използва опцията enable.auto.commit = true и напълно се отдаде работата по проследяване на позицията на консуматора в темата на Kafka, може да . В производствения код най-често позицията на консуматора се контролира ръчно (разработчикът управлява момента, в който задължително трябва да се извърши комит на прочетеното събитие).
В случаите, когато един консуматор не е достатъчен (например, ако потокът от нови събития е много голям), можете да добавите още няколко консуматора, свързвайки ги в консуматорска група. Консуматорската група логически представлява точно такъв консуматор, но с разпределение на данните между участниците в групата. Това позволява на всеки от участниците да вземе своя дял от съобщенията, като по този начин увеличава скоростта на четене.
Резултати от тестуването
Тук няма да пиша много пояснителен текст, просто ще споделя получените резултати. Тестовете бяха проведени на 3 физически устройства (12 CPU, 384 GB RAM, 15k SAS DISK, 10 GBit/s Нет), брокерите и zookeeper бяха разположени в lxc.
Тестване на производителността
В хода на тестовете бяха получени следните резултати.
- Скорост на запис на съобщения с размер 1 KB едновременно от 9 продюсера — 1,300,000 събития в секунда.
- Скорост на четене на съобщения с размер 1 KB едновременно от 9 консуматора — 1,500,000 събития в секунда.
Тест на устойчивостта
В хода на тестовете бяха получени следните резултати (3 брокера, 3 zookeeper).
- Неочакваното прекратяване на един от брокерите не води до спиране или недостъпност на кластера. Работата продължава в нормален режим, но на останалите брокери пада по-голямо натоварване.
- Неочаквано приключване на двама брокери в случай на клъстер от три брокера и min.isr = 2 води до недостъпност на клъстера за запис, но остава достъпен за четене. В случай, че min.isr = 1, клъстерът продължава да бъде достъпен както за четене, така и за запис. Въпреки това, този режим противоречи на изискването за висока безопасност на данните.
- Неочаквано приключване на един от сървърите на Zookeeper не води до спиране или недостъпност на клъстера. Работата продължава в нормален режим.
- Неочаквано приключване на двама сървъри на Zookeeper води до недостъпност на клъстера, докато не се възстанови работата на поне един от сървърите на Zookeeper. Това изявление е вярно за клъстера на Zookeeper с 3 сървъра. В резултат на изследванията беше решено да се увеличи клъстерът на Zookeeper до 5 сървъра за увеличаване на отказоустойчивостта.
Kafka като услуга
Убедихме се, че Kafka е отлична технология, която решава поставената пред нас задача (реализация на брокера за съобщения). Въпреки това, решихме да забраним на услугите да се обръщат директно към Kafka и я затворихме отгоре с услугата data-bus. Защо го направихме? Всъщност има няколко причини.
Data-bus пое всички задачи, свързани с интеграцията с Kafka (реализация и настройка на потребители и производители, мониторинг, известяване, логиране, мащабиране и т.н.). Така интеграцията с брокера за съобщения се извършва максимално лесно.
Data-bus позволи да се абстрахираме от конкретния език или библиотека за работа с Kafka.
Data-bus позволи на другите услуги да се абстрахират от слоя за съхранение. Може би в някакъв момент ще сменим Kafka с Pulsar, и в същото време никой няма да забележи (всички услуги знаят само за API на data-bus).
Data-bus пое валидирането на схемите на събитията.
С помощта на data-bus беше реализирана аутентификация.
Под прикритие на data-bus можем без даунтайм, незабелязано да актуализираме версиите на Kafka, централизирано да управляваме конфигурациите на производителите, потребителите, брокерите и т.н.
Data-bus позволи добавянето на необходимите функции, които липсват в Kafka (като одит на теми, контрол на аномалиите в клъстера, създаване на DLQ и т.н.).
Data-bus позволява централизирано реализиране на failover за всички услуги.
В момента, за да започнете да изпращате събития в брокера за съобщения, е достатъчно да свържете малка библиотека в кода на услугата си. Това е всичко. Получавате възможността да пишете, четете и мащабирате с една ред код. Цялата реализация е скрита от вас, навън излизат само няколко ръчки, тип размер на пакета. Под капака услугата data-bus стартира в Kubernetes необходимия брой инстанции на производители и потребители и им предоставя нужната конфигурация, но всичко това е прозрачно за вашата услуга.
Разбира се, не съществува сребърна куршума, и този подход има свои ограничения.
- Data-bus трябва да се поддържа от вас, за разлика от външните библиотеки.
- Data-bus увеличава броя на взаимодействията между услугите и брокера за съобщения, което води до намаляване на производителността в сравнение с чиста Kafka.
- Не всичко може така лесно да се скрие от услугите, не ни се иска да дублираме функционалността на KSQL или Kafka Streams в data-bus, затова понякога се налага да разрешим на услугите да взаимодействат директно.
В нашия случай предимствата надвиха недостатъците, и решението да скрием брокера за съобщения зад отделна услуга се оправда. През годината на експлоатация не сме имали никакви сериозни инциденти или проблеми.
P.S. Благодаря на приятелката ми, Екатерина Обаляева, за страхотните илюстрации към тази статия. Ако ви харесват, ще намерите още повече илюстрации.
Източник: habr.com
