

В средата на SRE-\/DevOps инженери никого не изненадва, че един ден клиент (или система за мониторинг) съобщава, че "всичко е загубено": сайтът не работи, плащанията не минават, животът е тлен… Както и да искаме да помогнем в такава ситуация, да се направи това без прост и ясен инструмент е много трудно. Често проблемът е скрит в кода на самото приложение – нужно е само да го локализираме.
И в горе, и в радост…
Така се е случило, че вече доста отдавна и много сме се влюбили в New Relic. Той беше и остава отличен инструмент за мониторинг на производителността на приложението, а също така позволява инструментализирането на микросервисна архитектура (чрез своя агент) и много, много други неща. И всичко би могло да е прекрасно, ако не бяха измененията в ценовата политика на услугата: неговата цената нарасна повече от 3 пъти. Освен това, от миналата година за получаване на trial-аккаунт е нужно да се комуникира с личен мениджър, което затруднява представянето на продукта на потенциални клиенти.
Обичайна ситуация: New Relic не е необходим на "постоянна база", за него се сещат само в момента, когато започнат проблемите. Но плащането все пак е необходимо редовно (по 140 USD на сървър на месец), а в автоматично мащабираща се облачна инфраструктура сумите не са малки. Въпреки че има възможност "Pay-As-You-Go", за включване на New Relic е необходимо да се рестартира приложението, което може да доведе до загуба на онези проблемни ситуации, заради които всичко се планира. Неотдавна New Relic въведе нов тарифен план – , – който на пръв поглед изглежда разумна алтернатива на Professional… но при детайлно разглеждане се оказа, че част от важните функции отсъстват (по-специално, нямат Key Transactions, Cross Application Tracing, Distributed Tracing).
В резултат на това се замислихме за търсене на по-евтина алтернатива, и нашият избор падна на две услуги Datadog и Atatus. Защо именно на тях?
За конкурентите
Веднага ще поясня, че на пазара присъстват и други решения. Ние дори разглеждахме Open Source варианти, но не при всеки клиент има налични ресурси за хостване на решения от категория self-hosted… – освен това, те изискват допълнителна поддръжка. Избраната от нас двойка се оказа най-близка до нашите нужди:
- вградена и развита поддръжка на PHP приложения (стекът на нашите клиенти е много разнообразен, но това е явен лидер в контекста на търсене на алтернативи на New Relic);
- достъпна цена (под 100 USD на месец за хостинг);
- автоматизирана инструментация;
- интеграция с Kubernetes;
- сходство с интерфейса на New Relic — забележителен плюс (защото нашите инженери са свикнали с него).
Затова на етапа на първоначалния подбор отсяхме няколко други популярни решения, а именно:
- Tideways, AppDynamics и Dynatrace — заради цената;
- Stackify — блокиран в РФ и показва твърде малко данни.
Следващата статия е построена по такъв начин, че първо ще бъдат кратко представени разглежданите решения, а след това ще разкажа за нашето типично взаимодействие с New Relic и опитите/впечатленията от извършването на аналогични операции в други услуги.
Представяне на отборените конкуренти
За , предполагам, всеки е чувал? Тази услуга започна своето развитие преди повече от 10 години, през 2008 г. Активно я използваме от 2012 г. и не сме имали проблеми с интеграцията на наистина голям брой приложения на PHP, Ruby и Python, а също така имаме опит с интеграция на C# и Go. Авторите на услугата имат решения за мониторинг на приложения, инфраструктури, трасировка на микросервисни инфраструктури, създадени са удобни приложения за потребителски устройства и много друго.
Обаче агентът на New Relic работи по собствени протоколи, в него няма поддръжка за OpenTracing. За разширена инструментация е необходимо да се внасят промени специално за New Relic. Накрая, поддръжката на Kubernetes все още има експериментален статус.
Започнал своето развитие през 2010 година изглежда значително по-интересно от New Relic именно по отношение на употребата в Kubernetes среди. По-специално, той поддържа интеграция с NGINX Ingress, събиране на логове, протоколи statsd и OpenTracing, което позволява да се проследи потребителското запитване от момента на свързването до завършването му, както и да се намерят логове по това запитване (както от страна на уеб сървъра, така и от страна на клиентите).
При използване на Datadog се сблъскахме с това, че той понякога неправилно изграждаше картата на микросервисите и с някои технически недостатъци. Например, той неправилно определи типа на услугата (възприе започна Django за услуга за кеширане) и генерираше 500-те грешки в PHP приложението, използващо популярната библиотека Predis.
— най-младият инструмент; услугата е стартирана през 2014 година. Неговият маркетингов бюджет очевидно отстъпва на изброените конкуренти, споменаванията се срещат значително по-рядко. Въпреки това, самият инструмент е много подобен на New Relic, не само в функциите (APM, Browser monitoring и др.), но и във външния вид.
Значителен недостатък е, че поддържа само Node.js и PHP. От друга страна, тя е реализирана значително по-добре в сравнение с Datadog. За разлика от последния, Atatus не изисква от приложенията допълнителни модификации и поставяне на етикети в кода.
Как работим с New Relic
Сега да разгледаме как обикновено използваме New Relic. Да предположим, че имаме проблем, който изисква решение:
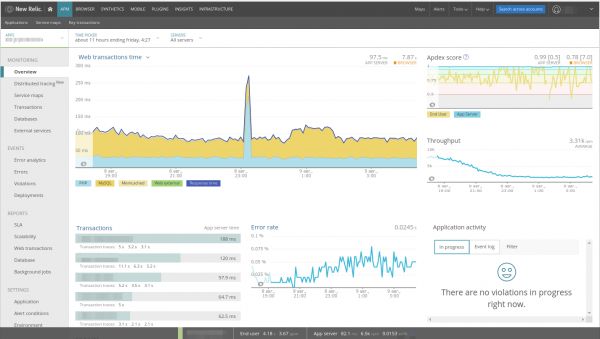
На графиката лесно се забелязва всплеск — ще го анализираме. В New Relic за уеб приложението веднага са избрани уеб транзакции, в графиката за производителност са посочени всички компоненти, налични са панели за error-rate, request-rate… Най-важното е, че директно от тези панели можем да преминаваме между различните части на приложението (например, клик на MySQL ще ни отведе до раздела за бази данни).
Тъй като в разглеждания пример виждаме увеличение на активността PHP, ще кликнем върху този график и автоматично ще преминем в Transactions:
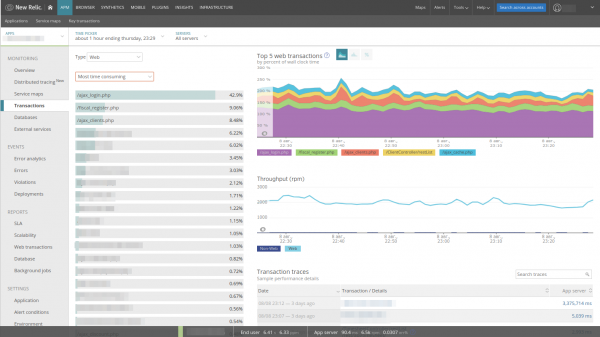
Списъкът с транзакции, които по същество са контролери от модела MVC, вече е сортиран по Most time consuming, което е много удобно: веднага виждаме с какво се занимава приложението. Тук също има примери за дълги заявки, които New Relic автоматично събира. Превключвайки сортирането, лесно можем да намерим:
- най-натоварения контролер на приложението;
- най-често искания контролер;
- най-бавния контролер.
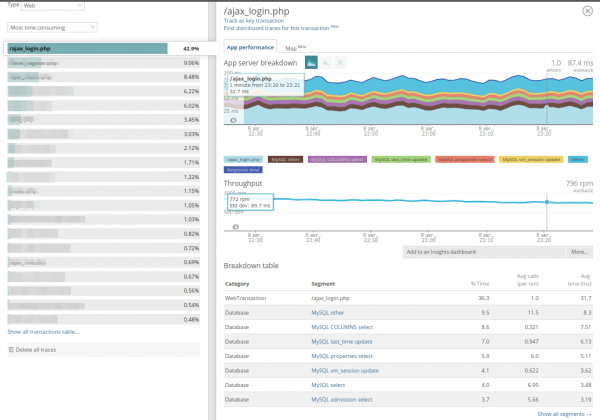
Освен това, можем да разгърнем всяка транзакция и да видим с какво се е занимавало приложението по време на изпълнението на кода:
Накрая, в приложението са запазени примери за трасета на дълги заявки (които отнемат повече от 2 секунди). Ето панел за дълга транзакция:
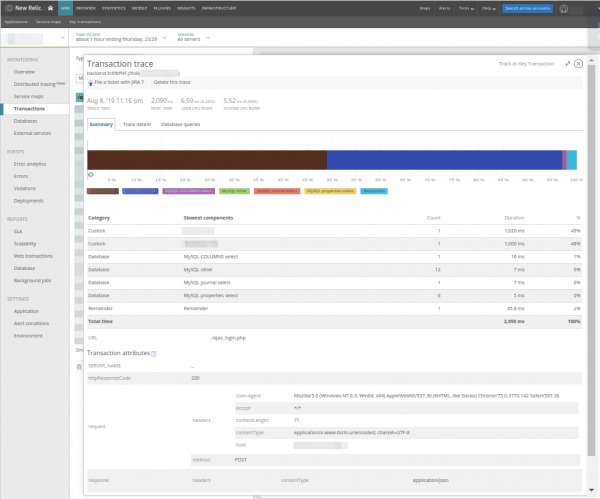
Ясно е, че много време отнемат два метода, а заедно с това се показва и времето, когато е била изпълнена заявката, нейният URI и домейн. Много често това помага да намерим заявката в логовете. Преминавайки към Trace details, можем да видим откъде се извикват тези методи:
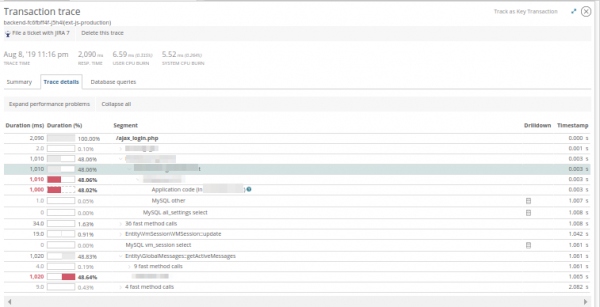
А в Database queries — да оценим заявките към базите данни, които са изпълнявани по време на работата на приложението:
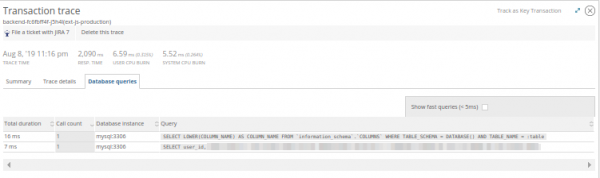
С натрупаните знания можем да оценим причините за забавянето на приложението и заедно с разработчика да изработим стратегия за решаване на проблема. В реалността New Relic не винаги предоставя ясна картина, но помага да изберем посока на разследване:
- дълго
PDO::Constructни доведе до странно функциониране на pgpoll; - нестабилност във времето
Memcache::Getпоказа некоректна конфигурация на виртуалната машина; - подозрително увеличеното време за обработка на шаблона доведе до вложен цикъл с проверка за наличността на 500 аватара в обектното хранилище;
- и така нататък…
Има случаи, когато вместо изпълнението на кода на основния екран се увеличава нещо свързано с външното съхранение на данни — без значение какво е то: Redis или PostgreSQL, — всички те се крият в таба Databases.
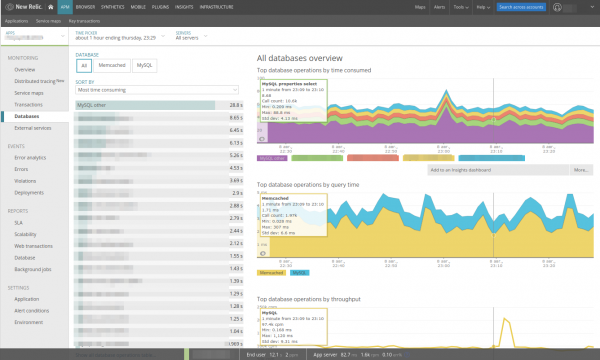
Може да изберете конкретна база за изследване и да проведете сортиране на запитванията — аналогично на начина, по който се прави в Transactions. Преминавайки в таба за запитвания, можете да видите колко често това запитване се среща във всеки от контролерите на приложението, както и да оцените колко често се извиква. Това е много удобно:
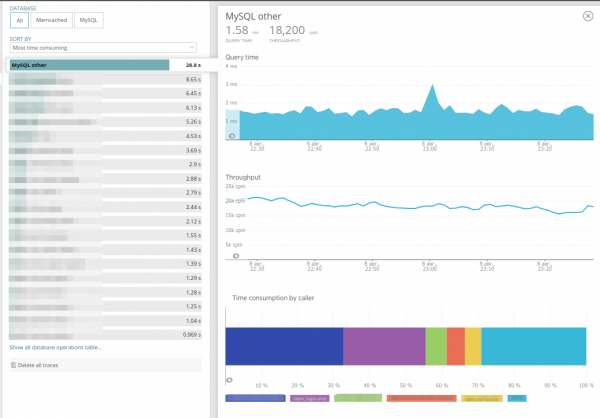
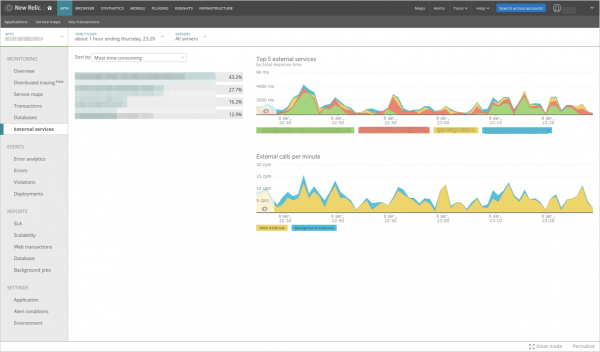
Аналогични данни съдържа таба Външни услуги, който крие запитвания към външни HTTP услуги, като обращения към обектното хранилище, изпращане на събития в Sentry или подобни. По съдържание таба е напълно аналогичен на Databases:
Конкуренти: възможности и впечатления
Сега идва интересното — да сравним възможностите на New Relic с тези на конкурентите. За съжаление, не успяхме да тестваме и трите инструмента на една версия на работещо приложение в продукция. Въпреки това, се опитахме да сравним максимално идентични ситуации/конфигурации.
1. Datadog
Datadog ни посреща с панел със стена от услуги:
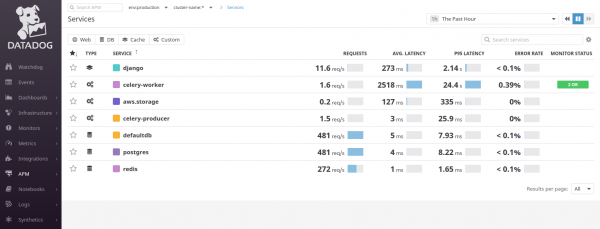
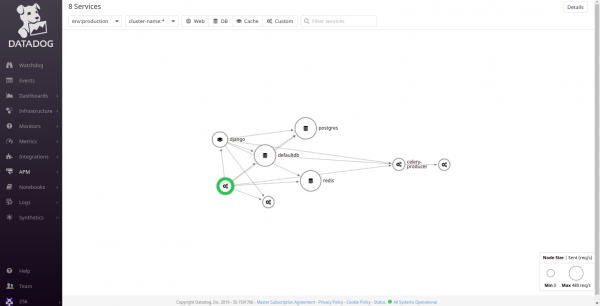
Той се опитва да раздели приложенията на компоненти/микросервизи, затова в приведеното в примера Django приложение ще видим 2 свързвания към PostgreSQL (defaultdb и postgres), както и Celery, Redis. Работата с Datadog изисква минимални знания за принципите на MVC: необходимо е да разбирате накъде точно идват заявките на потребителите. Обикновено това помага карта на услугите:
Между другото, нещо подобно има и в New Relic:
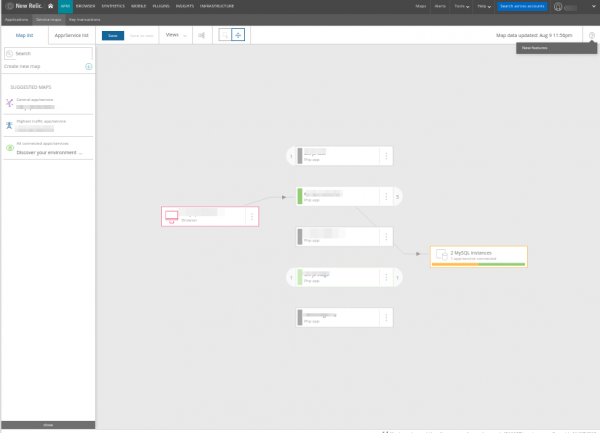
… а картата им, според мен, е направена по-просто и по-разбираемо: тя показва не компонентите на едно приложение (което би я направило прекалено подробна, както в случая с Datadog), а само конкретни услуги или микросервизи.
Да се върнем към Datadog: от картата на услугите можем да видим, че потребителските заявки идват в Django. Ще преминем към услугата Django и най-накрая ще видим това, което очаквахме:
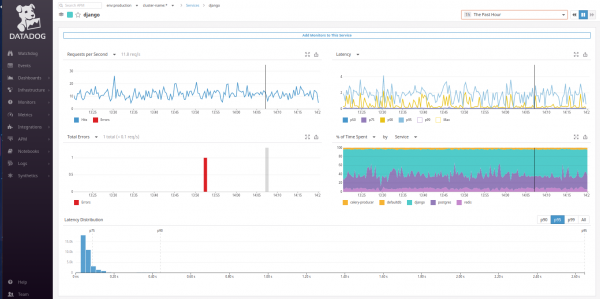
За съжаление, по подразбиране тук няма графика Време за уеб транзакции, аналогично на това, което виждаме на главната панела на New Relic. Обаче може да бъде настроено на мястото на графика % от времето, прекарано. Достатъчно е да го превключите в Средно време на заявка по тип… и ето, вече познатият график ни гледа!
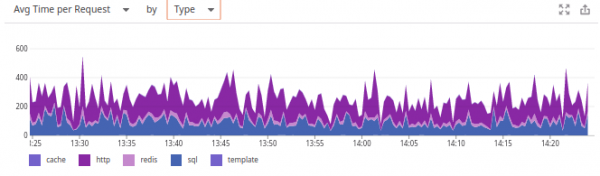
Защо в Datadog предпочетоха друг график — за нас е загадка. Разочароващо беше също, че системата не помни избора на потребителя (в отличие от двамата конкуренти), и следователно — единственото решение е създаването на потребителски панели.
Но зарадва възможността в Datadog да се премине от тези графики към метриките на свързаните сървъри, да се прочетат логовете и да се оцени натоварването на обработвачите на уеб сървъра (Gunicorn). Всичко е почти като в New Relic… и дори малко повече (логовете)!
Под графиките се намират транзакции, абсолютно аналогични на New Relic:
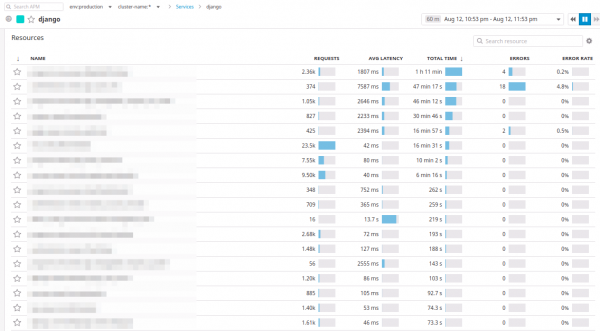
В Datadog транзакциите се наричат ресурси. Може да се сортират контролерите по брой заявки, по средно време на отговор, по максимално прекарано време за избрания период.
Ресурсът може да бъде разширен и да се види всичко, което вече наблюдавахме в New Relic:
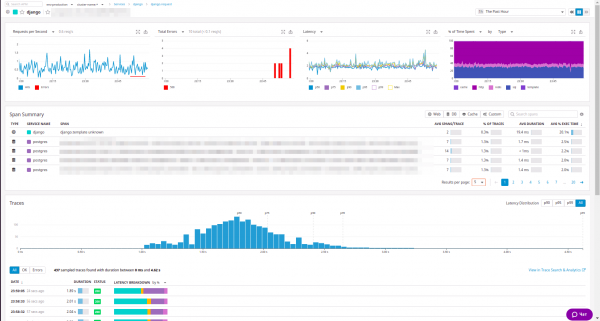
Налична е статистика за ресурса, обобщен списък на вътрешните повиквания и примери на заявки, които могат да бъдат сортирани по код на отговор… Между другото, това сортиране много се хареса на нашите инженери.
Всеки пример за ресурс в Datadog може да бъде разкрит и изучен:
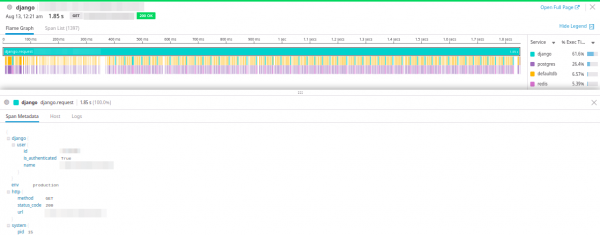
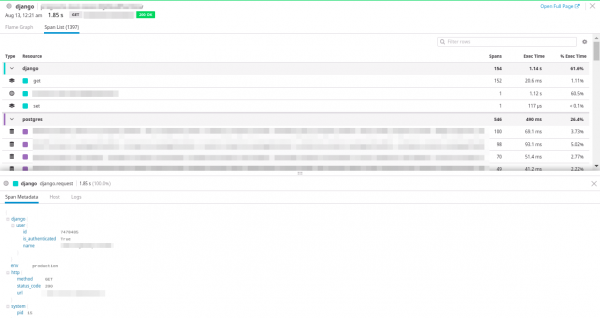
Представени са параметрите на заявката, обобщена диаграма за времето, прекарано върху всеки от компонентите, и водопадна диаграма, в която се вижда последователността на повикванията. Също така е налично превключване на дървовидния вид на водопадната диаграма:
И най-интересното — преглед на натоварването на хоста, на който е изпълнена заявката, и преглед на логовете на заявката.
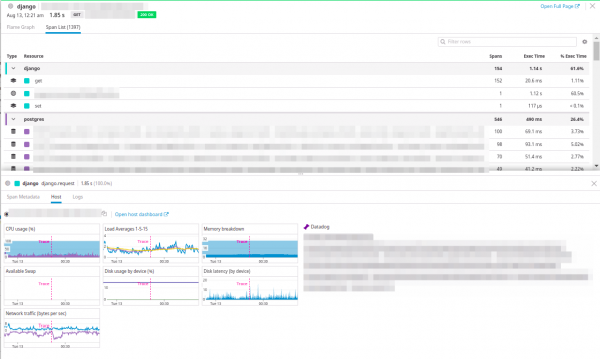
Отлична интеграция!
Може да възникне въпрос, къде са разделите Databases и Външни услуги, както в New Relic. Тук ги няма: тъй като Datadog разлага приложението на компоненти, PostgreSQL ще се счита за отделна услуга, а вместо Външни услуги трябва да се търси aws.storage (аналогично ще бъде и за всяка друга външна услуга, до която приложението може да се обърне).
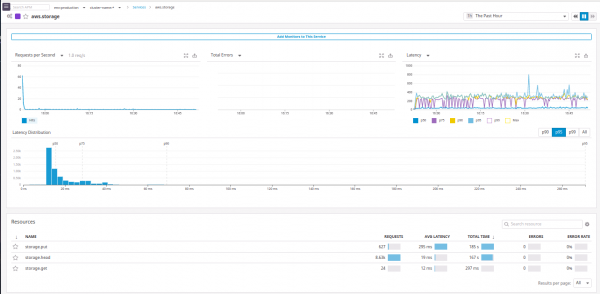
А ето пример с postgres:
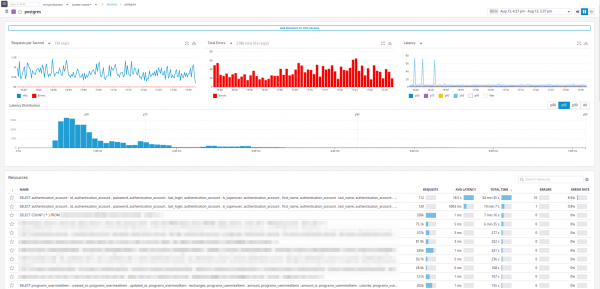
По същество имаме всичко, което искахме:
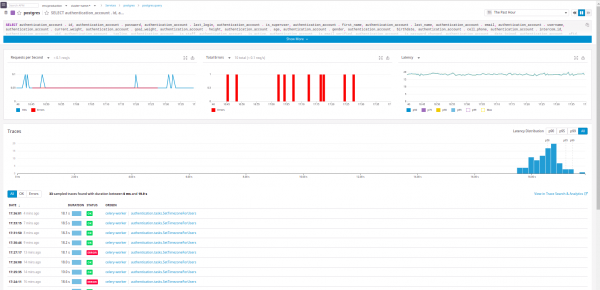
Ясно е от кой „сервис“ е дошло заявката.
Не е излишно да напомним, че Datadog отлично се интегрира с NGINX Ingress и позволява провеждане на цялостно проследяване от момента на постъпване на заявката в клъстера, а също така позволява да приемате метрики statsd, да събирате логове и метрики на хостовете.
Огромен плюс на Datadog е, че цената му включва мониторинг на инфраструктурата, APM, управление на логовете и Synthetics test, т.е. можете гъвкаво да подберете план.
2. Atatus
Екипът на Atatus твърди, че техният сервис — „същият като New Relic, но по-добър“. Нека проверим дали е така наистина.
Заглавната панелистена изглежда наистина подобно, но не успяхме да определим използваните в приложението Redis и memcached.
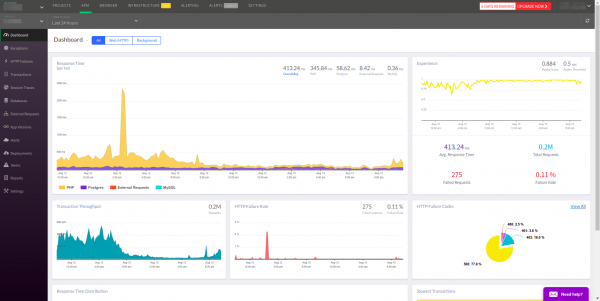
APM по подразбиране избира всички транзакции, въпреки че, обикновено, са нужни само уеб. Както в Datadog, няма възможност да се премине към нужния сервис от основния панел. Освен това, транзакциите се намират в списъка след грешките, което не изглежда много логично за APM.
В транзакциите на Atatus всичко е максимално подобно на New Relic. Минус — веднага не се вижда динамиката за всеки от контролерите. Тя трябва да се търси в таблицата с контролери, сортирайки по Най-продължително време:
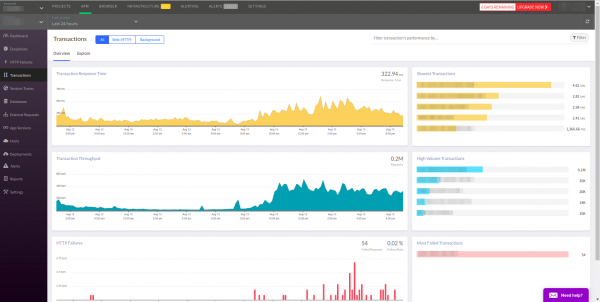
Познатият ни списък с контролери е наличен в раздела Explore:
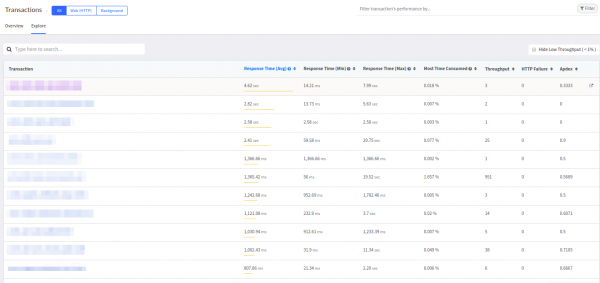
Тази таблица донякъде напомня Datadog и ни харесва повече от аналогичната в New Relic.
Всяка транзакция може да бъде разширена и да се види с какво се е занимавало приложението:
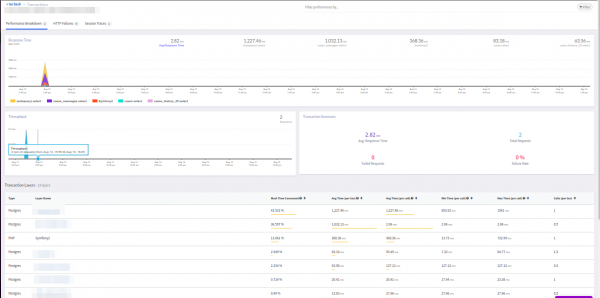
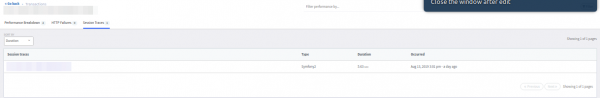
Панелът също наподобява Datadog: има брой на заявките, обща картина на извикванията. Горният панел предоставя раздел с грешки HTTP Failures и примери за бавни заявки Session Traces:
Ако преминете в транзакцията, ще видите пример за проследяване, можете да получите списък на заявките към базата и да видите заглавките на заявката. Всичко е по подобие на New Relic:
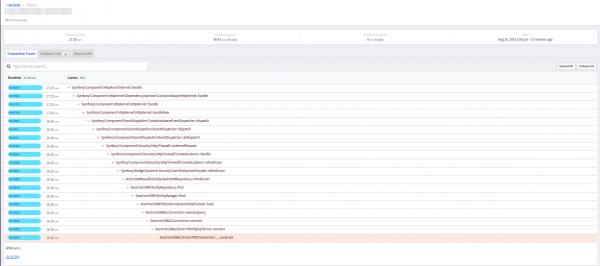
Наистина, Atatus ни впечатли с подробните проследявания — без типичните за New Relic агрегации на извикванията в блок reminder:
Но тук липсва филтър, който (както в New Relic) да отсява свръхбързите заявки (<5мс). От една страна, визуализацията на крайния отговор на транзакцията (успешен или грешка) ни хареса.
Панел Databases ще помогне да се изследват заявките към външни бази, които прави приложението. Напомням, че Atatus намери само PostgreSQL и MySQL, въпреки че в проекта са ангажирани и Redis, и memcached.
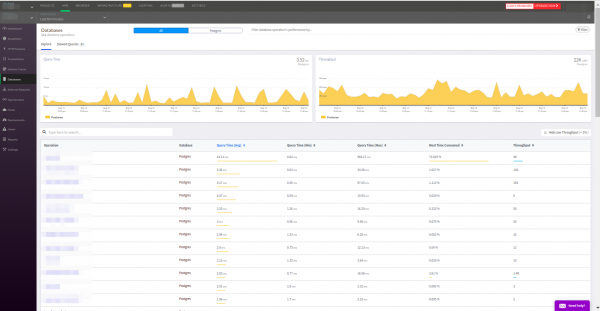
Запитванията се сортират по познатите критерии: честота на задействане, средно време за отговор и така нататък. Отделно е важно да се отбележи разделът с най-бавните запитвания — това е много удобно. Освен това, данните в този раздел за PostgreSQL съвпаднаха с данните от разширението. — отличен резултат!
Вкладка Външни запитвания напълно идентична на Бази данни.
Изводи
И двата представени инструмента показаха добри резултати в ролята на APM. Всеки от тях може да предложи необходимия минимум. Кратко обобщение на нашите впечатления е следното:
Datadog
Плюсове:
- удобна тарифна мрежа (APM струва 31 USD на хост);
- отлично се представи с Python;
- възможност за интеграция с OpenTracing.
- интеграция с Kubernetes;
- интеграция с NGINX Ingress.
Недостатъци:
- единственият APM, който предизвика недостъпност на приложението поради грешка в модула (predis);
- слаба автоинструментация на PHP;
- отчасти странно определение на услугите и тяхното предназначение.
Atatus
Плюсове:
- дълбока инструментация на PHP;
- похож на New Relic потребителски интерфейс.
Недостатъци:
- не работи на стари операционни системи (Ubuntu 12.05, CentOS 5);
- слаба автоинструментация;
- поддръжка само на два ЯП (Node.js и PHP);
- бавна работа на интерфейса.
Като се има предвид цената на Atatus от 69 USD на месец за сървър, ние по-скоро бихме използвали Datadog, който отлично се интегрира с нашите нужди (веб-приложения в K8s) и предлага много полезни функции.
P.S.
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
