

Подход IaC (Infrastructure as Code) се състои не само от кода, който се съхранява в репозитория, но и от хората и процесите, които обгръщат този код. Може ли да се повторят подходите от разработката на софтуер в управлението и описанието на инфраструктурата? Няма да е ненужно да запомните тази идея, докато четете статията.
Това е разшифровката на моя на .
Слайдове и видеа
- Dry run 2019-04-24
Инфраструктура като bash history
Предположим, че идвате на нов проект, а ви казват: «имаме Инфраструктура като код«. В действителност се оказва, Инфраструктура като bash history или например Документация като bash history. Това е напълно реална ситуация, например, подобен случай описваше Денис Лисенко в своето изказване , той разказа как от bash history са получили стройна инфраструктура в проекта.
При известно желание, може да се каже, че Инфраструктура като bash history это как код:
- възпроизводимост: можете да вземете bash history, да изпълните командите оттам, възможно е, между другото, да получите работна конфигурация на изхода.
- версиониране: знаете кой е влизал и какво е правил, пак не е факт, че това ще ви доведе до работна конфигурация на изхода.
- история: история кой и какво е направил. само не можете да я използвате, ако загубите сървъра.
Какво да правим?
Инфраструктура като код
Дори и този странен случай като Инфраструктура като bash history може да се свърже с Инфраструктура като код, но когато искаме да направим нещо по-сложно от стария добър LAMP сървър, ще стигнем до това, че този код трябва да се модифицира по някакъв начин, да се променя, да се доработва. По-нататък ще разглеждаме паралелите между Инфраструктура като код и разработката на софтуер.
D.R.Y.
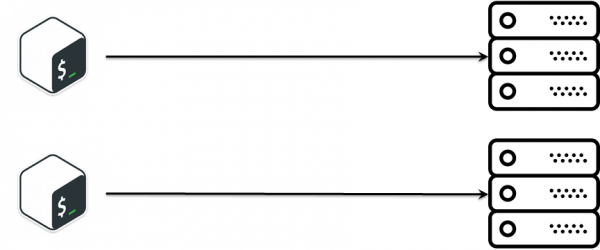
В проекта за разработка на СХД, имаше подзадача : издаваме нов релиз — необходимо е да го развъртим за по-нататъшно тестване. Задачата е напълно проста:
- влез тук по ssh и изпълни командата.
- скопирай файла там.
- направи конфигурацията тук.
- стартни услугата там
- …
- ПЕЧАЛБА!
За описаната логика е повече от достатъчно bash, особено в ранните етапи на проекта, когато той току-що стартира. Това , но с времето се появяват заявки да се разшири нещо подобно, но леко различаващо се. Първото, което идва на ум: копиране и поставяне. И ето, вече имаме два много подобни скрипта, които почти вършат същото. С времето количеството на скриптовете нарасна и се сблъскахме с факта, че съществува определена бизнес логика за разгръщане на инсталацията, която трябва да се синхронизира между различни скриптове, което е доста сложно.
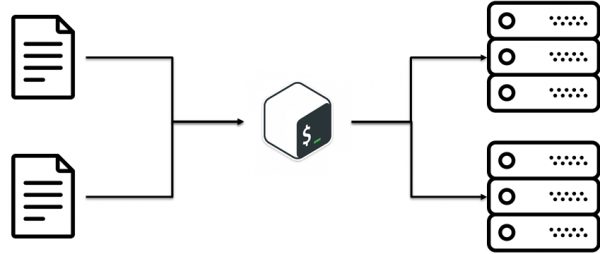
Оказва се, че съществува такава практика D.R.Y. (Не повтаряй себе си). Идеята е да се преизползва съществуващия код. Звучи просто, но не стигнахме до това веднага. В нашия случай това беше банална идея: да отделим конфигурациите от скриптовете. Т.е. бизнес логиката как се разгръща инсталацията отделно, конфигурациите отделно.
S.O.L.I.D. за CFM
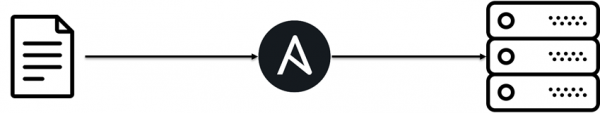
С времето проектът растеше и стана появата на Ansible. Основната причина за неговото поява е наличието на експертиза в екипа и фактът, че bash не е предназначен за сложна логика. Ansible също започна да съдържа сложна логика. За да не се превръща сложната логика в хаос, в разработката на софтуер съществуват принципи за организация на кода. S.O.L.I.D. Също така, например, Григорий Петров в доклада „Защо на IT специалиста му е нужен личен бранд“ засегна въпроса, че човек, по природа, му е по-лесно да оперира с някакви социални единици, в разработката на софтуер това са обекти. Ако обединим тези две идеи и продължим да ги развиваме, можем да забележим, че в описанието на инфраструктурата също може да се използва S.O.L.I.D. за да бъде по-лесно в бъдеще да се поддържа и модифицира тази логика.
Принципът за единствена отговорност
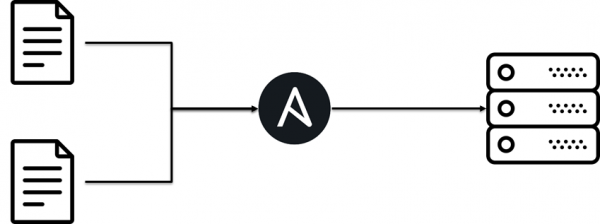
Всеки клас изпълнява само една задача.
Не трябва да смесваме код и да правим монолитни божествени макарони-удвоявачи. Инфраструктурата трябва да се състои от прости тухли. Оказва се, че ако разчленим Ansible playbook на малки парчета, т.е. Ansible роли, те са по-лесни за поддръжка.
Принципът за отвореност/затвореност.
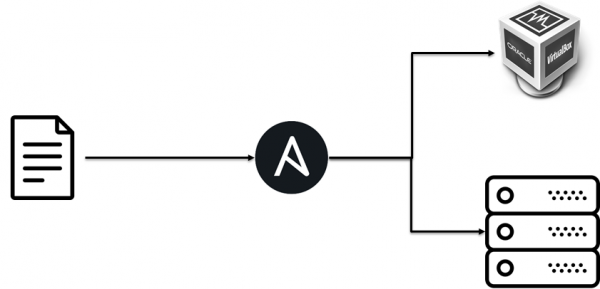
Отворени за разширение: означава, че поведението на единицата може да бъде разширено чрез създаване на нови типове единици.
- Затворени за промяна: в резултат на разширяване на поведението на единицата, не трябва да се внасят промени в кода, който използва тези единици.
- Затворени за промяна: в резултат на разширяване на поведението на сущността, не трябва да се внасят промени в кода, който използва тези сущности.
Първоначално разгръщахме тестова инфраструктура на виртуални машини, но тъй като бизнес логиката за разгръщане беше отделена от реализацията, без проблем добавихме разгръщането на bare metal.
Принцип на подмяна на Лисков
Принципът на подмяна на Барбара Лисков. Обектите в програмата трябва да могат да бъдат заменени с екземпляри на техните подтипове, без да се променя правилността на изпълнението на програмата.
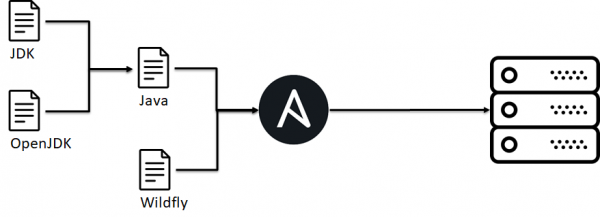
Ако погледнем по-широко, не е особеност само на конкретен проект, че там може да се приложи. S.O.L.I.D., става въпрос за CFM, например, в друг проект е необходимо да се разгръща стандартно Java приложение над различни Java, сървъри на приложения, бази данни, операционни системи и т.н. На този пример ще разглеждам по-нататъшните принципи. S.O.L.I.D.
В нашия случай в рамките на инфраструктурния екип има уговорка, че ако инсталираме ролята imbjava или oraclejava, то имаме бинарен изпълняем файл java. Това е необходимо, тъй като по-висшите роли зависят от това поведение, те очакват наличието на java. В същото време това ни позволява да заменяме една реализация/версия на java с друга, без да променяме логиката на разгръщане на приложението.
Проблемът тук е, че в Ansible не може да се реализира такова, което води до появата на определени уговорки в екипа.
Принцип на разделяне на интерфейса
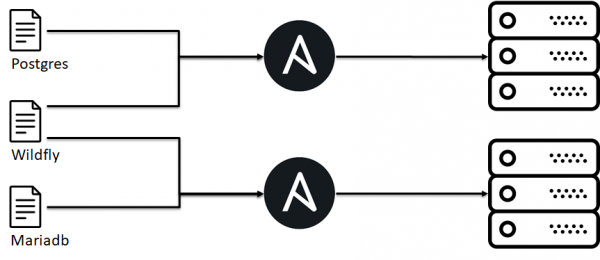
Принципът на разделяне на интерфейса: „много интерфейси, специално проектирани за клиенти, са по-добри от един общ интерфейс.
Първоначално опитвахме да съберем цялата вариативност на разгръщането на приложението в един Ansible playbook, но това беше трудно за поддържане, а подходът, при който имаме специфициран интерфейс навън (клиентът очаква порт 443), ни позволява да сглобим инфраструктурата от отделни блокчета за конкретната реализация.
Принцип на инверсия на зависимостите
Принципът на инверсия на зависимостите. Модулите от по-високо ниво не трябва да зависят от модулите от по-ниско ниво. И двата типа модули трябва да зависят от абстракции. Абстракциите не трябва да зависят от детайлите. Детайлите трябва да зависят от абстракциите.
Тук примерът ще се основава на антипатерн.
- Един от клиентите имаше частно облако.
- В рамките на облака поръчвахме виртуални машини.
- Но поради особеностите на облака, разгръщането на приложението беше свързано с това, на кой хипервизор попадна ВМ.
Т.е. високото ниво на логиката за разгръщане на приложението, зависимостите протичаха на по-долните нива на хипервизора, и това означаваше проблеми при повторната употреба на тази логика. Не прави така.
Взаимодействие
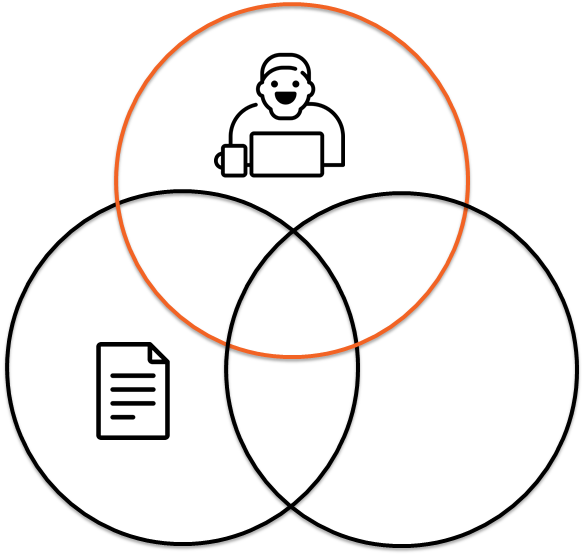
Инфраструктурата като код не е само за кода, а и за отношенията между кода и човека, за взаимодействията между разработчиците на инфраструктура.
Bus фактор
Да предположим, че в проекта ви работи Васил. Васил знае всичко за вашата инфраструктура, какво ще стане, ако той из plötzlich изчезне? Това е напълно реална ситуация, тъй като той може да бъде блъснат от автобус. Понякога това се случва. Ако такова нещо се случи и знанието за кода, неговата структура, как работи, наименованията и паролите не са разпределени в екипа, може да се сблъскате с редица неприятни ситуации. За да минимизирате тези рискове и да разпределите знанието в рамките на екипа, можете да използвате различни подходи.
Двойно Devops-ване
Не е като , за администраторите, които пият бира, сменят пароли, а аналог на парната програмиране. Т.е. двама инженери сядат на един компютър, една клавиатура и започват заедно да настроят вашата инфраструктура: настройка на сървър, написване на Ansible роля и т.н. Звучи добре, но при нас не се получи. Но частни случаи на тази практика проработиха. Нов служител, неговият наставник взема реална задача и работи — предава знанието.
Друг частен случай е инцидентния разговор. По време на проблема се събира екип от дежурни и ангажирани, назначава се един водещ, който споделя екрана си и озвучава мисловния процес. Другите участници следват мисълта на водещия, шпионират трикове от конзолата, проверяват какво не е пропуснато в логовете, научават нови неща за системата. Такъв подход по-скоро работеше, отколкото не.
Code Review
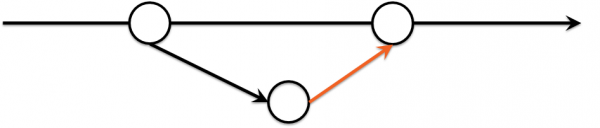
Субективно, по-ефективното разпространение на знанията за инфраструктурата и как е организирана, преминаваше чрез code review:
- Инфраструктурата е описана с код в хранилището.
- Промените се извършват в отделен клон.
- При сливане на заявка може да се види дельтата на промените в инфраструктурата.
Изюминката тук беше, че рецензентите се избираха по ред и по график, т.е. с известна вероятност ще влезете в нов участък от инфраструктурата.
Стил на кода
С времето се появиха конфликти по време на ревютата, тъй като ревюърите имаха свой собствен стил и ротацията на ревюърите ги сблъскваше с различни стилове: 2 интервала или 4, camelCase или snake_case. Внедряването на това не стана веднага.
- Първоначалната идея беше да се препоръча използването на linter, все пак инженерите са умни хора. Но различните редактори, операционни системи, това не е удобно.
- Това еволюира в бот, който по всеки проблемен комит пишеше в Slack и прикачваше изхода от linter. Но в повечето случаи имаше по-важни неща и кодът оставаше неизправен.
Green Build Master
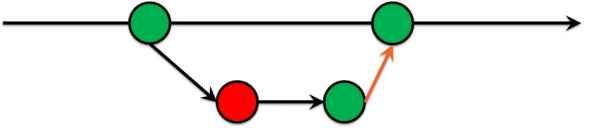
Времето минава и стигнахме до заключението, че не можем да допуснем в master комити, които не преминават определени тестове. Ето ни! Придобихме Green Build Master, който отдавна се практикува в разработката на ПО:
- Разработката става в отделен клон.
- Тестовете се изпълняват по този клон.
- Ако тестовете не преминат, кодът няма да попадне в master.
Приемането на това решение беше доста болезнено, тъй като предизвика много спорове, но си заслужаваше, тъй като на ревютата започнаха да идват искания за сливане без разногласия по стил и с времето броят на проблемните места започна да намалява.
IaC Testing
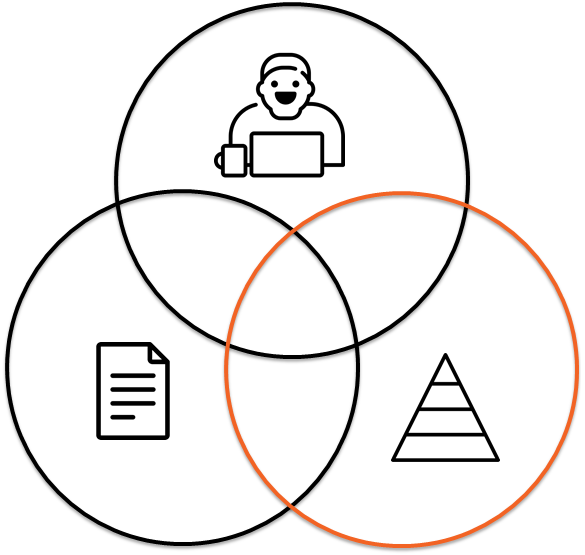
Освен проверката на стила, могат да се използват и други неща, например, да проверим дали вашата инфраструктура наистина може да се разрази. Или да проверим, че измененията в инфраструктурата няма да доведат до загуба на пари. Защо е нужно това? Въпросът е сложен и философски, по-добре е да отговорим с басня, че веднъж имало auto-scaler на Powershell, който не е проверил гранични условия => създадени са повече ВМ, отколкото трябва => клиентът е похарчил повече пари, отколкото е планирал. Неприятно е, но тази грешка можеше да бъде заловена на по-ранен етап.
Може да се запитате, защо да правим сложната инфраструктура още по-сложна? Тестовете за инфраструктура, както и за код, не са за опростяване, а за знание как вашата инфраструктура трябва да работи.
IaC Testing Pyramid
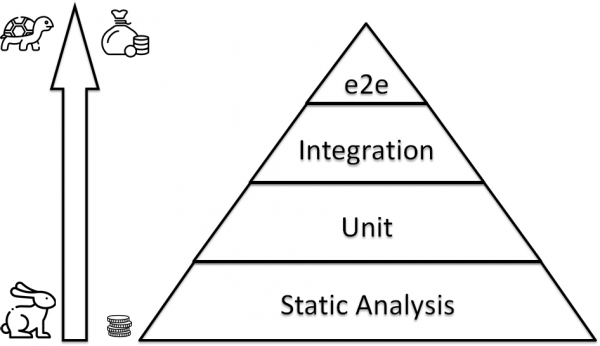
IaC Testing: Static Analysis
Ако веднага разгръщате цялата инфраструктура и проверявате, че тя работи, може да се окаже, че това отнема много време и изисква куп време. Затова в основата трябва да има нещо бързо работещо, което да е много и да покрива множество примитивни места.
Bash е сложен
Нека да разгледаме един банален пример. да изберем всички файлове в текущата директория и да ги копираме на друго място. Първото, което идва на ум:
for i in * ; do
    cp $i \/some\/path\/$i.bak
done
А какво, ако в името на файла има интервал? Ами, добре, ние сме умни, можем да използваме кавички:
for i in * ; do cp \"$i\" \"\/some\/path\/$i.bak\" ; doneМладци? Не! Какво ще стане, ако в директорията няма нищо, т.е. глобингът не сработва.
find . -type f -exec mv -v {} dst\/.bak ;Сега добре ли сме? Не, забравихме, че в името на файла може да има n.
touch x
mv x  \"$(printf \"foonbar\")\"
find . -type f -print0 | xargs -0 mv -t \/path\/to\/target-dir
Инструменти за статичен анализ
Проблемът от предишната стъпка можеше да бъде уловен, когато забравихме кавичките; за това в природата съществуват множество средства , всъщност те са много, и вероятно ще можете да намерите линтер за вашата IDE в зависимост от вашия стек.
Език
Инструмент
bash
Ruby
python
ansible
IaC Тестиране: Юнит тестове
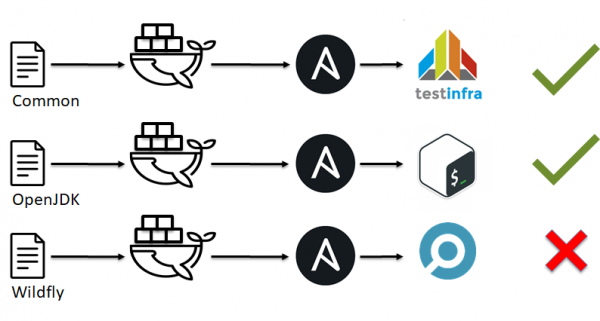
Както видяхме от предишния пример, линтерите не са всемогъщи и не могат да посочат всички проблемни места. В съответствие с аналогията с тестването на софтуер можем да си спомним за юнит тестовете. Веднага наум идват , , , . Но какво да правим с ansible, chef, saltstack и подобни?
В самото начало говорехме за S.O.L.I.D. и че нашата инфраструктура трябва да се състои от малки тухли. Време е за тях.
- Инфраструктурата се разбива на малки тухли, например роли на Ansible.
- Разгръща се някакво окръжение, било то docker или ВМ.
- На това тестово окръжение прилагаме нашата роля на Ansible.
- Проверяваме дали всичко е работило, както очакваме (изпълняваме тестовете).
- Решаваме дали е ОК или не.
IaC Тестиране: Инструменти за юнит тестване
Въпросът е, какво представляват тестовете за CFM? Може да пуснете скрипт, но можете да използвате и готови решения за това:
CFM
Инструмент
Ansible
Chef
Chef
saltstack
Пример за testinfra, проверяваме дали потребителите test1, test2 съществуват и са в групата sshusers:
def test_default_users(host):
    users = ['test1', 'test2' ]
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
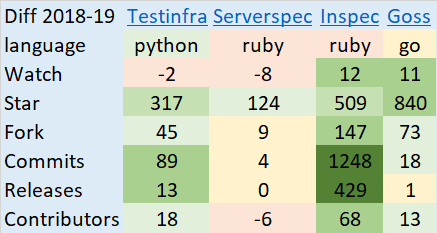
Какво да изберем? Въпросът е сложен и неоднозначен, ето пример за промените в проектите в GitHub за 2018-2019 година:
IaC Тестиране: рамки
Как да сглобим всичко заедно и да го стартираме? Може да при наличие на достатъчно количество инженери. Или можете да вземете готови решения, въпреки че не са много:
CFM
Инструмент
Ansible
Chef
Terraform
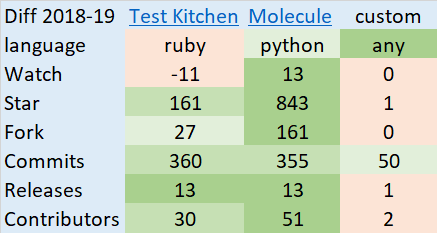
Пример за промените в проектите в GitHub за 2018-2019 година:
Molecule срещу Testkitchen
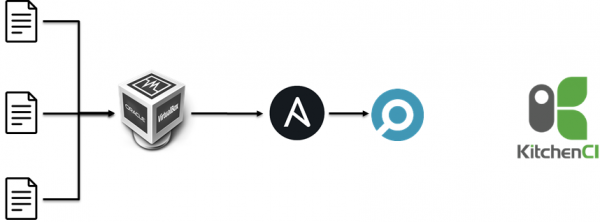
Първоначално ние :
- Да създадем ВМ в паралел.
- Да приложите Ansible роли.
- Изпълнение на inspec.
За 25-35 роли това отне 40-70 минути, което беше дълго.
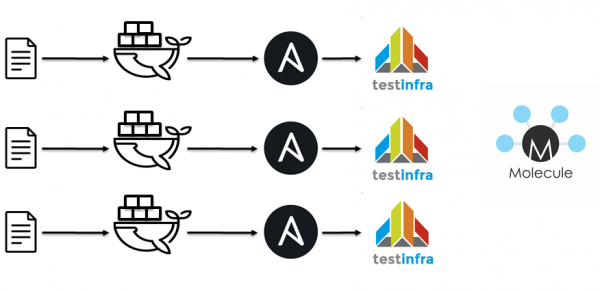
Следващата стъпка беше прехвърлянето на jenkins / docker / ansible / molecule. Идеологически всичко е същото.
- Линтинг на плейбуковете.
- Линтинг на ролите.
- Стартиране на контейнер.
- Да приложите Ansible роли.
- Изпълнение на testinfra.
- Проверка на идемпотентността.
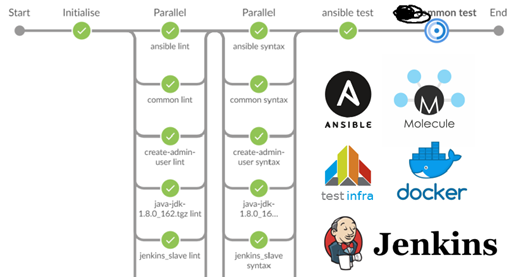
Линтовката за 40 роли и тестовете за десетина започнаха да отнемат около 15 минути.
Какво да изберете зависи от множество фактори, като използвания стек, експертизата в екипа и т.н. Всеки решава сам как да реши въпроса с Unit тестването.
IaC тестване: Интеграционни тестове.
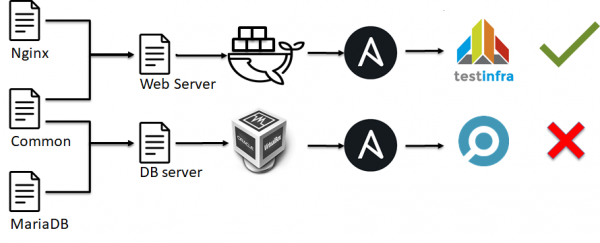
На следващото ниво на пирамидата за тестване на инфраструктурата се появяват интеграционни тестове. Те са подобни на Unit тестовете:
- Инфраструктурата се разделя на малки елементи, например Ansible роли.
- Разгръща се някакво окръжение, било то docker или ВМ.
- Тези тестови среди се прилагат много Ansible роли.
- Проверяваме дали всичко е проработило, както очакваме (изпълняваме тестовете).
- Решаваме дали е ОК или не.
Грубо казано, не проверяваме работоспособността на отделен елемент на системата, както в unit тестовете, а проверяваме как е конфигуриран сървърът като цяло.
IaC тестване: End to End тестове.
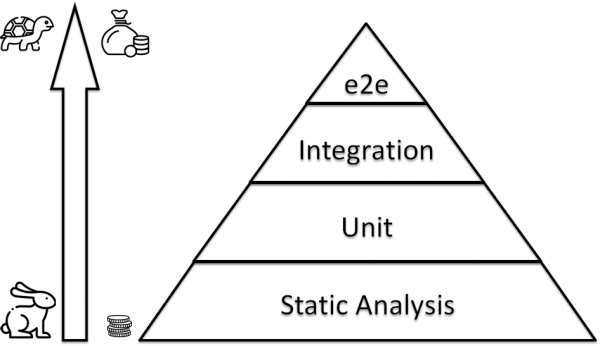
На върха на пирамидата ни посрещат End to End тестовете. Т.е. не проверяваме работоспособността на отделен сървър, отделен скрипт, отделен елемент от нашата инфраструктура. Проверяваме дали множество сървъри, свързани заедно, нашата инфраструктура работи, както очакваме. За съжаление не съм виждал готови решения, вероятно защото инфраструктурата често е уникална и е трудно да се шаблонира и направи фреймворк за тестването ѝ. Както и да е, всички създават свои собствени решения. Има търсене, но няма отговор. Затова ще разкажа какво има, за да подтикна другите към разумни идеи или да ми натресат, че всичко е изобретено преди нас.
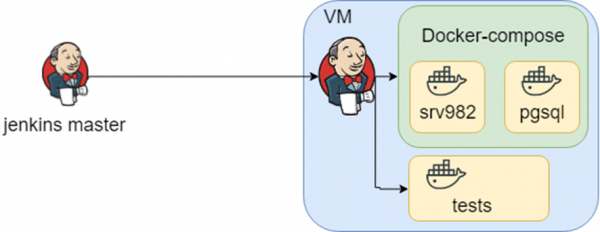
Проект с дълга история. Използва се в големи организации и вероятно всеки от вас е имал косвени срещи с него. Приложението поддържа множество бази данни, интеграции и т.н. Знанието как може да изглежда инфраструктурата включва множество docker-compose файлове, а знанието какви тестове да се пускат в каква среда е jenkins.
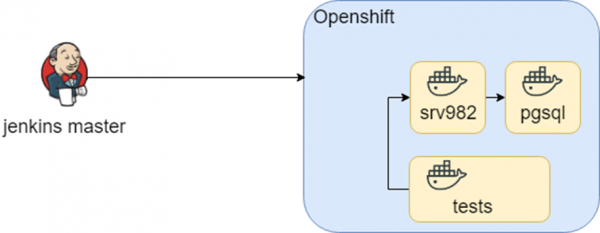
Тази схема работеше дълго време, докато в рамките на не опитахме да я прехвърлим в Openshift. Контейнерите останаха същите, а средата за изпълнение се промени (привет отново D.R.Y.).
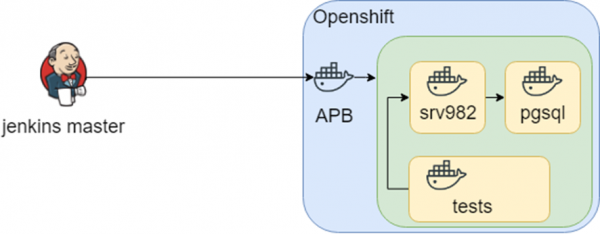
Изследването напредна и в OpenShift открихме нещо наречено APB (Ansible Playbook Bundle), което позволява да опаковаме знанията как да разгръщаме инфраструктура в контейнер. Т.е. имаме воспроизводима, тестируема точка на знание как да разгръщаме инфраструктура.
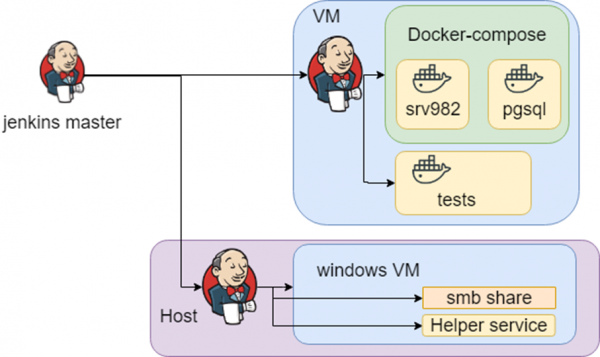
Всичко това звучеше добре, докато не се сблъскахме с хетерогенна инфраструктура: за тестовете ни е необходим Windows. В крайна сметка знанието за това какво, къде и как да разгръщаме и тестваме, остава в Jenkins.
Заключение
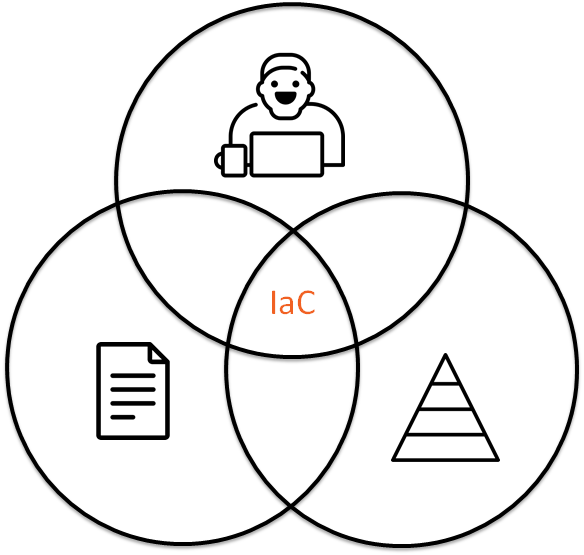
Инфраструктура като код е
- Код в репозиторий.
- Взаимодействие между хора.
- Тестване на инфраструктурата.
линкове
- Dry run 2019-04-24
- &
Източник: habr.com
