

В рамките на изследователски проект беше започната работа по внедряване на възможността в GCC за разделяне на процеса на компилация на няколко паралелно изпълнявани потока. В момента за повишаване на скоростта на сборка на многоядрени системи на нивото на утилитата make се стартират отделни процеси на компилятора, всеки от които извършва сборка на отделен файл с код. Новият проект експериментира с осигуряването на паралелизация на ниво компилатор, което потенциално може да увеличи ефективността на работа на многоядрени системи.
За тестване отделна паралелизираща клонка на GCC, за която е предложен нов параметър "—param=num-threads=N" за задаване на броя на нишките. На начален етап е реализирано изнасяне в отделни потоци на междупроцедурни оптимизации, които циклично се извикват за всяка функция и добре се поддават на паралелизация. В отделни потоци са изнесени операциите GIMPLE, отговорни за независими от хардуера оптимизации, оценяващи взаимовръзката между функциите.
В следващия етап също се планира изнесене на междупроцедурни RTL-оптимизации, вземащи предвид особеностите на хардуерната платформа. След това се планира реализиране на паралелизация на вътрепроцедурни оптимизации (IPA), прилагани към кода вътре в функцията, независимо от особеностите на повикванията. Ограничителното звено засега е събирачът на боклук, в който е добавена глобална блокировка, изключваща операциите по събиране на боклук по време на работа в многопоточен режим (в бъдеще събирачът на боклук ще бъде адаптиран за многопоточна работа в GCC).
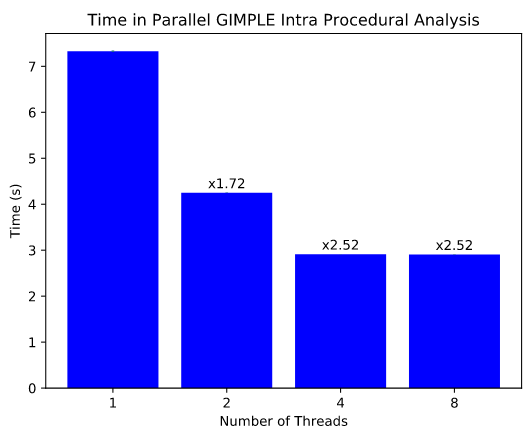
За оценка на промените в производителността е подготвен тестов набор, който извършва компилация на файла gimple-match.c, включващ над 100 хиляди реда код и 1700 функции. Тестовете на система с CPU Intel Core i5-8250U с 4 физически ядра и 8 виртуални (Hyperthreading) показаха намаляване на времето за изпълнение на оптимизациите Intra Procedural GIMPLE от 7 на 4 секунди при стартиране на 2 потока и до 3 секунди при стартиране на 4 потока, т.е. постигнато е увеличаване на скоростта на разглеждания етап на компилация с 1.72 и 2.52 пъти, съответно. Тестовете също показаха, че използването на виртуални ядра при Hyperthreading не води до увеличение на производителността.
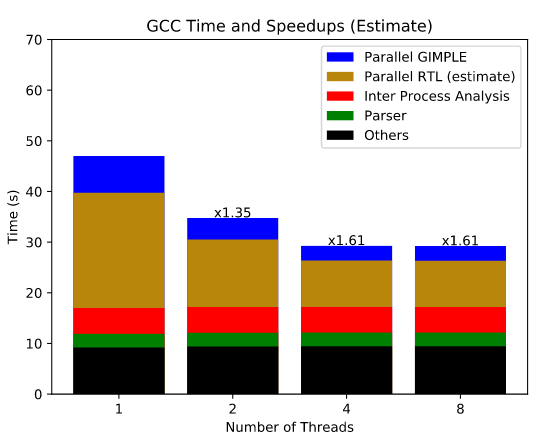
Общото време за компилация намаля с приблизително 10%, но според прогнозите, разпаралеляването на RTL-оптимизациите ще доведе до по-осезаеми резултати, тъй като тази фаза отнема значително повече време при компилация. Приблизително след разпаралеляване на RTL общото време за компилация ще се съкрати с 1.61 пъти. След това ще бъде възможно допълнително намаляване на времето за компилация с 5-10% чрез разпаралеляване на оптимизациите IPA.
Източник: opennet.ru
