

Продължение на превода на малка книга:
«Познание на съобщителните брокери»,
автор: Jakub Korab, издателство: O’Reilly Media, Inc., дата на издаване: юни 2017, ISBN: 9781492049296.
Предишната преведена част:
ГЛАВА 3
Kafka
Kafka е разработена в LinkedIn, за да заобиколи някои ограничения на традиционните брокери на съобщения и да избегне нуждата от конфигуриране на множество брокери на съобщения за различни взаимодействия «точка-точка», което е описано в тази книга в раздела «Вертикално и хоризонтално мащабиране» на страница 28. Сценариите на LinkedIn се основават основно на еднопосочно поглъщане на много големи обеми данни, като кликвания на страници и логове за достъп, като същевременно позволяват на тези данни да се използват от множество системи, без да се влияе на производителността на производителите или другите консуматори. Всъщност, причината за съществуването на Kafka е да предостави архитектура на обмена на съобщения, каквато описва Universal Data Pipeline.
С оглед на тази крайна цел, естествено възникнаха и други изисквания. Kafka трябва:
- Да бъде изключително бърза
- Да предоставя висока пропусквателна способност при работа със съобщения
- Да поддържа моделите «Издател-Абонат» и «Точка-Точка»
- Да не забавя с добавянето на потребители. Например, производителността и опашките на ActiveMQ и темата се влошават с нарастващия брой потребители на получателя
- Да бъде хоризонтално мащабируема; ако един брокер, който запазва съобщения, може да прави това само с максималната скорост на диска, то за увеличаване на производителността е разумно да се надхвърли един екземпляр на брокера
- Да разделя достъпа до съхранение и повторно извлечение на съобщения
За да постигнем всичко това, в Kafka е приета архитектура, която преосмисля ролите и отговорностите на клиентите и брокерите за обмен на съобщения. Моделът JMS е много ориентиран към брокера, където той отговаря за разпространението на съобщения, а клиентите трябва да се грижат единствено за изпращането и получаването на съобщения. Kafka, от своя страна, е ориентирана към клиента, като клиентът поема много функции на традиционен брокер, като например справедливо разпределение на съответните съобщения между потребителите, в замяна получавайки изключително бърз и мащабируем брокер. За хората, работили с традиционни системи за обмен на съобщения, работата с Kafka изисква основни промени в погледите.
Това инженерно направление доведе до създаването на инфраструктура за обмен на съобщения, способна да увеличи пропускната способност с много порядъка в сравнение с обикновен брокер. Както ще видим, този подход е свързан с компромиси, които означават, че Kafka не е подходяща за определени видове натоварвания и инсталиран софтуер.
Унифициран модел на получателя
За да изпълни изискванията, описани по-горе, Kafka обедини обмена на съобщения от тип „публикация-подписка“ и „точка-точка“ в рамките на един вид получател — топик. Това обърква хората, работили с системи за обмен на съобщения, където думата „топик“ се отнася до механизъм за разпространение, от който (от топика) четенето не е надеждно (is nondurable). Топиците в Kafka следва да се считат за хибриден тип получател, в съответствие с определението, дадено във въведението на тази книга.
В оставащата част на тази глава, ако не укажем изрично противното, терминът „топик“ ще се отнася до топика в Kafka.
За да разберем напълно как се държат топиците и какви гаранции предоставят, първо трябва да разгледаме как са реализирани в Kafka.
Всеки топик в Kafka има свой журнал.
Продюсери, които изпращат съобщения в Kafka, записват в този журнал, а консуматорите четат от журнала с помощта на указатели, които постоянно се движат напред. Периодично Kafka изтрива най-старите части на журнала, независимо от това дали съобщенията в тези части са били прочетени или не. Централният елемент на дизайна на Kafka е, че брокерът не се интересува от това дали съобщенията са били прочетени — това е отговорност на клиента.
Термините „журнал“ и „указател“ не се срещат в . Тези добре известни термини се използват тук, за да помогнат при разбирането.
Тази модель напълно се различава от ActiveMQ, където съобщенията от всички опашки се съхраняват в един журнал, а брокерът маркира съобщенията като изтрити, след като те са били прочетени.
Нека сега се задълбочим и разгледаме журнала на темата по-подробно.
Журналът на Kafka се състои от няколко партиции (). Kafka гарантира стриктна последователност в всяка партиция. Това означава, че съобщенията, записани в партицията в определен ред, ще бъдат прочетени в същия ред. Всяка партиция е реализирана под формата на цикличен (rolling) файл на журнала, който съдържа подмножество (subset) от всички съобщения, изпратени в темата от нейните продюсери. По подразбиране създадената тема съдържа една партиция. Идеята за партиции е централна идея на Kafka за хоризонтално мащабиране.
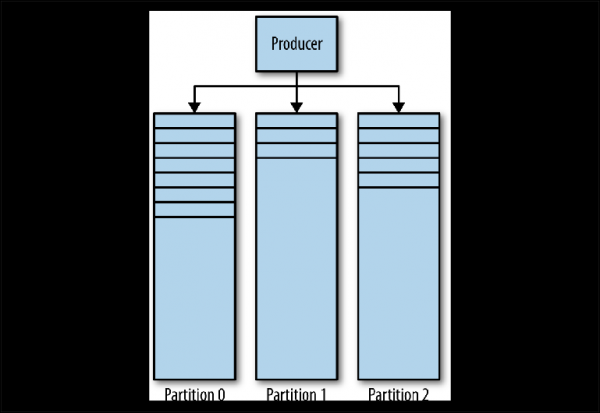
Фигура 3-1. Партиции на Kafka
Когато продюсерът изпраща съобщение в темата на Kafka, той решава в коя партиция да изпрати съобщението. Ще разгледаме това по-подробно по-късно.
Четене на съобщения
Клиент, който иска да прочете съобщения, управлява именуван указател, наречен група консуматори (consumer group), който указва на сместяване (offset) на съобщението в партицията. Сместяването е позиция с нарастващ номер, която започва от 0 в началото на партицията. Тази група консуматори, на която се позовават в API чрез определяемия от потребителя идентификатор group_id, отговаря на един логически потребител или система.
Повечето системи, които използват съобщения, четат данни от подателя чрез няколко инстанции и потоци за паралелна обработка на съобщения. Така че обикновено ще има много инстанции на консумерите, които споделят една и съща група консумери.
Проблемът с четенето може да се представи по следния начин:
- Темата има няколко партиции
- Няколко групи консумери могат да използват темата едновременно
- Групата консумери може да има няколко отделни инстанции
Това е нетривиален проблема "много към много". За да разберем как Kafka се справя с отношенията между групите консумери, инстанциите на консумерите и партициите, нека разгледаме редица progressively усложняващи се сценарии на четене.
Консумери и групи консумери
Нека вземем за отправна точка тема с една партиция ().
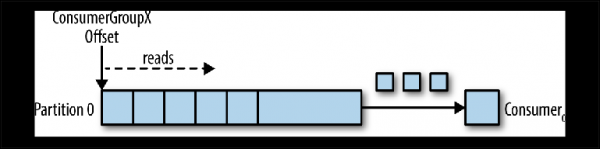
Figure 3-2. Консумер чете от партицията
Когато инстанцията на консумера се свързва с собствен group_id към тази тема, й е назначена партиция за четене и офсет в тази партиция. Позицията на този офсет се конфигурира от клиента като указател на най-новата позиция (най-новото съобщение) или на най-старата позиция (най-старото съобщение). Консумерът запитва (polls) съобщения от темата, което води до последователно четене от журнала.
Позицията на офсета редовно се комитва обратно в Kafka и се запазва като съобщения в вътрешната тема _consumer_offsets. Прочетените съобщения все пак не се изтриват, за разлика от обикновения брокер, и клиентът може да върне (rewind) офсета, за да обработи отново вече прегледаните съобщения.
Когато се свърже втори логически консумер, използвайки друг group_id, той управлява втори указател, който не зависи от първия (). Така темата на Kafka действа като опашка, в която съществува един консумер, и като обикновена тема на издател-подписчик (pub-sub), на която са подписани няколко консумера, с допълнителното предимство, че всички съобщения се запазват и могат да бъдат обработвани многократно.
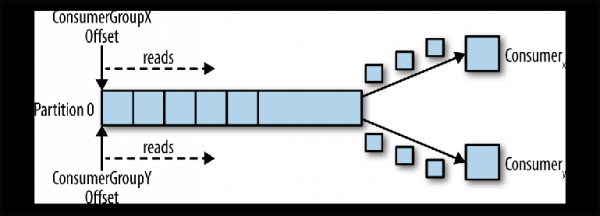
Figure 3-3. Два консумера в различни групи консумери четат от една партиция
Консумерите в групата консумери
Когато един екземпляр на консумира прочита данни от партиция, той напълно контролира указателя и обработва съобщения, какъвто е описано в предишната секция.
Ако няколко екземпляра на консюмери са свързани със същия group_id към темата с една партиция, то на екземпляра, който се свърже последен, ще бъде предаден контрол над указателя и от този момент нататък той ще получава всички съобщения ().
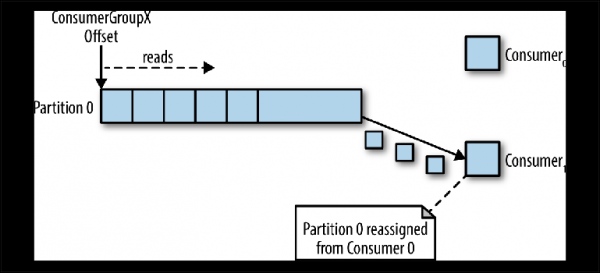
Фигура 3-4. Два консюмера в една и съща група консумери четат от една партиция
Този режим на обработка, при който броят на екземплярите на консумери надвишава броя на партициите, може да бъде разгледан като вид монополен потребител. Това може да бъде полезно, ако имате нужда от 'активно-пасивна' (или 'гореща-топла') кластеризация на вашите екземпляри на консумери, въпреки че паралелната работа на няколко консюмера ('активно-активна' или 'гореща-гореща') е значително по-типична, отколкото консумерите в режим на изчакване.
Такова поведение на разпределение на съобщенията, описано по-горе, може да предизвика изненада в сравнение с това, как се държи обикновената опашка JMS. В този модел съобщенията, изпратени в опашката, ще бъдат разпределени равномерно между двама консумери.
Най-често, когато създаваме няколко екземпляра на консумери, правим това или за паралелна обработка на съобщения, или за увеличаване на скоростта на четене, или за повишаване на устойчивостта на процеса на четене. Тъй като само един екземпляр на консумира може да чете данни от партиция едновременно, как се постига това в Kafka?
Един от начините да се направи това е да се използва един екземпляр на консумира, за да прочете всички съобщения и да ги предаде в пул от нишки. Въпреки че този подход увеличава пропускателната способност на обработката, той увеличава сложността на логиката на консумерите и не прави нищо за повишаване на устойчивостта на системата за четене. Ако един екземпляр на консумира се изключи поради прекъсване на захранването или подобно събитие, то четенето спира.
Каноничният начин за решаване на този проблем в Kafka е да се използва по-Оголямо количество партиции.
Партициониране
Партициите са основният механизъм за паралелно четене и мащабиране на темата извън капацитета на един брокер. За да разберем това по-добре, нека разгледаме ситуация, при която има тема с две партиции и към тази тема е абониран един консумер ().
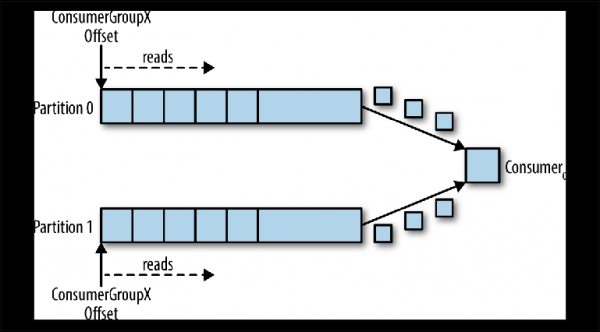
Фигура 3-5. Един консумер чете от няколко партиции
В този сценарий на консумера се дава контрол над указателите, които съответстват на неговия group_id в двете партиции, и започва да чете съобщения от двете партиции.
Когато към тази тема бъде добавен допълнителен консумер за същия group_id, Kafka преназначава (reallocate) една от партициите от първия на втория консумер. След това всеки екземпляр на консумера ще чете от една партиция на темата ().
За да осигурите паралелна обработка на съобщенията в 20 потока, ще ви трябват поне 20 партиции. Ако партициите са по-малко, ще имате консумери, които нямат с какво да работят, което беше описано по-рано в дискусията за монополните консумери.
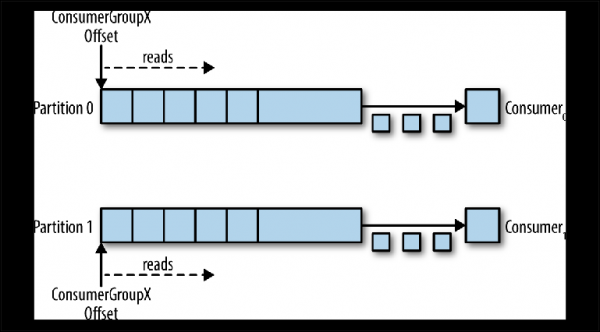
Фигура 3-6. Два консумера в една и съща група консумери четат от различни партиции
Тази схема значително намалява сложността на работата на брокера Kafka в сравнение с разпределението на съобщенията, необходимо за поддръжката на JMS опашка. Тук не е необходимо да се притеснявате за следните моменти:
- Кой консумер трябва да получи следващото съобщение, базирано на циклично (round-robin) разпределение, текущия капацитет на буферите за предварително извличане или предишните съобщения (както за групи съобщения JMS).
- Кои съобщения са изпратени на кои консумери и трябва ли да бъдат доставени повторно при отказ.
Всичко, което брокерът Kafka трябва да направи, е последователно да предава съобщения на консумера, когато последният ги поиска.
Обаче, изискванията за паралелно четене и повторно изпращане на неуспешни съобщения не изчезват — отговорността за тях просто преминава от брокера към клиента. Това означава, че те трябва да бъдат взети предвид в вашия код.
Изпращане на съобщения
Отговорността за решението в коя партиция да се изпрати съобщението е възложена на продюсера на това съобщение. За да разберете механизма, с който това се извършва, първо трябва да разгледате какво точно наистина изпращаме.
Докато в JMS използваме структура на съобщението с метаданни (заглавия и свойства) и тяло, съдържащо полезно натоварване (payload), в Kafka съобщението е пара "ключ-стойност". Полезното натоварване на съобщението се изпраща като стойност (value). Ключът, от своя страна, се използва основно за партициониране и трябва да съдържа ключ, специфичен за бизнес логиката, за да постави свързаните съобщения в същата партиция.
В Глава 2 обсъдихме сценария за онлайн залагания, когато свързаните събития трябва да се обработват по ред от един консуматор:
- Потребителският акаунт е настроен.
- Парите се кредитират в сметката.
- Прави се залог, който изтегля средства от сметката.
Ако всяко събитие представлява съобщение, изпратено в темата, то в този случай естественият ключ ще бъде идентификаторът на акаунта.
Когато съобщението се изпраща с помощта на Kafka Producer API, то се предава на функцията за партициониране, която, като вземе предвид съобщението и текущото състояние на кластерa Kafka, връща идентификатора на партицията, в която трябва да бъде изпратено съобщението. Тази функция е реализирана в Java чрез интерфейса Partitioner.
Този интерфейс изглежда по следния начин:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Реализацията на Partitioner за определяне на партицията използва по подразбиране алгоритъм за хеширане на ключа (general-purpose hashing algorithm over the key) или цикличен преразпределяне (round-robin), ако ключът не е указан. Това подразбирано значение работи добре в повечето случаи. Въпреки това в бъдеще може да искате да напишете собствен.
Написване на собствена стратегия за партициониране
Нека разгледаме пример, когато искате да изпратите метаданни заедно с полезното натоварване на съобщението. Полезното натоварване в нашия пример е инструкция за внесене на депозит в игралната сметка. Инструкцията е нещо, което искаме да гарантираме, че няма да бъде модифицирано при предаване и искаме да сме сигурни, че само доверената надстройка може да инициира тази инструкция. В този случай изпращащата и получаващата системи се споразумяват за използването на подпис за проверка на автентичността на съобщението.
В обикновен JMS просто определяме свойството „подпис на съобщението“ и го добавяме към съобщението. Все пак, Kafka не ни предоставя механизъм за предаване на метаданни — само ключ и стойност.
Тъй като стойността е полезният товар на банковия превод, чиято целостност искаме да запазим, нямаме друг избор, освен да определим структура на данните за използване в ключа. Предполагайки, че ни е нужен идентификатор на сметката за партициониране, тъй като всички съобщения, свързани със сметката, трябва да се обработват по ред, ще измислим следната структура на JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Тъй като стойността на подписа ще варира в зависимост от полезния товар, стандартната стратегия за хеширане на интерфейса Partitioner няма да групира свързаните съобщения надеждно. Затова ще трябва да напишем собствена стратегия, която да анализира този ключ и да разбива (partition) стойността на accountId.
Kafka включва контроли за сумираност за откриване на повреди в съобщенията в хранилището и разполага с пълен набор от функции за сигурност. Дори и в този случай понякога възникват специфични за индустрията изисквания, като посоченото по-горе.
Потребителската стратегия за партициониране трябва да гарантира, че всички свързани съобщения ще се окажат в една партиция. Въпреки че това изглежда просто, изискването може да бъде усложнено поради важността на поддържането на реда на свързаните съобщения и колко фиксировано е количеството партиции в темата.
Броят на партициите в темата може да се променя с времето, тъй като могат да се добавят, ако трафикът надвишава първоначалните очаквания. Така че, ключовете на съобщенията могат да бъдат свързани с партицията, в която първоначално са били изпратени, подразбирайки част от състоянието, което трябва да бъде разпределено между инстанциите на производителя.
Друг фактор, който трябва да се вземе предвид, е равномерността на разпределението на съобщенията между партициите. Обикновено, ключовете не се разпределят равномерно по съобщенията и хеш-функциите не гарантират справедливо разпределение на съобщенията за малък набор от ключове.
Важно е да се отбележи, че независимо от начина, по който решите да разделите съобщенията, съответният разделител може да се наложи да се използва повторно.
Нека разгледаме изискването за репликация на данни между Kafka клъстери в различни географски локации. За тази цел Kafka предлага инструмент за команден ред, наречен MirrorMaker, който се използва за четене на съобщения от един клъстер и предаване на съобщенията в друг.
MirrorMaker трябва да разбира ключовете на репликирания топик, за да поддържа относителния ред между съобщенията при репликация между клъстери, тъй като броят на партициите за този топик може да не съвпада в двата клъстера.
Потребителските стратегии за партициониране са относително редки, тъй като стандартните хеширане или циклично разпределение работят успешно в повечето сценарии. Въпреки това, ако ви трябват строги гаранции за подредба или трябва да извлечете метаданни от полезните натоварвания, партиционирането е нещо, на което трябва да обърнете по-подробно внимание.
Предимствата на мащабируемостта и производителността на Kafka произтичат от прехвърлянето на част от задълженията на традиционния брокер на клиента. В този случай се взема решение за разпределяне на потенциално свързани съобщения между няколко консума, които работят паралелно.
JMS брокерите също трябва да се справят с подобни изисквания. Интересно е, че механизмът за изпращане на свързани съобщения на един и същи консумер, реализиран чрез JMS Message Groups (вид стратегия за баланс на натоварването - sticky load balancing (SLB)), също изисква изпращачът да маркира съобщенията като свързани. В случая на JMS, брокерът е отговорен за изпращането на тази група свързани съобщения на един консумер от много и предаване на правото на собственост върху групата, ако консумерът се провали.
Споразумения относно продуцента
Партиционирането не е единственото, което трябва да се има предвид при изпращане на съобщения. Нека разгледаме методите send() на класа Producer в Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Важно отметить, че и двата метода връщат Future, което показва, че операцията по изпращане не се изпълнява веднага. В резултат на това, съобщението (ProducerRecord) се записва в буфера за изпращане за всяка активна партиция и се прехвърля към брокера във фонов режим чрез библиотеки на клиента Kafka. Въпреки че това прави работата изключително бърза, това означава, че неопитно написаното приложение може да загуби съобщения, ако неговият процес бъде спрян.
Както винаги, има начин да се направи операцията по изпращане по-надеждна за сметка на производителността. Размерът на този буфер може да бъде зададен на 0, и потокът на изпращащото приложение ще бъде принуден да изчака, докато предаването на съобщението към брокера не бъде завършено, по следния начин:
RecordMetadata metadata = producer.send(record).get();Отново за четенето на съобщения
Четенето на съобщения има допълнителни сложности, които е необходимо да се обсъждат. В отличие от API JMS, който може да стартира слушател на съобщения (message listener) в отговор на пристигането на съобщение, интерфейсът Consumer Kafka просто опрашва (polling). Нека да разгледаме по-подробно метода poll (), използван за тази цел:
ConsumerRecords poll(long timeout);Върнатото значение на метода е контейнерна структура, съдържаща няколко обекта ConsumerRecord от потенциално няколко партиции. ConsumerRecord Той самият е обект-държач за двойка ключ-стойност с относимите метаданни, като партицията, от която е получен.
Както беше обсъдено в Глава 2, трябва постоянно да помним какво се случва с съобщенията след успешна или неуспешна обработка, например, ако клиентът не може да обработи съобщението или ако спре работа. В JMS това беше обработвано чрез режим на потвърждение (acknowledgement mode). Брокерът или ще премахне успешно обработеното съобщение, или ще повторно достави необработеното или неуспешно (при условие че са били използвани транзакции).
Kafka работи съвсем по различен начин. Съобщенията не се премахват в брокера след четене и отговорността за това, какво се случва при провал, лежи върху самия четец на кода.
Както вече споменахме, групата консумери е свързана с offset в журнала. Позицията в журнала, свързана с този offset, съответства на следващото съобщение, което ще бъде издадено в отговор на poll ()Времевият момент, когато това изместване се увеличава, е решаващ за четенето.
Връщайки се към модела на четене, разгледан по-рано, обработката на съобщението се състои от три етапа:
- Извлечете съобщението за четене.
- Обработете съобщението.
- Потвърдете съобщението.
Kafka консуматорът идва с опцията за конфигурация enable.auto.commit. Това е често използвана настройка по подразбиране, както обикновено е при настройките, съдържащи термин 'авто'.
Преди Kafka 0.10 клиент, който използваше този параметър, изпращаше изместването на последното прочетено съобщение при следващото извикване poll () след обработката. Т това означаваше, че всяко вече извлечено (fetched) съобщение можеше да бъде обработено отново, ако клиентът вече го е обработил, но е бил неочаквано унищожен преди извикването. poll ()Тъй като брокерът не запазваше никакво състояние относно това, колко пъти е прочетено съобщението, следващият консуматор, който извлича това съобщение, нямаше да знае, че е станало нещо лошо. Това поведение беше псевдо-транзакционно. Изместването се комитваше само в случай на успешна обработка на съобщението, но ако клиентът спираше работа, брокерът отново изпращаше същото съобщение на друг клиент. Такова поведение съответстваше на гаранцията за доставка на съобщения 'поне веднъж«.
В Kafka 0.10 кодът на клиента беше променен по такъв начин, че комитът започна да се стартира периодично от библиотеката на клиента, в съответствие с настройката auto.commit.interval.ms. Това поведение е някъде между режимите JMS AUTO_ACKNOWLEDGE и DUPS_OK_ACKNOWLEDGE. При използване на автокомит съобщенията можеха да бъдат потвърдени независимо от това, дали бяха реално обработени - това можеше да се случи, когато консуматорът е бавен. Ако консуматорът спираше работа, съобщенията бяха извлечени от следващия консуматор, започвайки от комитираната позиция, което можеше да доведе до пропуск на съобщение. В този случай Kafka не губеше съобщения, четящият код просто не ги обработваше.
Този режим има същите перспективи, както в версия 0.9: съобщенията могат да бъдат обработени, но в случай на срив, изместването може да не е комитнато, което потенциално може да доведе до дублиране на доставката. Колкото повече съобщения извличате при изпълнение poll (), толкова по-голям е този проблем.
Както бе обсъдено в раздела „Четене на съобщения от опашката“ на стр. 21, в системата за обмен на съобщения няма концепция за доставка на съобщение „веднъж“, когато се вземат предвид режимите на сбой.
В Kafka има два начина за фиксиране (комит на) офсета: автоматично и ръчно. В двата случая съобщенията могат да бъдат обработвани няколко пъти, ако съобщението е било обработено, но е настъпил сбой преди комита. Можете също така да не обработите съобщението вообще, ако комитът е бил извършен във фона, а вашият код е завършил, преди да започне обработката (възможно за Kafka 0.9 и по-ранни версии).
Процесът на комитване на офсета ръчно може да се управлява в API на потребителя на Kafka, като се зададе параметъра enable.auto.commit на стойност false и изрично се извика един от следните методи:
void commitSync();
void commitAsync();
Ако целите да обработите съобщение „поне един път“, трябва да комитнете офсета ръчно с помощта на commitSync (), изпълнявайки тази команда веднага след обработката на съобщенията.
Тези методи не позволяват потвърждаването (acknowledged) на съобщения, преди да бъдат обработени, но не правят нищо, за да предотвратят потенциалното дублиране на обработката, създавайки същевременно видимост на транзакционността. В Kafka транзакции не присъстват. Клиентът няма възможност да направи следното:
- Автоматично да върне (rollback) провалено съобщение. Потребителите сами трябва да обработват изключенията, възникващи от проблемни полезни натоварвания и прекъсвания на бекенда, тъй като не могат да разчитат на повторна доставка на съобщения от брокера.
- Да изпрати съобщения в няколко теми в рамките на една атомарна операция. Както скоро ще видим, контролът върху различни теми и партиции може да бъде разпределен на различни машини в клъстер Kafka, които не координират транзакции при изпращане. Към момента на написването на тази статия е направена определена работа, за да се направи това възможно с помощта на KIP-98.
- Да свърже четенето на едно съобщение от една тема с изпращането на друго съобщение в друга тема. Отново, архитектурата на Kafka зависи от множество независими машини, работещи като една шина, и не се правят опити да се прикрие това. Например, не съществуват компоненти на API, които да позволяват свързването на Потребител и Продюсер в транзакцията. В JMS това се осигурява от обект Session, от който се създават MessageProducers и MessageConsumers.
Ако не можем да разчитаме на транзакции, как можем да осигурим семантиката, близка до тази, предоставяна от традиционните системи за обмен на съобщения?
Ако съществува вероятност консумерът да увеличи офсета преди обработката на съобщението, например по време на срив на консумера, то консумерът няма начин да разбере дали неговата група консумери е пропуснала съобщения, когато ѝ бъде назначена партиция. Следователно, една от стратегиите е да се върне (rewind) офсетът на предишната позиция. API-то на Kafka консумера предоставя следните методи за това:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Методът seek () може да се използва с метода
offsetsForTimes (Map timestampsToSearch) за да се върне в състояние в определен момент от миналото.
Косвено, използването на този подход означава, че е много вероятно някои съобщения, които са били обработени по-рано, да бъдат прочетени и обработени отново. За да избегнем това, можем да използваме идемпотентно четене, както е описано в Глава 4, за проследяване на вече прегледаните съобщения и изключване на дубликати.
Като алтернатива, кодът на вашия консумер може да бъде прост, ако загубата или дублирането на съобщения е приемливо. Когато разглеждаме сценарии на употреба, за които обикновено се използва Kafka, например, обработка на журнални събития, метрики, проследяване на кликвания и т.н., разбираме, че загубата на отделни съобщения едва ли ще окаже значително влияние върху околните приложения. В такива случаи стойностите по подразбиране са напълно приемливи. От друга страна, ако вашето приложение трябва да предава плащания, трябва да внимавате за всяко отделно съобщение. Всичко зависи от контекста.
Личните наблюдения показват, че с нарастващата интензивност на съобщенията стойността на всяко отделно съобщение намалява. Съобщения с голям обем обикновено стават ценни, ако се разглеждат в агрегирана форма.
Висока наличност (High Availability)
Подходът на Kafka към високата наличност се различава съществено от подхода на ActiveMQ. Kafka е проектирана на базата на хоризонтално мащабируеми клъстери, в които всички инстанции на брокера приемат и разпространяват съобщения едновременно.
Клъстерът на Kafka се състои от няколко инстанции на брокера, работещи на различни сървъри. Kafka е разработена да работи на обичайно автономно оборудване, където всеки възел има свое собствено отделно хранилище. Използването на мрежови хранилища (SAN) не се препоръчва, тъй като множество изчислителни възли могат да се конкурират за времеви интервали на хранилището и да създадат конфликти.иконфликти.
Kafka е постоянно активна система. Много от големите потребители на Kafka никога не изключват своите клъстери, а софтуерът винаги осигурява обновление чрез последователно рестартиране. Това се постига чрез гарантиране на съвместимост с предишната версия за съобщения и взаимодействия между брокерите.
Брокерите са свързани с клъстера от сървъри , който действа като регистър на конфигурационни данни и се използва за координиране на ролите на всеки брокер. ZooKeeper сам е разпределена система, която осигурява висока наличност чрез репликация на информацията, като установява кворум..
В основния случай, топикът се създава в клъстера на Kafka с следните свойства:
- Брой партиции. Както беше обсъдено по-рано, точното значение, използвано тук, зависи от желания ниво на паралелно четене.
- Коефициентът (факторът) на репликация определя колко инстанции на брокера в клъстера трябва да съдържат журнали за тази партиция.
Използвайки ZooKeeper за координация, Kafka се опитва справедливо да разпредели нови партиции между брокерите в клъстера. Това се прави от една инстанция, която изпълнява ролята на Контролер.
В рантайма за всяка партиция на топика Контролер назначава брокера в ролята на лидер (leader, master, водещ) последователи (последователи, рабы, подчинени). Брокер, който действува като лидер за тази партиция, отговаря за приемането на всички съобщения, изпратени му от продуцентите, и разпространението на съобщенията към консуматорите. Когато изпращат съобщения към партицията на темата, те се репликират на всички възли на брокера, които действат като последователи за тази партиция. Всеки възел, съдържащ журнали за партицията, се нарича реплика. Брокерът може да действа като лидер за едни партиции и като последовател за други.
Последователят, съдържащ всички съобщения, съхранявани при лидера, се нарича синхронизирана реплика (реплика, която е в синхронизирано състояние, in-sync replica). Ако брокерът, който действа като лидер за партицията, се изключи, всеки брокер, който е актуализиран или синхронизиран за тази партиция, може да поеме ролята на лидер. Това е невероятно устойчива структура.
Част от конфигурацията на продуцента е параметърът acks, който определя колко реплики трябва да потвърдят получаването на съобщението, преди приложението да продължи с изпращането: 0, 1 или всички. Ако е зададено стойност all, тогава, при получаване на съобщението, лидерът ще изпрати потвърждение (confirmation) обратно на продуцента, веднага щом получи потвърждения (acknowledgements) за записа от няколко реплики (включително самия себе си), определени от настройките на темата min.insync.replicas (по подразбиране 1). Ако съобщението не може да бъде успешно репликирано, продуцентът ще предизвика изключение за приложението (NotEnoughReplicas или NotEnoughReplicasAfterAppend).
В типичната конфигурация се създава тема с коефициент на репликация 3 (1 лидер, 2 последователи за всяка партиция) и параметърът min.insync.replicas е зададен на 2. В този случай клъстерът ще допуска единият от брокерите, управляващи партицията на темата, да се изключи без влияние върху клиентските приложения.
Това ни води обратно към вече познатия компромис между производителност и надеждност. Репликацията изисква допълнително време за изчакване на потвърдения (acknowledgments) от последователите. Въпреки това, тъй като тя се извършва паралелно, репликацията на поне три възли има същата производителност, като на два (игнорирайки увеличеното използване на пропускателната способност на мрежата).
С използването на тази репликационна схема, Kafka ловко избягва необходимостта да осигури физическо записване на всяко съобщение на диск чрез операция sync (). Всяко съобщение, изпратено от производителя, ще бъде записано в журнала на партицията, но, както бе обсъдено в Глава 2, записването във файла първоначално се извършва в буфера на операционната система. Ако това съобщение е репликирано на друг екземпляр на Kafka и се намира в неговата памет, загубата на лидера не означава, че самото съобщение е загубено — то може да бъде поето от синхронизирана реплика.
Отказът от необходимостта да се извършва операция sync () означава, че Kafka може да приема съобщения с скорост, с която може да ги записва в паметта. И обратно, колкото по-дълго може да се избегне триенето (flushing) на паметта на диска, толкова по-добре. Поради тази причина не е необичайно брокерите на Kafka да имат назначени 64 Гб памет или повече. Този обем памет означава, че един екземпляр на Kafka може лесно да работи с скорости много хиляди пъти по-бързо от традиционния брокер на съобщения.
Kafka може да бъде конфигуриран да прилага операция sync () к групи от съобщения. Тъй като всичко в Kafka е насочено към работа с групи, това наистина работи доста добре за много сценарии на приложение и е полезен инструмент за потребители, които изискват много силни гаранции. Повечето от чистата производителност на Kafka е свързана със съобщенията, които се изпращат на брокера под формата на пакети, и с факта, че тези съобщения се четат от брокера последователно на блокове чрез операции (операции, при които не се извършва копиране на данни от една област на паметта в друга). Последното е голямо предимство от гледна точка на производителността и ресурсите и е възможно само благодарение на използването на underlying структура на данни на журнала, която определя схемата на партицията.
В клъстера на Kafka е възможна значително по-висока производителност, отколкото при използването на един единствен брокер на Kafka, тъй като партициите на темата могат да се хоризонтално мащабират на множество отделни машини.
Итог
В тази глава разгледахме как архитектурата на Kafka преосмисля отношенията между клиентите и брокерите, за да осигури невероятно устойчив канал за обмен на съобщения с пропускна способност, много по-голяма от тази на обикновения брокер за съобщения. Обсъдихме функционалността, която използва за постигане на тази цел, и накратко разгледахме архитектурата на приложенията, които осигуряват тази функционалност. В следващата глава ще разгледаме общите проблеми, които трябва да решават приложенията за обмен на съобщения, и ще обсъдим стратегии за тяхното решаване. Ще завършим главата, описвайки как да разсъждаваме за технологиите за обмен на съобщения като цяло, за да можете да оцените тяхната пригодност за вашите сценарии на използване.
Предишната преведена част:
Преводът е завършен:
Продължение следва…
Само регистрирани потребители могат да участват в анкетата. , моля.
Използва ли се Kafka във вашата организация?
Да
Не
Използваше се, сега не
Планираме да използваме
Гласуваха 38 потребители. Въздържаха се 8 потребители.
Източник: habr.com
