

Здравейте, читатели на Хабра. С тази статия започваме цикъл, който ще разкаже за разработената от нас хиперконвергентна система AERODISK vAIR. Първоначално искахме с първата статия да разкажем всичко за всичко, но системата е доста сложна, затова ще я разглеждаме на части.
Нека започнем с историята на създаването на системата, ще се задълбочим във файловата система ARDFS, която е основата на vAIR, а също така ще направим и малко разсъждения относно позиционирането на това решение на руския пазар.
В следващите статии ще разкажем по-подробно за различните архитектурни компоненти (кластер, хипервизор, балансировчик на натоварването, система за мониторинг и т.н.), процеса на настройка, ще разгледаме въпросите за лицензиране, отделно ще покажем краш-тестове и, разбира се, ще напишем за натоварвателни тестове и размериране. Също така, отделна статия ще посветим на обществената версия на vAIR.
Аеродиск — това ли е история за СХД? Или защо изобщо започнахме да се занимаваме с хиперконвергентни решения?
Първоначалната идея да създадем своя хиперконвергентна система ни дойде около 2010 г. Тогава все още нямаше нито Аеродиск, нито подобни решения (комерсиални кутии с хиперконвергентни системи) на пазара. Задачата ни беше следната: от набор от сървъри с локални дискове, свързани чрез интерконект по протокол Ethernet, трябваше да създадем разширено хранилище и там да стартираме виртуални машини и софтуерна мрежа. Всичко това трябваше да се реализира без СХД (тъй като нямаше средства за СХД и нейните компоненти, а собствена СХД все още не бяхме измислили).
Изпробвахме много решения с отворен код и все пак успяхме да решим тази задача, но решението беше много сложно и трудно за повторение. Освен това, това решение беше от сорта на „Работи? Не пипай!“. Следователно, след решаването на задачата, не продължихме да развиваме идеята за превръщане на резултата от работата ни в пълноценен продукт.
След този случай се отказахме от тази идея, но усещането, че задачата е напълно решима, а ползата от такова решение е очевидна, така и не ни напусна. По-късно излезлите HCI-продукти на чуждестранни компании само потвърдиха това усещане.
Затова в средата на 2016 година се завърнахме към тази задача в рамките на създаването на пълноценен продукт. Тогава нямахме никакви отношения с инвеститори, поради което стои разработки трябваше да бъде закупен с нашите не толкова големи средства. Набрахме от Авито употребявани сървъри и комутатори и започнахме работа.
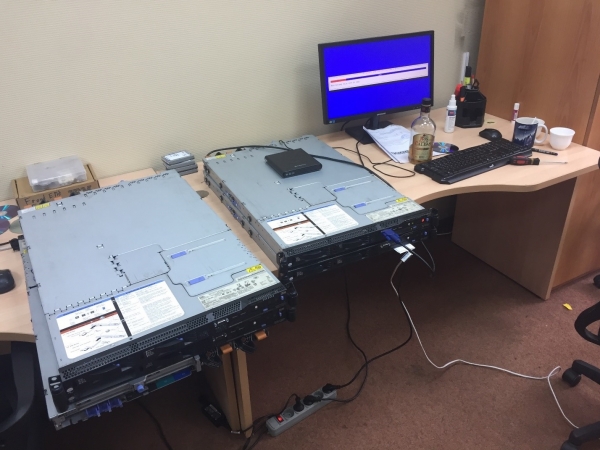
Основната начална задача беше създаването на собствена, макар и проста, файлова система, която да може автоматично и равномерно да разпределя данни под формата на виртуални блокове на n брой възли в клъстера, свързани с интерконект по Ethernet. При това файлова система трябваше да бъде добре и лесно мащабируема и независима от съседни системи, т.е. да бъде отделима от vAIR под формата на "просто хранилище".
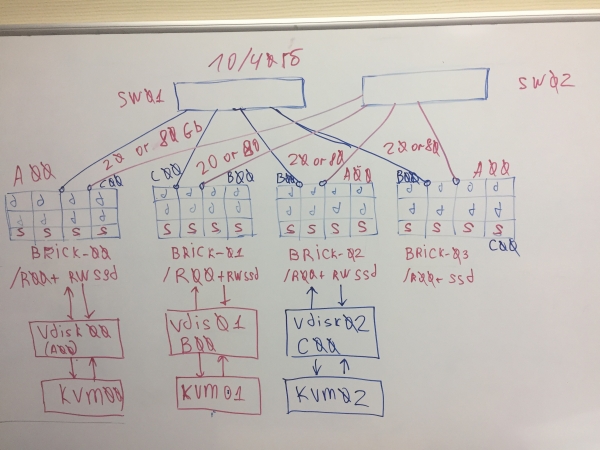
Първа концепция vAIR
Ние умишлено се отказахме от използването на готови open source решения за организация на разпределено хранилище (ceph, gluster, lustre и подобни) в полза на собствена разработка, тъй като вече имахме много проектен опит с тях. Без съмнение, самите тези решения са отлични, и преди работа над Аэродиском реализирахме не един интеграционен проект с тях. Но едно е да се реализира конкретна задача на един клиент, да се обучи персонал и, възможно, да се закупи поддръжка от голям вендор, а съвсем друго е да се създаде лесно тиражируем продукт, който да бъде използван за различни задачи, за които ние, като вендор, може би дори не знаем. За втората цел съществуващите open source продукти не подходяха, затова решихме да развием разпределена файлова система сами.
След две години усилията на няколко разработчици (които съчетаваха работата по vAIR с работата по класическа СХД Engine) постигнаха определен резултат.
До 2018 година написахме най-простата файлова система и я допълнихме с необходимата обвивка. Системата обединяваше физически (локални) дискове от различни сървъри по вътрешен интерконект в един плосък пул и "разрязваше" тях на виртуални блокове, след което от виртуалните блокове се създаваха блочни устройства с определено ниво на отказоустойчивост, на които с помощта на хипервизор KVM се създаваха и изпълняваха виртуални машини.
Не се натоварвахме с името на файловата система и я нарекохме ARDFS (отгатнете какво означава))
Този прототип изглеждаше добре (не визуално, разбира се, визуалното оформление още не беше готово) и показваше добри резултати по производителност и мащабируемост. След първия реален резултат стартирахме проекта, организирайки полноценна среда за разработка и отделен екип, който се занимаваше само с vAIR.
Точно тогава се оформи общата архитектура на решението, която досега не е претърпяла сериозни промени.
Потапяме се в файловата система ARDFS
ARDFS е основата на vAIR, която осигурява разпределено отказоустойчиво съхранение на данни за целия клъстер. Една от (но не единствена) отличителна черта на ARDFS е, че не използва никакви допълнителни изолирани сървъри подмети и управление. Така беше замислено от самото начало за опростяване на конфигурацията на решението и за неговата надеждност.
Структура на съхранение
В рамките на всички възли на клъстера ARDFS организира логически пул от цялото налично дисково пространство. Важно е да се разбере, че пулът – това не са данни и не е форматирано пространство, а просто оформление, т.е. всеки възел с инсталиран vAIR при добавяне към клъстера автоматично се добавя в общия пул ARDFS и дисковите ресурси автоматично стават общи за целия клъстер (и достъпни за бъдещо съхранение на данни). Този подход позволява на летището да се добавят и премахват възли без никакво сериозно влияние върху вече работещата система. Т.е. системата много лесно се мащабира с „кирпичи“, добавяйки или премахвайки възли в клъстера при необходимост.
Върху пула ARDFS се добавят виртуални дискове (обекти за съхранение на виртуалки), изградени от виртуални блокове с размер 4 мегабайта. На виртуалните дискове директно се съхраняват данните. На ниво виртуални дискове също така се задава схема за отказоустойчивост.
Както може да се досетите, за отказоустойчивост на дисковата подсистема не използваме концепцията RAID (Редундантен масив от независими дискове), а използваме RAIN (Редундантен масив от независими възли). Т.е. отказоустойчивостта се измерва, автоматизира и управлява въз основа на възлите, а не на дисковете. Дисковете, безусловно, също са обект на съхранение, те, както и всичко останало, се наблюдават, можем да извършваме всички стандартни операции с тях, включително да изграждаме локален хардуерен RAID, но клъстерът оперира именно с възлите.
В ситуация, в която много искате RAID (например сценарий, поддържащ множество откази на малки клъстери), нищо не пречи да използвате локални RAID контролери, а отгоре да направите разширено хранилище и RAIN архитектура. Този сценарий е напълно реалистичен и ние го поддържаме, затова ще говорим за него в статията за типични сценарии на приложение на vAIR.
Схеми за отказоустойчивост на хранилище
Схемите за отказоустойчивост на виртуалните дискове в vAIR могат да бъдат две:
1) Фактор на репликация или просто репликация – този метод за отказоустойчивост е прост "като пръчка и въже". Извършва се синхронна репликация между възлите с фактор 2 (2 копия на клъстера) или 3 (3 копия съответно). RF-2 позволява на виртуалния диск да издържи отказ на един възел в клъстера, но "отнема" половината от полезния обем, а RF-3 ще издържи отказ на 2 възли в клъстера, но ще резервира вече 2/3 от полезния обем за свои нужди. Тази схема много прилича на RAID-1, т.е. виртуалният диск, конфигуриран в RF-2, е устойчив на отказ на произволен един възел в клъстера. В този случай с данните всичко ще бъде в ред и дори ввод-изводът няма да спре. Когато падналият възел се възстанови, ще започне автоматично възстановяване/синхронизация на данните.
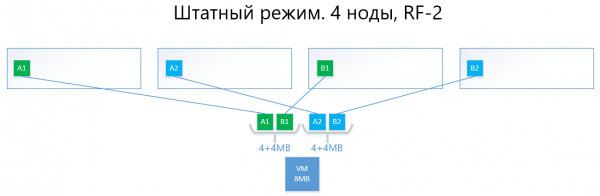
По-долу са представени примери за разпределение на данните RF-2 и RF-3 в нормален режим и в ситуации на откази.
Имаме виртуална машина с обем от 8MB уникални (полезни) данни, която работи на 4 нода vAIR. Ясно е, че в действителност едва ли ще бъде такъв малък обем, но за схема, отразяваща логиката на работа на ARDFS, този пример е най-подходящ. AB – това са виртуални блокове по 4MB, съдържащи уникални данни на виртуалната машина. При RF-2 се създават две копия на тези блокове A1+A2 и B1+B2, съответно. Тези блокове се "разполагат" по нодите, избягвайки пресичането на едни и същи данни на един нод, т.е. копията А1 няма да бъде на един нод с копията A2. С B1 и B2 е аналогично.
В случай на отказ на един от нодовете (например, ноб №3, където се съдържа копия B1), това копие автоматично се активира на нод, където няма копия на неговата копия (т.е. копия B2).
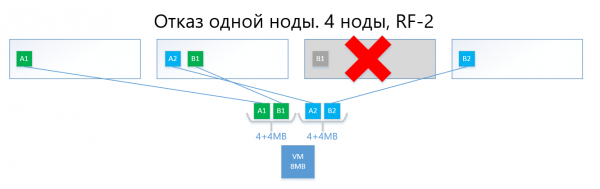
По този начин виртуалният диск (и ВМ, съответно) лесно ще преживеят отказ на един нод в схемата RF-2.
Схемата с репликация, при цялата си простота и надеждност, боледува от същия проблем, който и RAID1 – малко полезно пространство.
2) Erasure coding или изтриващо кодиране (също известно като „излишно кодиране“, „изтриващо кодиране“ или „код на излишъка“) съществува за решаване на горния проблем. EC – схема на излишъка, която осигурява висока наличност на данните при по-ниски разходи за дисково пространство в сравнение с репликацията. Принципът на работа на този механизъм е подобен на RAID 5, 6, 6P.
При кодиране, процесът EC разделя виртуалния блок (по подразбиране 4MB) на няколко по-малки „парчета данни“ в зависимост от схемата EC (например, схемата 2+1 разделя всеки блок от 4MB на 2 парчета по 2MB). След това този процес генерира за „парчетата данни“ „парчета паритет“ с размер не по-голям от една от преди разделените части. При декодиране, EC генерира недостигналите парчета, прочитайки „оцелелите“ данни в целия кластер.
Например, виртуалният диск с EC-схема 2 + 1, реализиран на 4 нода на клъстера, спокойно ще издържи отказ на един нод в клъстера, както и RF-2. При това разходите ще бъдат по-ниски, в частност коефициентът на полезна вместимост при RF-2 е 2, а при EC 2+1 той ще бъде 1,5.
Ако опишем по-просто, същността е, че виртуалният блок се разделя на 2-8 (защо от 2 до 8 вижте долу) „парчета“, а за тези парчета се изчисляват „парчета“ паритет на аналогичен обем.
В крайна сметка данните и паритетът се разпределят равномерно по всички възли на клъстера. По същия начин, както при репликацията, ARDFS автоматично разпределя данните по възлите, така че да не се допуска съхраняване на еднакви данни (копия на данни и техния паритет) на един възел, за да се изключи рискът от загуба на данни, ако данните и техният паритет внезапно се окажат на един и същ възел за съхранение, който излезе от строя.
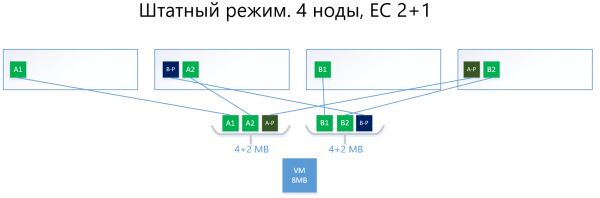
По-долу е пример с една и съща виртуална машина с 8 MB и 4 възла, но при схема EC 2+1.
Блоковете A и B се разделят на два парчета по 2 MB (на две, защото 2+1), тоест на A1+A2 и B1+B2. В противовес на репликата, A1 не е копие на A2, това е виртуален блок A, разделен на две части, както и блок B. В крайна сметка получаваме два комплекта по 4 MB, всеки от които съдържа две парчета от два мегабайта. Следва да се изчисли паритет за всеки от тези комплекти с обем не повече от едно парче (т.е. 2 MB), получаваме допълнително + 2 парчета паритет (A-P и B-P). Така имаме 4×2 данни + 2×2 паритет.
След това парчетата се „разглеждат“ по възлите така, че данните да не се сблъскват с техния паритет. Т.е. A1 и A2 няма да бъдат върху един и същ възел с A-P.
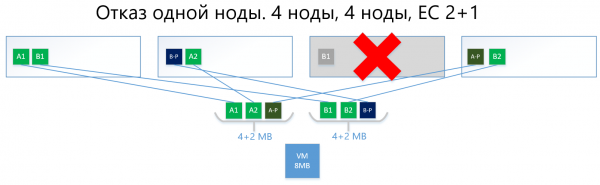
В случай на отказ на един възел (да речем, трети), падналият блок B1 ще бъде автоматично възстановен от паритета B-P, който се съхранява на възел №2, и ще бъде активиран на възел, където няма B-паритет, т.е. парче B-P. В този пример – това е възел №1.
Сигурен съм, че читателят се пита:
„Всичко, което описахте, отдавна е реализирано и от конкурентите, и в решения с отворен код, каква е разликата на вашата реализация на EC в ARDFS?“
А след това следват интересни особености на работата на ARDFS.
Кодиране на изтриване с акцент на гъвкавостта
Първоначално предвидихме доста гъвкава схема EC X+Y, където X е число от 2 до 8, а Y е число от 1 до 8, но винаги по-малко или равно на X. Тази схема е предвиждана за гъвкавост. Увеличаването на броя на данните (X), на които се разделя виртуалният блок, позволява да се намалят разходите, т.е. да се увеличи полезното пространство.
Увеличаването на броя на парчетата паритет (Y) увеличава надеждността на виртуалния диск. Колкото по-голямо е Y, толкова повече възли в клъстера могат да излязат от строя. Разбира се, увеличаването на обема на паритета намалява полезния капацитет, но това е цената на надеждността.
Зависимостта на производителността от схемите на EC е почти права: колкото повече "части", толкова по-ниска е производителността, тук, разбира се, се изисква балансиран поглед.
Този подход позволява на администраторите да конфигурират пространството по възможно най-гъвкавия начин. В рамките на пула ARDFS могат да се използват всякакви схеми за отказоустойчивост и техните комбинации, което също така, според нас, е много полезно.
По-долу е представена таблица за сравнение на няколко (не всички възможни) схеми на RF и EC.
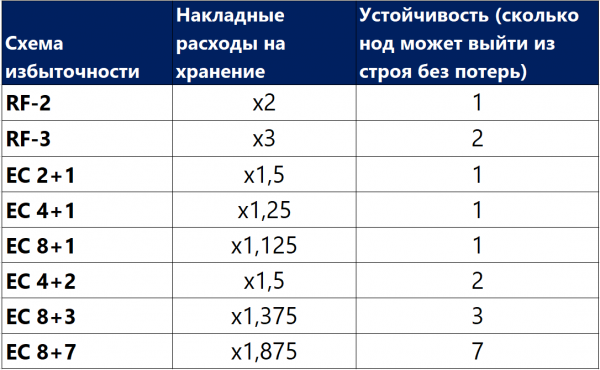
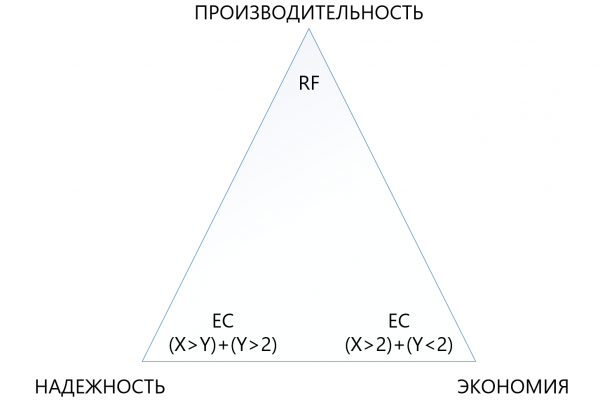
От таблицата се вижда, че дори най-"махровата" комбинация EC 8+7, допускаща загуба на до 7 нода в клъстера едновременно, "изяжда" по-малко полезно пространство (1,875 срещу 2), отколкото стандартната репликация, а защитава 7 пъти по-добре, което прави този механизъм на защита, макар и по-сложен, значително по-привлекателен в ситуации, когато е необходимо да се осигури максимална надеждност при недостиг на дисково пространство. Важно е да се разбере, че всяко "плюс" към X или Y ще бъде допълнителен разход за производителност, затова в триъгълника между надеждността, икономията и производителността трябва да се избира много внимателно. По тази причина ще посветим отделна статия на сайзинга на отстраняващото кодиране.
Надеждност и автономност на файловата система
ARDFS стартира локално на всички ноди в клъстера и синхронизира собствените си средства чрез специализирани Ethernet интерфейси. Важен момент е, че ARDFS самостоятелно синхронизира не само данните, но и метаданните, свързани с съхранението. В хода на работата по ARDFS паралелно изучавахме редица съществуващи решения и открихме, че много от тях извършват синхронизация на метата на файловата система с помощта на външна разпределена СУБД, която ние също използваме за синхронизация, но само на конфигурации, а не на метаданни на файловата система (за това и за други свързани подсистеми в следващата статия).
Синхронизация на метаданни на файловата система с външна СУБД е решение, разбира се, работещо, но в такъв случай консистентността на данните, съхранявани в ARDFS, би зависела от външната СУБД и нейното поведение (а тя, направо да си кажем — е капризна дама), което, според нас, не е добре. Защо? Ако метаданните на файловата система се повредят, на самите данни на файловата система също може да се каже „сбогом“, затова решихме да поемем по по-сложен, но надежден път.
Подсистемата за синхронизация на метаданните за ARDFS направихме сами и тя функционира абсолютно независимо от съседни подсистеми. Т.е. нито една друга подсистема не може да повреди данните на ARDFS. Според нас — това е най-надеждният и правилен път, а дали наистина е така – времето ще покаже. Освен това, с такъв подход се появява допълнително предимство. ARDFS може да се използва независимо от vAIR, просто като разширено хранилище, което със сигурност ще използваме в бъдещите продукти.
В крайна сметка, разработвайки ARDFS, получихме гъвкава и надеждна файловата система, даваща избор, където може да се спести капацитет или да се отдаде всичко на производителност, или да се направи хранилището свръхнадеждно за разумна цена, като се снижават изискванията за производителност.
Вместо с проста политика на лицензиране и гъвкава модел на доставка (предварително забелязване, vAIR се лицензира по нодове и се доставя или със софтуер, или като ПАК) това позволява много точно да се адаптира решението към най-различни изисквания на клиентите и след това лесно да се поддържа този баланс.
Кому е нужно това чудо?
От една страна, може да се каже, че на пазара вече има играчи, които имат сериозни решения в областта на хиперконвергенцията, и къде ние, всъщност, влизаме. Изглежда, че това твърдение е вярно, НО…
От друга страна, излизайки „в полето“ и общувайки с клиентите, ние и нашите партньори виждаме, че това изобщо не е така. Има много задачи за хиперконвергенцията, някъде хората просто не знаеха, че такива решения съществуват, другаде това изглеждаше скъпо, някъде имаше неуспешни тестове на алтернативни решения, а другаде дори забраняват да се купува, поради санкции. В общи линии полето се оказа неорано, затова решихме да повдигнем целината)))
Кога СХД е по-добро от ГКС?
Докато работим на пазара, често ни питат кога е по-добре да се прилага класическата схема с СХД и кога – хиперконвергентна? Много компании – производители на ГКС (особено тези, които нямат СХД в портфейла си) казват: „СХД остарява, хиперконвергент само!“. Това е смело изказване, но не отразява напълно действителността.
И честно казано, пазарът на СХД наистина се накланя към хиперконвергентните решения, но винаги има „но“.
На първо място, построените ЦОД-ове и ИТ-инфраструктури по класическата схема с СХД не могат просто да се пренастроят, така че модернизацията и разширението на такива инфраструктури е наследство за още 5-7 години.
На второ място, текущите инфраструктури (говорим за Русия) основно се строят по класическата схема с използване на СХД и не защото хората не знаят за хиперконвергенцията, а защото пазарът на хиперконвергенцията е нов, решенията и стандартите все още не са утвърдени, ИТ специалистите не са обучени, опитът е малко, а построяването на ЦОД-ове е наложително тук и сега. И тази тенденция ще продължи още 3-5 години (а след това още наследство, виж точка 1).
На трето място, има чисто техническо ограничение с допълнителни малки забавяния от 2 милисекунди при запис (без да се отчитат локалните кешове, разбира се), които са цената за разпределеното съхранение.
И нека не забравяме за използването на големи физически сървъри, които предпочитат вертикалното мащабиране на дисковата подсистема.
Има много важни и популярни задачи, при които СХД се представя по-добре от ГКС. Разбира се, производителите, които нямат СХД в продуктовия си портфейл, няма да се съгласят с нас, но сме готови да спорим с аргументи. Разбира се, като разработчици на двата продукта в едно от бъдещите публикации, ние задължително ще проведем сравнение между СХД и ГКС, където ясно ще демонстрираме условията, при които кой е по-добър.
А къде хиперконвергентните решения ще работят по-добре от СХД?
От горепосочените тези може да се направят три очевидни извода:
- Там, където допълнителните 2 милисекунди забавяне при запис, които непрекъснато възникват в продукция (в момента не говорим за синтетика, при синтетика могат да се покажат и наносекунди), са некритични, хиперконвергентното решение ще бъде подходящо.
- Там, където товарът от големите физически сървъри може да бъде преобразуван в много малки виртуални и разпределен по нодове, там също хиперконвергентните технологии ще се внедрят добре.
- Там, където хоризонталното мащабиране е с по-висок приоритет от вертикалното, там също ГКС ще бъдат отлично приети.
Какви са тези решения?
- Всички стандартни инфраструктурни услуги (каталогова служба, имейл, СЭД, файлови сървъри, малки или средни ERP и BI системи и др.). Ние наричаме това «общи изчисления».
- Инфраструктурата на облачните доставчици, където е необходимо бързо и стандартизирано хоризонтално разширяване и лесно «разрязване» на голям брой виртуални машини за клиенти.
- Инфраструктура виртуални работни площи (VDI), където много малки потребителски виртуалки стартират и спокойно «плават» в рамките на хомогенен кластер.
- Филиални мрежи, където във всеки филиал е нужно да се получи стандартна, отказоустойчива, но в същото време икономична инфраструктура от 15-20 виртуални машини.
- Всякакви разпределени изчисления (big data услуги, например). Там, където натоварването не е «дълбочинно», а «ширинно».
- Тестови среди, където са допустими допълнителни малки закъснения, но има бюджетни ограничения, тъй като става въпрос за тестове.
В момента именно за тези задачи направихме AERODISK vAIR и точно на тях правим акцент (за сега успешно). Възможно е, че скоро това да се промени, тъй като светът не стои на място.
И така…
С това приключва първата част от голям цикъл статии, в следващата статия ще разкажем за архитектурата на решението и използваните компоненти.
Ще се радваме на въпроси, предложения и конструктивни спорове.
Източник: habr.com
