

Zabbix е система за мониторинг. Както всяка друга система, тя се сблъсква с три основни проблема, характерни за всички системи за мониторинг: събиране и обработка на данни, съхранение на история и нейното почистване.
Етапите на получаване, обработка и запис на данни отнемат време. Малко, но за голяма система това може да доведе до значителни закъснения. Проблемът със съхранението е въпрос на достъпа до данните. Те се използват за доклади, проверки и тригери. Закъсненията в достъпа до данните също влияят на производителността. Когато базата данни нарасне, остарелите данни трябва да бъдат премахнати. Премахването е тежка операция, която също изразходва част от ресурсите.
Проблемите със закъсненията при събиране и съхранение в Zabbix се решават чрез кеширане: различни видове кешове и кеширане в базата данни. За решаване на третия проблем кеширането не е подходящо, затова в Zabbix е приложен TimescaleDB. За това ще разкаже Андрей Гущин — инженер по техническа поддръжка . В поддръжката на Zabbix Андрей е повече от 6 години и пряко се сблъсква с производителността.
Как работи TimescaleDB, каква производителност може да предостави в сравнение с обикновен PostgreSQL? Каква роля играе Zabbix за базата данни TimescaleDB? Как да я стартираме от нулата и как да мигрираме от PostgreSQL и производителността на коя конфигурация е най-добра? Всичко това под кат.

Предизвикателства по производителност
Всяка система за мониторинг се сблъсква с определени предизвикателства по производителност. Ще разкажа за три от тях: събиране и обработка на данни, съхранение и почистване на история.
Бързо събиране и обработка на данни. Добра система за мониторинг трябва бързо да получава всички данни и да ги обработва в съответствие с тригерни изрази - по свои критерии. След обработката системата също така трябва бързо да запази тези данни в базата данни, за да може по-късно да ги използва.
Съхранение на история. Добра система за мониторинг трябва да съхранява историята в базата данни и да предоставя удобен достъп до метриките. Историята е необходима, за да се използва в доклади, графики, тригери, прагости и изчисляеми елементи данни за уведомления.
Почистване на история. Понякога настъпва ден, когато не е нужно да съхранявате метрики. Каква полза имате от данни, събрани преди 5 години, преди месец или два: някои узли са изтрити, някои хостове или метрики вече не са нужни, тъй като са остарели и спират да се събират. Добър мониторинговата система трябва да съхранява исторически данни и от време на време да ги изтрива, за да не се разраства базата данни.
Почистването на остарели данни е остър въпрос, който силно влияе на производителността на базата данни.
Кеширане в Zabbix
В Zabbix първите и вторите извиквания се решават с помощта на кеширане. За събиране и обработка на данни се използва оперативна памет. За съхранение — история в тригери, графики и изчислявани елементи от данни. От страна на базата данни има определено кеширане за основни запитвания, например, графики.
Кеширане на самия Zabbix-сървър е:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Нека да разгледаме тях по-подробно.
ConfigurationCache
Това е основен кеш, в който съхраняваме метрики, хостове, елементи от данни, тригери — всичко необходимо за PreProcessing и за събиране на данни.
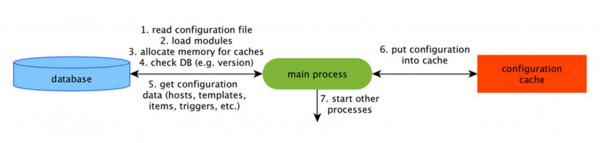
Всичко това се съхранява в ConfigurationCache, за да не се генерират излишни запитвания към базата данни. След стартиране на сървъра обновяваме този кеш, създаваме и периодично актуализираме конфигурации.
Събиране на данни
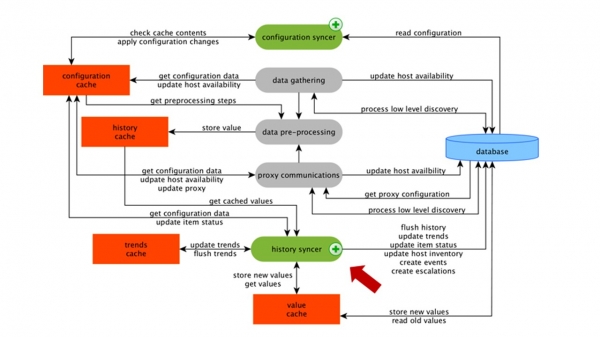
Схемата е доста голяма, но основното в нея — това е събирачите. Това са различни "pollers" — процеси на събиране. Те отговарят за различни видове събиране: събират данни по SNMP, IPMI, и предават това всичко на PreProcessing.
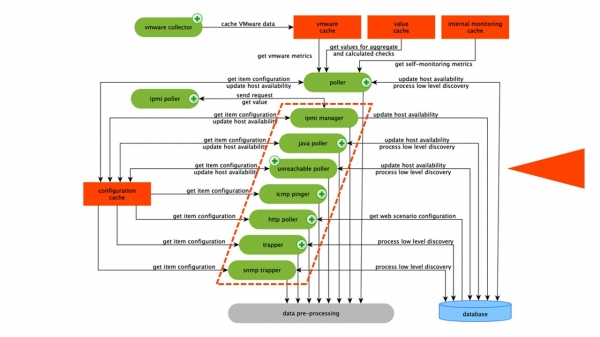 Събирачите са обведени с оранжева линия.
В Zabbix има изчислявани агрегатни елементи от данни, които са необходими, за да агрегатират проверки. Ако ги имаме, вземаме данни за тях директно от ValueCache.
PreProcessing HistoryCache
Всички събирачи използват ConfigurationCache, за да получават задачи. След това те ги предават на PreProcessing.
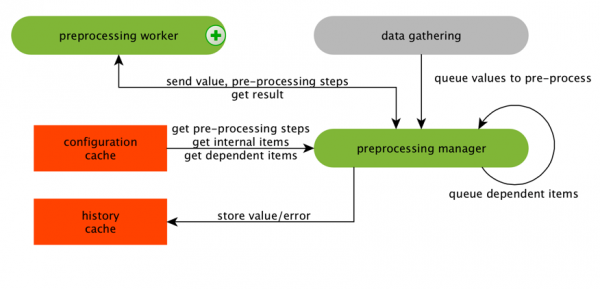
PreProcessing използва ConfigurationCache, за да получава стъпки на PreProcessing. Той обработва тези данни по различни начини.
След обработката на данните с помощта на PreProcessing, ги запазваме в HistoryCache, за да ги обработим. На този етап приключва събирането на данни и преминаваме към основния процес в Zabbix — history syncer, тъй като това е монолитна архитектура.
Бележка: PreProcessing е доста тежка операция. От версия 4.2 тя е изнесена на proxy. Ако имате много голям Zabbix с голямо количество елементи от данни и честота на събиране, това значително облекчава работата.
ValueCache, history & trends cache
Исторически синхронизатор — това е основният процес, който атомарно обработва всеки елемент данни, тоест всяко значение.
Историческият синхронизатор взима стойности от HistoryCache и проверява в Конфигурацията наличието на тригери за изчисления. Ако има, извършва изчисления.
Историческият синхронизатор създава събитие, ескалация, за да генерира оповестявания, ако е необходимо според конфигурацията, и записва. Ако има тригери за последваща обработка, той запомня това значение в ValueCache, за да не се обръща към таблицата с история. Така ValueCache се попълва с данни, необходими за изчисление на тригерите и изчислените елементи.
Историческият синхронизатор записва всички данни в БД, а тя — на диска. Процесът на обработка на това приключва.
Кеширане в БД
От страната на БД има различни кешове, когато искате да разглеждате графики или отчети за събития:
Innodb_buffer_poolот страната на MySQL;shared_buffersот страната на PostgreSQL;effective_cache_sizeот страната на Oracle;shared_poolот страната на DB2.
Има още много други кешове, но това са основните за всички БД. Те позволяват да се държат в оперативната памет данни, които често са необходими за запитвания. Имат свои технологии за това.
Производителността на БД е критично важна
Zabbix-сървърът постоянно събира данни и ги записва. При рестартиране той също чете от историята, за да попълни ValueCache. Скриптовете и отчетите използват Zabbix API, който е построен на база Web-интерфейса. Zabbix API прави запитвания към базата данни и получава необходимите данни за графики, отчети, списъци на събития и последни проблеми.
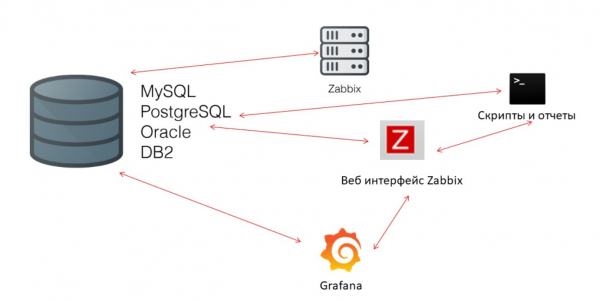
За визуализация — Grafana. Сред нашите потребители това е популярно решение. То може да изпраща директни запитвания чрез Zabbix API както към БД, така и генерира определена конкурентност за получаване на данни. Затова е необходима по-фина и добра настройка на БД, за да отговори на бързото издаване на резултати и тестове.
Housekeeper
Третото предизвикателство за производителността в Zabbix — е почистването на историята чрез Housekeeper. Той спазва всички настройки — в елементите данни е посочено колко дълго да се съхранява динамиката на измененията (трендовете) в дни.
TrendsCache изчисляваме на лето. Когато постъпват данни, ние ги агрегатираме за един час и ги записваме в таблиците за динамика на измененията на трендовете.
Housekeeper стартира и премахва информация от БД чрез обикновени «selects». Това не винаги е ефикасно, което може да се разбере от графиците на производителността на вътрешните процеси.
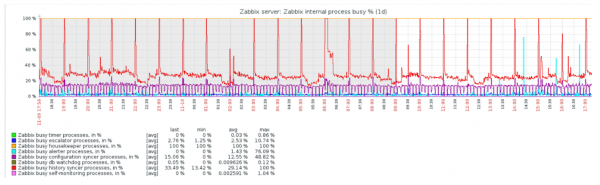
Червеният график показва, че History syncer е постоянно зает. Оранжевият график отгоре — това е Housekeeper, който постоянно се стартира. Той очаква от БД, когато тя премахне всички редове, които е задавал.
Кога да се изключи Housekeeper? Например, има «Item ID» и трябва да се премахнат последните 5 хиляди реда за определен период. Разбира се, това се случва чрез индексите. Но обикновено наборът от данни е много голям, и БД все пак чете от диска и извежда в кеша. Това винаги е много скъпа операция за БД и, в зависимост от размера на базата, може да доведе до проблеми с производителността.
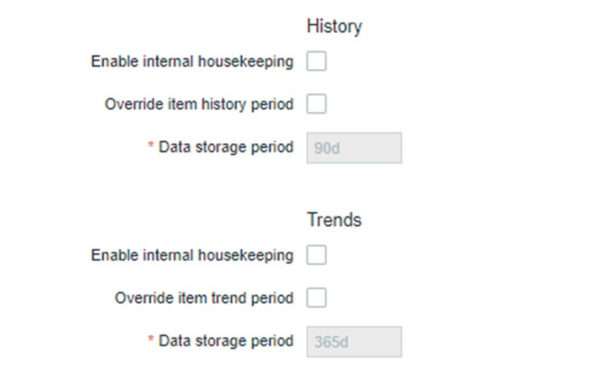
Housekeeper може просто да бъде изключен. В уеб-интерфейса има настройка в «Administration general» за Housekeeper. Изключваме вътрешния Housekeeping за вътрешната история на тенденциите и той вече не управлява това.
Housekeeper е изключен, графиците са изравнени — какви могат да бъдат проблемите в този случай и какво може да помогне за решаване на третия повик на производителността?
Partitioning — секциониране или партициониране
Обикновено партиционирането се настройва по различен начин на всяка релационна БД, която изброих. Всяка има своя технология, но те са сходни по принцип. Създаването на нова партиция често води до определени проблеми.
Обикновено партициите се настройват в зависимост от «setup» — количеството данни, което се създава за един ден. Обикновено Partitioning се задава за един ден, това е минимум. За тенденции новата партиция — за 1 месец.
Стойностите могат да се променят в случай на много голям «setup». Ако малкият «setup» е до 5 000 nvps (нови стойности в секунда), средният — от 5 000 до 25 000, то голям — над 25 000 nvps. Това са големи и много големи инсталации, които изискват внимателна настройка на самата база данни.
На много големи инсталации, времевият интервал от един ден може да не е оптимален. Виждал съм на MySQL партиции по 40 ГБ и повече на ден. Това е много голям обем данни, който може да доведе до проблеми и трябва да бъде намален.
Какво дава Partitioning?
Секциониране на таблици. Често това са отделни файлове на диска. Планът за заявки по-оптимално избира една партиция. Обикновено партиционирането се използва по диапазон — за Zabbix това също е вярно. Ние използваме там «timestamp» — времето от началото на епохата. При нас това са обикновени числа. Задавате начало и край на деня — това е партицията.
Бързо изтриване — DELETE. Избира се един файл/субтаблица, а не селекция от редове за изтриване.
Забележимо ускорява избора на данни SELECT — използва една или повече партиции, а не цялата таблица. Ако се обръщате за данни от предишен ден, те се избират от БД по-бързо, защото трябва да се зареди в кеша и да се предостави само един файл, а не голяма таблица.
Често много БД също ускорява INSERT — вмъкванията в child-таблица.
TimescaleDB
За v 4.2 обърнахме внимание на TimescaleDB. Това е разширение за PostgreSQL с нативен интерфейс. Разширението работи ефективно с данни от времеви серии, без да губи предимствата на релационните БД. TimescaleDB също автоматично партиционира.
В TimescaleDB има понятие хипертаблица (hypertable), която създавате. В нея се намират чанкове — партиции. Чанкoвете са автоматично управлявани фрагменти на хипертаблицата, които не влияят на другите фрагменти. За всеки чанк има собствен времеви диапазон.
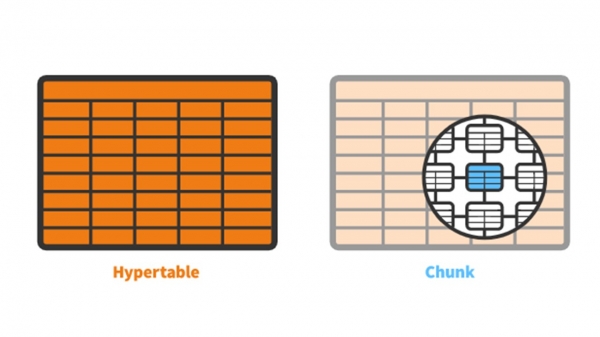
TimescaleDB vs PostgreSQL
TimescaleDB работи наистина ефективно. Производителите на разширението твърдят, че те използват по-подходящ алгоритъм за обработка на заявки, в частност, inserts. Когато размерите на dataset-вмъкванията нарастват, алгоритъмът поддържа постоянна производителност.
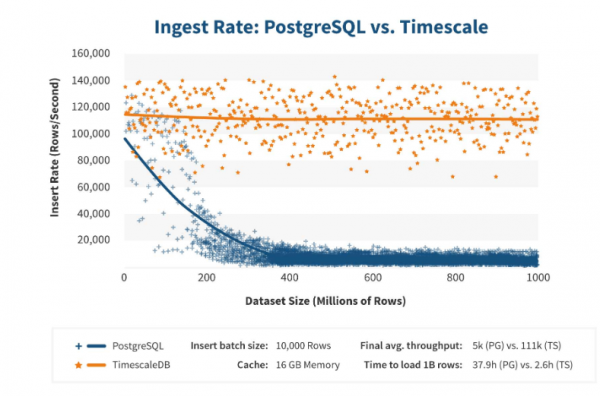
След 200 млн реда PostgreSQL обикновено започва да се забавя и губи производителност до 0. TimescaleDB позволява ефективно вмъкване на «inserts» при всякакъв обем данни.
Инсталиране
Инсталирането на TimescaleDB е доста просто за всички пакети. В всичко е подробно описано — той зависи от официалните пакети на PostgreSQL. TimescaleDB може също да бъде събран и компилиран ръчно.
За БД Zabbix просто активираме разширението:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Активирате разширението и го създавате за БД Zabbix. Последната стъпка — създаване на хипертаблица.
Миграция на таблиците с история към TimescaleDB
За това има специална функция create_hypertable:
ИЗБЕРЕТЕ create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
ИЗБЕРЕТЕ create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
ИЗБЕРЕТЕ create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
ИЗБЕРЕТЕ create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
ИЗБЕРЕТЕ create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
ИЗБЕРЕТЕ create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
ИЗБЕРЕТЕ create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
ОБНОВИ  config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
В функцията има три параметъра. Първият — таблица в БД, за която трябва да се създаде хипертаблица. Вторият — полето, по който трябва да се създаде chunk_time_interval — интервал на чанковете на партициите, които да се използват. В моя случай интервалът е един ден — 86 400.
Третият параметър — мигриране_данни. Ако зададете истинно, всички текущи данни се прехвърлят в предварително създадените чанкове. Аз самият използвах мигриране_данни. Имах около 1 TB, което отне повече от час. Дори в някои случаи, по време на тестването, изтривал съм ненужни исторически данни от символните типове, за да не се прехвърлят.
Последната стъпка — UPDATE: в db_extension слагаме timescaledb, за да разбере БД, че съществува това разширение. Zabbix го активира и правилно използва синтаксиса и запитванията вече към БД — онези функции, които са необходими за TimescaleDB.
Конфигурацията на хардware
Използвах два сървъра. Първият — VMware машина. Тя е доста малка: 20 процесора Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB оперативна памет и SSD диск на 200 GB.
Инсталирах PostgreSQL 10.8 с OS Debian 10.8-1.pgdg90+1 и файлова система xfs. Всичко е минимално настроено, за да използвам именно тази база данни, без включването на това, което ще използва самият Zabbix.
На същата машина имаше Zabbix сървър, PostgreSQL и агенти за натоварване. Имах 50 активни агенти, които използваха LoadableModule, за да генерират много бързо различни резултати: числа, низове. Запълвах базата с голямо количество данни.
Първоначалната конфигурация съдържаше 5 000 елемента данни на всеки хост. Почти всеки елемент съдържаше тригер, за да изглежда подобно на реалните инсталации. В някои случаи имаше повече от един тригер. На един възел на мрежата се падаха 3 000-7 000 тригера.
Интервалът на обновяване на елементите данни — 4-7 секунди. Регулирах натоварването, като използвах не само 50 агента, но и добавях още. Също така, с помощта на динамични данни регулирах натоварването и намалях интервала на обновяване до 4 секунди.
PostgreSQL. 35 000 nvps
Първият старт на това оборудване беше с чист PostgreSQL — 35 хиляди стойности в секунда. Както се вижда, вмъкването на данни отнема части от секунда — всичко е добре и бързо. Единственото, което забелязах, е, че SSD дискът от 200 GB бързо се запълва.
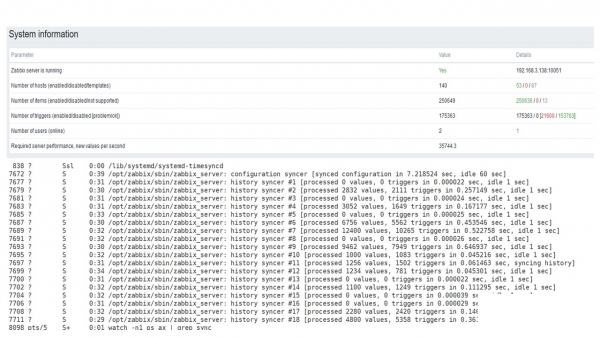
Това е стандартният потребителски интерфейс за наблюдение на производителността на Zabbix — сървърите.
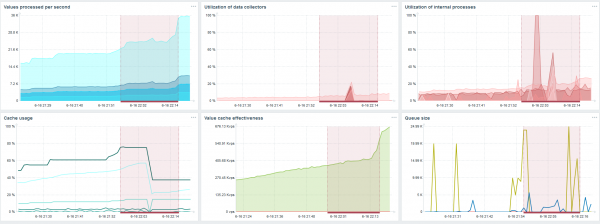
Първият син график — брой стойности в секунда. Вторият график вдясно — натоварване на процесите за събиране. Третият — натоварване на вътрешните процеси за събиране: history syncers и Housekeeper, който тук работеше достатъчно дълго.
Четвъртият график показва използването на HistoryCache. Това е нещо като буфер преди вмъкването в БД. Зеленият пети график показва използването на ValueCache, т.е. колко удара има ValueCache за тригерите — това са няколко хиляди стойности в секунда.
PostgreSQL. 50 000 nvps
После увеличих натоварването до 50 хиляди стойности в секунда на същото оборудване.
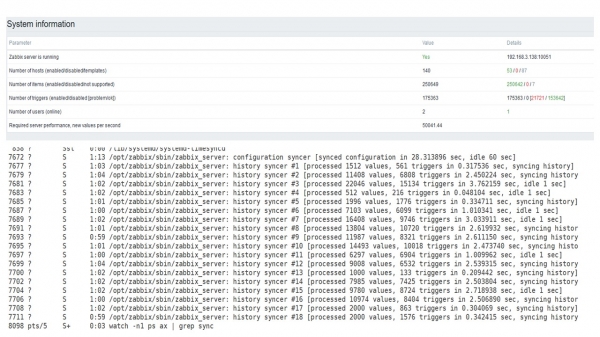
При зареждане с Housekeeper вмъкването на 10 хиляди стойности отнемаше 2-3 секунди.
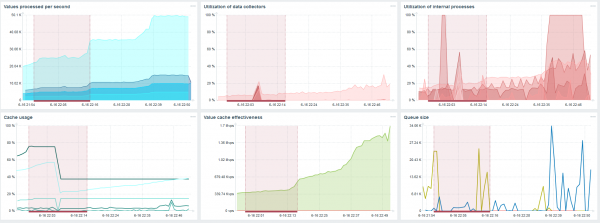
Housekeeper вече започва да пречи на работата.
От третия график се вижда, че общото натоварване на траперите и history syncers все още е на ниво 60%. На четвъртия график HistoryCache по време на работа на Housekeeper вече започва да се запълва доста активно. Той е запълнен на 20% — това е около 0,5 GB.
PostgreSQL. 80 000 nvps
После увеличих натоварването до 80 хиляди стойности в секунда. Това е приблизително 400 хиляди елемента данни и 280 хиляди тригера.
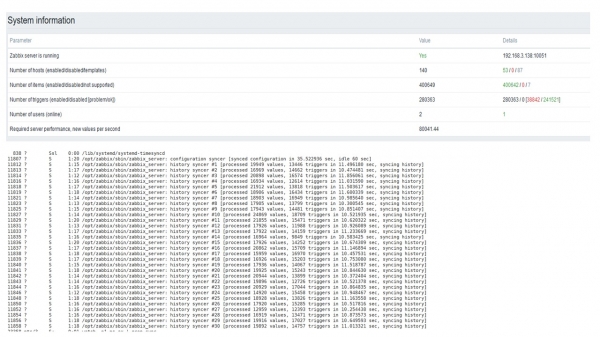
Вмъкването при натоварване на тридесет history syncers вече е доста високо.
Също така увеличих различни параметри: history syncers, кешове.
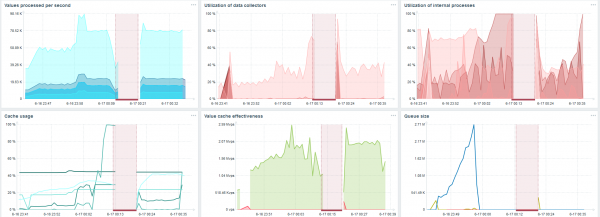
На моето оборудване натоварването на history syncers достигна максимума. HistoryCache бързо се запълни с данни — в буфера се натрупаха данни за обработка.
През цялото време наблюдавах как се използват процесорът, оперативната памет и други параметри на системата и установих, че използването на дисковете беше максимално.
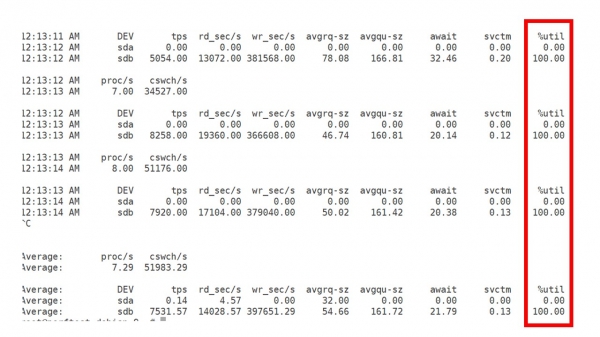
Постигнах използване на максималните възможности на диска на това оборудване и на тази виртуална машина. При такава интензивност PostgreSQL започна активно да изхвърля данни и дискът вече не успяваше да работи с четене и писане.
Втори сървър
Взех друг сървър, който имаше вече 48 процесора и 128 ГБ оперативна памет. Настроих го — сложих 60 history syncer и постигнах приемливо бързодействие.
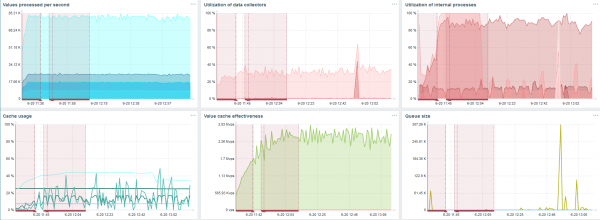
Всъщност, това вече е пределът на производителността, където е необходимо да се предприемат действия.
TimescaleDB. 80 000 nvps
Основната ми задача е да проверя възможностите на TimescaleDB под натоварването на Zabbix. 80 хиляди стойности в секунда — това е много, честотата на събиране на метрики (освен Яндекс, разбира се) и достатъчно голям «setup».
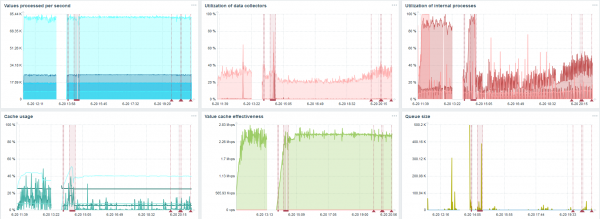
На всяка графика има спад — това е точно миграцията на данни. След спадовете в Zabbix-сървъра профилът на натоварването на history syncer се промени значително — спадна три пъти.
TimescaleDB позволява вмъкване на данни почти три пъти по-бързо и използва по-малко HistoryCache.
Съответно, ще получавате данни навреме.
TimescaleDB. 120 000 nvps
След това увеличих броя на елементите данни до 500 хиляди. Основната задача беше да проверя възможностите на TimescaleDB — получих изчислително значение от 125 хиляди стойности в секунда.
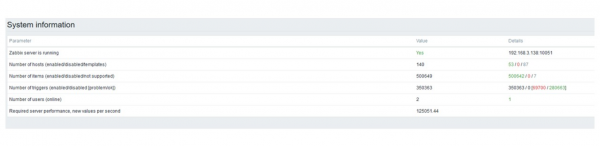
Това е работещ «setup», който може да работи дълго. Но тъй като диска ми беше само 1,5 ТБ, го запълних за няколко дни.
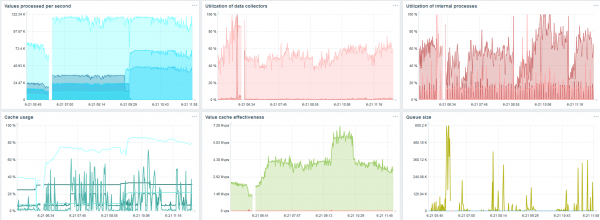
Най-важното е, че в същото време се създаваха нови партиции в TimescaleDB.
За производителността това е напълно незабележимо. Когато се създават партиции в MySQL, например, всичко е различно. Обикновено това се случва през нощта, тъй като блокира общото вмъкване, работата с таблиците и може да създаде деградация на услугата. В случая с TimescaleDB това не е така.
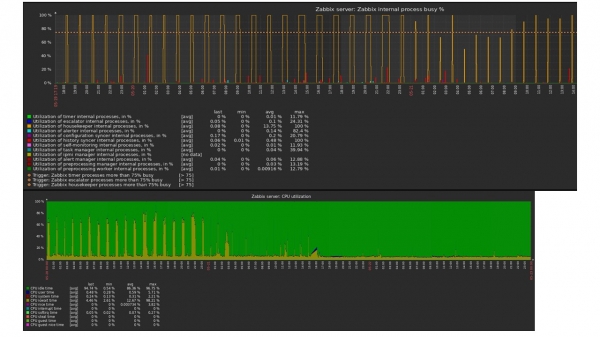
За пример ще покажа една графика от многото в community. На снимката е включен TimescaleDB, благодарение на което натоварването по използване на io.weight на процесора спадна. Използването на елементи от вътрешните процеси също намаля. И това е обикновен виртуален сървър на обикновени хард дискове, а не SSD.
Изводи
TimescaleDB е добро решение за малки «setup», които се натоварват от производителността на диска. То ще позволи да продължите да работите добре, докато мигрирате БД на по-бърз хардуер.
TimescaleDB е прост за настройка, дава увеличение на производителността, работи добре с Zabbix и има предимства в сравнение с PostgreSQL..
Ако използвате PostgreSQL и не планирате да го сменяте, препоръчвам да използвате PostgreSQL с разширение TimescaleDB в комбинация с Zabbix.Това решение работи ефективно до средни «setup».
Когато говорим за «висока производителност», имаме предвид . Скоро ще имате възможност да се запознаете с технологиите и практиките, които позволяват на услугите да обслужват милиони потребители. Списъкът за 7 и 8 ноември вече е подготвен, а все още могат да бъдат предложени.
Абонирайте се за нашия и , в които разкриваме трикове от предстоящата конференция и ще разберете как да извлечете максимална полза.
Източник: habr.com
