

Това е мит, достатъчно разпространен в сферата на сървърния хардуер. На практика хиперконвергентните решения (когато всичко е в едно) са необходими за много неща. Исторически първите архитектури бяха разработени от Amazon и Google за своите услуги. Тогава идеята беше да се създаде изчислителна ферма от еднакви възли, всеки от които има свои собствени дискове. Всичко това се обединяваше чрез определен софтуер (хипервизор) и се разделяше на виртуални машини. Основната задача е минимално усилие за поддръжка на един възел и минимални проблеми при мащабиране: просто купуваш още хиляда или две сървъри и ги свързваш. На практика това са единични случаи, и много по-често е важно по-малко на брой възли и малко друга архитектура.
Но предимството остава същото — невероятна простота на мащабиране и управление. Недостатъкът е, че различните задачи консумират ресурсите по различен начин, и някъде местните дискове ще са много, а на други места малко оперативна памет и така нататък. Тоест при различен тип задачи ще пада утилизацията на ресурсите.
Получаваше се, че плащате с 10-15% повече за удобството на настройката. Това и предизвика мита от заглавието. Дълго търсихме къде ще се прилага технологията оптимално и намерихме. Факт е, че Cisco не разполагаше със свои СХД, но искаше целия сървърен пазар. И създадоха Cisco Hyperflex - решение с локални хранилища на възлите.
А от това внезапно се получи много добро решение за резервни дата центрове (Disaster Recovery). Защо и как — сега ще ви разкажа. И ще покажа тестовете на кластера.
Където е необходимо
Хиперконвергенцията е:
- Преместване на дисковете в изчислителните възли.
- Пълна интеграция на подсистемата за съхранение на данни с подсистемата за виртуализация.
- Преместване/интеграция с мрежовата подсистема.
Тази връзка позволява реализирането на много функции на СХД на ниво виртуализация и всичко от един интерфейс за управление.
В нашата компания проектите за проектиране на резервни ЦОД са много търсени и често се избира именно хиперконвергентно решение заради множеството опции за репликация (включително метроклъстери) от кутията.
В случая на резервни ЦОД обикновено става въпрос за отдален обект на площадка в другия край на града или дори в друг град. Той позволява възстановяване на критични системи в случай на частичен или пълен отказ на основния ЦОД. Там постоянно се репликират данни от продукцията и тази репликация може да бъде на ниво приложение или на ниво блоково устройство (СХД).
Затова сега ще разкажа за устройството на системата и тестовете, а после — за няколко сценария на реално приложение с данни за спестяванията.
Тестове
Нашият екземпляр се състои от четири сървъра, всеки от които има 10 SSD диска с капацитет 960 ГБ. Има отделен диск за кеширане на операции на запис и съхранение на обслужваща виртуална машина. Самото решение е четвърта версия. Първата е откровено недостатъчна (съдейки по отзивите), втората е недостатъчно развита, третата вече е достатъчно стабилна, а тази може да се нарече релиз след завършване на бета-тестовете за широка публика. По време на тестовете не видях проблеми, всичко работи безотказно.
Промени в v4Премахнато е много на брой бъгове.
Първоначално платформата можеше да работи само с хипервизора VMware ESXi и поддържаше малък брой ноди. Освен това, процесът на разгръщане не винаги завършваше успешно, наложи се да се рестартират някои стъпки, имаше проблеми с актуализиране от стари версии, данните в GUI не винаги се показваха коректно (въпреки че и сега не съм доволен от показването на графиките за производителност), понякога възникваха проблеми на границата на виртуализацията.
Сега всички детски болести са отстранени, HyperFlex поддържа и ESXi, и Hyper-V, плюс това е възможно:
- Създаване на разширен клъстер.
- Създаване на клъстер за офиси без използване на Fabric Interconnect, от два до четири нода (купуваме само сървърите).
- Възможност за работа с външни СХД.
- Поддръжка на контейнери и Kubernetes.
- Създаване на зони за достъп.
- Интеграция с VMware SRM, ако вградената функционалност не удовлетворява.
Архитектура не се различава много от решенията на основните конкуренти, велосипед не са създали. Всичко това работи на платформата за виртуализация VMware или Hyper-V. Хардуерът се разполага на сървъри, разработени от Cisco UCS. Има тези, които мразят платформата заради относителната сложност на първоначалната настройка, множеството бутони, нетривиалната система от шаблони и зависимости, но има и тези, които са познали дзен, проникнали в идеята и повече не искат да работят с други сървъри.
Ще разгледаме точно решение за VMware, тъй като решението първоначално е създадено за него и има по-голям функционалност, Hyper-V бе доразвито по време на процеса, за да не изостава от конкурентите и да отговаря на очакванията на пазара.
Има клъстер от сървъри, пълни с дискове. Има дискове за съхранение на данни (SSD или HDD — по ваш вкус и нужди), и един SSD диск за кеширане. При запис на данни в datastore, данните се съхраняват на кеширащия слой (посвещението SSD диск и RAM на сервизното ВМ). Паралелно, блок от данни се изпраща на нодовете в клъстера (броят на нодовете зависи от фактора на репликация на клъстера). След потвърждение от всички нодове за успешен запис, потвърждението се изпраща на хипервизора и след това — на ВМ. Записаните данни в фонов режим се дедупликират, компресират и записват на дисковете за съхранение. При това на дисковете за съхранение винаги се записва голям блок последователно, което намалява натоварването на дисковете за съхранение.
Дедупликацията и компресията са включени постоянно и не могат да бъдат изключени. Четенето на данни става директно от дисковете за съхранение или от кеша в RAM. Ако се използва хибридна конфигурация, четенето също се кешира на SSD диск.
Данните не се привързват към текущото разположение на виртуалната машина и се разпределят равномерно между нодовете. Този подход позволява да се натоварят еднакво всички дискове и мрежови интерфейси. Налице е очевиден минус: не можем максимално да намалим закъснението при четене, тъй като няма гаранция за наличието на данни локално. Но смятам, че това е незначителна жертва в сравнение с получените предимства. Тем повече закъсненията в мрежата достигнаха такива стойности, че практически не влияят на общия резултат.
За цялата логика на работа на дисковата подсистема отговаря специална сервизна ВМ Cisco HyperFlex Data Platform controller, която се създава на всеки възел за съхранение. В нашата конфигурация на сервизната ВМ бяха отделени осем vCPU и 72 GB RAM, което не е никак малко. Напомням, че самият хост разполага с 28 физически ядра и 512 GB RAM.
Сервизната ВМ има достъп до физическите дискове директно чрез проброс на SAS контролера в ВМ. Общуването с хипервизора става чрез специален модул IOVisor, който прихваща операции за вход-изход и с помощта на агент, позволяващ предаване на команди в API на хипервизора. Агентът отговаря за работата с HyperFlex-снепшотове и клони.
В хипервизора дисковите ресурси се монтират като NFS или SMB споделяне (в зависимост от типа на хипервизора, предположете кой какъв е). А под капака се крие разпределена файлова система, която позволява добавянето на функции на напълно развитите СХД: тънко разпределение на томове, компресия и дедупликация, снепшотове по технологията Redirect-on-Write, синхронна/асинхронна репликация.
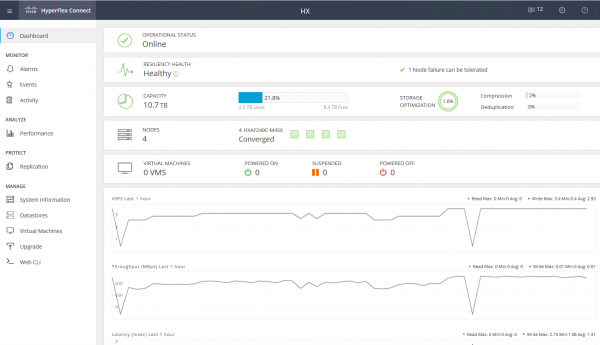
Сервизната ВМ предоставя достъп до WEB интерфейс за управление на подсистемата HyperFlex. Има интеграция с vCenter, и голямата част от ежедневните задачи могат да бъдат изпълнени от там, но датасторите, например, е по-удобно да се нарязват от отделен уеб интерфейс, ако вече сте преминали на бързия HTML5 интерфейс, или можете да използвате пълния Flash клиент с пълна интеграция. В сервизния уеб интерфейс можете да видите производителността и подробния статус на системата.
Съществува и друг вид възли в клъстера — изчислителни възли. Това могат да бъдат ракови или блейд сървъри без вградени дискове. На тези сървъри могат да се стартират ВМ, данните на които се съхраняват на сървъри с дискове. От гледна точка на достъпа до данни няма разлика между типовете възли, тъй като архитектурата предполага абстрахиране от физическото разположение на данните. Максималното съотношение между изчислителни възли и възли за съхранение е 2:1.
Използването на изчислителни възли увеличава гъвкавостта при мащабирането на ресурсите в клъстера: не е нужно да купуваме възли с дискове, ако имаме нужда единствено от CPU/RAM. Освен това можем да добавим блейд-корзина и да постигнем икономия на разходи за разполагане на сървъри в стойката.
В резултат имаме хиперконвергентна платформа с следните характеристики:
- До 64 възела в клъстера (до 32 възела за съхранение).
- Минималният брой на възлите в клъстера е три (две за Edge клъстера).
- Механизмът за излишък на данни: зеркализация с фактор на репликация 2 и 3.
- Metro клъстер.
- Асинхронна репликация на ВМ на друг HyperFlex клъстер.
- Оркестрация на превключване на ВМ в отдалечен ЦОД.
- Нативни снепшотове с технология Redirect-on-Write.
- До 1 ПБ полезно пространство при фактор на репликация 3 и без да се взема предвид дедупликация. Фактор на репликация 2 не се взима предвид, тъй като това не е вариант за сериозна продажба.
Още едно огромно предимство — простота при управлението и разгръщането. Всички сложности по настройката на сървъри UCS се поемат от специализирана ВМ, подготвена от инженерите на Cisco.
Конфигурация на тестови стенд:
- 2 x Cisco UCS Fabric Interconnect 6248UP като управляващ клъстер и мрежови компоненти (48 порта, работаещи в режим Ethernet 10G/FC 16G).
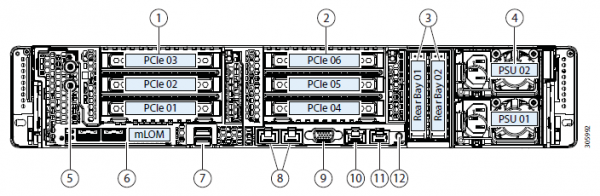
- Четири сървъра Cisco UCS HXAF240 M4.
Характеристики на сървърите:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/двойна ранка/x4/1.2v
Мрежа
UCSC-MLOM-CSC-02 (VIC 1227). 2 порта 10G Ethernet
Склад HBA
Cisco 12G Modular SAS проходен контролер
Складови дискове
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Повече опции за конфигурацииОсвен избраното оборудване, в момента са налични следните опции:
- HXAF240c M5.
- Един или два CPU от Intel Silver 4110 до Intel Platinum I8260Y. Наличен е втори генерация.
- 24 слота за памет, модули от 16 GB RDIMM 2600 до 128 GB LRDIMM 2933.
- От 6 до 23 диска за данни, един кеширащ диск, един системен и един бутов диск.
Дискове за капацитет
- HX-SD960G61X-EV 960GB 2.5 инча Enterprise Value 6G SATA SSD (1X издръжливост) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 инча Enterprise Value 6G SATA SSD (1X издръжливост) SAS 3.8 TB.
- Кеширащи дискове
- HX-NVMEXPB-I375 375GB 2.5 инча Intel Optane диск, екстремна производителност и издръжливост.
- HX-NVMEHW-H1600* 1.6TB 2.5 инча Ent. Perf. NVMe SSD (3X издръжливост) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 инча Ent. Perf. 12G SAS SSD (10X издръжливост) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 инча Ent. Perf. 12G SAS SED SSD (10X издръжливост) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 инча Enterprise performance 12G SAS SSD (3X издръжливост).
Системни / Лог дискове
- HX-SD240GM1X-EV 240GB 2.5 инча Enterprise Value 6G SATA SSD (изисква обновление).
Бутови дискове
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Свързване към мрежата чрез 40G, 25G или 10G Ethernet портове.
Като FI могат да бъдат HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Самият тест
За тестване на дисковата подсистема използвах HCIBench 2.2.1. Това е безплатен инструмент, позволяващ автоматизиране на генерирането на натоварвания от няколко виртуални машини. Самата натовареност се генерира от обикновен fio.
Нашият клъстер се състои от четирима възли, фактор на репликация 3, всички дискове Flash.
За тестиране създадох четири дата магазина и осем виртуални машини. За тестовете за записване се предполагае вариант, при който кеширащият диск не е пренаситен.
Резултатите от тестовете са следните:
100 % Четене 100 % Случайно
0 % Четене 100 % Случайно
Блок/дълбочина на опашката
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
С удебно посочени стойности, след които няма повишаване на производителността, понякога дори се наблюдава влошаване. Свързано е с факта, че достигаме производителността на мрежата/контролерите/дисковете.
- Последователно четене 4432 МБ/с.
- Последователно записване 804 МБ/с.
- При отказ на един контролер (отказ на виртуална машина или хост) падението в производителността е два пъти.
- При отказ на диска за съхранение - пада на 1/3. Ребилдът на диска заема 5% от ресурсите на всеки контролер.
На малък блок достигаме производителността на контролера (виртуална машина), неговият CPU е натоварен на 100%, при увеличаване на блока достигаме капацитета на портовете. 10 Гбит/с не е достатъчно за разкриване на потенциала на AllFlash системата. За съжаление, параметрите на предоставения демостенд не позволяват да се провери работа на 40 Гбит/с.
Според впечатленията ми от тестовете и изучаването на архитектурата, благодарение на алгоритъма, разпределящ данни между всички хостове, получаваме мащабируема предсказуема производителност, но това също така е ограничение при четене, тъй като от локалните дискове можеше да се извлекат и по-големи стойности, тук може да спаси по-производителна мрежа, например, налични FI на 40 Гбит/с.
Също така един диск за кеширане и дедупликация може да бъде ограничение, фактически в този стенд можем да записваме на четири SSD диска. Беше чудесно да имаме възможност да увеличим броя на кеширащите дискове и да видим разликата.
Реално използване
За организиране на резервен ЦОД могат да се използват два подхода (разполагане на резервно копие на отдалечен обект не се разглежда):
- Активно-пассивен. Всички приложения се хостват в основния ЦОД. Репликацията е синхронна или асинхронна. В случай на неизправност на основния ЦОД, трябва да активираме резервния. Това може да стане ръчно/чрез скриптове/приложения за оркестрация. Тук получаваме RPO, равен на честотата на репликация, а RTO зависи от реакцията и уменията на администратора и качеството на разглеждането/дебъгването на плана за превключване.
- Активно-активен. В този случай налична е само синхронна репликация, наличността на ЦОД-ите се определя от кворума/арбитъра, позициониран строго на трето място. RPO = 0, а RTO може да достигне 0 (ако приложението позволява) или да е равно на времето за обработка на отказа на ноду в кластер за виртуализация. На ниво виртуализация се създава разширен (Metro) клъстер, изискващ Active-Active СХД.
Обикновено виждаме при клиентите вече реализирана архитектура с класическа СХД в основния ЦОД, затова проектираме още една за репликация. Както споменах, Cisco HyperFlex предлага асинхронна репликация и създаване на разширен клъстер за виртуализация. При това не ни е нужна специализирана СХД от ниво Midrange и нагоре с недешеви функции за репликация и Active-Active достъп до данни на две СХД.
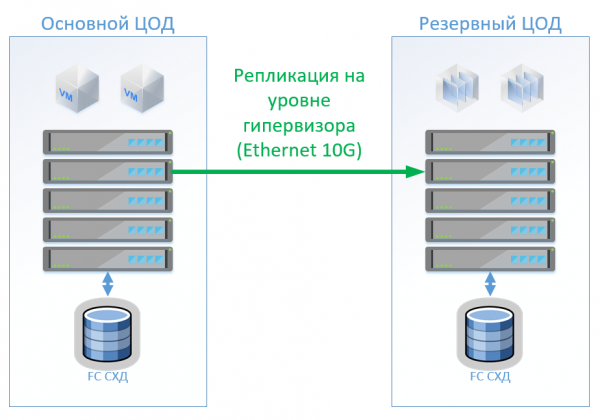
Сценарий 1: Имаме основен и резервен ЦОД, платформа за виртуализация на VMware vSphere. Всички продуктивни системи са разположени в основния ЦОД, а репликацията на виртуалните машини се извършва на ниво хипервизор, което ще позволи да не държим ВМ включени в резервния ЦОД. Бази данни и специализирани приложения репликираме със вградените средства и поддържаме ВМ включени. При отказ на основния ЦОД, стартираме системите в резервния ЦОД. Предполага се, че имаме около 100 виртуални машини. Докато основният ЦОД е активен, в резервния ЦОД могат да се стартират тестови среди и други системи, които могат да бъдат изключени в случай на превключване на основния ЦОД. Има и вариант, когато имаме двустранна репликация. От гледна точка на оборудването, нищо не се променя.
В случай на класическа архитектура ще поставим хибридно СХД във всеки ЦОД с достъп по FibreChannel, тиринг, дедупликация и компресия (но не онлайн), 8 сървъра на всяка площадка, по 2 комутатора FibreChannel и Ethernet 10G. За репликация и управление на превключването в класическата архитектура можем да използваме средства на VMware (Replication + SRM) или външни средства, които ще бъдат малко по-евтини и понякога по-удобни.
На схемата е представена схема.
В случай на използване на Cisco HyperFlex получаваме следната архитектура:
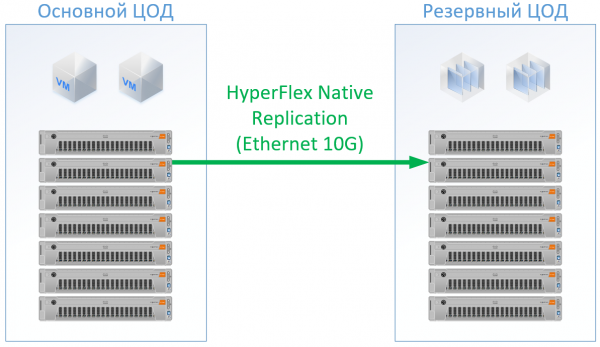
За HyperFlex използвах сървъри с големи ресурси CPU/RAM, тъй като част от ресурсите ще отидат за ВМ контролера HyperFlex, по CPU и памет дори малко надзаложих в конфигурацията на HyperFlex, за да не подигравам на Cisco и да гарантирам ресурси за останалите ВМ. Така можем да се откажем от FibreChannel комутатори и Ethernet портовете под всеки сървър, локалният трафик се комутирува вътре в FI.
В резултат получихме следната конфигурация за всеки ЦОД:
Сървъри
8 x 1U сървър (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
СХД
Хибридно СХД с FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet комутатор 10G 12 порта
—
SAN
2 x FC комутатор 32/16Gb 24 порта
2 x Cisco UCS FI 6332
Лицензии
VMware Ent Plus
Репликация и/или оркестрация на превключването на ВМ
VMware Ent Plus
За Hyperflex не заложих лицензии за софтуер за репликация, тъй като това е достъпно от кутията.
За класическата архитектура избрах вендор, който се е утвърдил като качествен и евтин производител. За двата варианта примених стандартната за конкретното решение отстъпка, в резултат получих реални цени.
Решението на Cisco HyperFlex излезе с 13% по-евтино.
Сценарий 2: създаване на два активни ЦОД-а. В този сценарий проектираме разширен клъстер на VMware.
Класическата архитектура се състои от сървъри за виртуализация, SAN (протокол FC) и две СХД, които могат да четат и пишат на тома, разширен между тях. На всяка СХД заложихме полезен капацитет за локата.
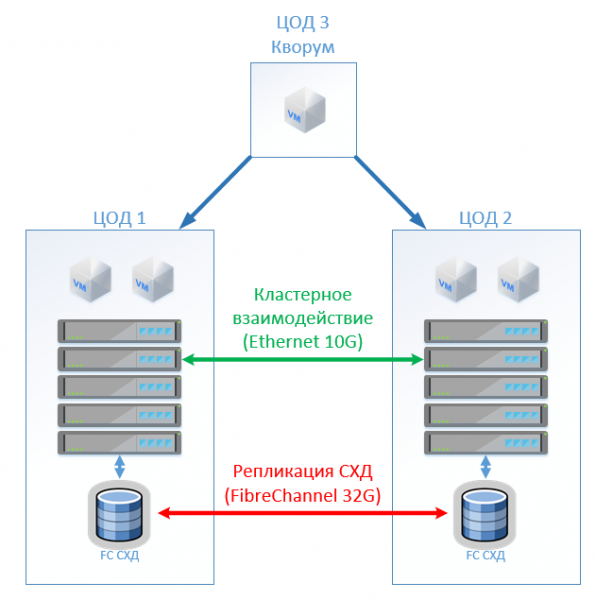
С HyperFlex просто създаваме Stretch кластер с равно количество нодове на двете площадки. В този случай се използва фактор на репликация 2+2.
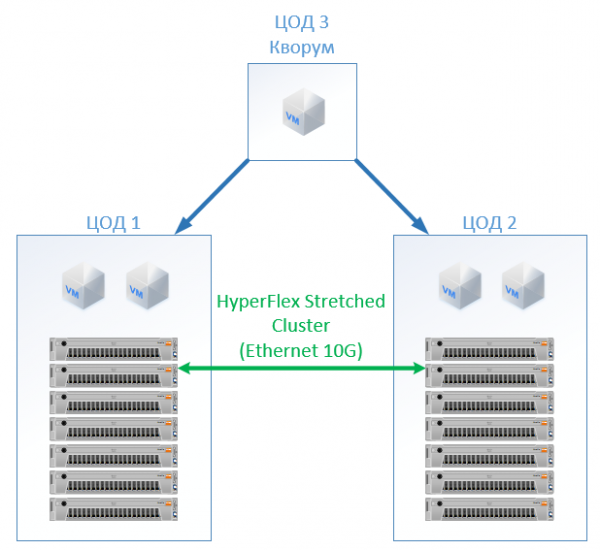
Получихме следната конфигурация:
Класическа архитектура
HyperFlex
Сървъри
16 x 1U сървър (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
СХД
2 x AllFlash СХД (150 TB SSD)
—
LAN
4 x Ethernet комутатор 10G 24 порта
—
SAN
4 x FC комутатор 32/16Gb 24 порта
4 x Cisco UCS FI 6332
Лицензии
VMware Ent Plus
VMware Ent Plus
В всички изчисления не включвах мрежовата инфраструктура, разходите за ЦОД и т. н.: те ще бъдат едни и същи за класическата архитектура и за решението на HyperFlex.
По цена HyperFlex се оказа с 5% по-скъп. Тук е важно да се отбележи, че по ресурсите CPU/RAM имам дисбаланс за Cisco, тъй като в конфигурацията попълвах каналите на контролерите на паметта равномерно. Цената е малко по-висока, но не в значителна степен, което ясно показва, че хиперконвергенцията не е непременно „играчка за богати“, а може да конкурира със стандартния подход за изграждане на ЦОД. Освен това това може да бъде интересно за тези, които вече имат сървъри Cisco UCS и съответната инфраструктура под тях.
От предимствата получаваме липса на разходи за администриране на SAN и СХД, онлайн компресия и дедупликация, единна точка за поддръжка (виртуализация, сървъри, също СХД), икономия на пространство (но не във всички сценарии), опростяване на експлоатацията.
Що се отнася до поддръжката, то тук я получавате от един вендор — Cisco. Судейки по опита ми с сървъри Cisco UCS, ми харесва, на HyperFlex не се наложи да се свързвам, всичко работеше. Инженерите отговарят бързо и могат да решават не само типови проблеми, но и сложни гранични случаи. Понякога се обръщам към тях с въпроси: „Може ли да се направи така, да се прикрепи това?“ или „Настроих нещо и не иска да работи. Помогнете!“ — те търпеливо ще намерят подходящото ръководство и ще посочат правилните действия, няма да отговорят: „Решаваме само хардуерни проблеми.“
Връзки
- Моят имейл е StGeneralov@croc.ru
Източник: habr.com
