

Директор по експлоатация на портала Banki.ru Андрей Николски разказа на миналогодишната конференция за „сиротните услуги“: как да разпознаем сиротата в инфраструктурата, какви проблеми създават сиротните услуги, какво да правим с тях и какво да правим, ако нищо не помага.
Под кат е текстовата версия на доклада.
Здравейте, колеги! Аз съм Андрей и ръководя експлоатацията в компанията Banki.ru.
Имаме големи услуги, това са монолитни услуги, имаме услуги в по-класическото разбиране, и много малки. В моя работническо-селянска терминология казвам, че ако услугата е проста и малка, то тя е микро, а ако не е много проста и не е малка, точно такава е просто услуга.
Предимства на услугите
Бързо ще премина през предимствата на услугите.
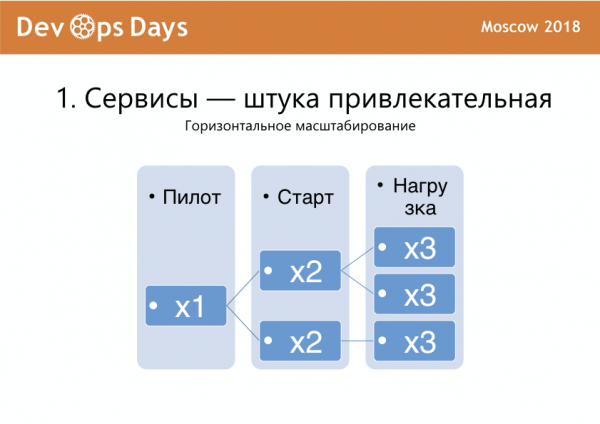
На първо място — мащабируемост. Можете бързо да направите нещо на услугата и да стартирате в продукция. Ако получите трафик, клонирате услугата. И ако получите още трафик, отново клонирате и с това живеете. Това е добър бонус и, по принцип, когато започвахме, той се счита за най-важен, защо изобщо правим всичко това.
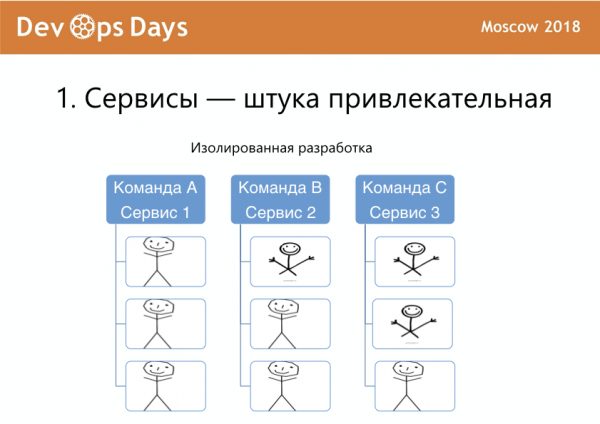
На второ място, изолирано развитие, когато имате няколко екипа за разработка, няколко различни разработчици в всеки екип и всеки екип разработва своя собствена услуга.
С екипите възниква нюанс. Разработчиците са различни. И съществуват, например, . Впервые видях това у Максима Дорофеева. Понякога хората-снежинки присъстват в някои екипи, а в други ги няма. Това прави различните услуги, използвани в компанията, малко неравномерни.
Погледнете на картинката: това е добър разработчик, има големи ръце, може много да направи. Основният проблем е откъде идват тези ръце.
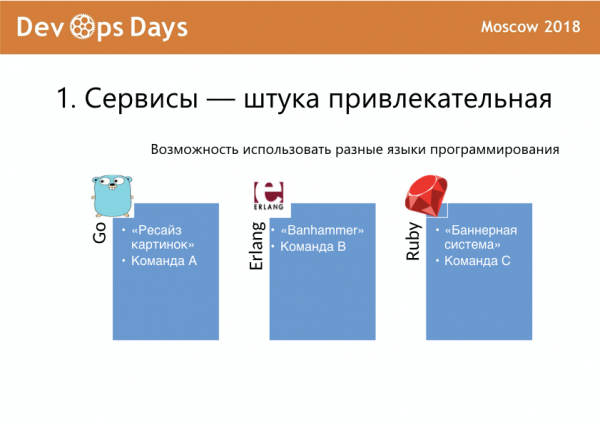
Услугите дават възможност да се използват различни програмни езици, по-подходящи за различни задачи. Някоя услуга на Go, някоя на Erlang, някоя на Ruby, нещо на PHP, нещо на Python. Въобще, има възможност да се развие много широко. И тук също има нюанси.
Услугово-ориентираната архитектура е преди всичко за devops. Тоест, ако нямате автоматизация, няма процес на деплой, ако настройвате ръчно, конфигурациите ви могат да се променят от инстанция на услугата до инстанция, и трябва да влизате и да правите нещо там, то влизате в ада.
Например, ако имате 20 услуги и трябва да ги деплоите ръчно, имате 20 конзоли и едновременно натискате „enter“, като нинджа. Това не е много добро.
Ако имате услуга след тестиране (ако има такова, разбира се) и трябва да я дооправите, за да работи в продукция, имам и за вас лоши новини.
Ако разчитате на специфични услуги на Amazon и работите при това в Русия, то два месеца назад вие също бяхте с "Всичко гори около мен, аз съм добре, всичко е супер".
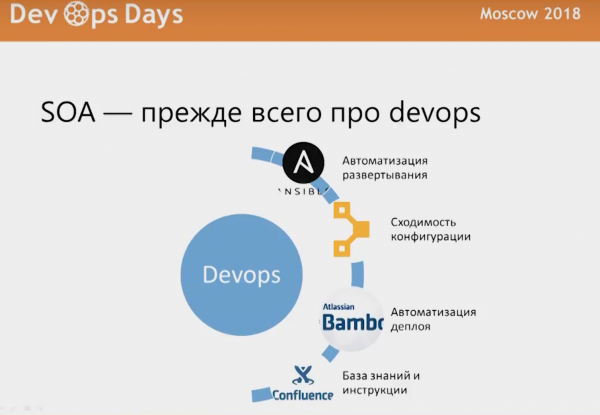
Използваме Ansible за автоматизация на развертыването, Puppet за сходимост, Bamboo за автоматизация на деплоя, Confluence, за да описваме всичко това.
Няма да спирам подробно на това, защото докладът е по-скоро за практиките на взаимодействие, а не за техническата реализация.
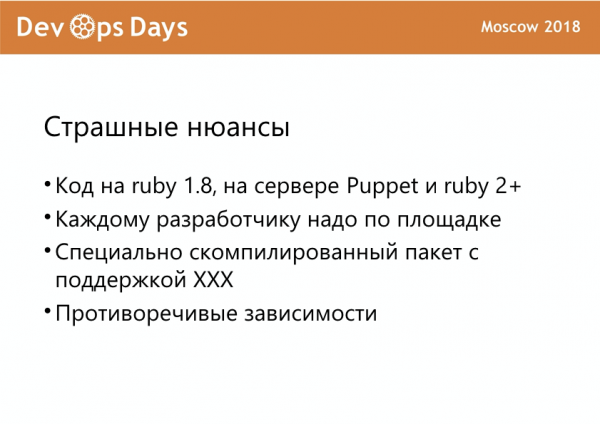
Имали сме, например, проблеми, когато Puppet на сървъра работи с Ruby 2, а някое приложение е написано за Ruby 1.8, и те не работят заедно. Настъпва някакъв проблем. А когато трябва да задържите няколко версии на Ruby на една машина, обикновено започват проблеми.
Например всеки разработчик получава платформа, на която има почти всичко, което имаме, всички услуги, които могат да се разработват, за да има изолирана среда, където може да я счупи и да направи каквото иска.
Понякога е необходим някакъв специално компилиран пакет с поддръжка на нещо. Това е доста сериозно. Чух доклад, където docker образът тежи 45 Гб. В Linux, разбира се, е по-лесно, там всичко е по-малко, но пак, няма да стигнат местата.
Има противоречиви зависимости, когато една част от проекта зависи от библиотека на една версия, друга част от проекта зависи от друга версия, а библиотеките не могат да се инсталират заедно по никакъв начин.
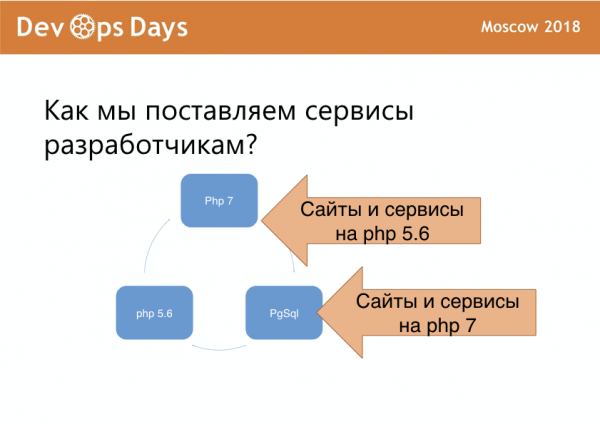
Имаме сайтове и услуги на PHP 5.6, срамуваме се за тях, но какво да правим. Това е една платформа за нас. Има сайтове и услуги на PHP 7, които са повече, за тях не се срамуваме. И всеки разработчик има своя база, където радостно работи.
Ако пишете в компанията на един език, то три виртуалки на разработчик звучат нормално. Ако имате различни програмни езици, ситуацията става по-лоша.
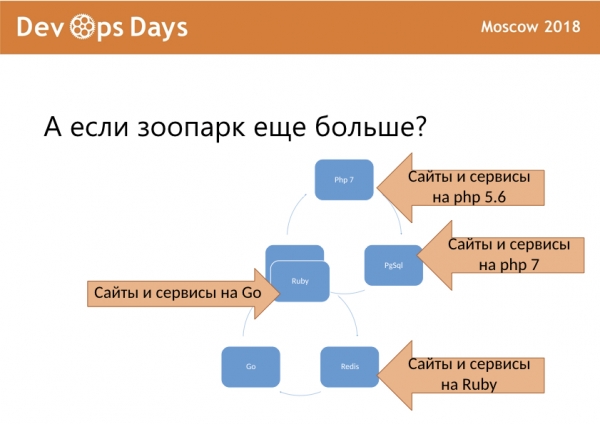
Вие получавате уебсайтове и услуги на този, на този, а след това още една платформа за Go, една платформа за Ruby и още някакъв Redis отстрани. В крайна сметка всичко това се превръща в голямо поле за поддръжка и всяко нещо може да се развали по всяко време.
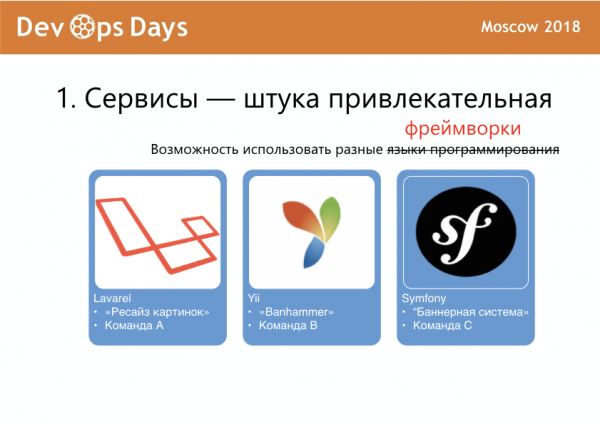
Затова заменихме предимствата на програмния език с различни фреймворкове, тъй като фреймворковете на PHP са доста различни, имат различни възможности, различни общности и различна поддръжка. И можете да пишете услуга, така че вече да имате нещо готово за нея.
Всяка услуга има свой екип
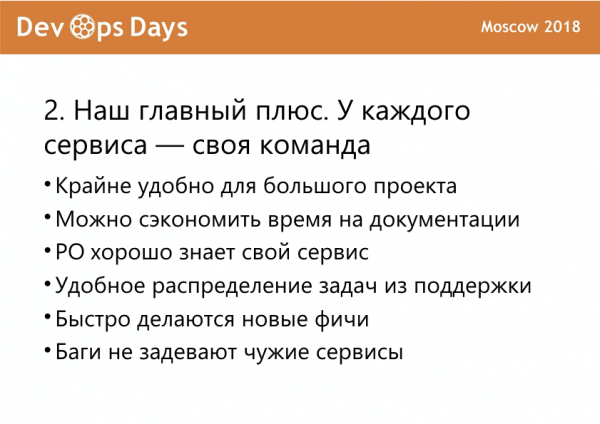
Нашето основно предимство, което се е оформило през последните години, е, че всяка услуга има свой екип. Това е удобно за голям проект, може да спести време за документация, мениджърите добре познават проекта си.
Задачите от поддръжката могат да се поставят отлично. Например, ако услугата за застраховане се развали. И веднага екипът, който се занимава със застраховането, отива да я поправя.
Бързо се създават нови функции, защото когато имате един атомарен сервис, можете бързо да добавите нещо в него.
И когато счупите своя сервис, а това е неизбежно, не засягате чужди услуги, и при вас не идват разработчици с бита от други екипи и не ви казват: «Ай-ай, не трябва да правите така».
Както винаги, има нюанси. Имаме стабилни екипи, мениджърите са здраво привързани към екипите. Има ясни документи, мениджърите стриктно следят всичко. Всяка команда с мениджер има по няколко услуги и има конкретна точка на компетентност.
Ако екипите са плаващи (такова също понякога се използва при нас), има добър метод, наречен „звездна карта“.
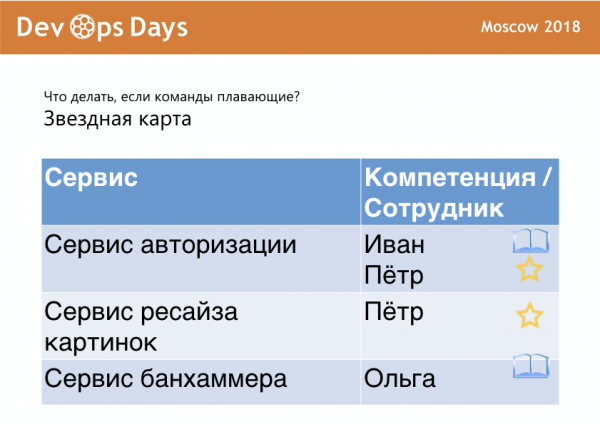
Имате списък на услугите и хората. Звездичката означава, че човекът е експерт в тази услуга, а книжката означава, че човекът изучава тази услуга. Задачата на човека е да замени книжката със звездичка. А ако пред услугата няма нищо написано, тогава започват проблеми, за които ще разкажа по-нататък.
Как се появяват услугите-сироти?
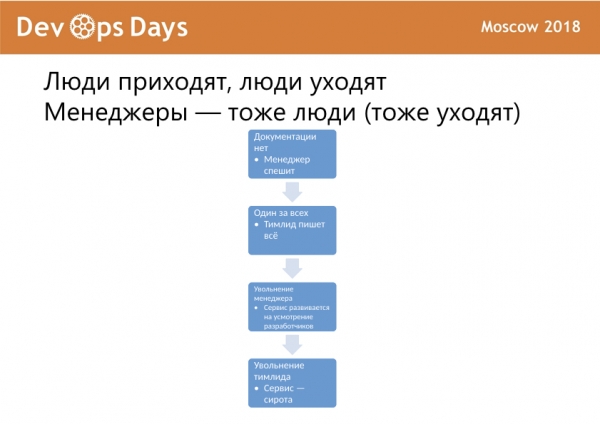
Първата проблема, първият начин да получите услуга сирак във вашата инфраструктура, е съкращаването на хора. Било ли е някога така, че от бизнеса идват срокове, преди да сте оценили задачите? Понякога сроковете са строги и просто няма достатъчно време за документация. "Трябва да предадем услугата в продукция, после ще допишем."
Ако екипът е малък, понякога в него има един програмист, който пише всичко, а останалите са на поддържане. "Аз написах основната архитектура, ти направи интерфейсите." След това в някакъв момент мениджърът, например, напуска. И в този период, когато мениджърът е напуснал, а нов още не е назначен, програмистите сами решават накъде върви услугата, какво се случва. А както знаем (да се върнем на няколко слайда назад), в някои екипи има хора-метле, понякога метле-тимлидер. След това той напуска, и ние получаваме сирак услугата.
При това задачите от поддръжката и бизнеса не изчезват, те се натрупват в беклога. Ако при разработката на услугата са имало архитектурни грешки, те също се натрупват в беклога. Услугата бавно деградира.
Как да разпознаем сирак?
Този списък описва ситуацията добре. Кой разпозна нещо от своята инфраструктура?
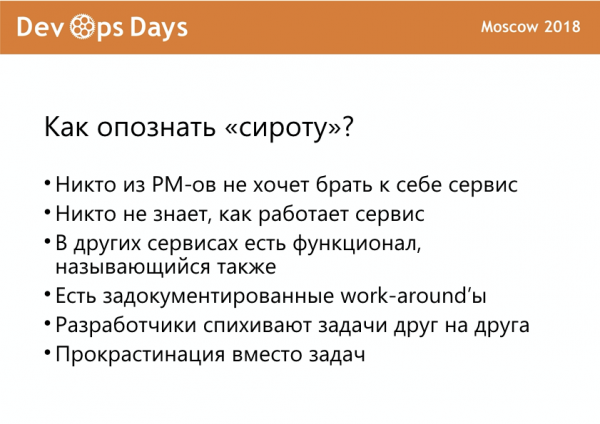
За документираните work-around’и: има услуга, и като цяло, тя работи, има ръководство на две страници как да се работи с нея, но как работи вътре, никой не знае.
Или например, има някакъв съкращател на линкове. При нас в момента се използват три съкращатели на линкове за различни цели в различни услуги. Това са последствията точно от тях.
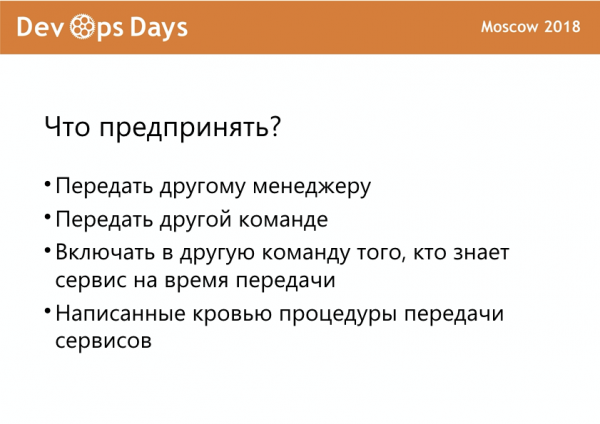
Сега ще бъда капитанът очевидност. Какво трябва да се направи? Първо, трябва да предадете услугата на друг мениджър, на друг екип. Ако вашият тимлидер все още не е напуснал, то в този друг екип, когато разберете, че услугата наподобява сирак, трябва да включите някого, който поне малко разбира от нея.
Основното нещо: трябва да имате написани процедури за предаване. В нашия случай обикновено следя за това аз, защото ми трябва да функционира всичко. На мениджърите им трябва бързо да предадат, а какво ще стане с него след това, вече не им е толкова важно.
Следният начин да се направи сирота е: „Ще извършим аутсорсинг, така ще бъде по-бързо, а после ще предадем на екипа“. Ясно е, че всеки има някакви планове в екипа, опашка. Често бизнес поръчителят мисли, че аутсорсерите ще направят същото, както и техническия отдел, който има в компанията. Въпреки че мотиваторите им са различни. При аутсорсинга могат да възникнат странни технологични решения и необичайни алгоритмични подходи.
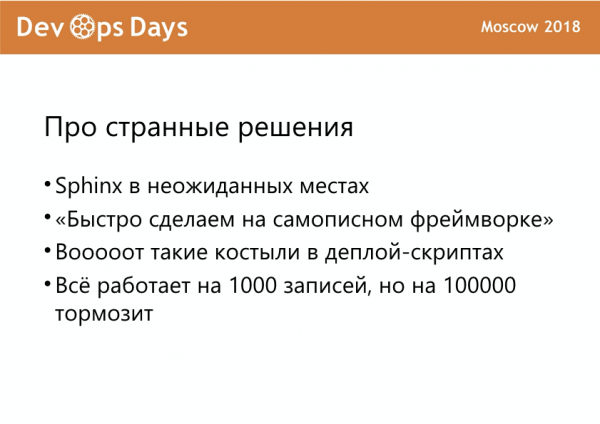
При нас, например, имаше услуга, в която Sphinx беше на различни неочаквани места. Ще разкажа по-късно какво ми се наложи да направя.
Аутсорсерите често имат самописани фреймворкове. Това обикновено е просто голи PHP с копипейст от предишен проект, където може да се намери всичко. Големи костни крепежи в скриптовете за внедряване, когато трябва да промените няколко реда в някакъв файл с помощта на сложни Bash скриптове, като тези скриптове за внедряване се извикват от някакъв трети скрипт. В резултат на това, когато смените системата за внедряване, избирате нещо друго, и хоп, услугата ви не работи. Защото там трябваше да поставите още 8 линка между различни папки. Или се случва, че хиляда записа работят, а сто хиляди вече не.
Ще продължа да капитанствам. Приемането на услуга от аутсорсинга е задължителна процедура. Имали ли сте случай, когато услуга от аутсорсинг идва, а тя не се приема никъде? Това не е толкова популярно, колкото сиротната услуга, но все пак.
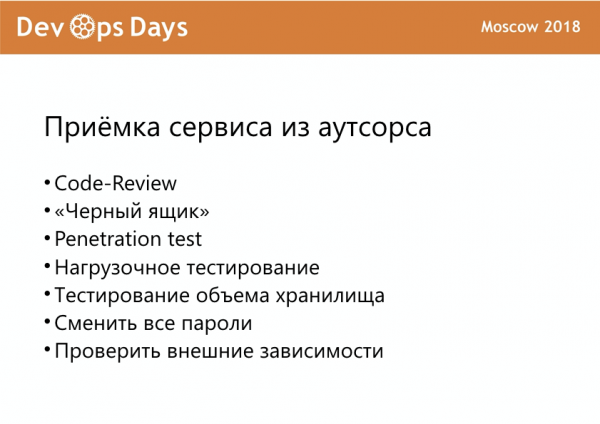
Услугата трябва да се проверява, трябва да се ревюира, трябва да се сменят паролите. Имахме случай, когато ни предоставиха услуга, там админ панелът беше „if login == ‘admin’ && password == ‘admin’...“, написано направо в кода. Седим и се чудим, и това го пишат хора през 2018 година?
Тестването на обема на хранилището също е необходимо. Трябва да се види какво ще стане при сто хиляди записа, преди да пуснете услугата в продукция.
Не трябва да се чувствате неудобно да изпращате услугата за доработка. Когато кажете: „Тази услуга няма да я приемем, имаме 20 задачи, направете ги, тогава ще я приемем“, това е абсолютно нормално. Съвестта не трябва да боли, че ще поставите мениджър в трудна ситуация или че бизнесът ще похарчи пари. Впоследствие бизнесът ще похарчи повече.
Имахме случай, когато решихме да направим пилотен проект на аутсорсинг.
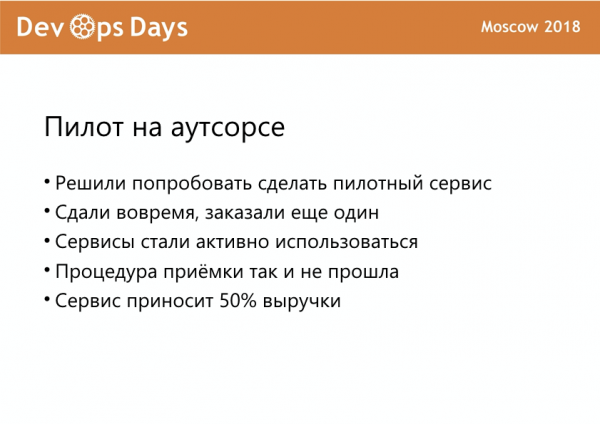
Той беше предаден навреме, и това беше единственият критерий за качество. Затова направиха още един пилотен проект, вече дори не съвсем пилотен. Тези услуги бяха приети, административно заявиха, ето вашия код, ето екипа, ето вашия мениджър. Услугите наистина започнаха да генерират печалба. Въпреки това, по факто, те останаха все същите сираци, никой не разбира как работят, а мениджърите всячески се отклоняват от техните задачи.
Има още едно страхотно понятие — партизанска разработка. Когато някой отдел, обикновено това е отдел маркетинг, искат да тестват хипотеза и поръчват услугата изцяло на аутсорс. Трафикът започва да тече, те затварят документи, подписват актове с подизпълнителя, въвеждат я в експлоатация и казват: «Хлапета, имаме услуга, вече има трафик, носи ни пари, давайте да я приемем». Ние сме като: «Опа, как така».
И още един начин за получаване на услугата-сирота: когато някой екип изведнъж се окаже натоварен, ръководството казва: «Да предадем услугата на този екип на друг екип, той има по-малко натоварване». А след това предаваме на третия екип и сменяме мениджъра. И накрая отново имаме сираче.
В какво е проблемът със сираците?
Кой не знае, това е издигнатият в Швеция линейен кораб Wasa, знаменит с това, че е затънал пет минути след спускането на вода. А шведският крал, между другото, никого за това не е екзекутирал. Той се строел от две поколения инженери, които не умеят да строят такива кораби. Логичен ефект.
Корабът можеше да затъне, между другото, много по-лошо, например, когато на него вече е пътувал кралят някъде в буря. А така, затъна незабавно, по аджайл това е добре — провалете се рано.
Ако сме се провалили рано, обикновено проблеми няма. Например, по време на приемането го изпратихме за доработка. А ако сме се провалили вече в продукцията, когато са вложени пари, тогава могат да възникнат проблеми. Последствията, както ги наричат в бизнеса.
С какво са опасни услугите-сираци:
- Услугата може да се счупи внезапно.
- Услугата се поправя дълго или изобщо не се поправя.
- Проблеми с безопасността.
- Проблеми с доработките и обновленията.
- Ако се повреди важна услуга, страда репутацията на компанията.
Какво да правим с услугите-сираци?
Още веднъж ще повторя какво трябва да се направи. Първо, трябва да има документация. 7 години в Banki.ru ме научиха, че тестерите не трябва да вярват на думите на разработчиците, а експлоатацията не трябва да вярва на никого. Трябва да проверяваме.
На второ място, трябва да се пишат схеми за взаимодействие, защото понякога може да се окаже, че услугите, които не се приемат особено добре, имат зависимости, за които никой не е споменал. Например, разработчиците са свързали услугата с ключа си за някаква Яндекс.Карта или Dadata. Ако ви свърши безплатният лимит, всичко се счупва и не знаете какво е станало. Всички тези проблеми трябва да бъдат описани: в услугата се използва Dadata, Sms, нещо друго.
На трето място, работата с техническия дълг. Когато правите някакви импровизации или приемате услуга и казвате, че нещо трябва да се направи, трябва да следите за това да се направи. Защото после може да се окаже, че малка ямка не е толкова малка и вие ще паднете в нея.
С архитектурните задачи имаме история, свързана със Sphinx. В една от услугите Sphinx се използваше за въвеждане на списъци. Просто списък с пагинация, но той се реиндексиреше всяка нощ. Съставен беше от два индекса: един, който се реиндексиреше всяка нощ и още един малък индекс, който се прикрепяше към него. Всеки ден, с вероятност 50%, или нещата се счупваха, или не, при публикуването индексът се повреждаше и новините спираха да се обновяват на главната страница. Първоначално това отнемаше 5 минути, докато индексът се реиндексира, след това индексът нарасна и в един момент започна да се реиндексира 40 минути. Когато го отстранихме, дишахме с облекчение, защото беше ясно, че след малко време индексът ще се реиндексира през целия работен ден. Това ще е провал за нашия портал, осем часа без новини — всичко, бизнесът спира.
План за работа с изоставена услуга
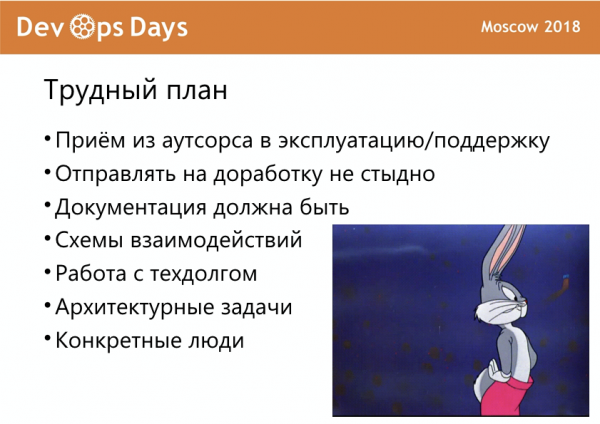
Всъщност, това е много трудно, защото DevOps е за комуникация. Иска се да бъдете в добри отношения с колегите си, а когато зашлевявате колеги и мениджъри с правила по главите, те могат да изпитват противоречиви чувства към хората, които правят така.
Освен всичките тези точки, има още нещо важно: за всяка конкретна услуга, за всяка конкретна част от процеса на деплой, трябва да отговарят конкретни хора. Когато няма хора и трябва да се привлекат други, за да се изучи всичко това, става трудно.
Ако всичко това не е помогнало и сервизът-сирота все още е сирота, никой не иска да го вземе, документацията не се пише, екипът, който е бил привлечен към този сервиз, отказва да прави нещо, има един прост начин — да се преработи всичко.
Тоест, вие вземате изискванията за услугата отново и пишете нова услуга, по-добра, на по-добра платформа, без странни технологични решения. И мигрирате към нея в бой.
Имахме ситуация, когато взехме услуга на Yii 1 и осъзнахме, че не можем да я развиваме, защото изчерпахме разработчиците, които могат добре да пишат на Yii 1. Всички разработчици пишат добре на трето Symfony. Какво да правим? Определихме време, определихме екип, определихме мениджър, пренаписахме проекта и плавно прехвърлихме трафика към него.
След това старият сервиз може да бъде премахнат. Това е любимата ми процедура, когато от системата за управление на конфигурации трябва да вземеш и да изчистиш някакъв сервиз и след това да прегледаш, за да видиш, че всички инстанции на продукцията са погасени, за да няма следи у разработчиците. Репозиторият в git остава.
Това е всичко, което исках да споделя, готов съм да дискутирам, темата е холиварна, много хора се заплитат в нея.
На слайдовете беше споменато, че сте унифицирали езиците. Като пример беше ресайзинг на картинки. Но необходимо ли е наистина да се привържем към един език? Защото ресайзинг на изображение на PHP, всъщност можеше да се направи и на Golang.
Всъщност, това не е задължително, както и всички практики. Може би, в някои случаи, дори не е желателно. Но трябва да разберете, че ако в компанията ви има 50 души от техническия отдел, от които 45 са PHP разработчици, и 3 са девопси, които умеят Python, Ansible, Puppet и нещо такова, и само един пише услуга на Go за ресайз на изображения, то когато той напусне, експертизата си отива с него. И в същото време ще трябва да търсите специфичен разработчик на пазара, който знае този език, особено ако той е рядък. Тоест, от организационна гледна точка, това е проблемно. От гледна точка на девопса, не просто ще ви е необходимо да клонирате готов набор от плейбуци, които използвате за разгръщане на услуги, а ще трябва да ги напишете отново.
В момента разработваме услуга на Node.js, и това ще бъде площадка за всеки разработчик с отделен език. Но се замислихме, че играта си струва. Тоест, тук е въпрос на размисъл.
Как мониторите вашите услуги? Как събирате и проследявате логовете?
Логовете ги събираме в Elasticsearch и ги поставяме в Kibana, а в зависимост от това дали е продукционна или тестова среда, там се използват различни събирачи. Някъде Lumberjack, някъде нещо друго, вече не помня. И има места в определени услуги, където поставяме Telegraf и го изпращаме някъде отделно.
Как да живеем с Puppet и Ansible в една среда?
Всъщност, в момента имаме две среди, едната е Puppet, а другата Ansible. Работим върху това да ги хибридизираме. Ansible е добра среда за първоначална настройка, Puppet - това е лошо нещо за първоначална настройка, защото изисква работа ръчно на площадката, а Puppet осигурява сходство на конфигурацията. Това означава, че площадката сама се поддържа в актуално състояние, а за да се поддържа ansibiliziranata машина в актуално състояние, трябва постоянно да се изпълняват плейбуци с някаква периодичност. Ето такава е разликата.
Как поддържате съвместимост? Имате конфигурации и в Ansible, и в Puppet?
Това е нашата голяма болка, поддържаме съвместимост ръчно и се опитваме да намерим начин как да преминем от всичко това. Излиза, че Puppet инсталира пакети и поддържа някакви връзки, а Ansible, например, инсталира код и адаптира свежи конфигурации на приложенията.
В презентацията беше за различни версии на Ruby. Какво решение?
Сблъскахме се с това на едно място и постоянно трябва да го имаме предвид. Просто изключихме частта, която работеше на този Ruby, който не беше съвместим с приложенията, и я държахме отделно.
Тази година конференцията ще се проведе на 7 декември в 'Технополис'. До 11 ноември приемаме предложения за доклади. ни, ако искате да говорите.
Регистрацията за участниците е отворена, присъединете се!
Източник: habr.com
