

Облаците са като магическа кутия — казваш какво ти трябва и ресурсите просто се появяват от нищото. Виртуални машини, бази данни, мрежа — всичко това принадлежи само на теб. Има и други тенанти в облака, но в своята Вселена ти си единственият владетел. Уверен си, че винаги ще получиш необходимите ресурси, не отговаряш на никого и сам определяш как ще изглежда мрежата. Как точно работи тази магия, която кара облака еластично да разпределя ресурси и напълно да изолира тенантите един от друг?
Облакът AWS е мегасуперсложна система, която еволюира от 2006 година. Част от това развитие е Василий Пантюхин — архитект на Amazon Web Services. Като архитект той вижда не само крайния резултат, но и трудностите, които AWS преодолява. Колкото повече разбиране за работата на системата, толкова повече доверие. Затова Василий ще сподели тайните на облачните услуги на AWS. Под кат искаме да споделим устройството на физическите сървъри на AWS, еластичната мащабируемост на БД, персонализираната база данни на Amazon и методи за увеличаване на производителността на виртуалните машини, докато намаляваме цената им. Знанието за архитектурните подходи на Amazon ще помогне по-ефективно да използвате услугите на AWS и, възможно, ще даде нови идеи за изграждане на собствени решения.
За говорителя: Василий Пантюхин () започна като Unix админ в .ru компании, 6 години работи с големи железа на Sun Microsystems, 11 години проповядваше дата центрирането на света в EMC. По естествен път еволюира към частни облаци, а през 2017 се впусна в публични. Сега с технически съвети помага на хората да живеят и да се развиват в облака AWS.
Дисклеймер: всичко, което следва — е лично мнение на Василий и може да не съвпада с позицията на Amazon Web Services. на доклада, на базата на който е написана статията, е наличен на нашия YouTube канал.
Защо разказвам за устройството на Amazon
Първата ми кола беше с „ръчка“ — на механична предавателна кутия. Това беше прекрасно, защото даваше усещането, че мога да управлявам колата и напълно контролирам нея. Харесваше ми, че поне горе-долу разбирам принципа на работа. Естествено, представях си устройството на кутията доста примитивно — нещо като предавателната кутия на велосипед.
Всичко беше прекрасно, освен едно — чакането в задръствания. Седиш и нищо не правиш, но постоянно сменяш предавките, натискаш съединителя, газта, спирачките — от това наистина се уморяваш. Проблемът с задръстванията частично се реши, когато в семейството се появи кола с автоматична скоростна кутия. Зад волана имаш време да помислиш за нещо, да слушаш аудиокнига.
В живота ми се появи и загадка, защото изобщо престанах да разбирам как работи колата ми. Съвременният автомобил е сложна машина. Колата се адаптира едновременно към десетки различни параметри: натискане на газта, спирачките, стил на шофиране, качество на пътя. Вече не разбирам как това работи.
Когато започнах да се занимавам с облака на Amazon, за мен това също беше тайна. Само че тази тайна е на много по-високо ниво, защото в колата има един шофьор, а в AWS те са милиони. Всички потребители едновременно управляват, натискат газта и спирачките. Учудващо е, че те отиват, където искат — за мен това е чудо! Системата автоматично се адаптира, мащабира и еластично се нагажда към всеки потребител, така че му се струва, че е единствен в тази Вселена.
Магията малко се развея, когато по-късно дойдох да работя като архитект в Amazon. Видях с какви проблеми се сблъскваме, как ги решаваме, как развиваме услугите. С нарастващото разбиране за работата на системата идва и по-голямо доверие в услугата. Затова искам да споделя картината на това, какво има под капака на облака AWS.
За какво ще говорим
Избрах диверсифициран подход — подбрах 4 интересни услуги, за които си струва да поговорим.
Оптимизация на сървъри. Ефемерни облаци с физическо присъствие: физически датацентрове, където стоят физически сървъри, които шумят, загряват се и мига лампички.
Сървис без сървърни функции (Lambda) — вероятно най-мащабируемата услуга в облака.
Мащабиране на база данни. Ще поговоря за това как построяваме собствените си мащабируеми БД.
Мащабиране на мрежата. Последната част, в която ще разкрия устройството на нашата мрежа. Това е чудесна работа — всеки потребител на облака смята, че е единствен в облака и изобщо не вижда другите наематели.
Забележка. В тази статия ще говорим за оптимизация на сървъри и мащабиране на бази данни. Мащабирането на мрежата ще разгледаме в следващата статия. А какво става със serverless функциите? За тях излезе отделно обяснение "В него се разказва за няколко различни начина за мащабиране и подробно се разглежда решението Firecracker – симбиоза на най-добрите качества на виртуални машини и контейнери.
Сървъри
Облакът е ефимерен. Но тази ефемерност все пак има физическо проявление – сървъри. Първоначално тяхната архитектура беше класическа. Стандартен x86 чипсет, мрежови карти, Linux, хипервизор Xen, на който работеха виртуалните машини.
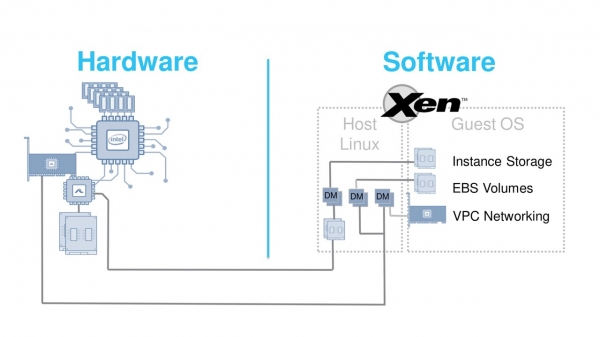
През 2012 година такава архитектура напълно покриваше поставените задачи. Xen – отличен хипервизор, но с един сериозен недостатък. Той има достатъчно високи разходи за емулация на устройства. С появата на нови, по-бързи мрежови карти или SSD дискове тези разходи стават твърде високи. Как да се справим с този проблем? Решихме да работим едновременно по два фронта – оптимизиране и на хардуера, и на хипервизора. Задачата е много сериозна.
Оптимизиране на хардуера и хипервизора
Не е възможно да направим всичко наведнъж и перфектно. Какво означава "перфектно" също не беше ясна идея.
Решихме да приложим еволюционен подход – променяме един важен елемент в архитектурата и го пускаме в продукция.
Настъпваме на всички грабли, слушаме оплаквания и предложения. След това променяме друга компонента. Така, с малки инкременти, коренно променяме цялата архитектура на базата на обратна връзка от потребителите и поддръжката.
Преобразуването започна през 2013 г. с най-сложната част – мрежата. В C3 инстанциите към стандартната мрежова карта добавиха специална карта Network Accelerator. Тя се свързваше буквално с къс loopback кабел на предния панел. Не е красиво, но в облака не се вижда. Затова пряката връзка с хардуера принципно подобри jitter и пропускната способност на мрежата.
След това решихме да се заемем с подобряване на достъпа до блочното съхранение на данни EBS – Elastic Block Storage. Това е комбинация от мрежа и хранилище. Сложността е, че ако на пазара съществуваха карти Network Accelerator, възможността просто да се купи хардуер Storage Accelerator я нямаше. Затова се обърнахме към стартъп Annapurna Labs, който разработи специализирани ASIC чипове за нас. Те позволиха да свързваме отдалечени томове EBS като NVMe устройства.
В инстансите C4 решихме две задачи. Първата — да реализираме бъдеща, но нова по това време, технология NVMe. Втората — значително разтоварихме централния процесор, като прехвърлихме обработката на заявките към EBS на новата карта. Успя успешно, затова сега Annapurna Labs е част от Amazon.
Към ноември 2017 г. разбрахме, че е време да сменим и самия хипервизор.
Новият хипервизор е разработен на основата на доработени модули на KVM ядрото.
Той принципиално намалява разходите за емулация на устройства и позволява директна работа с новите ASIC. Инстансите C5 бяха първите виртуалки, в които работи новият хипервизор. Ние го нарекохме Nitro.
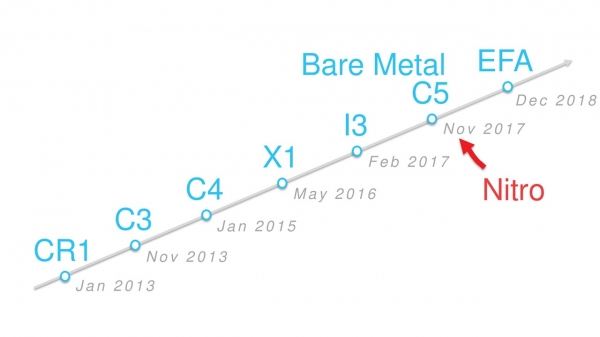 Еволюция на инстансите по времева ос.
Всички нови типове виртуални машини, които се появиха от ноември 2017, работят на този хипервизор. При физическите Bare Metal инстанси няма хипервизор, но също така се наричат Nitro, тъй като използват специализирани Nitro карти.
През следващите две години броят на типовете Nitro инстанси надхвърли няколко десетки: A1, C5, M5, T3 и други.
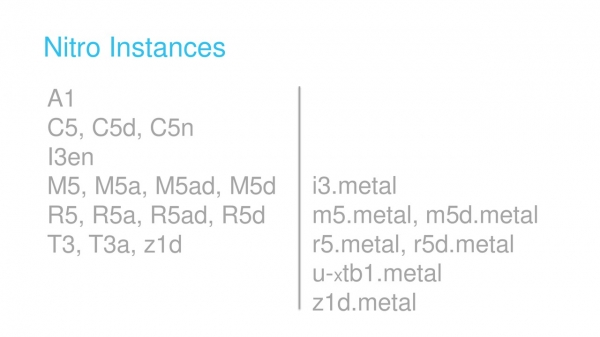
Типове инстанси.
Как са изградени съвременните Nitro машини
Те имат три основни компонента: Nitro хипервизор (за който споменахме по-горе), чип за сигурност и Nitro карти.
Чипът за сигурност е интегриран направо в дънната платка. Той контролира множество важни функции, например, контрол на зареждането на хост операционната система.
Nitro картите — съществуват четири типа. Всички те са разработени от Annapurna Labs и базирани на общи ASIC. Част от техния фърмуер също е общ.
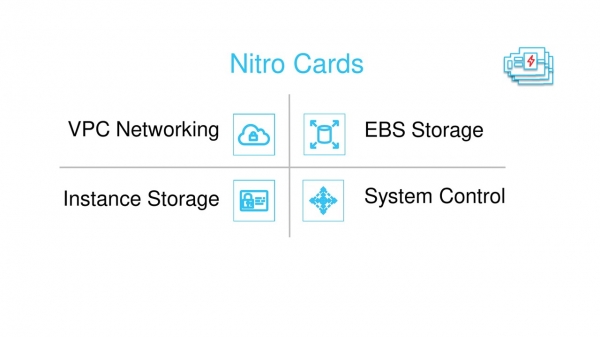
Четири типа Nitro карти.
Една от картите е предназначена за работа с мрежата.VPCТова е картата, която се вижда във виртуалките като мрежова карта ENA — Elastic Network Adaptor. Освен това, тя инкапсулира трафика, когато го предава през физическата мрежа (за това ще говорим във втората част на статията), контролира фаервола Security Groups, отговаря за маршрутизацията и други мрежови функции.
Отделни карти работят с блочно съхранение EBS и дисковете, които са вградени в сървъра. За гостовата виртуалка те се представят като NVMe адаптери.Те също така отговарят за криптиране на данните и мониторинг на дисковете.
Системата Nitro карти, хипервизор и чип за сигурност е обединена в SDN мрежа или Software Defined Network. За управлението на тази мрежа (Control Plane) отговаря контролер на картата.
Разбира се, продължаваме разработката на нови ASIC. Например, в края на 2018 г. пуснахме чипа Inferentia, който позволява по-ефективно да се работи с задачи за машинно обучение.
Чип Inferentia за машинно обучение.
Мащабируема база данни
Традиционната база данни има слойна структура. Ако много опростим, можем да различим следните нива.
- SQL — на него работят мениджърите на клиенти и заявки.
- Осигуряване на транзакции — тук всичко е ясно, ACID и всичко такова.
- Кеширане, което се осигурява от буферни пулове.
- Логиране — осигурява работа с redo-логове. В MySQL те се наричат Bin Logs, в PostgreSQL — Write Ahead Logs (WAL).
- Хранение – непосредствено запис на диска.
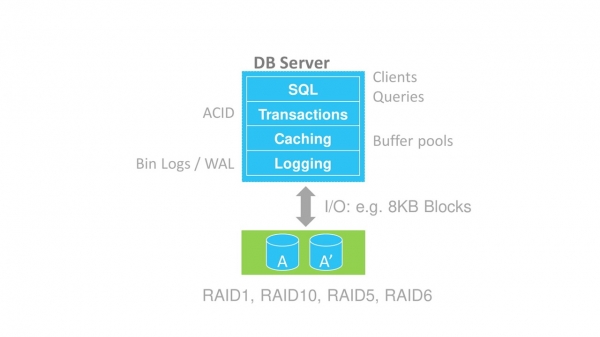
Слойна структура на базата данни.
Съществуват различни методи за мащабиране на бази данни: шардиринг, архитектура Shared Nothing, споделени дискове.
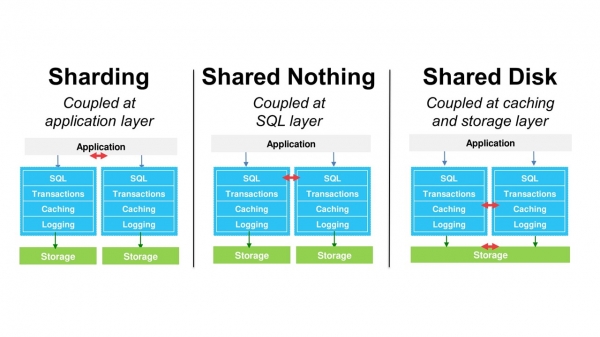
Въпреки това, всички тези методи запазват същата монолитна структура на базата данни. Това значително ограничава мащабирането. За да решим този проблем, разработихме собствена БД — Amazon Aurora. Тя е съвместима с MySQL и PostgreSQL.
Amazon Aurora
Основната архитектурна идея е да се отделят нивата на съхранение и логиране от основната база данни.
Предварително ще спомена, че нивото на кеширане също направихме независимо. Архитектурата спира да бъде монолитна и получаваме допълнителни степени на свобода в мащабирането на отделни блокове.
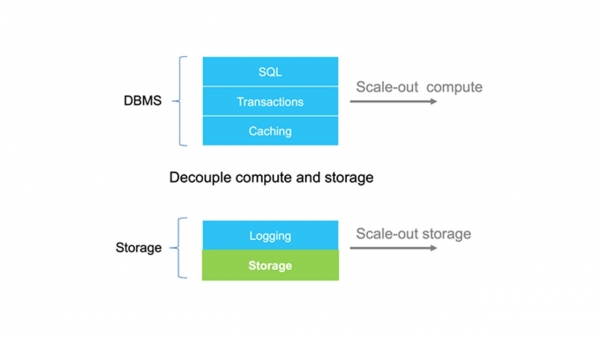
Нивата на логиране и съхранение са отделени от базата данни.
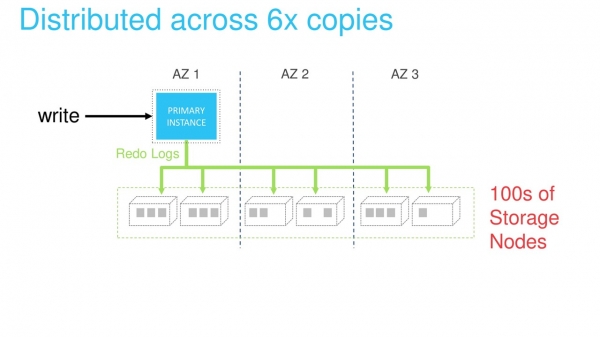
Традиционната СУБД записва данни в системата за съхранение под формата на блокове. В Amazon Aurora създадохме „умно“ хранилище, което може да разговаря на езика redo-логове. Вътре в себе си хранилището превръща логовете в блокове данни, следи за тяхната целостност и автоматично ги архивира.
Този подход позволява да се реализират интересни неща като клониране. То работи принципно по-бързо и по-икономично, защото не изисква създаване на пълна копия на всичките данни.
Нивото на съхранение е реализирано като разпределена система. Тя се състои от много физически сървъри. Всеки redo-лог се обработва и съхранява едновременно от шест узла. Това осигурява защита на данните и разпределение на натоварването.
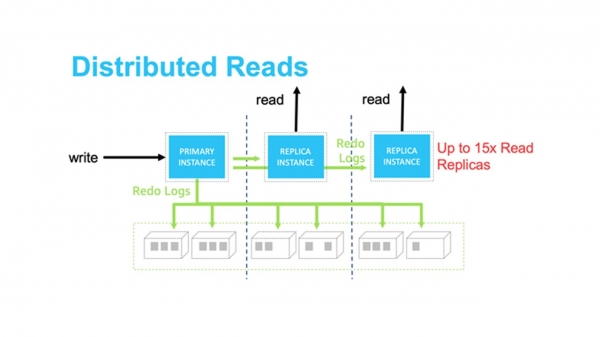
Четенето и мащабиране може да бъде осигурено с подходящи реплики. Разпределеното хранилище елиминира необходимостта от синхронизация между основния инстанс на БД, чрез който записваме данни, и останалите реплики. Актуалните данни са гарантирано достъпни за всички реплики.
Единствената проблема е кеширането на стари данни на репликите за четене. Но тази задача може да бъде решена чрез предаване на всички redo логове към репликите по вътрешна мрежа. Ако логът е в кеша, той се маркира като некоректен и се презаписва. Ако го няма в кеша, просто се отхвърля.
С хранилището приключихме.
Как да мащабираме нива на СУБД
Тук хоризонталното мащабиране е много по-сложно. Затова ще следваме утъпкания път на класическото вертикално мащабиране..
Да предположим, че имаме приложение, което комуникира с СУБД чрез майстор-нод.
При вертикалното мащабиране назначаваме нов нод, който ще има повече процесори и памет.
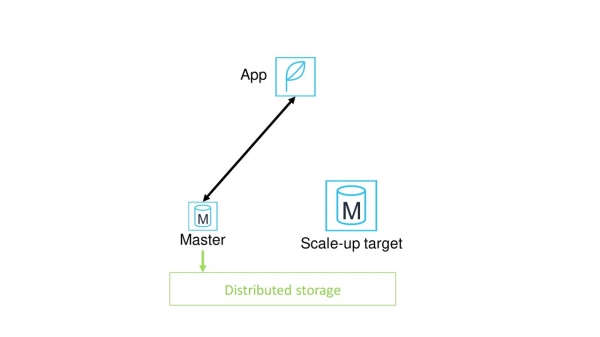
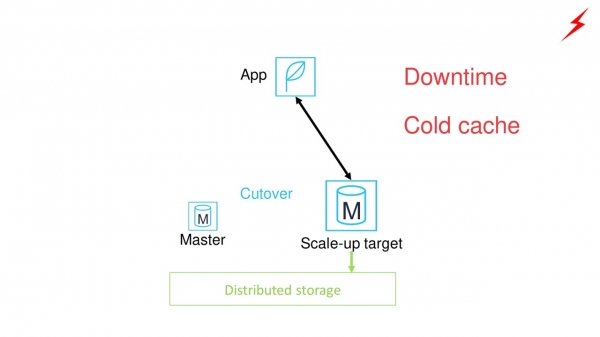
След това прехвърляме приложението от стария майстор-нод на новия. Появяват се проблеми.
- Това ще изисква значително време на престой на приложението.
- Новият майстор-нод ще има студен кеш. Производителността на БД ще бъде максимална само след затопляне на кеша.
Как можем да подобрим ситуацията? Да сложим прокси между приложението и майстор-нод.
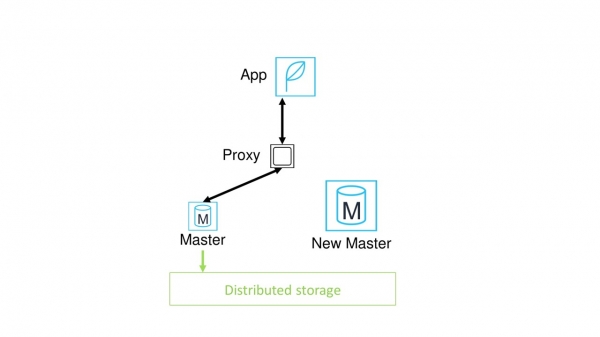
Какво ще ни даде това? Сега не е необходимо ръчно да пренасочваме всички приложения към новия нод. Превключването може да се извърши под проксито и е принципно по-бързо.
Изглежда, че проблемът е решен. Но не, все още страдаме от необходимостта да затопляме кеша. Освен това, възниква нов проблем – сега проксито е потенциална точка на отказ.
Крайната ни решение с Amazon Aurora serverless
Как решихме тези проблеми?
Оставихме прокси. Това не е отделен инстанс, а цял разпределен флот от проксита, през които приложенията се свързват с БД. Всяка от нодовете в случай на отказ може да бъде заменена почти мигновено.
Добавихме пул от топли нодове с различен размер. Затова, в случай на необходимост от нова нод с по-голям или по-малък размер, тя е незабавно налична. Не е необходимо да чакаме да се зареди.
Целият процес на мащабиране се контролира от специализирана система за мониторинг. Мониторинг постоянно следи състоянието на текущата мастер-нода. Ако установи, например, че натоварването на процесора е достигнало критична стойност, уведомява пулът от топли инстанси за необходимостта от отделяне на нова нода.
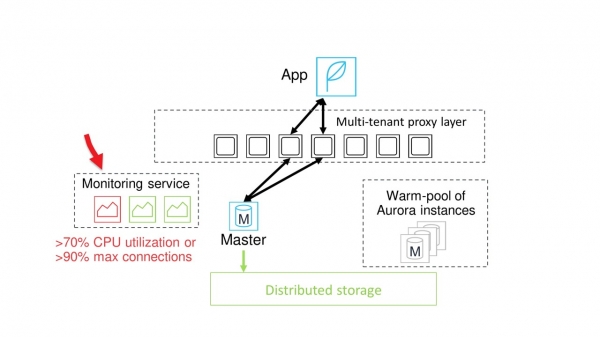
Разпределени проксита, топли инстанси и мониторинг.
Нодата с необходимата мощност е налична. Към нея се копират буферните пулове и системата започва да изчаква безопасен момент за превключване.
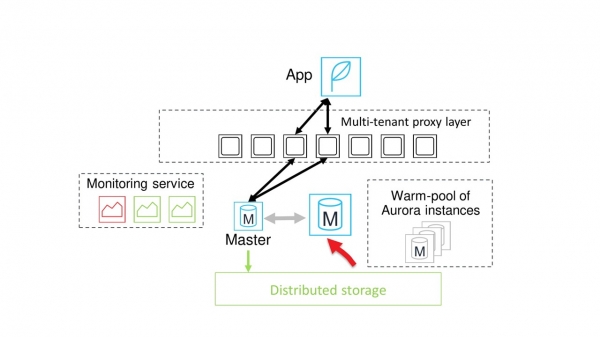
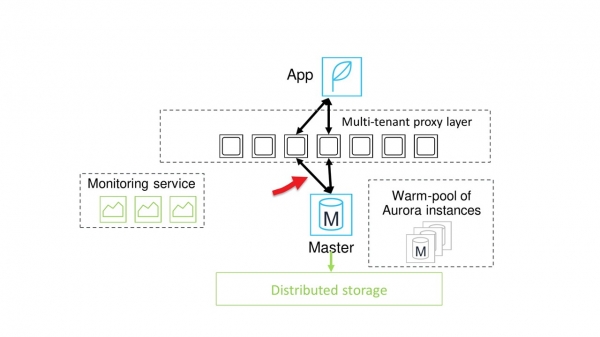
Обикновено моментът за превключване настъпва достатъчно бързо. Тогава комуникацията между проксито и старата мастер-нода се прекъсва, всички сесии се превключват на новата нода.
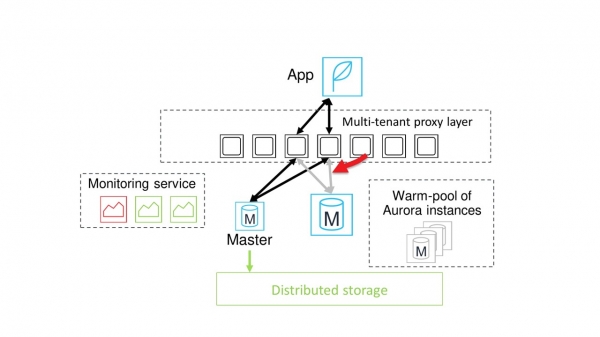
Работата с базата данни се възобновява.
На графиката се вижда, че прекъсването е наистина много кратко. На синята графика е натоварването, а на червените стъпки — моментите на мащабиране. Кратковременните спадове в синята графика са точно тази кратка задръжка.
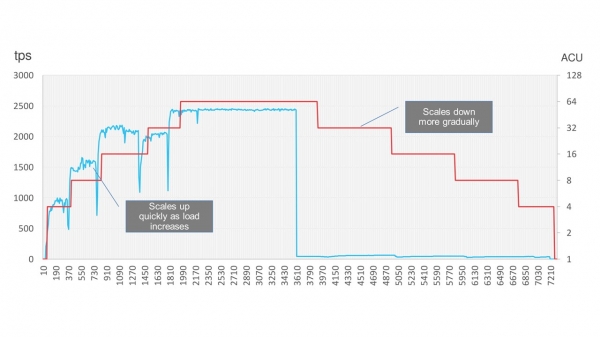
Между другото, Amazon Aurora позволява значителни икономии, като изключва базата данни, когато не се използва, например, през уикенда. След спирането натоварването на базата данни постепенно намалява и за известно време се изключва. Когато натоварването се върне, тя отново плавно се увеличава.
В следващата част от разказа за устройството на Amazon ще поговорим за мащабирането на мрежата. Абонирайте се и следете обновленията, за да не пропуснете статията.
На Василий Пантюхин ще изнесе доклад "". Какви модели на проектиране на разпределени системи използват разработчиците на Amazon, какви могат да бъдат причините за отказ на услугите, какво е Cell-based architecture, Constant Work, Shuffle Sharding — ще бъде интересно. Остават по-малко от месец до конференцията — . 24 октомври е окончателното повишаване на цените.
Източник: habr.com
