

В тази статия ще разгледаме теоретичните изводи от преобразуването функцията на линейната регресия в функцията на обратното логит-преобразуване (или иначе казано, функцията на логистичния отговор). След това, използвайки арсенала на метода на максималната вероятност, в съответствие с модела на логистичната регресия, ще изведем функцията на загубите Logistic Loss, или с други думи, ще определим функция, с която в модела на логистичната регресия се подбират параметрите на вектора с тегла  .
План на статията:
- Нека припомним за линейната зависимост между две променливи
- Ще установим необходимостта от преобразуването функцията на линейната регресия
 в функцията на логистичния отговор
- Ще извършим преобразувания и ще изведем функцията на логистичния отговор
- Ще се опитаме да разберем какво е лошото в метода на най-малките квадрати при подбора на параметрите функции Logistic Loss
- Използваме метод на максималната вероятност за определяне функцията за подбор на параметри :
5.1. Случай 1: функция Logistic Loss за обекти с обозначения на класове 0 и 1:
5.2. Случай 2: функция Logistic Loss за обекти с обозначения на класове -1 и +1:
 в функцията на логистичния отговор

 функции Logistic Loss
 :


Статията изобилства от прости примери, в които всички изчисления лесно могат да бъдат направени устно или на хартия, но в някои случаи може да се наложи калкулатор. Така че се подгответе 🙂
Тази статия е главно насочена към дата учени с основни познания в основите на машинното обучение.
В статията ще бъде предоставен код за визуализиране на графики и изчисления. Целият код е написан на езика python 2.7. Предварително ще поясня относно "новизната" на използваната версия — такова е едно от условията за преминаване на известния курс от Яндекс на не по-малко известната интернет платформа за онлайн образование Coursera, и както може да се предположи, материалът е подготвен по мотиви на този курс.
01. Линейна зависимост
Напълно резонно е да се зададе въпросът — каква връзка има тук линейната зависимост и логистичната регресия?
Всичко е просто! Логистичната регресия представлява един от моделите, които принадлежат на линейния класификатор. С други думи, задачата на линейния класификатор е да предскаже целевите стойности  от променливите (регресори)
 . При това се приема, че зависимостта между признаците
 и целевите стойности
 е линейна. Оттук и самото название на класификатора — линейен. Ако много грубо обобщим, основното предположение на модела на логистичната регресия е наличието на линейна зависимост между признаците
 и целевите стойности
 . Ето я — връзката.
В студия на първия пример и той, разбира се, е за праволинейната зависимост на изследваните величини. По време на подготовката на статията, се натъкнах на пример, който вече е доста познат — зависимостта на тока от напрежението („Прикладен регресионен анализ“, Н.Дрейпер, Г.Смит). Тук също ще го разгледаме.
В съответствие с Законът на Ома:
 , където
 — ток,
 — напрежение,
 — съпротивление.
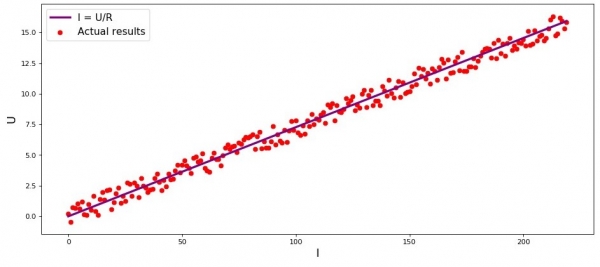
Ако не знаехме закона на Ома, бихме могли да открием зависимостта емпирично, променяйки  и измервайки
 , като запазваме
 фиксирано. Тогава бихме видели, че графикът на зависимостта
 от
 дава повече или по-малко права линия, преминаваща през началото на координатната система. Казваме „повече или по-малко“, тъй като, въпреки че зависимостта е фактически точна, нашите измервания могат да съдържат малки грешки и следователно точките на графика може да не попаднат точно на линията, а да бъдат разположени около нея произволно.
График 1 „Зависимостта  от
 »
Код за рисуване на график
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Актуални резултати')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Необходимост от преобразувания на уравнението на линейната регресия
Нека разгледаме поредния пример. Представим си, че работим в банка и пред нас е задачата да определим вероятността за връщане на кредита от заемателя в зависимост от някои фактори. За опростяване на задачата, ще разгледаме само два фактора: месечната заплата на заемателя и месечният размер на плащането по кредита.
Задачата е много условна, но с този пример ще можем да разберем защо за решаването й не е достатъчно прилагането на функцията на линейната регресия, а също така ще научим какви преобразувания на функцията трябва да бъдат извършени.
Връщаме се към примера. Ясно е, че колкото по-висока е заплатата, толкова повече заемателят може да предоставя месечно за погасяване на кредита. В същото време, за определен диапазон от заплати, тази зависимост ще бъде напълно линейна. Например, да вземем диапазона на заплатите от 60,000лв до 200,000лв и да предположим, че в посочения диапазон заплатите, зависимостта между размера на месечния платеж и заплатата е линейна. Да предположим, че за посочения диапазон заплати е установено, че съотношението между заплатата и плащането не може да пада под 3 и на заемателя трябва да му остават 5,000лв. И само в този случай ще приемем, че заемателят ще върне кредита на банката. Тогава, уравнението на линейната регресия ще приеме следния вид:

където  ,
 ,
 ,
 — заплата
 -ия заемател,
 — плащане по кредита
 -ия заемател.
Подставяйки в уравнението заплатата и плащането по кредита с фиксирани параметри  можем да вземем решение за одобрение или отказ на кредита.
За да не изпреварваме събитията, отбележим, че при зададени параметри  функцията на линейната регресия, използвана в функцията на логистичен отговор ще предостави големи стойности, които затрудняват изчисленията за определяне на вероятностите за погасяване на кредита. Затова се предлага да намалим нашите коефициенти, да кажем, с 25,000 пъти. От това преобразуване в коефициентите, решението за одобрение на кредита няма да се промени. Нека запомним този момент за по-късно, а сега, за да бъде още по-ясно, за какво става въпрос, да разгледаме ситуацията с трима потенциални заематели.
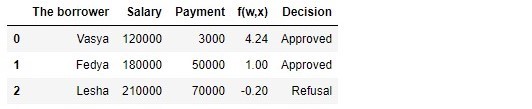
Таблица 1 "Потенциални заематели"
Код за генериране на таблицата
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Заемателят':np.array(['Вася', 'Федя', 'Леша']),
        'Заплата':np.array([120000,180000,210000]),
       'Плащане':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Заплата']*w_1 + df['Плащане']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Одобрено'
        decision.append(dec)
    else:
        dec = 'Отказ'
        decision.append(dec)

df['Решение'] = decision

df[['Заемателят', 'Заплата', 'Плащане', 'f(w,x)', 'Решение']]
Според данните от таблицата, Вася с заплата от 120,000лв иска да получи кредит, който да погаси с месечно плащане от 3,000лв. Определили сме, че за одобрение на кредита, размерът на заплатата на Вася трябва да надвишава три пъти размера на плащането и да му останат 5,000лв. На това изискване Вася отговаря:  . Остава дори 106.000Р. Въпреки че при изчислението
 намалихме коефициентите
 в 25.000 пъти, получихме същия резултат — кредитът може да бъде одобрен. Федя също ще получи кредит, а на Леша, въпреки че той получава най-много, ще му се наложи да смекчи амбициите си.
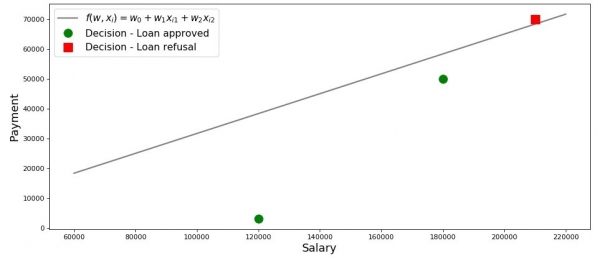
Нека нарисуваме график за този случай.
График 2 «Класификация на заемателите»
Код за рисуване на графика
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Решение - Кредит одобрен')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Решение - Кредит отказан')
plt.xlabel('Заплата', size = 16)
plt.ylabel('Плащане', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
И така, нашата линия, построена в съответствие с функцията  , разделя „лошите“ заематели от „добрите“. Тези заематели, чийто желания не съвпадат с възможностите, се намират над линията (Леша), а тези, които могат според параметрите на нашия модел да върнат кредита, са под линията (Вася и Федя). С други думи, нашата линия разделя заемателите на два класа. Нека ги обозначим по следния начин: за класа
 ще отнесем тези заематели, които най-вероятно ще върнат кредита, а за класа
 или
 ще отнесем тези заематели, които най-вероятно няма да могат да върнат кредита.
Обобщим изводите от този простичък пример. Нека вземем точка  и, подставяйки координатите на точката в съответното уравнение на линията
 , ще разгледаме три варианта:
- Ако точката е под линията, и я отнасяме към класа , стойността на функцията ще бъде положителна от до . Значи можем да считаме, че вероятността за погасяване на кредита попада в пределите . Колкото по-голяма е стойността на функцията, толкова по-висока е вероятността.
- Ако точката е над линията и я отнасяме към класа или , то стойността на функцията ще бъде отрицателна от до . Тогава ще считаме, че вероятността за погасяване на дълга попада в пределите и, колкото по-голяма по модул стойността на функцията, толкова по-висока е нашата увереност.
- Точката е на линията, на границата между двата класа. В този случай стойността на функцията ще бъде равна на и вероятността за погасяване на кредита е равна на .
 , стойността на функцията
 ще бъде положителна от
 до
 . Значи можем да считаме, че вероятността за погасяване на кредита попада в пределите
 . Колкото по-голяма е стойността на функцията, толкова по-висока е вероятността.
 или
 , то стойността на функцията ще бъде отрицателна от
 до
 . Тогава ще считаме, че вероятността за погасяване на дълга попада в пределите
 и, колкото по-голяма по модул стойността на функцията, толкова по-висока е нашата увереност.
 ще бъде равна на
 и вероятността за погасяване на кредита е равна на
 .
Сега, представете си, че имаме не два фактора, а десетки, заемателите не са три, а хиляди. Тогава вместо линия ще имаме m-мерна плоскост и коефициенти  данните няма да бъдат взети от тавана, а ще бъдат извлечени по всички правила, базирани на натрупаните данни за заемателите, които са върнали или не са върнали кредита. И наистина, забележете, в момента избираме заематели при вече известни коефициенти
 . Всъщност, задачата на модела на логистична регресия е точно да определи параметрите
 , при които стойността на функцията на загубите Logistic Loss ще се стреми към минимално. Но как се изчислява векторът
 , ще научим в 5-та част на статията. А сега да се върнем обратно - при нашия банков сътрудник и тримата му клиенти.
Благодарение на функцията  знаем на кого може да се даде кредит и на кого трябва да се откаже. Но с такава информация не можем да отидем при директора, тъй като от нас искаха да получат вероятността за връщане на кредита от всеки заемател. Какво да правим? Отговорът е прост - трябва да преобразуваме функцията
 , стойностите на която лежат в диапазона
 в стойности, които ще лежат в диапазона
 . И такава функция съществува, нарича се функция на логистичния отговор или обратното логит преобразуване. Запознайте се:

Нека видим стъпките, по които се получава функцията на логистичния отговор. Нека отбележим, че ще вървим в обратна посока, т.е. ще предположим, че знаем стойността на вероятността, която е в пределите от  до
 , а след това ще "развием" тази стойност на цялата територия от
 до
 .
03. Извеждаме функцията на логистичния отговор
Стъпка 1. Преобразуваме стойностите на вероятността в диапазона

За времето на трансформацията на функцията  в функцията на логистичния отговор
 оставяме на мира нашия кредитен аналитик, а вместо това ще се разходим по букмейкърските кантори. Не, разбира се, няма да правим залози, всичко, което ни интересува там, е смисълът на израза, например, шанс 4 на 1. Шансовете, познати на всички залагащи играчи, са съотношението между "успехите" и "неуспехите". От гледна точка на вероятностите, шансовете са вероятността за настъпване на събитие, разделена на вероятността, че събитието няма да се случи. Нека запишем формулата за шанса на настъпване на събитие
 :

, където  — вероятността за настъпване на събитие,
 — вероятността ЗА НЕ настъпването на събитие
Например, ако вероятността младият, силен и бърз кон, наречен "Ветерок", да изпревари на състезанията старата и тромава баба, известна като "Матилда", е равна на  , шансовете за успех на „Ветерка“ съставят
 к

 и обратно, знаейки шансовете, не ни е трудно да изчислим вероятността
 :

По този начин, научихме се да „превеждаме“ вероятността в шансове, които приемат стойности от  до
 . Нека направим още една стъпка и да научим как да „превеждаме“ вероятността на цялата числова пряма от
 до
 .
Стъпка 2. Преведем стойностите на вероятността в диапазон

Тази стъпка е много проста — ще логаритмираме шансовете по основата на числото на Ейлер  и ще получим:

Сега знаем, че ако  , то изчисляването на стойността
 ще бъде много просто и, освен това, трябва да бъде положително:
 . Вярно е.
От любопитство, да проверим, ако  , тогава очакваме да видим отрицателна стойност
 . Проверяваме:
 . Всичко е вярно.
Сега знаем как да преведем стойността на вероятността от  до
 на цялата числова пряма от
 до
 . В следващата стъпка ще направим всичко обратно.
А засега, нека отбележим, че според правилата на логаритмирането, знаейки стойността на функцията  , можем да изчислим шансовете:

Този метод за определяне на шансовете ще ни бъде полезен в следващата стъпка.
Стъпка 3. Ще изведем формула за определяне на

Така, научихме, знаейки  , да намираме стойностите на функцията
 . Но в действителност, трябва всичко точно обратно — знаейки стойността
 да намерим
 . За това ще се обърнем към понятието обратна функция на шансовете, според което:

В статията няма да изведем посочената формула, но ще проверим с числата от горния пример. Знаем, че при шансове равни 4 към 1 ( ), вероятността за настъпване на събитието е 0.8 (
 ). Нека направим заместване:
 . Това съвпада с нашите изчисления, проведени по-рано. Продължаваме.
На предишната стъпка извеждахме, че  , така че можем да направим замяна в обратната функция на шансовете. Получаваме:

Да разделим и числителя, и знаменателя на  , тогава:

В случай на нужда, за да се уверим, че не сме сгрешили, ще направим още една малка проверка. На стъпка 2, определихме, че  . Тогава, замествайки стойността
 в функцията на логистичния отклик, очакваме да получим
 . Заместете и получаваме:
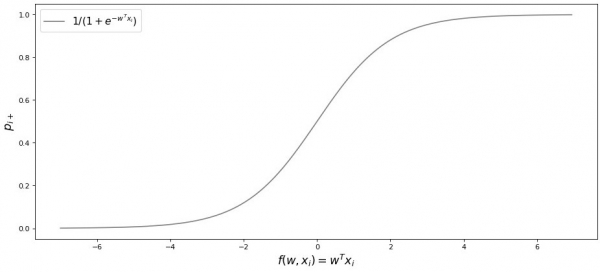
 Поздравявам ви, уважаеми читателю, току-що извършихме и тестваме функцията на логистичния отклик. Нека погледнем графика на функцията.

График 3 „Функция на логистичния отклик“
График 3 «Функция на логистичния отговор»
Код за рисуване на графика
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
В литературата също така може да се срещне наименование на тази функция като сигмоида-функция. От графика е ясно видно, че основното изменение на вероятността за принадлежност на обекта към класа става в относително малък диапазон  , някъде от
 до
 .
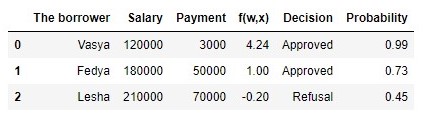
Предлагам да се върнем към нашия кредитен аналитик и да му помогнем с изчисляването на вероятността за погасяване на кредити, иначе той рискува да остане без премия 🙂
Таблица 2 „Потенциални заемачи“
Код за генериране на таблицата
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probability'] = proba

df[['The borrower', 'Salary', 'Payment', 'f(w,x)', 'Decision', 'Probability']]
И така, вероятността за връщане на кредита сме определили. В общи линии, това изглежда вярно.
Наистина, вероятността, че Васил при заплата от 120.000Р ще може да плаща по 3.000Р на банката месечно, е близка до 100%. Между другото, трябва да разбираме, че банката може да отпусне кредит и на Леша, ако политиката на банката предвижда, например, кредитиране на клиенти с вероятност за връщане на кредита над, да кажем, 0.3. Просто в такъв случай банката ще формира по-голям резерв за възможни загуби.
Също така трябва да отбележим, че отношението заплата към плащане не е по-малко от 3 и с резерв от 5.000Р беше взето на случаен принцип. Затова не можем да използваме оригиналната форма на вектора на теглата.  . Необходимо беше да намалим значително коефициентите и в такъв случай разделихме всеки коефициент на 25.000, т.е. по същество адаптирахме резултата. Но това беше направено, за да опростим разбирането на материала на начален етап. В действителност, обаче, ще трябва да не измисляме и адаптираме коефициентите, а да ги намираме. Както в следващите части на статията ще изведем уравненията, с помощта на които се подбират параметрите.
 .
04. Метод на най-малките квадрати при определяне на вектора на теглата в логистичната функция на отговор
 в логистичната функция на отговор
Вече ни е известен такъв метод за подбор на вектора на теглата  , като метод на най-малките квадрати (МНК) и всъщност, защо да не го използваме в задачите за бинарна класификация? Наистина, нищо не пречи да използваме МНК, но този метод в задачите за класификация дава по-малко точни резултати от Logistic Loss. Това има теоретично обосноваване. Нека първо да разгледаме един прост пример.
Представете си, че нашите модели (използващи MSE и Logistic Loss) вече са започнали подбора на вектора на теглата  и ние сме спрели изчисленията на някакъв етап. Независимо дали в средата, в края или в началото, важното е, че вече имаме някакви стойности на вектора на теглата и да кажем, че на този етап вектора на теглата
 за двата модела нямат разлики. Тогава взимаме получените тегла и ги подставяме в функцията на логистичния отговор (
 ) за някакъв обект, който принадлежи към класа
 . Ще разгледаме два случая, когато в съответствие с подбрания вектор на теглата нашият модел греши сериозно и обратно — моделът е сигурен, че обектът принадлежи на класа
 . Нека видим какви глоби ще бъдат наложени при използването на МНК и Logistic Loss.
Код за изчисляване на глобите в зависимост от използваната функция на загубите
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Случай с груба грешка — моделът отнася обекта към класа  с вероятност 0,01
Глобата при използването на МНК ще бъде:

Глобата при използването на Logistic Loss ще бъде:

Случай с голяма увереност — моделът отнася обекта към класа  с вероятност 0,99
Глобата при използването на МНК ще бъде:

Глобата при използването на Logistic Loss ще бъде:

Т този пример добре илюстрира, че при груба грешка функцията на загубите Log Loss наказва модела значително по-силно от MSE. Нека сега да разгледаме какви са теоретичните предпоставки за използването на функцията на загубите Log Loss в задачите за класификация.
05. Методът на максималната вероятност и логистичната регресия
Както беше обещано в началото, статията изобилства от прости примери. В студиото нов пример и стари приятели — кредитополучателите: Вася, Федя и Леша.
За всеки случай, преди да развием примера, напомням, че в живота се справяме с обучаваща извадка от хиляди или милиони обекта с десетки или стотици признаци. Въпреки това тук цифрите са взети така, че лесно да се запомнят от начинаещия дата-сайентист.
Връщаме се към примера. Да предположим, че директорът на банката е решил да предостави кредит на всички нуждаещи се, независимо от факта, че алгоритъмът е подсказал да не го предоставя на Леша. И така, измина достатъчно време и научаваме кой от тримата героя е погасил кредита и кой не. Както и се очакваше: Вася и Федя са погасили кредита, а Леша — не. Сега да си представим, че този резултат ще бъде нова обучаваща извадка за нас, и в същото време сякаш сме загубили всички данни за факторите, влияещи на вероятността за погасяване на кредита (заплата на заемателя, размер на месечното плащане). Тогава интуитивно можем да предположим, че всеки трети заемател не връща кредита на банката или с други думи вероятността за връщане на кредита от следващия заемател  . Това интуитивно предположение има теоретично потвърждение и се основава на метода на максимално правдоподобие, който често в литературата се нарича принцип на максимално правдоподобие.
Първо, нека се запознаем с понятийния апарат.
Правдоподобие на извадката — това е вероятността да получим именно такава извадка, именно такива наблюдения / резултати, т.е. произведение на вероятностите да се получат всяко от резултатите на извадката (например, погасен или не погасен кредит от Вася, Федя и Леша едновременно).
Функцията на правдоподобие свързва правдоподобието на извадката с ценностите на параметрите на разпределението.
В нашия случай, обучаващата извадка представлява обобщена схема на Бернули, в която случайната величина приема само две стойности:  или
 . Следователно правдоподобието на извадката може да бъде записано като функция на правдоподобието от параметъра
 по следния начин:


По-гореизложената запись може да се интерпретира така. Съвместната вероятност, че Вася и Федя ще погасат кредита е равна на  , вероятността, че Леша НЕ е погасил кредита е равна на
 (тъй като беше налице именно НЕ погасяване на кредита), следователно съвместната вероятност на всичките три събития е равна на
 .
Метод на максималната вероятност — това е метод за оценка на неизвестен параметър чрез максимизация на функция на вероятността. В нашия случай е необходимо да се намери такава стойност  , при която
 достига максимума.
Откъде всъщност идва идеята – да се търси стойността на неизвестен параметър, при която функцията на правдоподобие достига максимум? Произходът на идеята произтича от представата, че извадката е единственият, наличен ни, източник на знание за генеральната совокупност. Всичко, което знаем за генеральната совокупност, е представено в извадката. Следователно, всичко, което можем да кажем, е, че извадката е най-точното отражение на генеральната совокупност, което имаме на разположение. Следователно, нужно ни е да намерим такъв параметър, при който наличната извадка става най-вероятна.
Очевидно, имаме работа с оптимизационна задача, в която е необходимо да намерим точка на екстремум на функцията. За намиране на точката на екстремум е необходимо да разгледаме условието на първи ред, т.е. да приравним производната на функцията на нула и да решим уравнението относно търсения параметър. Обаче, търсенето на производната на произведение от множество множители може да се окаже продължително, за да се избегне това, съществува специална техника – преминаване към логаритъм. функция на вероятността. Защо такова преминаване е възможно? Нека обърнем внимание на факта, че не търсим самия екстремум на функцията , а точката на екстремум, т.е. това стойност на неизвестния параметър
 , при която
 достига максимума. При преминаване към логаритъм точката на екстремум не се променя (въпреки че самият екстремум ще се различава), тъй като логаритъмът е монотонна функция.
Нека, в съответствие с горепосоченото, продължим да развиваме нашия пример с кредитите от Васи, Феди и Леши. За начало да преминем към логаритъма на функцията на правдоподобие:

Сега можем без затруднения да диференцираме израза по  :

И накрая, да разгледаме условието на първи ред – да приравним производната на функцията на нула:

Така че, нашата интуитивна оценка на вероятността за погасяване на кредита  е теоретично обоснована.
Отлично, но какво да правим с такава информация? Ако смятаме, че всеки трети заемател няма да върне парите на банката, то последната неминуемо ще фалира. Вярно е, но при оценка на вероятността за погасяне на кредита, равна на  Не взехме предвид факти, влияещи на връщането на кредита: заплатата на заимодателя и размера на месечното плащане. Нека си спомним, че по-рано изчислихме вероятността за възстановяване на кредита от всеки клиент, като взехме предвид точно тези фактори. Логично е, че вероятностите също ще са различни от константната стойност
 .
Нека определим правдоподобието на извадките:
Код за изчисление на правдоподобието на извадките
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Правдоподобието на извадката при константна стойност p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Правдоподобието на извадката при изчислена стойност p:', round(likelihood(y,p_log_response),3)
Правдоподобието на извадката при константна стойност  :

Правдоподобието на извадката при изчисление на вероятността за връщане на кредита с оглед на факторите  :


Правдоподобието на извадката с вероятност, изчислена в зависимост от факторите, се оказа по-високо от правдоподобието при константна стойност на вероятността. Какво означава това? Това означава, че познанията за факторите позволяват по-точно определяне на вероятността за връщане на кредита за всеки клиент. Следователно, при отпускането на следващ кредит, е по-правилно да използваме модела за оценка на вероятността за връщане на дълга, предложен в края на третия раздел на статията.
Но тогава, ако трябва да максимизираме функцията на правдоподобието на извадката, защо да не използваме някой алгоритъм, който ще дава вероятности за Васи, Феди и Леши, например, равни на 0.99, 0.99 и 0.01 съответно. Вероятно такъв алгоритъм ще покаже добри резултати при обучителната извадка, тъй като ще приближи стойността на правдоподобието на извадката  , но, на първо място, такъв алгоритъм вероятно ще има затруднения с обобщаващата способност, а на второ — този алгоритъм определено няма да бъде линейнен. И ако методите за справяне с пренапасването (а именно слаба обобщаваща способност) явно не попадат в плана на тази статия, то по втория пункт нека да се спрем по-подробно. За целта е достатъчно да отговорим на един прост въпрос. Може ли вероятността за погасяване на кредита от Васил и Филип да бъде същата, като се вземат предвид известните ни фактори? От гледна точка на здравия разум, разбира се, не може. Така за погасяване на кредита Васил ще дава 2,5% от заплатата си на месец, а Филип — почти 27,8%. Също така на графика 2 „Класификация на клиентите“ виждаме, че Васил е значително по-далеч от линията, разделяща класовете, отколкото Филип. Накрая, знаем, че функцията
 за Васил и Филип приема различни стойности: 4,24 за Васил и 1,0 за Филип. Ако, например, Филип печелеше значително повече или искаше по-малък кредит, то тогава вероятностите за погасяване на кредита на Васил и Филип биха били сходни. С други думи, линейната зависимост не може да се заблуди. И ако наистина бяхме изчислили коефициентите
 , а не ги бяхме взели от мухата, то щяхме спокойно да заявим, че нашите стойности
 най-добре оценяват вероятността за погасяване на кредита от всеки заемополучател, но тъй като се уговорихме да считаме, че определението на коефициентите
 е извършено по всички правила, ще приемем, че нашите коефициенти дават най-добрата оценка на вероятността 🙂
Но се отклонихме от темата. В този раздел трябва да разберем как се определя векторът на теглата  , който е необходим за оценка на вероятността за връщане на кредита от всеки заемополучател.
Кратко резюмираме с какъв арсенал сме на разположение в търсенето на коефициентите  :
1. Предполагаме, че зависимостта между целевата променлива (прогнозна стойност) и фактора, който влияе на резултата — е линейна. Поради тази причина се прилага функцията на линейната регресия от вида  , линия, която разделя обектите (клиентите) на класове
 и
 или
 (клиенти, способни да погасят кредита и не способни). В нашия случай уравнението има вида
 .
2. Използваме функция на обратно логит-преобразуване от вида  за определяне на вероятността за принадлежност на обекта към класа
 .
3. Ние разглеждаме нашия обучителен набор като реализация на обобщена Бернулиеви схеми, което означава, че за всеки обект се генерира случайна величина, която с вероятност  (своя за всеки обект) приема стойност 1 и с вероятност
 – 0.
4. Знаем, че трябва да максимизираме функцията на правдоподобието на извадката в светлината на приетите фактори, така че текущата извадка да стане най-вероятна. С други думи, трябва да подберем такива параметри, при които извадката ще бъде най-вероятна. В нашия случай подбираният параметър е вероятността за погасяване на кредита  , която от своя страна зависи от неизвестни коефициенти
 . Следователно, трябва да намерим такъв вектор на тегла
 , при който вероятността на извадката ще бъде максимална.
5. Знаем, че за максимизиране на функцията на вероятността на извадката можете да използвате метод на максималната вероятност. И ние познаваме всички хитри методи за работа с този метод.
Получава се такава многоходова схема 🙂
А сега да си припомним, че в самото начало на статията искахме да изведем два вида функция за загуба Logistic Loss в зависимост от начина, по който се обозначават класовете на обектите. Уговорено е, че в задачи за класификация с два класа, класовете се обозначават като  и
 или
 . В зависимост от обозначението, на изхода ще бъде съответстваща функция за загуба.
Случай 1. Класификация на обекти на и
 и

По-рано, при определяне на вероятността на извадката, в която вероятността за погасяване на дълга от заемателя се изчислява на базата на фактори и зададени коефициенти  , приложихме формулата:

Всъщност  — това е стойността на функцията на логистичния отговор
 при зададен вектор на тегла

Тогава нищо не пречи да запишем функцията на вероятността на извадката така:

Случва се, че понякога на някои начинаещиanalytici им е трудно да разберат от първия път как работи тази функция. Нека да разгледаме 4 кратки примера, които всичко ще изяснят:
1. Ако  (т.е. съгласно обучаващата извадка, обектът принадлежи към клас +1), а нашият алгоритъм
 определя вероятността обектът да бъде от клас
 равна на 0.9, тогава този сегмент от вероятността на извадката ще бъде изчислен така:

2. Ако  , а
 , тогава изчислението ще бъде такова:

3. Ако  , а
 , тогава изчислението ще бъде такова:

4. Ако  , а
 , тогава изчислението ще бъде такова:

Ясно е, че функцията на вероятността ще бъде максимизирана в случаите 1 и 3 или в общия случай — при правилно отгатнати стойности на вероятностите за отнесение на обекта към класа  .
Във връзка с това, когато се определя вероятността за отнесение на обекта към класа  не познаваме само коефициентите
 , тогда ще ги търсим. Както беше споменато по-горе, това е задача за оптимизация, в която за начало трябва да намерим производната на функцията на правдоподобие по векторa на теглата
 . Въпреки това, предварително е разумно да опростим задачата си: ще търсим производната на логаритъма функция на вероятността.

Защо след логаритмироването, в функцията на логистичната грешка, сменихме знака с  на
 . Всичко е просто, тъй като в задачите за оценка на качеството на модела е прието да минимизираме стойността на функцията, затова умножихме дясната част на израза по
 и съответно вместо максимизиране, сега минимизираме функцията.
Собствено, в момента, пред вашите очи беше болезнено изведена функция на загубите — Logistic Loss за обучаваща извадка с два класа:  и
 .
Сега, за намирането на коефициентите, ще ни е нужно само да намерим производната функцията на логистичната грешка и след това, използвайки числени методи за оптимизация, като градиентен спуск или стохастичен градиентен спуск, да подберем най-оптималните коефициенти  . Но, отчитайки, вече не малкия обем на статията, предлагам да проведем диференцирането сами или, може би, това ще бъде тема за следваща статия с голямо количество аритметика без толкова подробни примери.
Случай 2. Класификация на обекти на и
 и

Подходът тук ще бъде същият като с класовете  и
 , но самият път към извеждането на функцията на загубите Logistic Loss, ще бъде по-витиев. Пристъпваме. За функцията на правдоподобие ще използваме оператора „ако…, то…“. Тоест, ако
 -ят обект принадлежи на клас
 , то за изчисляването на правдоподобие на извадката използваме вероятността
 , и ако обектът принадлежи на клас
 , то в правдоподобието подставяме
 . Ето как изглежда функцията на правдоподобие:

На пръстите ще обясним как работи това. Нека разгледаме 4 случая:
1. Ако  и
 , то в правдоподобието на извадката „ще отиде“

2. Ако  и
 , то в правдоподобието на извадката „ще отиде“

3. Ако  и
 , то в правдоподобието на извадката „ще отиде“

4. Ако  и
 , то в правдоподобието на извадката „ще отиде“

Очевидно, че в 1 и 3 случая, когато вероятностите бяха правилно определени от алгоритъма, функцията на правдоподобие ще се максимизира, тоест точно това искахме да получим. Въпреки това, такъв подход е достатъчно обременяващ и по-нататък ще разгледаме по-компактна форма. Но за начало, ще логаритмируем функцията на правдоподобие с замяна на знака, тъй като сега ще минимизираме нея.

Ще подставим вместо  израза
 :

Оптимизирайте дясното събираемо под логаритъма, използвайки простичките аритметични техники и получете:

А сега е време да се отървем от оператора „ако…, то…“. Забележете, че когато обектът  попада в класа
 , то в израза под логаритъма, в знаменателя,
 се повдига на степен
 , и ако обектът принадлежи на клас
 , така че $e$ се повдига на степен
 . Следователно, записа на степента може да бъде опростен — обединете двата случая в един:
 . Тогава функцията на логистичната грешка приема вид:

Според правилата на логаритмирането, обърнете дробта и изнесете знака " " (минус) пред логаритъма, получаваме:

Пред вас е функцията на загубите logistic Loss, която се прилага в обучаващата извадка с обекти, отнасящи се към класовете:  и
 .
Е, на този етап се откланям и завършваме статията.
Предишната работа на автора — „Преобразуване на уравнението на линейната регресия в матричен вид”
Помощни материали
1. Литература
1) Прикладен регресионен анализ / Н. Дрейпер, Г. Смит – 2-ро изд. – М.: Финанси и статистика, 1986 (превод от английски)
2) Теория на вероятностите и математическа статистика / В.Е. Гмурман — 9-то изд. — М.: Висша школа, 2003
3) Теория на вероятностите / Н.И. Чернова — Новосибирск: Новосибирски държавен университет, 2007
4) Бизнес аналитика: от данни до знания / Паклин Н. Б., Орешков В. И. — 2-ро изд. — Санкт Петербург: Питер, 2013
5) Data Science Наука за данните от нула / Джоел Грас — Санкт Петербург: БХВ Петербург, 2017
6) Практическа статистика за специалисти Data Science / П.Брюс, Е.Брюс — Санкт Петербург: БХВ Петербург, 2018
2. Лекции, курсове (видео)
1)
2)
3)
4)
5)
3. Интернет източници
1)
2)
3)
4)
5)
6)
7)
8)
Източник: habr.com
