

30 ноември — 1 декември в Нижни Новгород се проведе. Участниците бяха помолени да създадат прототип на продуктово решение с помощта на набора инструменти Intel OpenVINO. Организаторите предоставиха списък с примерни теми, на които можеха да се ориентират при избора на задача, но последното решение оставаше на екипите. Освен това, беше насърчавано използването на модели, които не са включени в продукта.
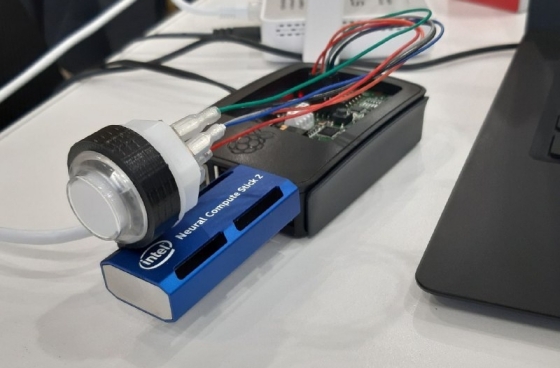
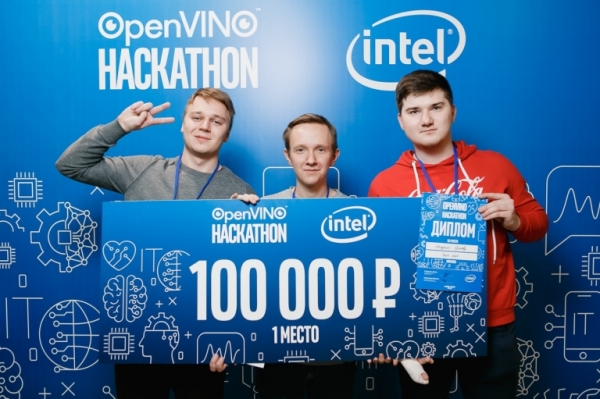
В статията ще разкажем за това как създадохме своя прототип на продукта, с който в крайна сметка заехме първото място.
В хакатона участваха повече от 10 екипа. Приятно е, че някои от тях пристигнаха от други региони. Мястото на провеждане на хакатона беше комплексът „Кремлевский на Почаине“, където вътре бяха окачени стари снимки на Нижни Новгород, много автентично! (напомням, че в момента централният офис на компанията Intel е разположен точно в Нижни Новгород). На участниците бяха отделени 26 часа за написване на код, в края на което беше необходимо да представят своето решение. Допълнителен плюс беше наличието на демо-сесия, за да се уверим, че всичко, което сме замислили, е наистина реализирано, а не е останало само в идеите на презентацията. Имаше мърч, закуски, храна, всичко това също!
Освен това, компанията Intel предоставяше по желание камери, Raspberry PI, Neural Compute Stick 2.
Избор на задача
Една от най-трудните части в подготовката за хакатона с отворена тематика е изборът на задача. Веднага решихме да измислим нещо, което все още не съществува в продукта, тъй като в анонса беше споменато, че това е много желателно.
Анализирайки , които влизат в продукта в текущото издание, стигаме до извода, че повечето от тях решават различни задачи по компютърно зрение. Всъщност е доста трудно да се измисли задача от областта на компютърното зрение, която не може да бъде решена с помощта на OpenVINO, а ако такава наистина може да бъде измислена, е трудно да се намерят предварително обучени модели в отворен достъп. Решаваме да разгледаме и друго направление — в областта на обработката и анализа на речта. Обмисляме интересен проблем за разпознаване на емоции по глас. Трябва да се каже, че в OpenVINO вече има модел, който определя емоциите на човека по лицето, но:
- В теорията е възможно да се създаде комбиниран алгоритъм, който да работи както по звук, така и по изображение, което трябва да доведе до увеличение на точността.
- Камерите обикновено имат тъмен ъгъл на виждане, за да покрият голяма зона, за това е необходима не една камера, звукът няма такова ограничение.
Развиваме идеята: ще вземем за основа концепцията за сегмента на търговията на дребно. Можем да определим задоволството на клиента на касите на магазините. Ако някой от клиентите не е доволен от обслужването и започне да повишава тон — можем веднага да повикаме администратора на помощ.
В този случай е нужно да добавим разпознаване на човека по глас, което ще ни позволи да различаваме служителите на магазина от клиентите и да предоставяме анализи за всяко индивидуално лице. И освен това, ще можем да анализираме поведението на самите служители на магазина, да оценяваме атмосферата в екипа, звучи не лошо!
Формираме изискванията за нашето решение:
- Малък размер на целевото устройство
- Работа в реално време
- Ниска цена
- Лесна мащабируемост
В крайна сметка избираме Raspberry Pi 3 като целево устройство с .
Тук е важно да се отбележи една важна особеност на NCS — той работи най-добре със стандартни CNN архитектури; ако е необходимо да стартирате модел с персонализирани слоеве, тогава очаквайте нискоуровнева оптимизация.
Остава малко: нужно е да се сдобием с микрофон. Може да е обикновен USB микрофон, въпреки че той няма да изглежда добре в комбинация с RPI. Но и тук решението буквално е "под ръка". За запис на глас решаваме да използваме платката Voice Bonnet от комплекта , на която има запоен стерео микрофон.
Сваляме Raspbian от и го качваме на флашка, тестираме дали микрофонът работи с помощта на следната команда (тя ще запише аудио с продължителност 5 секунди и ще запази в файл):
arecord -d 5 -r 16000 test.wavВеднага отбелязвам, че микрофонът е много чувствителен и добре улавя шумове. За да поправим това, ще влезем в alsamixer, ще изберем Capture devices и ще намалим нивото на входния сигнал до 50-60%.
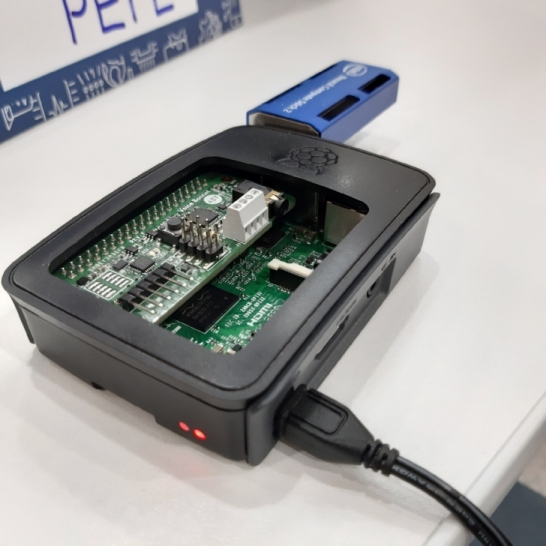
Доработваме корпуса с пила и всичко влиза, можем дори да затворим капака.
Добавяме индикаторен бутон.
По време на разглобяването на AIY Voice Kit си спомняме, че там има RGB бутон, чиято подсветка може да се контролира програмно. Търсим “Google AIY Led” и намираме документацията:
Защо да не използваме този бутон за показване на разпознатото емоционално състояние, имаме само 7 класа, а в бутона има 8 цвята, тъкмо стигат!
Свързваме бутона по GPIO с Voice Bonnet, зареждаме необходимите библиотеки (те вече са инсталирани в дистрибуцията от AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Създаваме dict, в който на всяка емоция ще отговаря цвят под формата на RGB Tuple и обект на класа aiy.leds.Leds, чрез който ще обновяваме цвета:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
И накрая, след всяко ново предсказание на емоция ще обновяваме цвета на бутона в съответствие с нея (по ключа).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))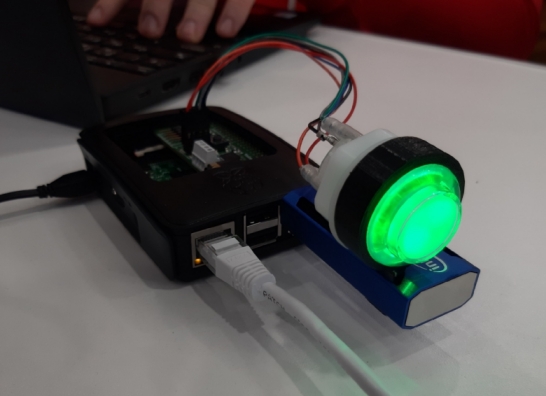
Бутонче, светни!
Работим с глас
Ще използваме pyaudio за улавяне на потока от микрофона и webrtcvad за филтриране на шум и откриване на глас. Освен това, ще създадем опашка, в която асинхронно ще добавяме и взимаме откъси с глас.
Тъй като webrtcvad има ограничение на размера на подаваните фрагменти — те трябва да са по 10/20/30мс, а обучението на модела за разпознаване на емоции (както ще разберем по-късно) е извършено на датасет с 48кHz, ще улавяме чанкове с размер 48000×20мс/1000×1(моно)=960 байта. Webrtcvad ще връща True/False за всеки от тези чанкове, което отговаря на наличието или отсъствието на глас в чанка.
Реализираме следната логика:
- Ще добавяме в списъка тези чанкове, където има глас; ако гласът отсъства, увеличаваме брояча на празните чанкове.
- Ако броячът на празните чанкове >=30 (600 мс), проверяваме размера на списъка с натрупаните чанкове; ако той >250, добавяме в опашката, иначе считаме, че дължината на записа е недостатъчна, за да я подадем на модела за идентификация на говорещия.
- Ако броячът на празните чанкове все още < 30, а размерът на списъка с натрупаните чанкове е над 300, ще добавим откъса в опашката за по-точно предсказание. (тъй като с времето емоциите имат тенденция да се променят)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Време е да потърсим предобучени модели в открито пространство, отиваме в github, търсим, но помним, че имаме ограничение по използваната архитектура. Това е доста сложно, тъй като трябва да тестваме моделите на собствените си входни данни, освен това е необходимо да ги конвертираме във вътрешния формат на OpenVINO — IR (Intermediate Representation). Изпробвахме около 5-7 различни решения от github, и ако моделът за разпознаване на емоции проработи веднага, то с разпознаването по глас се наложи да почакаме малко по-дълго — там се използват по-сложни архитектури.
Спираме се на следните:
- Емоции от гласа —
Тя работи по следния принцип: аудиото се нарязва на откъси с определен размер, за всеки от тези откъси извеждаме и след това ги подаваме на входа на CNN. - Разпознаване по глас —
Тук вместо MFCC работим със спектрограма, след FFT подаваме сигнала в CNN, където на изхода получаваме векторно представяне на гласа.
По-надолу ще говорим за конвертиране на модели, ще започнем с теория. OpenVINO включва няколко модула:
- Open Model Zoo, модели от който могат да се използват и включват в продукта ви
- Model Optimizer, благодарение на който можем да преконвертираме модела от различни формати на фреймворка (Tensorflow, ONNX и т.н.) в формат Intermediate Representation, с който след това ще работим.
- Inference Engine позволява стартиране на модели в IR формат на Intel процесори, Myriad чипове и ускорители Neural Compute Stick.
- Най-ефективната версия на OpenCV (с подкрепа за Inference Engine).
Всеки модел в IR формат е описан с два файла: .xml и .bin.
Моделите се конвертират в IR формат чрез Model Optimizer по следния начин:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typeпозволява да изберете формата на данните, с който ще работи моделът. Поддържат се FP32, FP16, INT8. Изборът на оптимален тип данни може да донесе добър прирост на производителността.
--input_shapeозначава размерността на входните данни. Възможността динамично да я променяте съществува в C++ API, но не се задълбочихме в това и за един от моделите просто я фиксирахме.
След това ще се опитаме да заредим вече конвертирания модел в IR формат чрез DNN модула в OpenCV и да извършим forward на него.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Последният ред в този случай позволява да пренасочим изчисленията към Neural Compute Stick; по подразбиране изчисленията се извършват на процесора, но при Raspberry Pi това няма да сработи, ще е необходим стик.
Следващата логика е следната: ще разделим нашето аудио на прозорци с определен размер (в нашия случай 0.4с), всяко от тези прозорци ще преобразуваме в MFCC, които след това ще подадем на мрежата:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
След това ще вземем най-често срещания клас за всички прозорци. Просто решение, но за хакатона не е нужно да измисляме нещо твърде сложно, освен ако не разполагаме с време. Има ни още много работа, така че продължаваме — разбираме се с разпознаването по глас. Трябва да създадем някаква база, в която да се съхраняват спектрограмите на предварително записаните гласове. Понеже времето е ограничено, решаваме този въпрос както можем.
А именно, създаваме скрипт за запис на откъс от глас (работи така, както е описано по-горе, само че при прекъсване от клавиатурата ще запазва гласа в файл).
Опитваме:
python3 voice_db/record_voice.py test.wavЗаписваме гласовете на няколко човека (в нашия случай трима членове на екипа)
След това за всеки записан глас извършваме бързо преобразуване на Фурие, получаваме спектрограмата и я съхраняваме под формата на numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Повече в файла
create_base.py
В резултат, при стартиране на основния скрипт, в самото начало ще получим ембеддинги от тези спектрограми:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)След като получим ембединг от звучащия фрагмент, можем да определим на кого принадлежи, вземайки косинусното разстояние от фрагмента до всички гласове в базата (колкото по-малко, толкова по-вероятно) — за демо зададохме праг от 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
В заключение ще отбележа, че скоростта на инференцията беше бърза и позволяваше добавянето на още 1-2 модела (за семпъл с дължина от 7 секунди, за инференция отиваха 2.5). Вече нямаше да вложим време за нови модели и се фокусирахме върху написването на прототип на уеб-приложение.
Уеб-приложение
Важно нещо: взимаме с нас рутер от вкъщи и настройваме собствената си локална мрежа, което помага да свържем устройството и лаптопите.
Бекендът представлява непрекъснат канал за съобщения между фронтенда и Raspberry Pi, основан на технологията websocket (http over tcp протокол).
Първият етап е получаването на обработена информация от Raspberry, а именно опакованите в json предсказания, които в средата на пътя се записват в базата данни, за да може да се формира статистика за емоционалния фон на потребителя за определен период. След това този пакет се изпраща на фронтенда, който използва абонамент и получаване на пакети от крайна точка на уебсокета. Целият бекенд механизъм е построен на езика golang, изборът падна на него, защото той е подходящ за асинхронни задачи, с които горутините се справят добре.
При достъп до крайната точка потребителят се регистрира и се добавя в структурата, след което се получава неговото съобщение. И потребителят, и съобщението се записват в общ хъб, от който съобщенията вече се изпращат нататък (към подписания фронт), а ако потребителят затвори връзката (Raspberry или фронта), абонаментът му се отменя и той се изтегля от хъба.
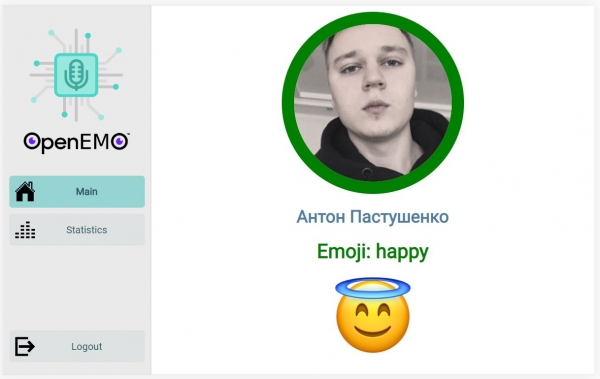
Очакваме свързване с бекендаFrontend е уеб приложение, написано на JavaScript с използването на библиотеката React за ускоряване и опростяване на процеса на разработка. Целта на приложението е визуализация на данни, получени чрез алгоритми, изпълнени на бекенд страна и директно на Raspberry Pi. На страницата има рутинг по секции, реализиран с помощта на react-router, но основният интерес представлява началната страница, където в реално време постъпва непрекъснат поток от данни от сървъра чрез технологията WebSocket. Raspberry Pi открива глас, определя принадлежността към конкретен човек от регистрираната база и изпраща списък с вероятности на клиента. Клиентът показва последните актуални данни, извежда аватар на човека, който с най-голяма вероятност е говорил в микрофона, както и емоцията, с която произнася думите.

Начална страница с обновяеми предиктиЗаключение
Не успяхме да завършим всичко, както беше замислено, просто нямаше достатъчно време, затова основната надежда беше на демото, на това, че всичко ще заработи. В презентацията разказахме как е всичко устроено, какви модели използвахме, с какви проблеми се сблъскахме. След това имаше част от демото — експерти се разхождаха в залата в произволен ред и се приближаваха до всяка отбор, за да видят работещия прототип. Задаваха въпроси и на нас, всеки отговори по своята част, оставихме уеб на лаптопа и всичко действително работеше, както се очакваше.
Искам да отбележа, че общата стойност на нашето решение беше 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (може да вземете платка respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Как да подобрим:
- Да използваме регистрация от клиента — да поискаме да прочете текст, който генерираме случайно
- Да добавим още няколко модела: по гласа може да се определи пол и възраст
- Да разделяме одновременно звучащите гласове (диаризация)
Репозитория:

Уморени, но щастливи ниеВ заключение искам да благодаря на организаторите и участниците. От проектите на другите отбори, лично на нас ни хареса решението за мониторинг на свободните паркинг места. За нас това беше страхотен опит за потапяне в продукта и разработката. Надявам се в регионите да се провеждат все повече интересни събития, включително и по тематика на изкуствения интелект.
Източник: habr.com
