

Здравей, Хабър! Представям ви превод на статия
.
Когато става въпрос за релационни бази данни, не мога да не си помисля, че нещо липсва. Те се използват навсякъде. Съществуват много различни бази данни: от малкото и полезно SQLite до мощната Teradata. Но има само няколко статии, които обясняват как работи базата данни. Можете да търсите сами по запитването "howdoesarelationaldatabasework" ("как работят релационните бази данни"), за да видите колко малко резултати излизат. Освен това, тези статии са кратки. Ако търсите последните модни технологии (BigData, NoSQL или JavaScript), ще намерите повече задълбочени статии, обясняващи как те работят.
Дали релационните бази данни са твърде стари и твърде скучни, за да бъдат обяснени извън университетските курсове, изследователските доклади и книгите?
Като разработчик мразя да използвам нещо, което не разбирам. И ако базите данни се използват повече от 40 години, трябва да има причина за това. През тези години съм отделил стотици часове, за да разбера наистина тези странни черни кутии, които използвам всеки ден. Релационни бази данни са много интересни, защото те са основани на полезни и многократно използваеми концепции. Ако ви интересува разбирането на база данни, но никога не сте имали време или желание да се задълбочите в тази широка тема, тази статия трябва да ви хареса.
Въпреки че заглавието на тази статия е очевидно, целта на тази статия не е да разбере как да използвате база данни. Следователно, вие вече трябва да знаете как да напишете прост запитващ JOIN и базови запитвания CRUD; иначе може да не разберете тази статия. Това е единственото, което трябва да знаете, ще обясня всичко останало.
Ще започна с някои основи на компютърните науки, като времевата сложност на алгоритмите (BigO). Знам, че някои от вас мразят тази концепция, но без нея не можете да разберете детайлите в базата данни. Понеже това е огромна тема, ще се съсредоточа върху това, което считам за важно: как базата данни обработва SQL запитване. Ще представя само основни концепции на базата данни, така че в края на статията да имате представа какво се случва под капака.
Тъй като това е дълга и техническа статия, която включва множествени алгоритми и структури от данни, не бързайте да я прочетете. Някои концепции може да са трудни за разбиране; можете да ги пропуснете и все пак да получите обща представа.
За по-осведомените от вас, тази статия е разделена на 3 части:
- Преглед на нискоуровневите и високоуровневите компоненти на базата данни
- Преглед на процеса на оптимизация на заявките
- Преглед на управлението на транзакции и буферни пулове
Връщайки се към основите
Много години назад (в далечна, далечна галактика…), разработчиците трябваше да знаят точно колко операции кодираха. Те знаеха наизуст своите алгоритми и структури от данни, защото не можеха да си позволят да изразходват ЦП и паметта на своите бавни компютри.
В тази част ще ви напомня за някои от тези концепции, тъй като те са необходими за разбирането на базите данни. Също така ще въведа понятието индекс на базата данни.
O(1) срещу O(n2)
В момента много разработчици не се тревожат за времевата сложност на алгоритмите … и те са прави!
Но когато се занимавате с голям обем данни (не говоря за хиляди) или ако се борите за милисекунди, става критично важно да разберате тази концепция. И както разбирате, базите данни трябва да се справят с двете ситуации! Няма да ви накарам да прекарате повече време от необходимото, за да усвоите същността. Това ще ни помогне по-късно да разбере концепцията за оптимизация на разходите (cost based optimization).
Концепция
Временна сложност на алгоритъма се използва, за да се види колко време ще отнеме извършването на алгоритъма за даден обем данни. За да опишат тази сложност, се използват математически обозначения на големите O. Това означение се използва с функция, която описва колко операции са необходими на алгоритъма за зададения обем входни данни.
Например, когато кажа "този алгоритъм има сложност O (some_function() )", това означава, че за обработването на определен обем данни алгоритъмът изисква some_function(a_certain_amount_of_data) операции.
При това важно е не количеството данни**, а как ** нараства броят на операциите при увеличаване на обема на данните. Временната сложност не дава точно количество операции, но е добър начин да се оцени времето за изпълнение.
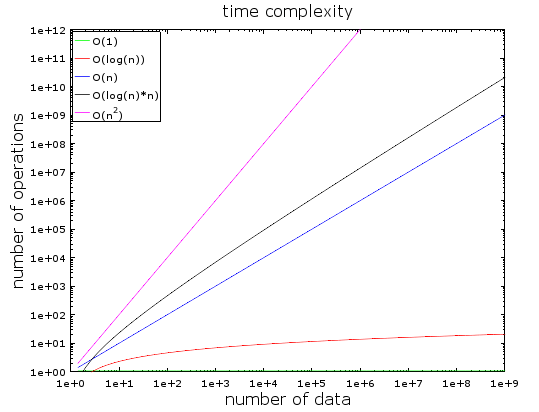
На този график можете да видите връзката между броя на операциите и обема на входните данни за различни видове времеви сложности на алгоритмите. Използвах логаритмична скала, за да ги представя. С други думи, количеството данни бързо нараства от 1 до 1 милиард. Можем да видим, че:
- O(1) или постоянна сложност остават постоянни (в противен случай няма да се нарича постоянна сложност).
- O(log(n)) остава ниска дори при милиарди данни.
- Най-лошата сложност е O(n2), където броят на операциите бързо нараства.
- Другите две сложности също нарастват бързо.
Примери
При малко количество данни разликата между O(1) и O(n2) незначителна. Например, да предположим, че имате алгоритъм, който трябва да обработи 2000 елемента.
- Алгоритъм O(1) ще изисква 1 операция
- Алгоритъм O(log(n)) ще изисква 7 операции
- Алгоритъм O(n) ще изисква 2000 операции
- Алгоритъм O(n * log(n)) ще изисква 14 000 операции
- Алгоритъм O(n2) ще изисква 4 000 000 операции
Разликата между O(1) и O(n2) изглежда голяма (4 милиона операции), но всъщност ще загубите максимум 2 мс — времето да мигнете. Всъщност, съвременните процесори могат да обработват . Затова производителността и оптимизацията не представляват проблем за много ИТ проекти.
Както казах, все още е важно да знаете тази концепция при работа с огромни количества данни. Ако сега алгоритъмът трябва да обработи 1 000 000 елемента (което не е толкова много за база данни):
- Алгоритъм O(1) ще изисква 1 операция
- Алгоритъм O(log(n)) ще изисква 14 операции
- Алгоритъм O(n) ще изисква 1 000 000 операции
- Алгоритъм O(n * log(n)) ще изисква 14 000 000 операции
- Алгоритъм O(n2) ще изисква 1 000 000 000 000 операции
Не съм правил изчисления, но бих казал, че с алгоритъм O(n2) имате време да изпиете кафе (даже две!). Ако добавите още 0 към обема на данните, ще имате време да си починете.
Да отидем по-дълбоко
За справка:
- Търсенето в добра хеш-таблица намира елемент за O(1).
- Търсенето в добре балансирано дърво дава резултат за O(log(n)).
- Търсенето в масив дава резултат за O(n).
- Най-добрите алгоритми за сортиране имат сложност O(n * log(n)).
- Лошият алгоритъм за сортиране има сложност O(n2).
Забележка: в следващите части ще видим тези алгоритми и структури от данни.
Има няколко типа времеви сложност на алгоритъма:
- среден случай
- най-добрият възможен сценарий
- и най-лошият сценарий
Времевата сложност обикновено е най-лошият сценарий.
Говорих само за времевата сложност на алгоритъма, но сложността е приложима и за:
- използването на памет от алгоритъма
- използването на дисков вход/изход от алгоритъма
Разбира се, има сложности, които са по-лоши от n2, например:
- n4: това е ужасно! Някои от споменатите алгоритми имат такава сложност.
- 3n: това е още по-зле! Един от алгоритмите, който ще видим в средата на тази статия, има тази сложност (и той наистина се използва в много бази данни).
- факториал n: никога няма да получите своите резултати дори с малко данни.
- nn: ако се сблъскате с тази сложност, трябва да се запитате дали наистина това е вашата област …
Забележка: дадох ви не реално определение на обозначението „голямо O“, а просто идея. Можете да прочетете тази статия в за реално (асимптотично) определение.
MergeSort (Сортиране чрез сливане)
Какво правите, когато трябва да сортирате колекция? Какво? Извиквате функцията sort()… Ок, добър отговор… Но за базите данни трябва да разберете как работи тази функция sort().
Има няколко добри алгоритми за сортиране, затова ще се спра на най-важния: сортиране чрез сливане. Може би сега не разбирате защо сортирането на данни е полезно, но ще трябва да разберете след частта, посветена на оптимизацията на запитванията. Освен това, разбирането на сортирането чрез сливане ще ни помогне по-късно да разберем общата операция join на бази данни, наречена merge присъединете се (сливане).
Merge (сливане)
Както много полезни алгоритми, сортирането чрез сливане се основава на хитрост: сливането на 2 сортирани масива с размер N / 2 в N-елементен сортиран масив струва само N операции. Тази операция се нарича сливане.
Нека видим какво означава това с прост пример:
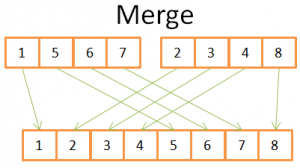
На тази диаграма се вижда, че за изграждането на окончателния сортиран масив от 8 елемента трябва да се извърши само една итерация на 2 по 4-елементни масива. Тъй като и двата 4-елементни масива вече са сортирани:
- 1) Сравнявате текущите елементи на двете масиви (в началото текущият елемент = първият)
- 2) След това вземете най-малкия, за да го поставите в масив от 8 елемента
- 3) И преминете към следващия елемент в масива, от който взехте най-малкия елемент
- и повтаряйте 1, 2, 3, докато не стигнете до последния елемент на един от масивите.
- След това вземате останалите елементи от другия масив, за да ги поставите в масив от 8 елемента.
Това работи, защото и двата 4-елементни масива са подредени и следователно не е нужно да 'се връщате' в тези масиви.
Сега, когато разбрахме този трик, ето моя псевдокод за merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //рекурсивни повиквания
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //сливане на 2-те малки подредени масива в един голям
   array result := merge(new_left_array,new_right_array);
   return result;
Сортирането чрез сливане разделя задачата на по-малки задачи и след това намира резултатите от по-малките задачи, за да получи резултата от оригиналната задача (забележка: този тип алгоритми се нарича разделяй и властвуй). Ако не разбирате този алгоритъм, не се тревожете; не го разбрах от първия път, когато го видях. Ако това може да ви помогне, виждам този алгоритъм като двуфазен алгоритъм:
- Фаза на делене, където масивът се разделя на по-малки масиви
- Фаза на сортиране, където малките масиви се обединяват (чрез сливане), за да образуват по-голям масив.
Фаза на деление
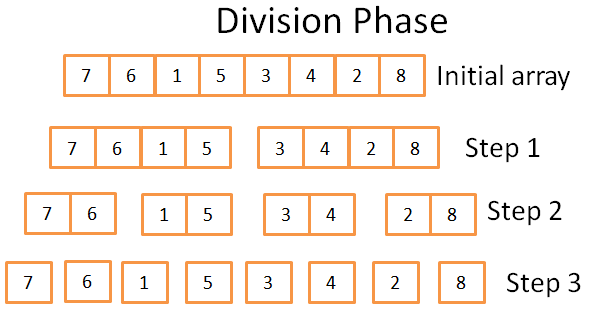
На етапа на деление масивът се дели на единични масиви за 3 стъпки. Формалният брой стъпки е log(N) (тъй като N=8, log(N) = 3).
Откъде го знам?
Аз съм гений! С една дума — математика. Идеята е, че всеки шаг дели размера на оригиналния масив на 2. Броят на стъпките е броят на пъти, които можете да разделите оригиналния масив на две. Това е точното определение на логаритъма (с основа 2).
Фаза на сортиране
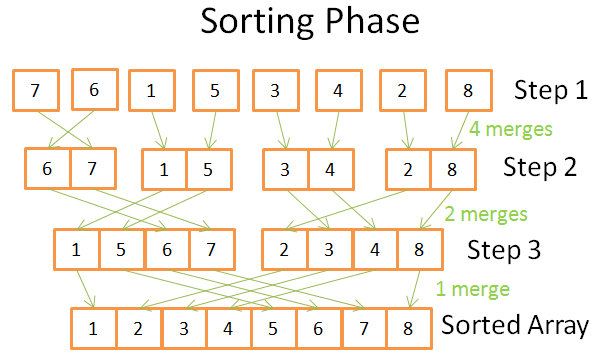
На етапа на сортиране започвате с единични (едноелементни) масиви. В течение на всеки етап прилагате няколко операции по сливане, а общата стойност е N = 8 операции:
- На първия етап имате 4 слияния, които струват по 2 операции всяко
- На втория етап имате 2 слияния, които струват по 4 операции всяко
- На третия етап имате 1 сливане, което струва 8 операции
Тъй като съществуват log (N) стъпки, общата цена N * log(N) операции.
Предимствата на merge sort
Защо този алгоритъм е толкова мощен?
Защото:
- Можете да го промените, за да намалите обема на паметта, така че да не създавате нови масиви, а да модифицирате входния масив директно.
Забележка: този вид алгоритми се нарича (сортиране без допълнителна памет).
- Можете да го промените да използва одновременно дисково пространство и малък обем памет, без значителни разходи за дисков вход/изход. Идеята е да заредите в паметта само тези части, които в момента се обработват. Това е важно, когато трябва да сортирате таблица с размери в гигабайти само с буфер памет от 100 мегабайта.
Забележка: този вид алгоритми се нарича .
- Можете да го промените да работи на множество процеси/нишки/сървъри.
Например, разпределената сортировка слиянием е един от ключовите компоненти (който е структура в големи данни).
- Този алгоритъм може да превърне оловото във злато (вярно!).
Този алгоритъм за сортиране се използва в повечето (ако не във всички) бази данни, но той не е единственият. Ако искате да научите повече, можете да прочетете тази , която обсъжда плюсовете и минусите на общите алгоритми за сортиране в базите данни.
Масив, Дърво и Хеш-таблица
Сега, когато разбираме идеята за времевата сложност и сортиране, трябва да ви разкажа за 3 структури от данни. Това е важно, защото те са основата на съвременните бази данни. Ще въведа и понятието индекс на базата данни.
Масив
Двуизмерният масив е най-простата структура от данни. Таблицата може да се разглежда като масив. Например:
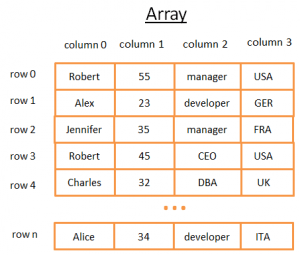
Този 2-мерен масив представлява таблица с редове и колони:
- Всеки ред представлява същество
- Колоните съ хранят свойства, описващи съществото.
- Всяка колона съхранява данни от определен тип (цялочислен, низ, дата…).
Така е удобно да се съхраняват и визуализират данни, обаче, когато се наложи да намерите определено значение, това не е подходящо.
Например, ако искате да намерите всички момчета, които работят във Великобритания, ще трябва да прегледате всеки ред, за да определите дали този ред принадлежи на Великобритания. Това ще ви струва N операции, където N — брой редове, което не е лошо, но може ли да има по-бърз начин? Сега е време да се запознаем с дърветата.
Забележка: повечето съвременни бази данни предоставят разширени масиви за ефективно съхранение на таблици: heap-organizedtables и index-organizedtables. Но това не променя проблема с бързото търсене на определено условие в група от колони.
Дърво и индекс в базата данни
Двоичното дърво за търсене е двоично дърво със специално свойство, ключът в всеки възел трябва да бъде:
- по-голям от всички ключове, съхраняващи се в лявото поддърво
- по-малък от всички ключове, съхраняващи се в дясното поддърво
Нека да видим какво означава това визуално
Идеята
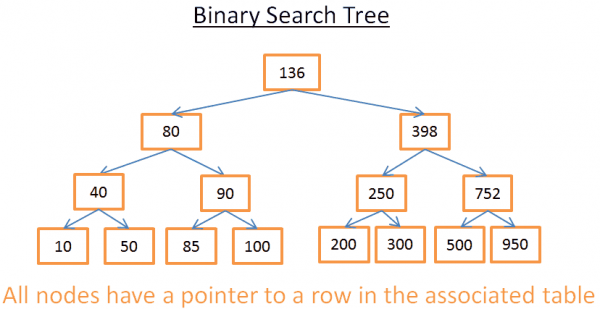
Това дърво има N = 15 елемента. Да предположим, че търся 208:
- Започвам с корена, чийто ключ е 136. Тъй като 136<208, гледам дясното поддърво на възела 136.
- 398>208, следователно, гледам лявото поддърво на възела 398
- 250>208, следователно, гледам лявото поддърво на възела 250
- 200<208, следователно, гледам дясното поддърво на възела 200. Но 200 няма дясно поддърво, стойността не съществува (защото, ако съществува, тя ще бъде в дясното поддърво на 200).
Сега, да кажем, че търся 40
- Започвам с корена, чийто ключ е 136. Тъй като 136 > 40, гледам лявото поддърво на възела 136.
- 80 > 40, следователно, гледам лявото поддърво на възела 80
- 40= 40, възел съществува. Извличам идентификатора на реда в съществуващия възел (това не е на рисунка) и гледам в таблицата за този идентификатор на ред.
- Знанието за идентификатора на реда ми позволява да разбера къде точно се намират данните в таблицата, и следователно мога да ги получа мигновено.
В крайна сметка и двете търсения ще ми струват количество нива в дървото. Ако внимателно прочетете частта за сливане, трябва да видите, че тук има log (N) нива. Получава се, цена на търсенето log(N), не е лошо!
Връщаме се към нашия проблем
Но това е много абстрактно, затова нека се върнем към нашия проблем. Вместо просто число, представете си низ, който представлява страната на някого в предишната таблица. Да предположим, че имате дърво, което съдържа поле "country" (колона 3) на таблицата:
- Ако искате да знаете кой работи в Обединеното кралство
- гледате на дървото, за да получите възела, който представлява Обединеното кралство
- В "UKnode" ще намерите разположението на записите на служителите във Великобритания.
Търсенето ще струва log(N) операции вместо N операции, ако директно използвате масив. Това, което току-що представихте, беше индекс на базата данни.
Можете да конструирате индексно дърво за всяка група от полета (стринг, число, 2 стринга, число и стринг, дата и т.н.), стига да имате функция за сравнение на ключовете (т.е. групи от полета), така че да можете да установите реда между ключовете (което е валидно за всички основни типове в базата данни).
B+Tree Index
Въпреки че това дърво работи добре за получаване на определена стойност, има ЕДИН ГОЛЯМ проблем, когато трябва да получите няколко елемента между две стойности.Това ще струва O(N), защото ще трябва да проверите всеки възел в дървото и да видите дали е между тези две стойности (например, с подредено обхождане на дървото). Освен това, тази операция не е удобна за дисков вход-изход, тъй като ще трябва да прочетете цялото дърво. Трябва да намерим начин ефективно да изпълним запитване за диапазон.За решаване на този проблем, съвременните бази данни използват модифицирана версия на предишното дърво, наречено B+Tree. В B+Tree дървото:
- само най-долните възли (листа) съхраняват информация (разположение на редовете в свързаната таблица)
- останалите възли са тук за маршрутизиране към правилния възел по време на търсене..
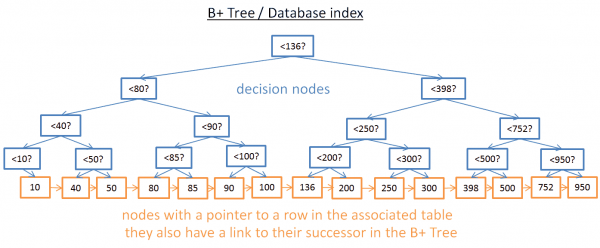
Както можете да видите, тук има повече възли (в два пъти). В действителност, имате допълнителни възли, „възли за вземане на решения“, които ще ви помогнат да намерите правилния възел (който съхранява местоположението на редовете в свързаната таблица). Но сложността на търсенето все още е O(log(N)) (има само още един слой). Голямата разлика е, че възлите на долния слой са свързани с техните наследници..
С това B+Tree, ако търсите стойности от 40 до 100:
- Просто трябва да търсите 40 (или най-близката стойност след 40, ако 40 не съществува), както направихте с предишното дърво.
- След това съберете наследниците на 40, използвайки директни връзки до наследниците, докато не достигнете 100.
Предположим, че сте намерили M наследника и дървото има N възела. Намирането на конкретен възел струва log(N) подобно на предишното дърво. Но, получавайки този възел, ще получите M наследника в M операции с връзки към техните наследници. Търсенето струва само M+log(N) операции в сравнение с N операциите с предишното дърво. Освен това, не е необходимо да четете цялото дърво (само M + log (N) възела), което означава по-малко използване на диска. Ако M е малко (например, 200 реда) и N е голямо (1 000 000 реда), това ще е ГОЛЯМА разлика.
Но тук има нови проблеми (отново!). Ако добавите или изтриете ред в базата данни (и следователно в свързания индекс B+Tree):
- трябва да поддържате реда между възлите в B+Tree, иначе няма да можете да намерите възлите в несортирано дърво.
- трябва да запазите минимално възможния брой нива в B+Tree, иначе времевата сложност в O (log (N)) ще стане O (N).
С други думи, B+Tree трябва да бъде самоорганизирано и балансирано. За щастие, това е възможно с умни операции за изтриване и вмъкване. Но това струва скъпо: вмъкването и изтриването в B+ дървото струва O (log (N)). Затова някои от вас вероятно са чували, че използването на прекалено много индекси не е много добра идея. Наистина, вие забавяте бързото вмъкване / обновление / изтриване на ред в таблицата, тъй като базата данни трябва да обнови индексите на таблицата с помощта на скъпа операция O (log (N)) за всеки индекс. Освен това, добавянето на индекси означава по-голямо натоварване за мениджъра на транзакции (ще бъде описан в края на статията).
За повече информация можете да погледнете статията в Уикипедия за . Ако искате пример за реализация на B+Tree в базата данни, вижте и от водещ разработчик на MySQL. И двете са фокусирани върху това как InnoDB (двигателят на MySQL) обработва индексите.
Забележка: Читателят ми каза, че заради нискоуровневите оптимизации дървото B+ трябва да бъде напълно балансирано.
Хеш-таблица
Нашата последна важна структура от данни е хеш-таблицата. Тя е много полезна, когато искате бързо да търсите стойности. Освен това, разбирането на хеш-таблицата ще ни помогне по-късно да разберем общата операция за свързване с базата данни, известна като хеш-свързване ( hash join). Тази структура от данни също се използва от базата данни за съхраняване на някои вътрешни неща (например, таблица за заключване или буферен пул, ще видим и двете концепции по-късно).
Хеш-таблицата е структура от данни, която бързо намира елемент по неговия ключ. За да построите хеш-таблица, трябва да определите:
- ключа за вашите елементи
- хеш-функция за ключовете. Изчислените хешове на ключовете дават местоположение на елементите (наречени сегменти ).
- функция за сравнение на ключове. След като намерите правилния сегмент, трябва да намерите елемента, който търсите, в рамките на сегмента, използвайки това сравнение.
Прост пример
Нека вземем нагледен пример:
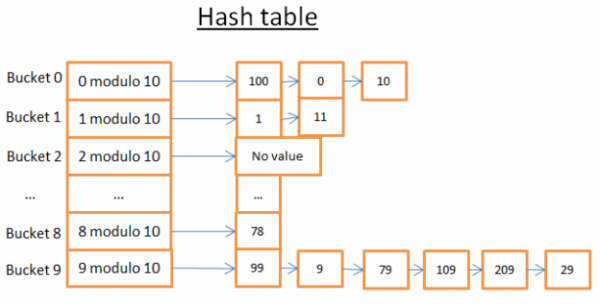
Тази хеш-таблица има 10 сегмента. Понеже съм мързелив, изобразих само 5 сегмента, но знам, че вие сте умни, така че ще ви позволя да си представите още 5 сами. Използвал съм хеш-функция по модул 10 на ключа. С други думи, запазвам само последната цифра на ключа на елемента, за да намеря неговия сегмент:
- ако последната цифра е 0, елементът попада в сегмент 0,
- ако последната цифра е 1, елементът попада в сегмент 1,
- ако последната цифра е 2, елементът попада в сегмент 2,
- …
Функцията за сравнение, която използвах, е просто равенство между две цели числа.
Да предположим, че искате да получите елемента 78:
- Хеш-таблицата изчислява хеш-кода за 78, който е равен на 8.
- Хеш-таблицата гледа в сегмент 8, и първият елемент, който намира, е 78.
- Тя ви връща елемент 78
- Търсенето струва само 2 операции (една за изчисляване на стойността на хеш-функцията, а друга за търсене на елемента в рамките на сегмента).
Сега, да предположим, че искате да получите елемента 59:
- Хеш-таблицата изчислява хеш-кода за 59, който е равен на 9.
- Хеш-таблицата търси в сегмент 9, първият намерен елемент е 99. Тъй като 99!=59, елемент 99 не е правилният елемент.
- Използвайки същата логика, се взема вторият елемент (9), третият (79), …, последният (29).
- Елементът не беше намерен.
- Търсенето струва 7 операции.
Добра хеш-функция
Както виждате, в зависимост от стойността, която търсите, разходите не са еднакви!
Ако сега променя хеш-функцията по модул 1 000 000 на ключа (т.е. взимайки последните 6 цифри), второто търсене ще струва само 1 операция, тъй като в сегмент 000059 няма елементи. Реалната задача е да се намери добра хеш-функция, която ще създава сегменти, съдържащи много малко елементи.
В моя пример е лесно да се намери добра хеш-функция. Но това е прост пример, намирането на добра хеш-функция е по-трудно, когато ключът:
- низ (например — фамилия)
- 2 низа (например — фамилия и име)
- 2 низа и дата (например — фамилия, име и дата на раждане)
- …
С добра хеш-функция, търсенето в хеш-таблица е O(1).
Масив vs хеш-таблица
Защо да не използвате масив?
Хм, добър въпрос.
- Хеш-таблицата може да бъде частично заредена в паметта, а останалите сегменти могат да останат на диска.
- С масив трябва да използвате непрекъснато пространство в паметта. Ако заредите голяма таблица много е трудно да намерите достатъчно непрекъснато пространство.
- За хеш-таблица можете да изберете необходимия ключ (например, страната и фамилията на човека).
За допълнителна информация, можете да прочетете статията за , която е ефективна реализация на хеш-таблица; не е нужно да разбирате Java, за да схванете концепциите, изложени в тази статия.
Източник: habr.com
