

Здравейте, Хабр! Аз съм Артем Карамышев, ръководител на екипа по системно администриране. . През последната година имахме множество стартирания на нови продукти. Целта ни беше API услугите да се мащабират лесно, да бъдат отказоустойчиви и готови за бърз растеж на потребителското натоварване. Нашата платформа е реализирана на OpenStack и искам да споделя какви проблеми с отказоустойчивостта на компонентите ни се наложи да решим, за да постигнем отказоустойчива система. Мисля, че това ще бъде интересно за тези, които също развиват продукти на OpenStack.
Общата отказоустойчивост на платформата произтича от устойчивостта на нейните компоненти. Така че ще преминем постепенно през всички нива, на които открихме рискове и ги отстранихме.
Видеоверсията на тази история, която е основана на доклад на конференцията Uptime day 4, организирана от , може да бъде гледана .
Отказоустойчивост на физическата архитектура
Публичната част на облака MCS в момента се базира в два дата центъра от ниво Tier III, между които има собствена тъмна оптика, резервирана на физическо ниво с различни трасета, с капацитет от 200 Гбит/с. Нивото Tier III осигурява необходимото ниво на отказоустойчивост на физическата инфраструктура.
Тъмната оптика е резервирана както на физическо, така и на логическо ниво. Процесът на резервиране на каналите беше итеративен, появиха се проблеми и ние постоянно усъвършенстваме свързаността между дата центровете.
Например, неотдавна при работа в шахта близо до един от дата центровете, екскаватор проби тръба, в която се оказаха както основният, така и резервният оптичен кабел. Нашият отказоустойчив канал за свързаност с дата центъра се оказа уязвим в една точка — в шахтата. Съответно, загубихме част от инфраструктурата. Направихме изводи и предприехме редица действия, включително прокарахме допълнителна оптика през съседната шахта.
В центровете има точки на присъствие на доставчици на свързаност, на които ние предаваме своите префикси чрез BGP. За всяка мрежова посока се избира най-добрата метрика, което позволява да се осигури най-добро качество на свързването на различни клиенти. Ако свързаността чрез един доставчик бъде прекъсната, ние пренасочваме маршрутизацията си през наличните доставчици.
В случай на отказ в работата на доставчика, ние автоматично преминаваме към следващия. В случай на отказ на един от центровете за данни, ние имаме огледално копие на нашите услуги във втория център за данни, които поемат цялото натоварване.
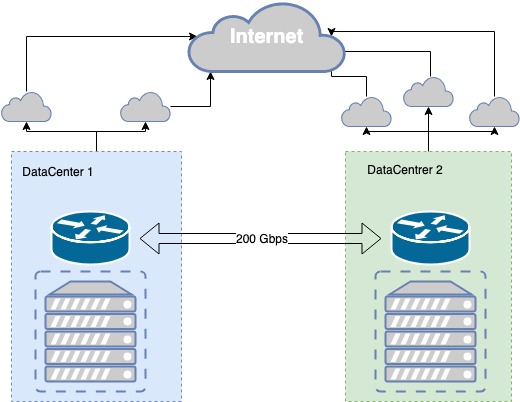
Отказоустойчивост на физическата инфраструктура
Какво използваме за отказоустойчивост на ниво приложения
Нашият сервис е изградена на редица компоненти с отворен код.
ExaBGP — сервис, който реализира редица функции, използвайки протокола за динамична маршрутизация на базата на BGP. Ние активно го използваме, за да анонсираме нашите бели IP адреси, чрез които потребителите получават достъп до API.
HAProxy — високо натоварен балансировач, позволяващ да се настроят много гъвкави правила за балансиране на трафика на различни нива на модела OSI. Ние го използваме за балансиране преди всички услуги: бази данни, брокери на съобщения, API услуги, уеб услуги, нашите вътрешни проекти — всичко стои зад HAProxy.
API приложение — уеб приложение, написано на python, с помощта на което потребителят управлява своята инфраструктура, своя сервис.
Worker приложение (по-долу просто worker) — в услугите на OpenStack това е инфраструктурен демон, който позволява предаване на API команди на инфраструктурата. Например, създаването на диск се извършва именно в worker, а запитването за създаване — в API приложението.
Стандартна архитектура на OpenStack приложението
Повечето услуги, разработени за OpenStack, се опитват да следват единна парадигма. Услугата обикновено се състои от две части: API и worker-и (изпълнители на бекенда). Обикновено, API е WSGI-приложение на python, което може да се стартира или като самостоятелен процес (демон), или с помощта на вече готов уеб сървър Nginx, Apache. API обработва заявката на потребителя и предава допълнителни инструкции за изпълнение на приложението worker application. Предаването става чрез брокер на съобщения, обикновено RabbitMQ, а останалите се поддържат слабо. Когато съобщенията достигнат до брокера, те се обработват от worker-ите, които в случай на необходимост връщат отговор.
Тази парадигма предполага изолирани общи точки на отказ: RabbitMQ и базата данни. В същото време RabbitMQ е изолиран в рамките на една услуга и по принцип може да бъде индивидуален за всяка услуга. Затова в MCS максимално разделяме тези услуги, за всеки отделен проект създаваме отделна база, отделен RabbitMQ. Този подход е добър, тъй като в случай на авария в някои уязвими точки не се поврежда цялата услуга, а само нейната част.
Броят на worker application не е ограничен, така че API може лесно да се мащабира хоризонтално зад балансировачите с цел увеличаване на производителността и устойчивостта на отказ.
В някои услуги е необходима координация вътре в услугата — когато се извършват сложни последователни операции между API и worker-ите. В този случай се използва единен център за координация, клъстерна система като Redis, Memcache, etcd, която позволява на един worker да каже на друг, че тази задача е възложена на него (‘ти, моля, не я взимай’). Използваме etcd. Обикновено работниците активно комуникират с базата данни, записват и четат информация оттам. Като база данни използваме mariadb, която е в многомастър клъстери.
Такъв класически единичен сервис е организиран по общоприетия начин за OpenStack. Може да се разглежда като затворена система, за която са достатъчно очевидни начините за мащабиране и устойчивост на отказ. Например, за устойчивост на отказ API е достатъчно да поставите балансировач пред тях. Мащабирането на worker-ите се постига чрез увеличаване на тяхното количество.
Слабото място в цялата схема са RabbitMQ и MariaDB. Архитектурата им заслужава отделна статия. В тази статия искам да се фокусирам върху отказоустойчивостта на API.
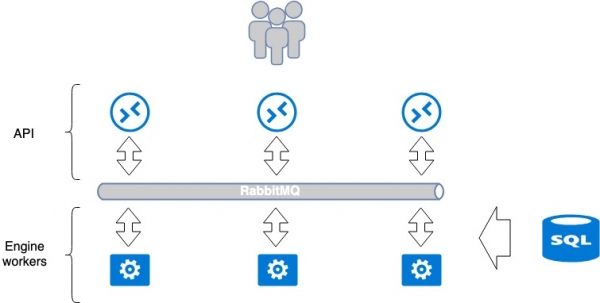
Архитектура на Openstack приложение. Балансиране и отказоустойчивост на облачната платформа
Правим балансировщик HAProxy отказоустойчив с помощта на ExaBGP
За да бъдат нашите API мащабируеми, бързи и отказоустойчиви, поставихме пред тях балансировщик. Избрахме HAProxy. На мое мнение, той притежава всички необходими характеристики за нашата задача: балансировка на няколко нива на OSI, интерфейс за управление, гъвкавост и мащабируемост, голямо количество методи за балансировка, поддръжка на таблици със сесии.
Проблемът, който трябваше да решим, беше отказоустойчивостта на самия балансировщик. Просто инсталирането на балансировщик също създава точка на отказ: балансировщикът се разваля - услугата пада. За да избегнем това, използвахме HAProxy заедно с ExaBGP.
ExaBGP позволява реализирането на механизъм за проверка на състоянието на услугата. Използвахме този механизъм, за да проверяваме работоспособността на HAProxy и в случай на проблеми да изключим услугата HAProxy от BGP.
Схема ExaBGP+HAProxy
- Инсталираме необходимия софтуер, ExaBGP и HAProxy, на три сървъра.
- На всеки от сървърите създаваме loopback интерфейс.
- На всичките три сървъра задаваме на този интерфейс един и същ публичен IP адрес.
- Публичният IP адрес се анонсира в интернет чрез ExaBGP.
Отказоустойчивостта се постига чрез анонсиране на един и същ IP адрес от всички три сървъра. От гледна точка на мрежата, един и същ адрес е достъпен от три различни следващи хопа. Рутерът вижда три идентични маршрута, избира най-привилегированият от тях спрямо собствената си метрика (обикновено това е един и същ вариант) и трафикът върви единствено към един от сървърите.
В случай на проблеми с работата на HAProxy или излизане на сървъра от строя, ExaBGP спира да анонсира маршрута и трафикът плавно преминава на друг сървър.
Така постигнахме отказоустойчивост на балансировщика.
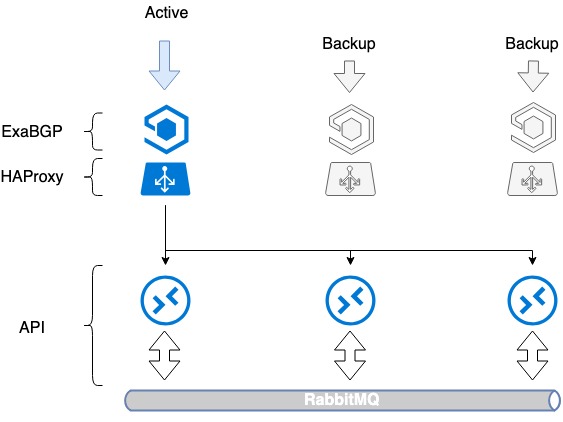
Отказоустойчивост на балансировшици HAProxy
Схемата се оказа неидеална: научихме се да резервираме HAProxy, но не научихме как да разпределяме натоварването вътре в услугите. Затова леко разширихме схемата: преминахме към балансировка между няколко публични IP адреса.
DNS базирано балансиране плюс BGP
Остава нерешен въпросът с балансирането на натоварването пред нашите HAProxy. Въпреки това, решението е доста просто, точно както постъпихме и ние.
За балансиране на три сървъра ще са нужни 3 бели IP адреса и добрият стар DNS. Всеки от тези адреси се определя на интерфейса loopback на всеки HAProxy и се анонсира в интернет.
В OpenStack за управление на ресурсите се използва каталог на услугите, в който се задава endpoint API на съответната услуга. В този каталог записваме домейна — public.infra.mail.ru, който се разрешава чрез DNS с три различни IP адреса. В резултат получаваме разпределение на натоварването между трите адреса чрез DNS.
Но, тъй като при анонсиране на белите IP адреси не управляваме приоритетите за избор на сървър, все още не става въпрос за балансирано натоварване. Обикновено ще се избира само един сървър по старшинство на IP адреса, а другите двама ще останат неактивни, тъй като не са зададени никакви метрики в BGP.
Започнахме да предаваме маршрути чрез ExaBGP с различна метрика. Всеки балансировач анонсира всичките три бели IP адреса, но един от тях, основният за този балансировач, се анонсира с минимална метрика. Така че, докато всичките три балансировача са активни, заявките към първия IP адрес отиват при първия балансировач, заявките към втория при втория, а към третия при третия.
Какво се случва, когато един от балансировачите падне? При отказ на който и да е балансировач, основният му адрес все още се анонсира от двата други, а трафикът между тях се преразпределя. По този начин предоставяме на потребителя чрез DNS веднага няколко IP адреса. Чрез DNS балансиране и различна метрика получаваме равномерно разпределение на натоварването на всичките три балансировача. И в същото време не губим отказоустойчивост.
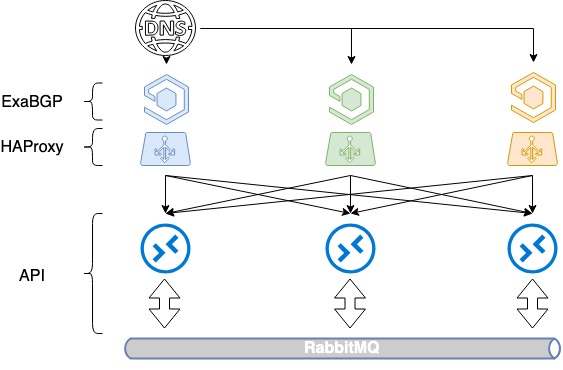
HAProxy балансиране на базата на DNS + BGP
Взаимодействие между ExaBGP и HAProxy
Така реализирахме отказоустойчивост в случай на излизане на сървър, основана на прекратяването на анонса на маршрути. Но HAProxy може да се изключи и по други причини, освен излизането на сървъра от строя: грешки в администрирането, вътрешни повреди на услугата. Искаме да премахнем повредения балансировач от натоварването и в тези случаи е необходим друг механизъм.
Следователно, като разширихме предишната схема, реализирахме heartbeat между ExaBGP и HAProxy. Това е софтуерна реализация на взаимодействието между ExaBGP и HAProxy, при която ExaBGP използва персонализирани скриптове за проверка на статуса на приложенията.
За целта в конфигурацията на ExaBGP е необходимо да се настрои health checker, който ще може да проверява статуса на HAProxy. В нашия случай настройваме health backend в HAProxy, а от страна на ExaBGP проверяваме с прост GET запит.
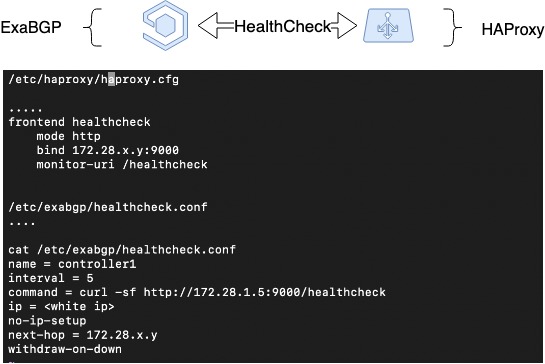
HAProxy Health Check
HAProxy Peers: синхронизация на сесиите
Следващото нещо, което трябваше да направим, беше да синхронизираме сесиите. Когато работите с разпределени балансировчици, е трудно да се организира запазването на информацията за клиентските сесии. Но HAProxy е един от малкото балансировчици, които могат да го направят благодарение на функционалността Peers – възможността за прехвърляне на таблици с сесии между различни процеси на HAProxy.
Съществуват различни методи за балансировка: прости, като , и разширени, при които сесията на клиента се запомня и той всеки път попада на същия сървър, на който е бил преди. Ние искахме да реализираме втория вариант.
В HAProxy за запазване на клиентските сесии се използва механизма stick-tables. Те запазват оригиналния IP адрес на клиента, избрания таргет адрес (бекенд) и определена служебна информация. Обикновено stick таблиците се използват за запазване на двойката source-IP + destination-IP, което е особено полезно за приложения, които не могат да предадат контекста на потребителската сесия при преминаване към друг балансировчик, например – в режим на балансировка RoundRobin.
Ако stick таблицата бъде научена да се премества между различни процеси на HAProxy (между които се осъществява балансировка), нашите балансировчици ще могат да работят с един пул stick таблици. Това ще позволи безшевно превключване на мрежата на клиента при падане на един от балансировчиците, а работата със сесиите на клиентите ще продължи на същите бекенди, които са били избрани преди.
За правилната работа трябва да бъде решен проблемът с IP адреса на балансировчика, от който е установена сесията. В нашия случай това е динамичен адрес на loopback интерфейса.
Правилната работа на peers се постига само при определени условия. Тоест, TCP таймаутите трябва да бъдат достатъчно големи или превключването трябва да бъде достатъчно бързо, за да не бъде прекъсната TCP сесията. Все пак, това позволява безпроблемно превключване.
В IaaS имаме услуга, изградена по същата технология. Това е , наречена Octavia. Тя е основана на две процесаHAProxy и първоначално включва поддръжка на peers. В тази услуга те показаха отлични резултати.
На картинката е схемата за преместване на peers таблици между три инстанции на HAProxy, предлага се конфигурация как може да бъде настроено:
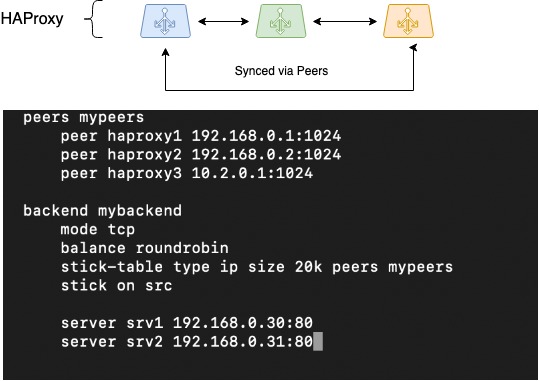
HAProxy Peers (синхронизация на сесиите)
Ако реализирате такава схема, трябва внимателно да тествате работата й. Не е сигурно, че ще работи по същия начин в 100% от случаите. Но поне така няма да загубите stick таблици, когато е нужно да запомните source IP на клиента.
Ограничение на броя на едновременните заявки от един и същи клиент
Всякакви услуги, които са в открит достъп, включително и нашите API, могат да бъдат подложени на лавини от заявки. Причините могат да бъдат съвсем различни, от грешки на потребителите до целенасочени атаки. Периодично ни DDoS-ят по IP адресите. Клиентите често грешат в скриптовете си, създавайки мини DDoS.
По един или друг начин трябва да предвидим допълнителна защита. Очевидното решение е да ограничим броя на заявките към API и да не харчим процесорно време за обработка на злонамерени заявки.
За реализиране на подобни ограничения прилагаме rate limits, организирани на базата на HAProxy, с помощта на същите stick таблици. Настройката на лимитите е достатъчно проста и позволява да се ограничат потребителите по брой заявки към API. Алгоритъмът запомня source IP, от който се правят заявките, и ограничава броя на едновременните заявки от един потребител. Разбира се, изчислихме средния профил на натоварване на API за всяка услуга и установихме лимит, приблизително 10 пъти по-висок от това значение. Все още внимателно наблюдаваме ситуацията и сме нащрек.
Как изглежда това на практика? Имаме клиенти, които постоянно използват нашите API за автоматично мащабиране. Те създават около двеста-триста виртуални машини сутрин и ги изтриват вечер. За OpenStack създаването на виртуална машина, плюс PaaS услуги, изисква поне 1000 API заявки, тъй като взаимодействието между услугите също става чрез API.
Тези прехвърляния на задачи причиняват значителен натиск. Оценихме този натиск, събрахме дневните пикове, увеличихме ги десетократно, и това стана нашият rate лимит. Сме в час със ситуацията. Често забелязваме ботове, скенери, които се опитват да разгледат, дали имаме CGA скриптове, които могат да стартират, и активно ги блокираме.
Как да обновявате кодовата база незабелязано за потребителите
Ние реализираме отказоустойчивост и на ниво процеси на деплой на код. При внедряване има повреди, но тяхното влияние върху достъпността на услугите може да се минимизира.
Непрекъснато обновяваме услугите си и трябва да осигурим процес на обновление на кодовата база без ефект за потребителите. Успяхме да решим този проблем, използвайки възможностите за управление на HAProxy и реализация на Graceful Shutdown в нашите услуги.
За решаването на този проблем трябваше да осигурим управление на балансировщика и "правилното" изключване на услугите:
- В случая с HAProxy управлението се извършва чрез stats файл, който по същество е сокет и се определя в конфигурацията на HAProxy. Команди могат да му се предават чрез stdio. Но нашият основен инструмент за контрол на конфигурации е ansible, затова в него има вграден модул за управление на HAProxy, който активно използваме.
- По-голямата част от нашите услуги API и Engine поддържат технологии за graceful shutdown: при изключване те изчакват пълното завършване на текущата задача, независимо дали е http заявка или някаква служебна задача. Същото се случва и с worker'a. Той знае всички задачи, които изпълнява, и приключва, когато всички са успешно завършени.
Благодарение на тези два момента, безопасният алгоритъм на нашето деплой изглежда по следния начин.
- Разработчикът събира нов пакет код (при нас е RPM), тества в dev среда, тества в stage и оставя в stage репозитория.
- Разработчик поставя задача за деплой с максимално подробен опис на «артефактите»: версия на новия пакет, описание на новата функционалност и други подробности за деплоя при необходимост.
- Системният администратор започва обновлението. Стартира playbook на Ansible, който от своя страна извършва следното:
- Взема пакета от stage-репозитория, обновява версията на пакета в продуктовия репозитори.
- Съставя списък с бекендовете на обновявания сервис.
- Изключва първия обновяван сервис в HAProxy и изчаква да приключат процесите му. Благодарение на graceful shutdown сме сигурни, че всички текущи клиентски заявки ще завършат успешно.
- След пълното спиране на API, worker-ите и изключването на HAProxy, се извършва обновление на кода.
- Ansible стартира сервисите.
- За всеки сервис активира определени «давалки», които извършват unit-тестиране по предварително определен набор от ключови тестове. Извършва се основна проверка на новия код.
- Ако на предишната стъпка не бяха открити грешки, бекендът се активира.
- Преминаваме към следващия бекенд.
- След обновлението на всички бекенди, се стартират функционалните тестове. Ако те не са достатъчни, разработчикът проверява всяка нова функционалност, която е разработвал.
На този етап деплоят е завършен.
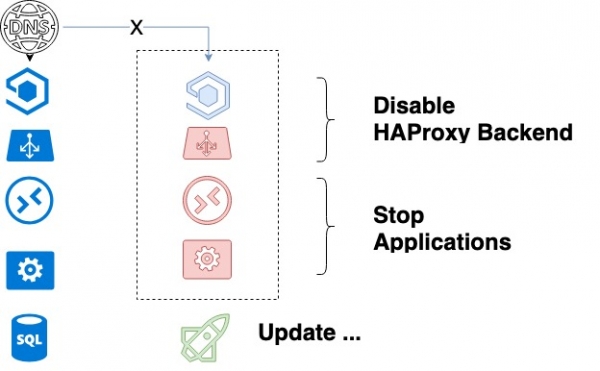
Цикъл на обновление на сервиса.
Тази схема нямаше да бъде работеща, ако нямахме едно правило. Поддържаме в продукция едновременно стара и нова версия. Още на етапа на разработка на софтуера се предвижда, че дори ако има промени в базата данни на сервиса, те няма да счупят предишния код. В резултат на това се извършва постепенно обновление на кодовата база.
Заключение
Споделяйки собствените си размисли относно отказоустойчивата WEB-архитектура, искам още веднъж да подчертая нейните ключови моменти:
- физическа отказоустойчивост;
- мрежова отказоустойчивост (балансировчици, BGP);
- отказоустойчивост на използвания и разработван софтуер.
На всички стабилен uptime!
Източник: habr.com
