

Отказоустойчивостта и високата наличност са важни теми, затова ще посветим отделни статии на RabbitMQ и Kafka. Тази статия е посветена на RabbitMQ, а следващата — на Kafka, в контекста на сравнение с RabbitMQ. Статията е дълга, така че се настанете удобно.
Нека разгледаме стратегиите за отказоустойчивост, консистентност и висока наличност (HA), както и компромисите, които трябва да направим с всяка стратегия. RabbitMQ може да работи на клъстери от възли — в този случай той се класифицира като разпределена система. Когато става въпрос за разпределени системи, често говорим за консистентност и наличност.
Тези понятия описват как системата реагира при срив. Срив в мрежовата свързаност, срив на сървъра, срив на твърдия диск, временно недостъпност на сървъра поради обработка на данни, загуба на пакети или забавяне на мрежовата свързаност. Всичко това може да доведе до загуба на данни или конфликти. Оказва се, че е почти невъзможно да се постигне система, която е едновременно напълно непротиворечива (без загуба на данни, без разминаване в данните) и налична (ще приема операции за четене и запис) при всички сценарии на срив.
Ще видим, че консистентността и наличността се намират на противоположните краища на спектъра и е необходим избор в коя посока да оптимизирате. Добрата новина е, че с RabbitMQ такъв избор е възможен. Имате т.нар. „нердски“ лостове, с които да балансирате между по-висока консистентност или по-висока наличност.
Особено внимание ще обърнем на конфигурации, които водят до загуба на данни при потвърдени записи. Има верига на отговорност между публикуващите, брокерите и потребителите. След като съобщението е предадено на брокера, неговата работа е да не го загуби. Когато брокерът потвърди на публикуващия, че е приел съобщението, не очакваме, че то ще бъде загубено. Но ще видим, че това наистина може да се случи в зависимост от конфигурацията на брокера и издателя.
Примитиви на устойчивост за един възел
Устойчиви опашки/маршрутизиране
В RabbitMQ има два типа опашки: дълготрайни/устойчиви (durable) и неустойчиви (non-durable). Всички опашки се съхраняват в базата данни Mnesia. Устойчивите опашки се обявяват отново при стартиране на възела и, по този начин, оцеляват след рестартиране, срив на системата или срив на сървъра (докато се съхраняват данни). Това означава, че докато декларирате маршрутизация (exchange) и опашка като устойчиви, инфраструктурата на опашките/маршрутизацията ще се върне в оперативен режим.
Неустойчивите опашки и маршрутизацията се изтриват при рестартиране на възела.
Устойчиви съобщения
Само фактът, че опашката е дълготрайна, не означава, че всички нейни съобщения ще преживеят рестартиране на възела. Ще бъдат възстановени само съобщенията, определени от публикуващия като устойчиви (persistent). Устойчивите съобщения наистина създават допълнителна натовареност на брокера, но ако загубата на съобщение е неприемлива, няма друг вариант.
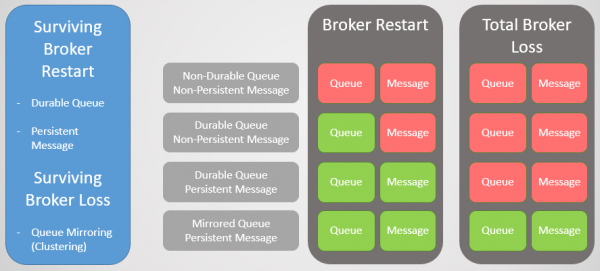
Рис. 1. Матрица на устойчивостта
Клъстеризация с огледално копиране на опашката
За да оцелее загубата на брокера, ни трябва излишък. Можем да обединим няколко възела RabbitMQ в клъстер и след това да добавим допълнителен излишък чрез репликация на опашките между няколко възела. По този начин, ако един възел се срине, не губим данни и оставаме достъпни.
Огледално копиране на опашката:
- една главна опашка (мастер), която получава всички команди за запис и четене
- едно или няколко огледала, които получават всички съобщения и метаданни от главната опашка. Тези огледала съществуват не за мащабиране, а изключително за излишък.
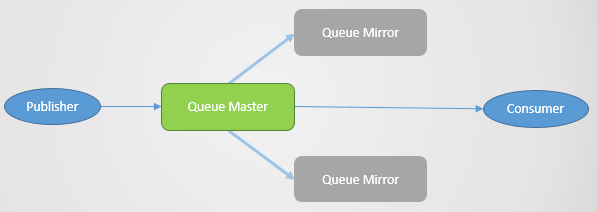
Рис. 2. Огледално копиране на опашката
Огледалното копиране се настройва чрез съответната политика. В нея можете да изберете коефициент на репликация и дори възлите, на които трябва да бъде разположена опашката. Примери:
ha-mode: allha-mode: exactly, ha-params: 2(един мастер и едно огледало)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Потвърждение за публикуващия
За да се постигне последователна запис, са необходими потвърждения от паблишера (Publisher Confirms). Без тях съществува риск от загуба на съобщения. Потвърждението се изпраща на паблишера след записването на съобщението на диск. RabbitMQ записва съобщения на диск не при получаването им, а по периодичен график, на всеки няколкостотин милисекунди. Когато опашката се репликира, потвърждението се изпраща само след като всички реплики също са записали своята копие на съобщението на диск. Това означава, че използването на потвърждения добавя забавяне, но ако сигурността на данните е важна, те са необходими.
Отказоустойчива опашка
Когато брокера спре или падне, всички водещи опашки (мастери) на този узел отпадат заедно с него. След това кластерът избира най-старото огледало на всеки мастер и го повишава в нов мастер.
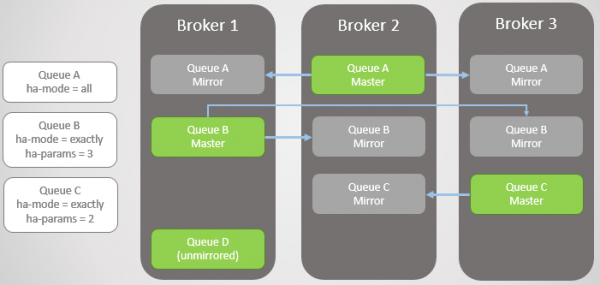
Рис. 3. Няколко репликирани опашки и техните политики
Брокер 3 пада. Обърнете внимание, че огледалото на Опашка С на Брокер 2 е повишено до мастер. Също така обърнете внимание, че за Опашка C е създадено ново огледало на Брокер 1. RabbitMQ винаги се опитва да поддържа коэффициента на репликация, зададен във вашите политики.
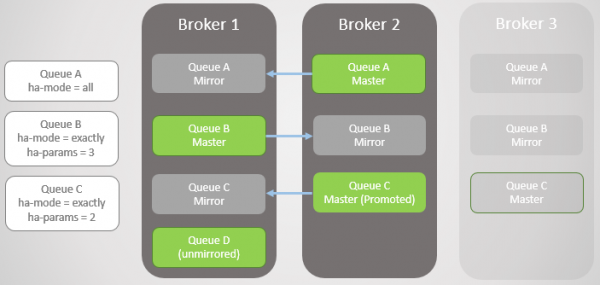
Рис. 4. Брокер 3 отпада, което предизвиква отказ на опашка C
Пада следващият Брокер 1! Остава ни само един брокер. Огледалото на Опашка B е повишено до мастер.
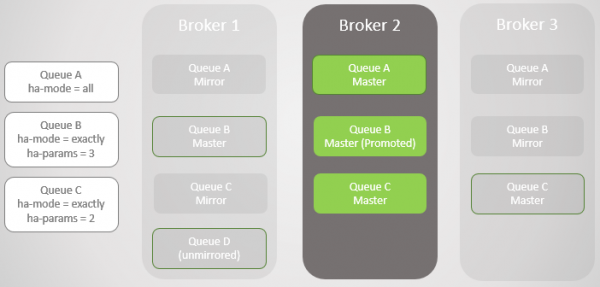
Рис. 5
Върнахме Брокер 1. Независимо от това колко успешно данните са оцелели при загубата и възстановяването на брокера, всички репликирани съобщения на опашката се отхвърлят при рестартиране. Важно е да се отбележи, тъй като ще има последици. Скоро ще разгледаме тези последици. Така Брокер 1 сега отново е член на клъстера и клъстерът се опитва да спазва политиките и така създава огледала на Брокер 1.
В този случай загубата на Брокер 1 беше окончателна, както и на данните, така че незаслонената Опашка В е напълно загубена.
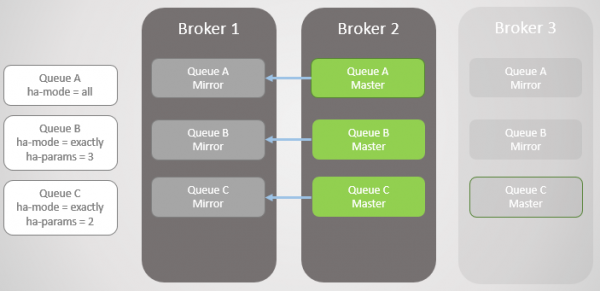
Рис. 6. Брокер 1 се връща в строя
Брокер 3 се завърна в експлоатация, така че опашките A и B получават обратно създадените на него огледала, за да отговорят на изискванията на своите HA политици. Но сега всички основни опашки са на един възел! Това не е идеално, по-добре е равномерното разпределение между възлите. За съжаление, тук няма особени опции за повторно балансиране на майсторите. Ще се върнем на този въпрос по-късно, тъй като първо трябва да разгледаме синхронизацията на опашките.
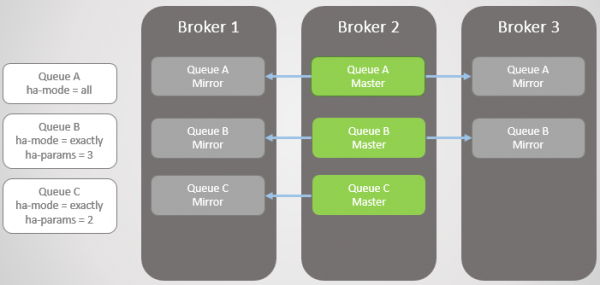
Рис. 7. Брокер 3 се завръща в експлоатация. Всички основни опашки на един възел!
Така че, сега трябва да имате представа как огледалата осигуряват излишък и устойчивост на отказ. Това гарантира достъпност в случай на отказ на един възел и защитава от загуба на данни. Но още не сме приключили, защото всъщност всичко е много по-сложно.
Синхронизация
Когато се създава ново огледало, всички нови съобщения винаги ще се репликират на това огледало и всякакви други. Що се отнася до съществуващите данни в основната опашка, можем да ги репликираме в новото огледало, което става пълна копия на майстора. Можем също да не репликираме съществуващите съобщения и да позволим на основната опашка и новото огледало да се съгласят с времето, когато новите съобщения пристигнат в края, а съществуващите съобщения излизат от главата на основната опашка.
Тази синхронизация се извършва автоматично или ръчно и се управлява с помощта на политики на опашките. Нека да разгледаме пример.
Имаме две огледални опашки. Опашка A се синхронизира автоматично, а Опашка B – ръчно. И в двете опашки има по десет съобщения.
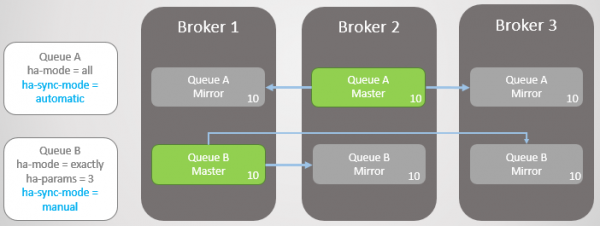
Рис. 8. Две опашки с различни режими на синхронизация
Сега губим Брокер 3.
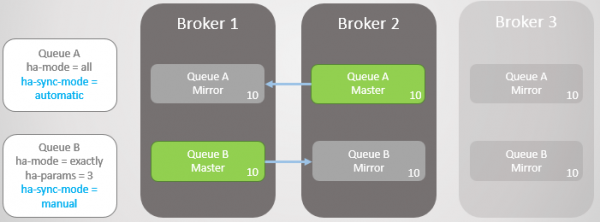
Рис. 9. Брокер 3 падна
Брокер 3 се завръща в експлоатация. Клъстерът създава огледало за всяка опашка на нов възел и автоматично синхронизира новата Опашка А с майстора. Въпреки това, огледалото на новата Опашка В остава празно. Така имаме пълен излишък на Опашка A и само едно огледало за съществуващите съобщения на Опашка B.
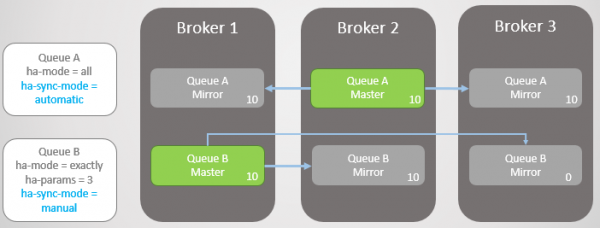
Рис. 10. Новото огледало на Опашка А получава всички съществуващи съобщения, а новото огледало на Опашка B – не.
В двете опашки постъпват още по десет съобщения. След това Брокер 2 пада, а Опашка A се връща към най-старата огледална опашка, която се намира на Брокер 1. При повредата не настъпва загуба на данни. В Опашка B има двадесет съобщения в майстора и само десет в огледалото, тъй като тази опашка никога не е репликирала оригиналните десет съобщения.
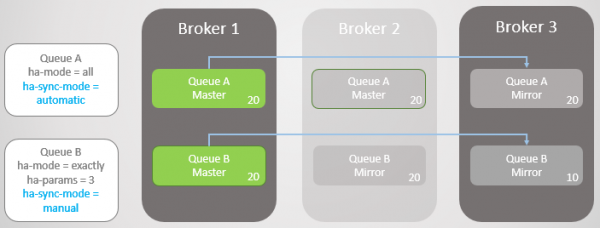
Рис. 11. Опашка A се връща на Брокер 1 без загуба на съобщения
В двете опашки постъпват още по десет съобщения. Сега Брокер 1 пада. Опашка A без проблеми преминава на огледало без загуба на съобщения. Въпреки това, Опашка B има проблеми. На този етап можем да оптимизираме или достъпността, или консистентността.
Ако искаме да оптимизираме достъпността, то политиката ha-promote-on-failure трябва да бъде зададена на always. Това е стойността по подразбиране, така че можем просто да не посочваме политиката изобщо. В такъв случай, по същество допускаме повреди в несинхронизираните огледала. Това ще доведе до загуба на съобщения, но опашката остава достъпна за четене и запис.
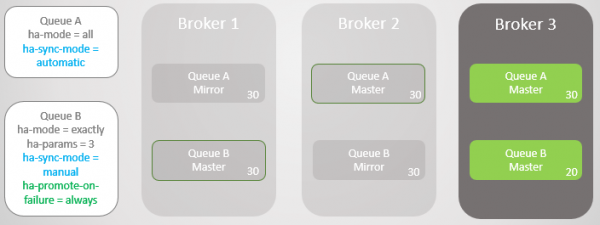
Рис. 12. Опашка A се връща на Брокер 3 без загуба на съобщения. Опашка B се връща на Брокер 3 с загуба на десет съобщения
Ние също можем да зададем ha-promote-on-failure на стойността when-synced. В този случай, вместо да се върне на огледалото, опашката ще изчака, докато Брокер 1 с данните си се върне в оперативен режим. След неговото връщане, главната опашка отново се намира на Брокер 1 без загуба на данни. Достъпността е пожертвана за сигурността на данните. Но това е рисков режим, който може да доведе дори до пълна загуба на данни, което ще разгледаме в най-скоро време.
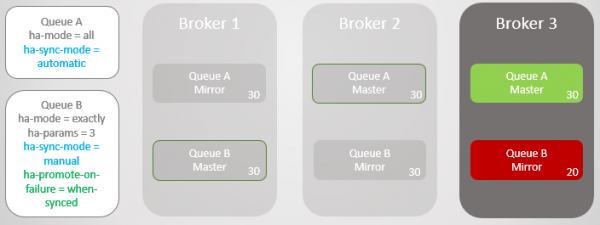
Рис. 13. Опашка B остава недостъпна след загуба на Брокер 1
Можете да зададете въпроса: «Може би е по-добре никога да не използвате автоматична синхронизация?». Отговорът е, че синхронизацията е блокираща операция. По време на синхронизацията главната опашка не може да извършва никакви операции по четене или запис!
Нека разгледаме пример. Сега имаме много големи опашки. Как те могат да нараснат до такава големина? По няколко причини:
- Опашките не се използват активно
- Това са опашки с висока скорост, а в момента потребителите работят бавно
- Това са опашки с висока скорост, настъпи повреда, и потребителите наваксват
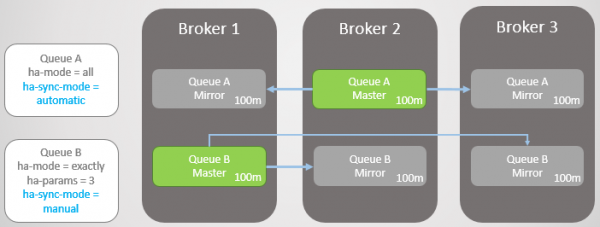
Рис. 14. Две големи опашки с различни режими на синхронизация
Сега пада Брокер 3.
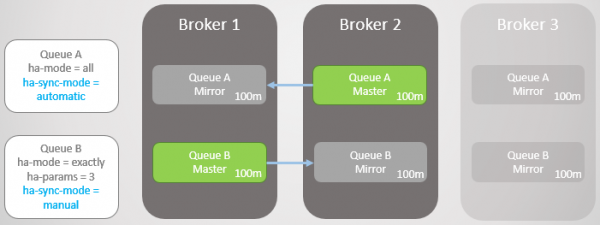
Рис. 15. Брокер 3 пада, оставяйки по един майстор и огледало в всяка опашка
Брокер 3 се връща в строя и се създават нови огледала. Главната Опашка А започва да репликира съществуващите съобщения на новото огледало, и през това време Опашката е недостъпна. За репликация на данните са необходими два часа, което води до два часа престой за тази Опашка!
Обаче Опашка B остава достъпна през целия период. Тя е пожертвала част от излишността в името на достъпността.
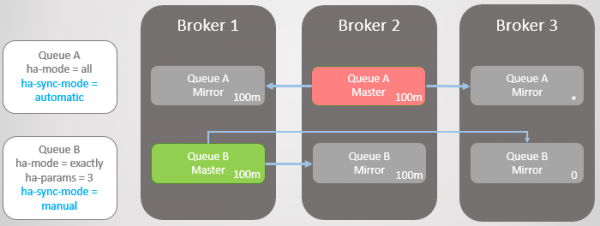
Рис. 16. Опашката остава недостъпна по време на синхронизация
След два часа Опашка A също става достъпна и отново може да започне да приема операции по четене и запис.
Актуализации
Такова блокиращо поведение по време на синхронизация затруднява обновяването на клъстери с много големи опашки. В определен момент възел с майстор трябва да бъде рестартиран, което означава или преминаване на огледало, или деактивиране на опашката по време на обновяване на сървъра. Ако изберем преминаването, ще загубим съобщения, ако огледалата не са синхронизирани. По подразбиране по време на деактивиране на брокера, преминаването на несинхронизирано огледало не се изпълнява. Това означава, че след връщане на брокера, не губим никакви съобщения, единствената щета е само простоя на опашката. Правилата за поведение при деактивиране на брокера се задават от политиката ha-promote-on-shutdown. Може да се установи едно от две стойности:
always= включен преминаването на несинхронизирани огледалаwhen-synced= преминаване само на синхронизирано огледало, в противен случай опашката става недостъпна за четене и запис. Опашката се връща в строя, веднага щом брокерът се върне
Както и да е, с големите опашки трябва да се избира между загуба на данни и недостъпност.
Когато достъпността повишава сигурността на данните
Преди да вземете решение, трябва да вземете предвид още едно усложнение. Въпреки че автоматичната синхронизация е по-добра за излишността, как тя влияе на сигурността на данните? Разбира се, благодарение на по-добрата излишност, RabbitMQ с по-малка вероятност ще изгуби съществуващите съобщения, но какво ще стане с новите съобщения от паблишерите?
Тук трябва да се вземат предвид следните аспекти:
- Може ли публикуващият просто да върне грешка, а по-късно горната служба или потребителят да опитат отново?
- Може ли издателят да запази съобщение локално или в база данни, за да опита отново по-късно?
Ако публикуващият може само да отхвърли съобщението, то наистина подобряването на достъпността също повишава сигурността на данните.
Така че трябва да търсите баланс, а решението зависи от конкретната ситуация.
Проблеми с ha-promote-on-failure=when-synced
Идеята ha-promote-on-failure= when-synced се състои в това, че предотвратяваме превключването към несинхронизирано огледало, и по този начин избягваме загуба на данни. Опашката остава недостъпна за четене или запис. Вместо това се опитваме да върнем падналия брокер с непокътнати данни, за да възобнови работата си като основен без загуба на данни.
Но (и това е голямо "но") ако брокерът е загубил данните си, имаме голям проблем: опашката е загубена! Всички данни са изчезнали! Дори и да имате огледала, които основно наваксват основната опашка, тези огледала също се отхвърлят.
За да добавим отново възел със същото име, казваме на клъстера да забрави загубения възел (чрез командата rabbitmqctl forget_cluster_node) и да стартира нов брокер със същото име на хоста. Докато клъстерът помни загубения възел, той помни старата опашка и несинхронизираните огледала. Когато на клъстера се каже да забрави загубения възел, тази опашка също се забравя. Сега трябва да я обявим отново. Загубихме всички данни, въпреки че имахме огледала с частичен набор от данни. По-добре би било да преминем на несинхронизирано огледало!
Затова ръчната синхронизация (и неизпълнението на синхронизацията) в комбинация с ha-promote-on-failure=when-synced, според мен, е доста рискована. Документите твърдят, че този вариант съществува за сигурността на данните, но това е двуостър меч.
Преразпределение на мастери
Както беше обещано, се връщаме към проблема с натрупването на всички мастери на един или няколко възела. Това може да се случи дори в резултат на „свиваща“ (rolling) актуализация на клъстера. В клъстер с три възела всички основни опашки ще се натрупат на един или два възела.
Преразпределението на мастери може да се окаже проблематично по две причини:
- Няма добри инструменти за извършване на преразпределение
- Синхронизация на опашките
Има трета страна за преразпределение , която не се поддържа официално. Относно външните приставки в ръководството на RabbitMQ : „Плъгинът предлага някои допълнителни инструменти за настройка и отчитане, но не се поддържа и не е проверен от екипа на RabbitMQ. Използвайте на собствен риск.“
Има още един трик за преместване на основната опашка чрез HA политики. В ръководството се споменава за това. То работи по следния начин:
- Премахва всички огледала с времева политика с по-висок приоритет от съществуващата HA политика.
- Променя времевата HA политика да използва режим „възли“, посочвайки възела, на който трябва да се премести основната опашка.
- Синхронизира опашката за принудителна миграция.
- След завършване на миграцията премахва времевата политика. Влиза в сила първоначалната HA политика и се създава необходимият брой огледала.
Недостатъкът е, че този подход може да не сработи, ако имате големи опашки или строги изисквания за излишност.
Сега да видим как работят кластерите на RabbitMQ със мрежови разделения.
Нарушение на свързаността
Възлите на разпределената система са свързани чрез мрежови връзки, и мрежовите връзки могат и ще бъдат прекъсвани. Честотата на прекъсванията зависи от локалната инфраструктура или надеждността на избраната облачна услуга. Във всеки случай, разпределените системи трябва да могат да се справят с тях. Отново сме изправени пред избор между наличност и последователност, и отново добрата новина е, че RabbitMQ осигурява и двата варианта (просто не едновременно).
С RabbitMQ имаме две основни опции:
- Да позволим логично разделение (split-brain). Това осигурява наличност, но може да предизвика загуба на данни.
- Да забраним логичното разделение. Може да доведе до краткосрочна загуба на наличност в зависимост от начина на свързване на клиентите към клъстера. Също така може да доведе до пълна недостъпност в клъстер с два възела.
Но какво е логично разделение? Това е, когато клъстерът се разделя на две поради загуба на мрежови връзки. На всяка страна огледалата повдигат статуса си до мастър, така че в крайна сметка на всяка опашка има няколко мастъра.
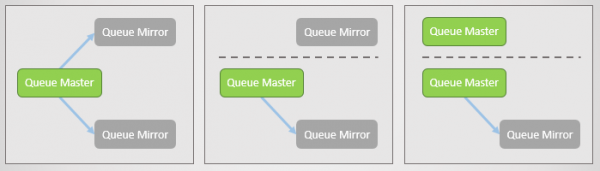
Рис. 17. Главна опашка и две огледала, всяко на отделен възел. След това възниква мрежова повреда, и едното огледало се отделя. Отделеният възел вижда, че другите два са се отделили, и изтласква своите огледала до главният. Сега имаме две главни опашки, и двете разрешават запис и четене.
Ако паблишърите изпращат данни до двата главни възела, ще получим две разминаващи се копия на опашката.
Различните режими на RabbitMQ осигуряват или наличност, или съгласуваност.
Режим Ignore (по подразбиране)
Този режим осигурява наличност. След загуба на свързаност се получава логическо разделение. След възстановяване на свързаността, администраторът трябва да реши на коя част да даде предпочитание. Загубената страна ще бъде рестартирана, и всички натрупани данни от нея ще се загубят.
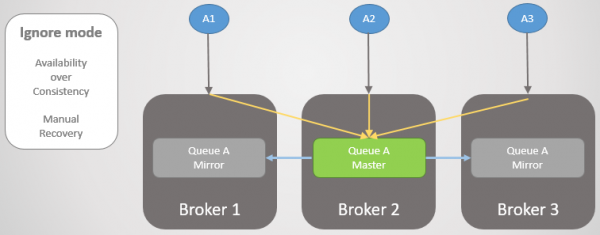
Рис. 18. Три паблишъра са свързани с три брокера. Вътрешно клъстерът насочва всички заявки към главната опашка на Брокер 2.
Сега губим Брокер 3. Той вижда, че другите брокери са се отделили, и изтласква своето огледало до главно. Така се получава логическо разделение.
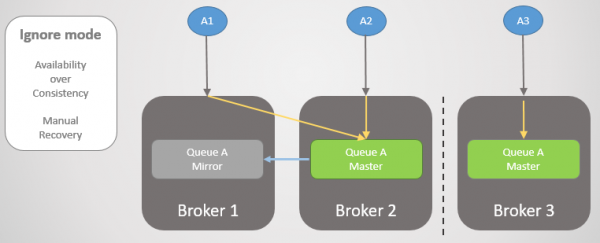
Рис. 19. Логическо разделение (split-brain). Записите отиват в две главни опашки, и двете копия се разминават.
Свързаността се възстановява, но логическото разделение остава. Администраторът трябва ръчно да избере загубената страна. В приведения по-долу случай администраторът рестартира Брокер 3. Всички съобщения, които той не е успял да предаде, се губят.
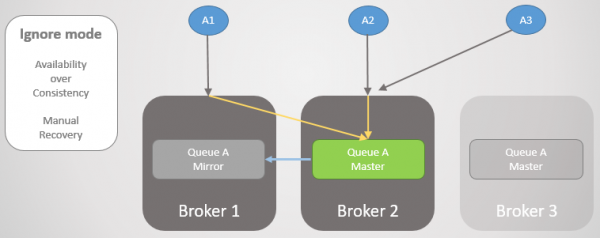
Рис. 20. Администраторът изключва Брокер 3.
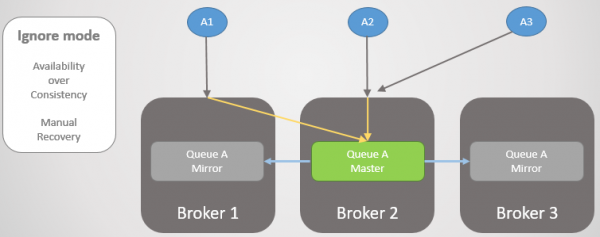
Рис. 21. Администраторът стартира Брокер 3, и той се присъединява към клъстера, губейки всички съобщения, които там останаха.
По време на загуба на свързаност и след нейното възстановяване клъстерът и тази опашка бяха налични за четене и запис.
Режим Autoheal
Работи аналогично на режима Ignore, с изключение на това, че самият клъстер автоматично избира загубената страна след разделение и възстановяване на свързаността. Загубената страна се връща в клъстера празна, а опашката губи всички съобщения, които са били изпратени само на тази страна.
Режим Pause Minority
Ако не искаме да допускаме логическо разделение, нашият единствен вариант е да се откажем от четенето и записването на по-малката страна след раздела на клъстера. Когато брокерът види, че е на по-малката страна, спира работата, тоест затваря всички съществуващи връзки и отказва нови. Веднъж в секунда проверява възстановяването на свързаността. Щом свързаността е възстановена, той възобновява работата си и се присъединява отново към клъстера.
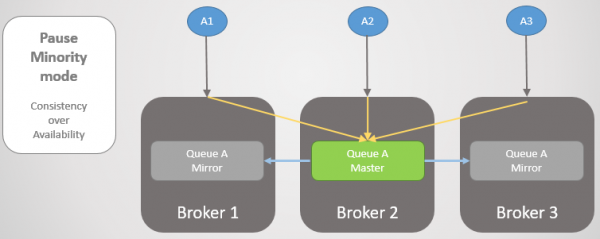
Рис. 22. Три публикуващи единици са свързани с три брокера. Вътрешно клъстерът насочва всички заявки към главната опашка на Брокер 2.
След това Брокери 1 и 2 се отделят от Брокер 3. Вместо да повишава своето огледало до майстор, Брокер 3 спира работа и става недостъпен.
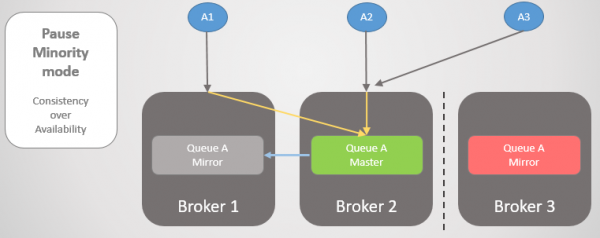
Рис. 23. Брокер 3 спира работа, отключва всички клиенти и отхвърля заявки за свързване.
След като свързаността е възстановена, той се връща в клъстера.
Нека погледнем друг пример, при който главната опашка е на Брокер 3.
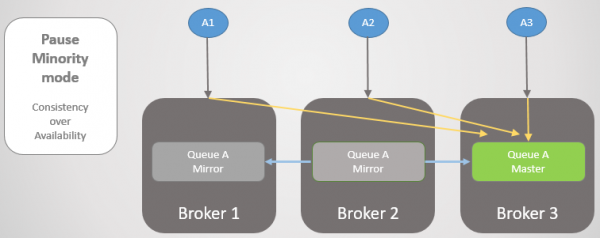
Рис. 24. Главната опашка на Брокер 3.
След това настъпва същата загуба на свързаност. Брокер 3 е на пауза, тъй като е на по-малката страна. От другата страна възлите виждат, че Брокер 3 е изпаднал, така че по-старото огледало от Брокери 1 и 2 се повишава до майстор.
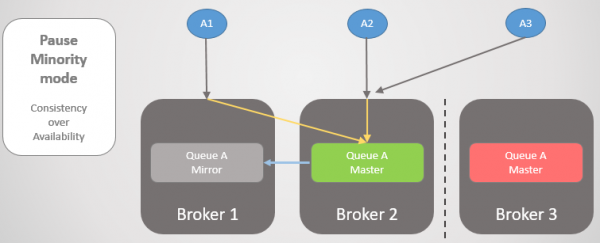
Рис. 25. Преход към Брокер 2 при недостъпност на Брокер 3.
Когато свързаността е възстановена, Брокер 3 ще се присъедини към клъстера.

Рис. 26. Клъстерът се е върнал към нормална работа.
Тук е важно да разберем, че получаваме последователност, но можем да получим и достъпност, ако успешно преместим клиентите на по-голямата част от раздела. За повечето ситуации лично аз бих избрал режим Pause Minority, но това всъщност зависи от конкретния случай.
За да се осигури достъпност, е важно да се уверим, че клиентите успешно се свързват с възела. Нека разгледаме нашите опции.
Осигуряване на свързаност на клиентите
Имаме няколко варианта как да насочим клиентите към основната част на клъстера или към работещи възли (след отказ на един възел). Нека първо да си припомним, че конкретната опашка се намира на определен възел, но маршрутизацията и политиките се репликират на всички възли. Клиентите могат да се свързват към всеки възел, а вътрешната маршрутизация ще ги насочи където трябва. Но когато възелът е спрян, той отхвърля връзки, затова клиентите трябва да се свържат с друг възел. Ако възелът е отказал, той почти не може да направи нищо.
Нашите варианти:
- Достъпът до клъстера се осъществява чрез балансировач на натоварването, който просто циклично проверява възлите, а клиентите извършват повторни опити за свързване до успешен завършек. Ако възелът не работи или е спрян, опитите за свързване към него ще завършат с неуспех, но следващите опити ще се насочат към други сървъри (в цикличен режим). Това е подходящо за краткотрайно загубване на свързаност или за паднал сървър, който ще бъде бързо възстановен.
- Достъп до клъстера чрез балансировач на натоварването и премахване на спрени/паднали възли от списъка, веднага след като бъдат открити. Ако това се направи бързо и ако клиентите могат да извършват повторни опити за свързване, ще постигнем постоянна наличност.
- Да се предостави на всеки клиент списък с всички възли, а клиентът при свързване случайно да избере един от тях. Ако при опит за свързване получи грешка, преминава към следващия възел в списъка, докато не се свърже.
- Да се премахне трафикът от падналия/спрян възел с помощта на DNS. Това се прави с малък TTL.
Изводи
Клъстеризацията на RabbitMQ има своите предимства и недостатъци. Най-сериозните недостатъци са, че:
- при присъединяване към клъстера възлите отхвърлят своите данни;
- блокиращата синхронизация води до недостъпност на опашката.
Всички трудни решения произлизат от тези две особености на архитектурата. Ако RabbitMQ можеше да запазва данни при повторно свързване на клъстера, синхронизацията щеше да бъде по-бърза. Ако можеше да извършва неблокираща синхронизация, щеше да поддържа по-добре големи опашки. Отстраняването на тези два проблема сериозно би подобрило характеристиките на RabbitMQ като отказоустойчива и високо достъпна технология за обмен на съобщения. Нямам куража да препоръчам RabbitMQ с клъстериране в следните ситуации:
- Ненадеждна мрежа.
- Ненадеждно хранилище.
- Много големи опашки.
Що се отнася до настройките за висока достъпност, помислете за следните:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(илиautoheal)- устойчиви съобщения
- убедете се, че клиентите се свързват с активен възел, когато някой възел излезе от строя
За консистентност (сигурност на данните) помислете за следните настройки:
- Publisher Confirms и Manual Acknowledgements на страна на потребителя
ha-promote-on-failure=when-synced, ако издателите могат да опитат отново по-късно и ако имате много надеждно хранилище! В противен случай поставете=always.ha-sync-mode=automatic(но за големи неактивни опашки може да се нуждаете от ръчен режим; освен това, помислете дали недостъпността няма да доведе до загуба на съобщения)- режим Pause Minority
- устойчиви съобщения
Не сме разгледали всички въпроси по отношение на отказоустойчивостта и високата достъпност; например, как безопасно да извършваме административни процедури (като постепенни актуализации). Трябва да поговорим и за федерацията и плъгина Shovel.
Ако съм пропуснал нещо, моля, дайте ми знак.
Вижте също моя , където правя тестове на клъстера RabbitMQ с помощта на Docker и Blockade, за да проверя някои сценарии за загуба на съобщения, описани в тази статия.
Предишни статии от серията:
№1 —
№2 —
№3 —
Източник: habr.com
